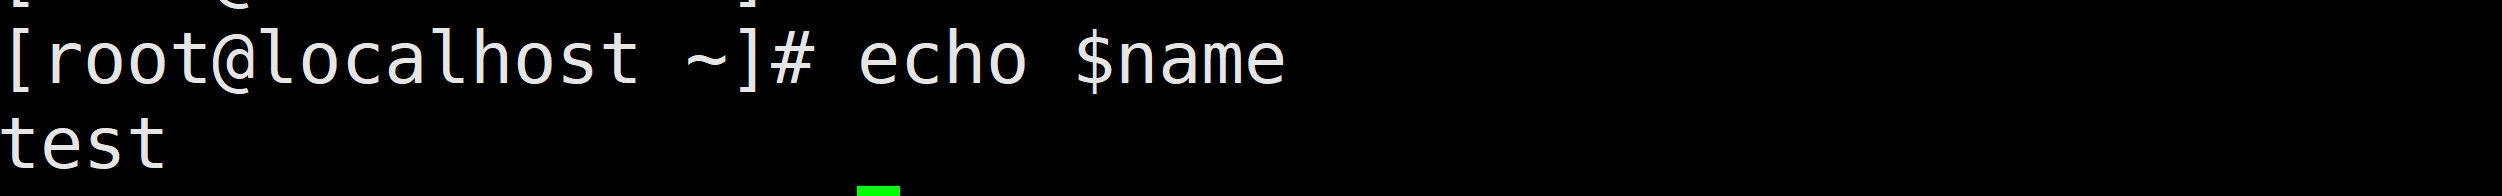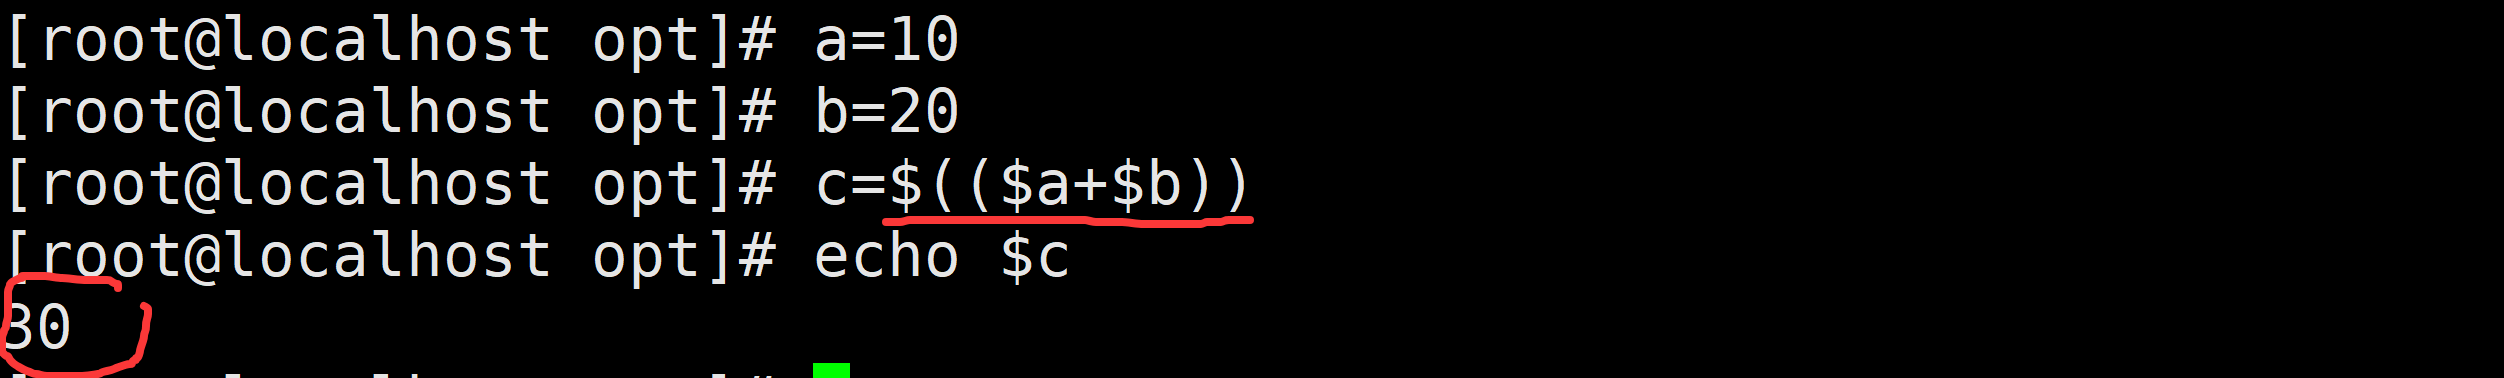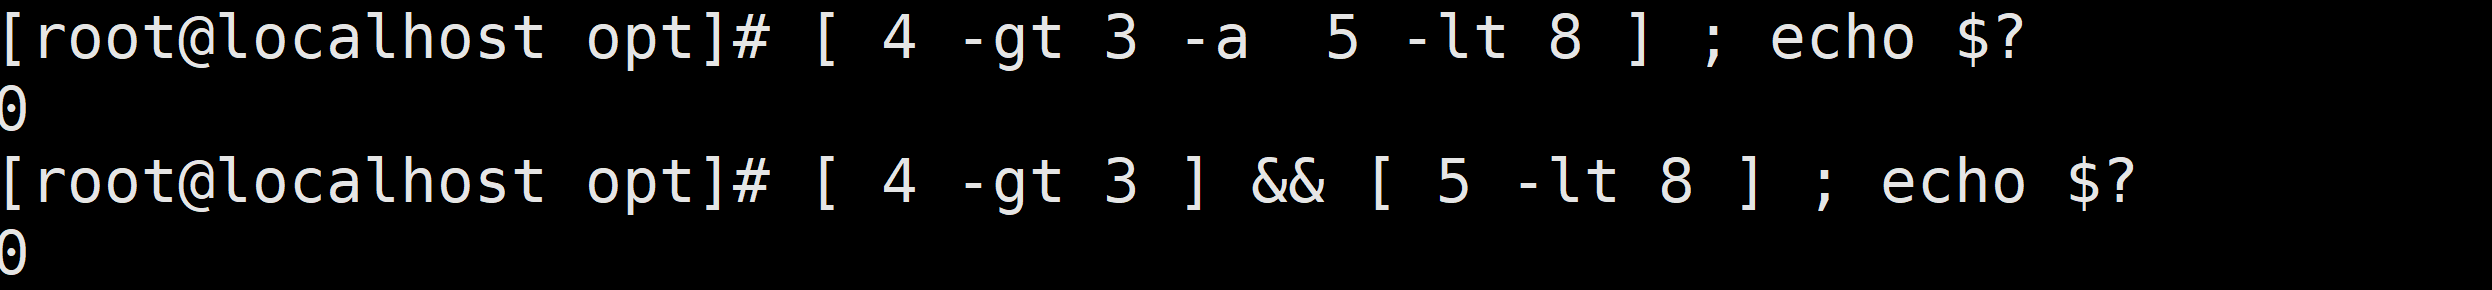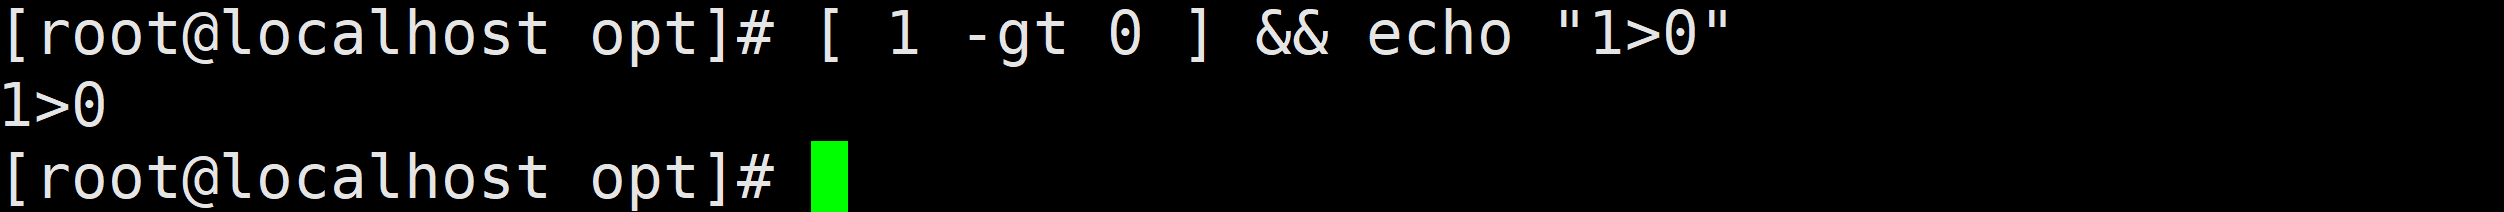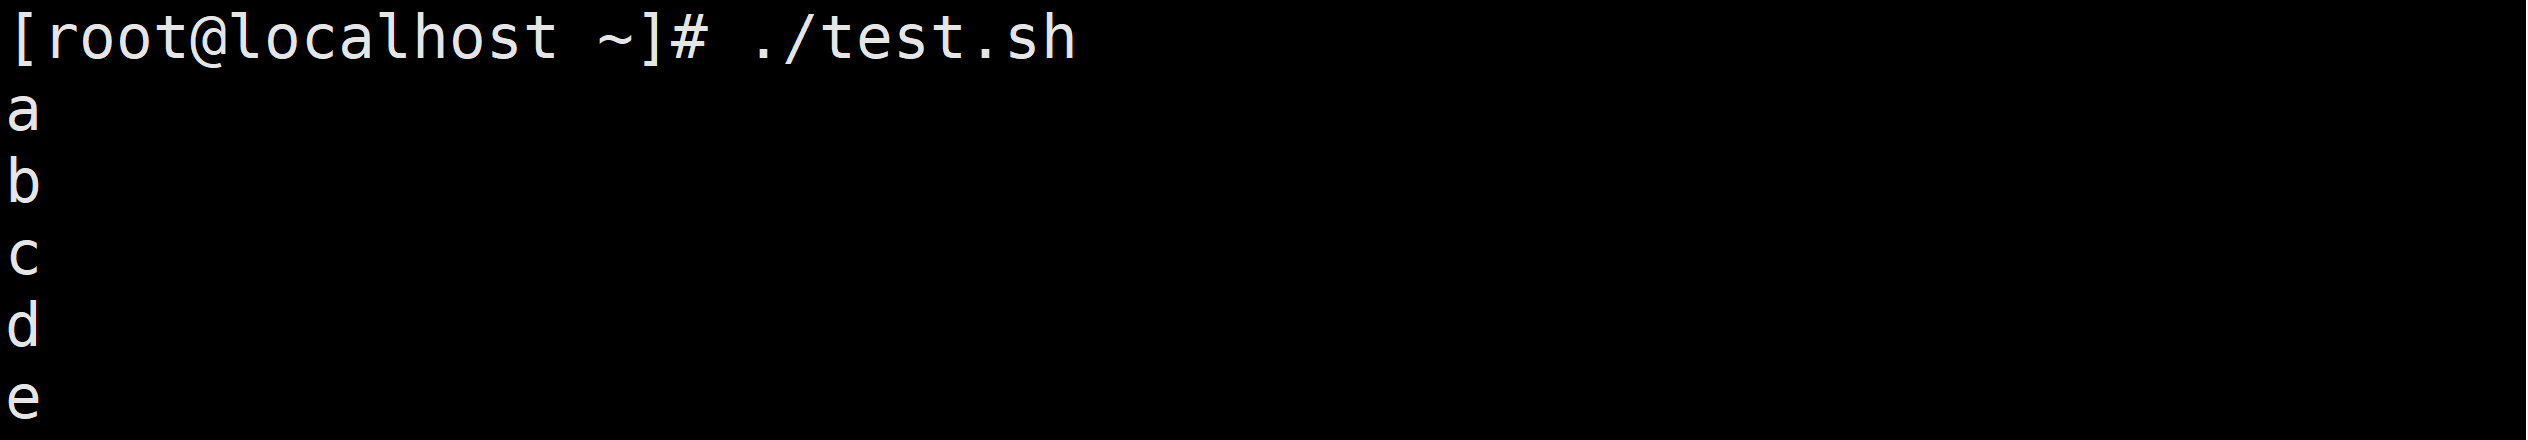一、安装certmanager

1. 安装 cert-manager CRD

kubectl apply -f https://github.com/cert-manager/cert-manager/releases/download/v1.14.4/cert-manager.crds.yaml

2. 创建 cert-manager 命名空间

kubectl create namespace cert-manager

3. 使用 Helm 安装 cert-manager

helm repo add jetstack https://charts.jetstack.io
helm repo update

helm install cert-manager jetstack/cert-manager \
  --namespace cert-manager \
  --version v1.14.4   # 只是参考版本

4. 验证 cert-manager 安装成功

# 检查 Pod 状态(Running 为正常)
kubectl get pods -n cert-manager

# 检查 CRD 是否安装成功
kubectl get crds | grep cert-manager

二、示例:Cloudflare DNS01 验证(泛域名证书)

1. Cloudflare API 令牌申请

  1. 登录 Cloudflare 控制台 → 选择你的域名 → 点击概述→获取您的API令牌
  2. 点击创建令牌,选择模板「编辑区域 DNS」
  3. 权限配置:区域 → DNS → 编辑 ,包括 → 特定区域 → 选择你的域名
  4. 创建令牌并复制 API Token(仅显示一次)
  5. 在域名概览页复制 Zone ID

2. 创建 Cloudflare 认证 Secret

  • 在cert-manager 命名空间存储 API 令牌与区域 ID

# 文件名:cloudflare-api-secret.yaml
apiVersion: v1
kind: Secret
metadata:
  name: cloudflare-api-token
  namespace: cert-manager
type: Opaque
stringData:
  # 填写 Cloudflare API 令牌
  api-token: "你的Cloudflare API令牌"
  # 填写 Cloudflare 域名 Zone ID
  zone-id: "你的Cloudflare区域ID"

  • 执行创建命令:

kubectl apply -f cloudflare-api-secret.yaml

3. 创建集群签发器(ClusterIssuer)

  • 创建签发器

# 文件名:cluster-issuer-prod.yaml
apiVersion: cert-manager.io/v1
kind: ClusterIssuer
metadata:
  name: letsencrypt-prod-cloudflare
spec:
  acme:
    # Let's Encrypt 生产环境地址
    server: https://acme-v02.api.letsencrypt.org/directory
    email: "yourname@bkj.com"
    privateKeySecretRef:
      name: letsencrypt-prod-cloudflare
    solvers:
    - dns01:
        cloudflare:
          email: "yourname@bkj.com"
          apiTokenSecretRef:
            name: cloudflare-api-token
            key: api-token

  • 执行创建命令:

kubectl apply -f cluster-issuer-prod.yaml

4.创建泛域名证书(Certificate)

apiVersion: cert-manager.io/v1
kind: Certificate
metadata:
  name: envoy-bkj-cert
  namespace: gateway 
spec:
  # 证书最终存储的 Secret 名称
  secretName: envoy-wildcard-tls
  issuerRef:
    name: letsencrypt-prod-cloudflare
    kind: ClusterIssuer
    group: cert-manager.io
  dnsNames:
  - "*.bkj.com"  # 你的泛域名,不用改
  privateKey:
    algorithm: RSA
    size: 2048
  # 过期前 20 天自动续期
  renewBefore: 480h

  • 执行创建命令

kubectl apply -f wildcard-certificate.yaml

5. 证书签发成功验证步骤

5.1 验证 Cloudflare 认证 Secret

kubectl get secret cloudflare-api-token -n cert-manager

判断标准:能看到名为 cloudflare-api-token 的 Secret 资源。

5.2 验证集群签发器(ClusterIssuer)

kubectl get clusterissuer

判断标准:

  • 能看到 letsencrypt-prod-cloudflare
  • READY 列显示为 True(核心标志,False 表示签发器配置错误)

5.3 验证证书资源(Certificate)

    kubectl get certificates -n gateway

    判断标准:

    • 能看到 envoy-bkj-cert
    • READY 列显示为 True(核心标志,False 表示签发失败)
    • AGE 列有时间(表示资源已创建)

    5.4 验证证书存储 Secret

    kubectl get secret envoy-wildcard-tls -n gateway

    判断标准:

    • 能看到名为 envoy-wildcard-tls 的 Secret
    • TYPE 列显示为 kubernetes.io/tls(表示是标准 TLS 证书 Secret)

    Certbot 是 Let's Encrypt 官方推荐的开源证书管理工具,专为裸机服务器(CentOS、Ubuntu 等)设计,可全自动完成 SSL 证书的申请、配置、部署与续签,完美解决网站 HTTPS 加密需求。

    • 无需手动购买证书、无需手动配置、无需定期更新
    • 证书有效期 90 天,支持无人值守自动续签
    • 兼容 Nginx/Apache/ 自定义服务,一键集成 Web 服务器

    自动签发 SSL 证书支持单域名、多域名证书签发,自动完成域名所有权验证。

    自动配置 Web 服务器一键修改 Nginx 配置,自动开启 HTTPS、强制 HTTP 跳转 HTTPS。

    全自动证书续签(核心)系统后台定时任务自动运行,证书到期前 30 天自动续签,续签后自动重启 Nginx 生效。

    全球信任签发的证书兼容所有浏览器、操作系统、移动端,无安全警告。

    永久免费无任何使用成本,无域名数量限制,适合生产 / 测试环境。

    一、安装snapd

    官方早已弃用 yum 安装 Certbot
    直接用官方唯一推荐的 Snapd 方式安装最新版 Certbot

    # 安装EPEL源(已装可跳过)
    yum install -y epel-release
    # 安装snapd
    yum install -y snapd
    # 启动snapd服务
    systemctl enable --now snapd.socket
    # 创建软链接
    ln -s /var/lib/snapd/snap /snap

    二、用 Snap 安装最新版 Certbot

    # 安装core依赖
    snap install core
    snap refresh core
    # 安装最新certbot
    snap install --classic certbot
    # 链接命令到系统全局
    ln -s /snap/bin/certbot /usr/bin/certbot

    三、签发证书(以nginx为例)

    certbot --nginx -d xxx.com -d www.xxx.com

    输入email,确认协议

    四、自动续签

    1.工作模式

    Certbot 安装后自动创建系统定时任务,无需人工干预:

    • 定时器(certbot-renew.timer):每天自动执行 2 次,检查证书状态
    • 续签服务(certbot-renew.service):执行续签命令 certbot renew
    • 续签规则:证书到期 ≤30 天 自动续签
    • 生效方式:续签完成后自动重启 Nginx,HTTPS 无缝切换

    2.验证自动续签

    certbot renew --dry-run

    出现 Congratulations 就代表自动续签功能正常

    3.查看定时任务状态

    systemctl list-timers | grep certbot

    五、证书默认存储路径

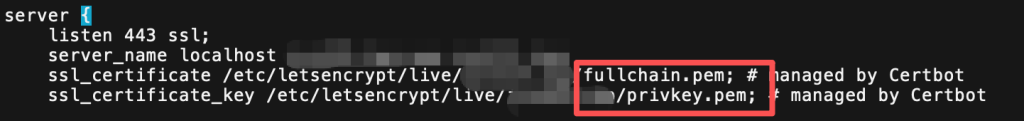
    /etc/letsencrypt/live/xxx.com/

    核心文件:

    • fullchain.pem:证书公钥
    • privkey.pem:证书私钥

    在nginx的配置文件也能看到certbot已经将我们的nginx配置文件的证书路径更改

    MySQL数据库管理以及备份

    1)关系型数据库

    重点:强调数据与数据之间的关系

    mysql(免费,开源。8.0以后的版本不开源,不免费。目前主流的使用版本5.7) sqlserver oracle db2

    • mysql

    MySQL是一个关系型数据库管理系统,由瑞典MySQL AB 公司开发,属于 Oracle 旗下产品。MySQL 是最流行的关系型数据库管理系统之一,在 WEB 应用方面,MySQL是最好的 RDBMS (Relational Database Management System,关系数据库管理系统) 应用软件之一。

    MySQL是一种关系型数据库管理系统,关系数据库将数据保存在不同的表中,而不是将所有数据放在一个大仓库内,这样就增加了速度并提高了灵活性。

    MySQL所使用的 SQL 语言是用于访问数据库的最常用标准化语言。MySQL 软件采用了双授权政策,分为社区版和商业版,由于其体积小、速度快、总体拥有成本低,尤其是开放源码这一特点,一般中小型和大型网站的开发都选择 MySQL 作为网站数据库。

    • SQL Server

    微软开发的关系型数据库管理系统,深度集成 Windows 生态,支持 Transact-SQL 语言,具备图形化管理工具(SSMS)和强大的企业级功能(如分布式事务、商业智能 BI)。特点:兼容性强(与.NET 框架无缝对接)、高可用性( Always On 集群)、内置数据加密与审计功能,适合企业级 ERP、CRM 系统及微软技术栈项目。但主要运行于 Windows 平台,开源生态较弱,授权成本较高。

    • Oracle

    甲骨文公司的旗舰关系型数据库,以稳定性、安全性和高性能著称,支持大型跨国企业核心业务系统(如银行交易、电信计费)。核心优势:完整支持 ACID 事务、RAC 集群(实时应用集群)实现高可用、分区表处理海量数据、强大的 PL/SQL 编程能力。但架构复杂(需专业 DBA 运维)、授权费用高昂,主要应用于金融、政府等对可靠性要求极高的场景。

    • DB2

    IBM 研发的企业级关系型数据库,主打安全性、可扩展性和大数据处理能力,支持多平台(Linux/UNIX/Windows)。特色功能:pureScale 集群技术(线性扩展性能)、BLU 加速(内存列存储)、高级压缩与加密算法,适合数据仓库、OLAP 分析及合规性要求高的行业(如医疗、保险)。与 IBM 生态(如 WebSphere、Cognos)深度整合,但市场份额低于 Oracle 和 SQL Server,学习成本较高。

    2)非关系型数据库

    memcache redis hbase

    • Memcache

    Memcache 是一款开源的高性能分布式内存缓存系统,诞生于 2003 年。它通过将数据存储在内存中,大幅减少对后端数据库的访问压力,从而提升 Web 应用响应速度。核心特点:纯内存存储(读写速度极快)、支持简单键值对、分布式集群(需客户端分片)、自动淘汰过期数据。但不支持持久化,断电后数据丢失,适合缓存高频访问的简单数据(如会话、热门商品信息),减轻数据库负担。

    • Redis

    Redis(Remote Dictionary Server)是 2009 年推出的开源内存数据库,支持丰富的数据结构(字符串、哈希、列表、集合、有序集合等),被誉为 “数据结构服务器”。它的数据优先存储于内存,同时支持 RDB 快照和 AOF 日志持久化,保障数据安全。具备原子操作、主从复制、哨兵和集群等高可用特性,广泛用于缓存、排行榜、计数器、消息队列等场景,功能全面且性能卓越。

    • HBase

    HBase 是 Apache 开源的分布式列式数据库,基于 Hadoop 架构(HDFS 存储、ZooKeeper 协调),专为存储海量数据(数十亿行 × 数百万列)并提供实时随机读写而设计。采用列式存储,适合处理稀疏数据;支持自动分片和水平扩展至数千节点;基于 HDFS 实现高可靠性和强一致性。典型场景包括 PB 级日志存储、电商评论实时查询、物联网设备数据处理等,适合海量冷数据的高效存储与访问。

    重点:强调数据的存储

    1.数据库管理mysqladmin命令

    mysqladmin 是 MySQL 官方提供的管理工具,通过 MySQL 客户端协议 连接服务器,可执行管理操作。

    1)命令格式

    mysqladmin [选项] [命令]

    2)选项说明

    • -h, --host=主机名:指定 MySQL 服务器地址(默认 localhost)。
    • -u, --user=用户名:连接的用户名。
    • -p, --password[=密码]:连接密码(建议用 -p 后交互式输入,避免明文显示)。
    • -P, --port=端口:指定服务器端口(默认 3306)。

    3)用法示例

    查看服务器状态mysqladmin -uroot -p status

    mysqladmin -uroot -p status
    
    [root@slavedb ~]# mysqladmin -uroot -pAa123456= status
    Uptime: 13667  Threads: 2  Questions: 1467  Slow queries: 0  Opens: 295  Flush tables: 1  Open tables: 177  Queries per second avg: 0.107

    关闭MySQL服务器mysqladmin -uroot -p shutdown

    mysqladmin -uroot -p shutdown
    
    [root@slavedb ~]# mysqladmin -uroot -pAa123456= shutdown
    [root@slavedb ~]# mysql -uroot -p
    Enter password: 
    ERROR 2002 (HY000): Can't connect to local MySQL server through socket '/var/lib/mysql/mysql.sock' (2)
    [root@slavedb ~]# systemctl status mysqld
    ● mysqld.service - MySQL Server
       Loaded: loaded (/usr/lib/systemd/system/mysqld.service; enabled; vendor preset: disabled)
       Active: inactive (dead) since Sun 2025-06-22 20:09:55 CST; 2min 28s ago
         Docs: man:mysqld(8)
               http://dev.mysql.com/doc/refman/en/using-systemd.html
      Process: 10969 ExecStart=/usr/sbin/mysqld --daemonize --pid-file=/var/run/mysqld/mysqld.pid $MYSQLD_OPTS (code=exited, status=0/SUCCESS)
      Process: 10951 ExecStartPre=/usr/bin/mysqld_pre_systemd (code=exited, status=0/SUCCESS)
     Main PID: 10972 (code=exited, status=0/SUCCESS)
    
    Jun 22 16:20:33 slavedb systemd[1]: Starting MySQL Server...
    Jun 22 16:20:33 slavedb systemd[1]: Started MySQL Server.

    重新加载权限表mysqladmin -uroot -p reload

    #无需重启服务器,修改权限后常用
    mysqladmin -uroot -p reload

    创建数据库mysqladmin -uroot -p create woniu

    mysqladmin -uroot -p create woniu

    删除数据库

    mysqladmin -uroot -p drop woniu
    
    [root@slavedb ~]# mysqladmin -uroot -p drop woniu
    Dropping the database is potentially a very bad thing to do.
    Any data stored in the database will be destroyed.
    
    Do you really want to drop the 'woniu' database [y/N] y
    Database "woniu" dropped

    修改用户密码mysqladmin -uroot -p password "Aa654321="

    mysqladmin -uroot -p password "Aa654321="

    检查服务器是否存活mysqladmin -uroot -p ping

    mysqladmin -uroot -p ping
    
    [root@slavedb ~]# mysqladmin -uroot -pAa654321= ping
    mysqld is alive

    查看MySQL版本信息mysqladmin -uroot -p version

    mysqladmin -uroot -p version
    
    [root@slavedb ~]# mysqladmin -uroot -p version
    Enter password: 
    mysqladmin  Ver 8.42 Distrib 5.7.44, for Linux on x86_64
    Copyright (c) 2000, 2023, Oracle and/or its affiliates.
    
    Oracle is a registered trademark of Oracle Corporation and/or its
    affiliates. Other names may be trademarks of their respective
    owners.
    
    Server version      5.7.44-log
    Protocol version    10
    Connection      Localhost via UNIX socket
    UNIX socket     /var/lib/mysql/mysql.sock
    Uptime:         9 min 15 sec
    
    Threads: 2  Questions: 29  Slow queries: 0  Opens: 119  Flush tables: 1  Open tables: 112  Queries per second avg: 0.052

    2.mysql -- 数据库连接

    MySQL 命令行客户端(mysql)是管理和操作 MySQL 数据库的核心工具,支持交互式执行 SQL 语句、批量处理脚本等功能。

    1)命令格式

    mysql [选项] [数据库名]

    2)选项说明

    选项 描述 示例
    -h, --host=主机 指定服务器地址(默认 localhost) mysql -h 192.168.1.100
    -u, --user=用户 指定用户名 mysql -u root
    -p, --password 指定密码(交互式输入) mysql -p
    -P, --port=端口 指定端口(默认 3306) mysql -P 3307
    --ssl-ca=证书路径 使用 SSL 加密连接 mysql --ssl-ca=ca.pem
    --defaults-file 指定配置文件 mysql --defaults-file=~/.my.cnf

    3)用法示例

    本地连接mysql -uroot -p

    mysql  -uroot -p

    远程连接mysql -h

    mysql  -h 服务器地址  -u用户名   -p密码  

    file

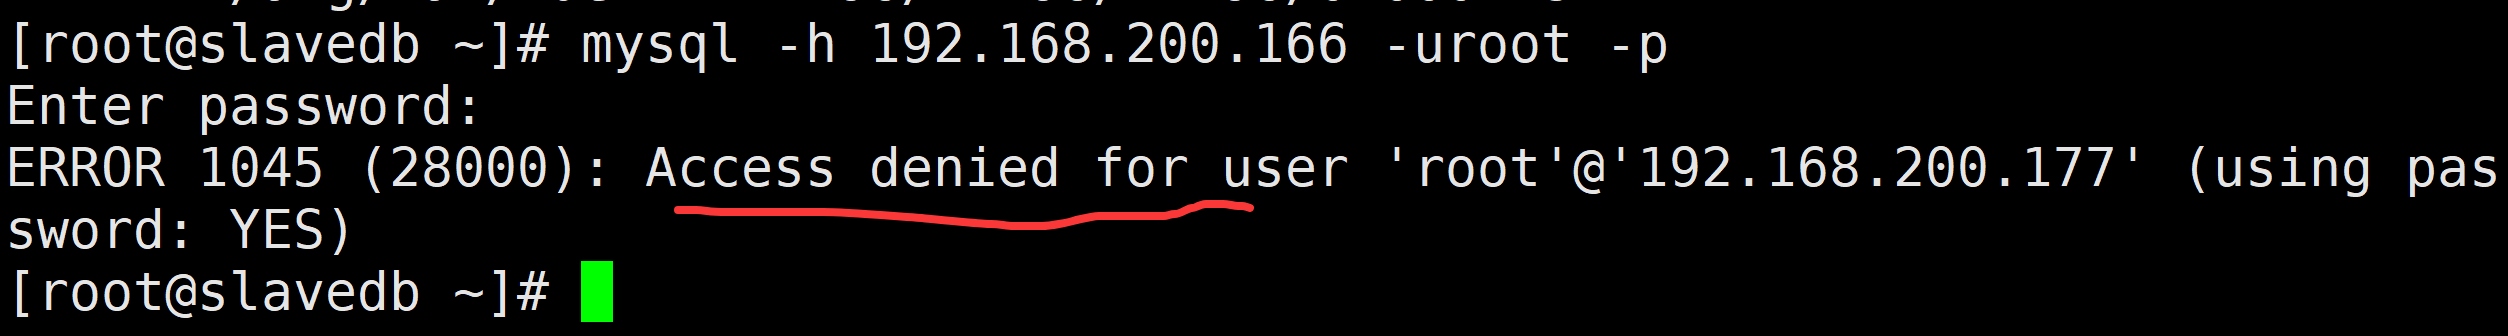
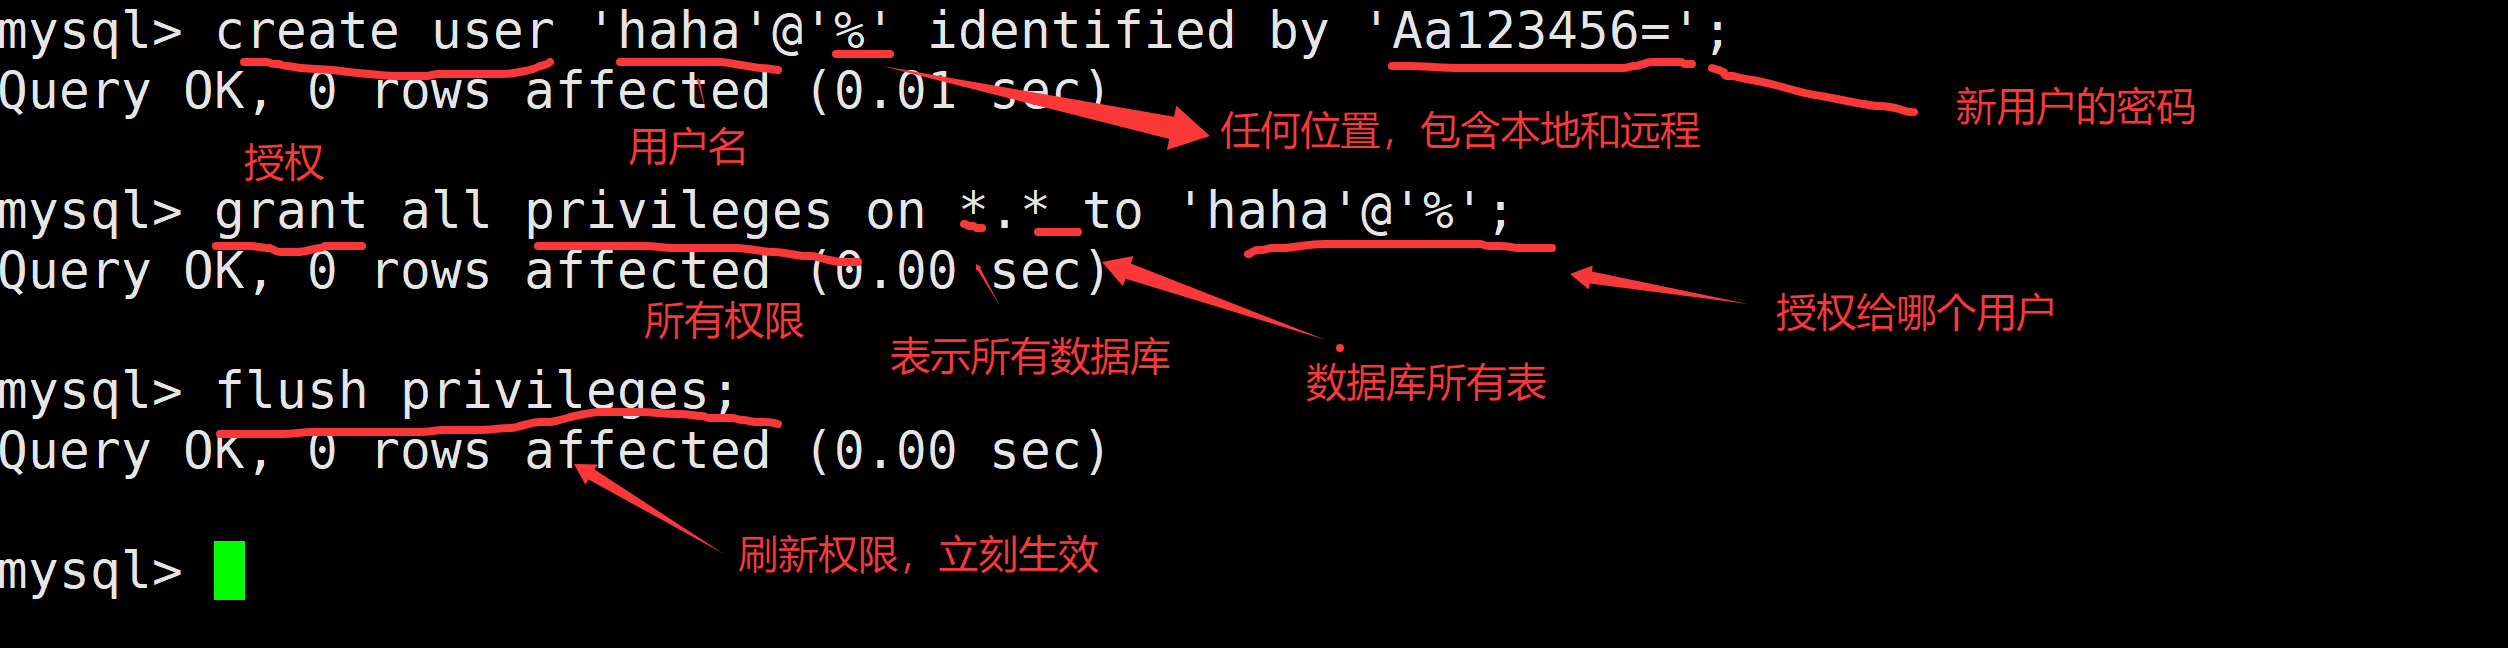
    • 需要授权远程登录
    授权
    creatae user 'root'@'%' identified by '123456';
    grant all privileges on *.* to 'root'@'%';
    flush privileges;

    file

    # 客户端远程连接数据库
    mysql -h 192.168.200.166 -uhaha -p

    3.mysqldunmp数据库备份

    • mysqldump 是 MySQL 自带的备份工具。可以保证数据的一致性和服务的可用性
    • 它的备份原理是通过协议连接到 MySQL 数据库,将需要备份的数据查询出来,将查询出的数据转换成对应的 insert 语句,当我们需要还原这些数据时,只要执行这些 insert 语句,即可将对应的数据还原

    MySQLdump 使用 MySQL 客户端协议(MySQL Client/Server Protocol)连接到数据库服务器。这是一种基于 TCP/IP 的二进制协议,用于客户端(如 mysql 命令行、MySQL Workbench、mysqldump)与 MySQL 服务器之间的通信。默认通过 3306 端口通信,数据以二进制格式传输,相比文本协议更高效,支持加密(如 SSL/TLS)。

    1)命令格式

    mysqldump [选项] 数据库名   [表名]       > 脚本名
    mysqldump [选项] --数据库名 [选项 表名]   > 脚本名
    mysqldump [选项] --all-databases [选项] > 脚本名

    2)选项说明

    参数名 缩写 含义
    —host -h 服务器IP地址
    —port -P 服务器端口号
    —user -u MySQL 用户名
    —pasword -p MySQL 密码
    —databases -B 指定要备份的数据库
    —all-databases -A 备份mysql服务器上的所有数据库
    —compact 压缩模式,产生更少的输出
    —comments 添加注释信息
    —complete-insert 输出完成的插入语句
    —lock-tables 备份前,锁定所有数据库表
    —no-create-db/—no-create-info 禁止生成创建数据库语句
    —force 当出现错误时仍然继续备份操作
    —default-character-set 指定默认字符集
    —add-locks 备份数据库表时锁定数据库表
    -single-transaction 保证数据的一致性和服务的可用性
    —master-data=1\ 2 通常等于1,记录binlog日志位置与文件名,追加至备份文件中
    —flush-logs -F 备份之前刷新日志
    —events -E 备份事件调度器代码
    —triggers -T 备份触发器
    —routines -R 备份存储过程和存储函数

    备份所有数据库

    mysqldump --all-databases -uroot -p  > all.db
    还原数据库:
    mysql -uroot -p < all.db

    备份单个数据库或数据表

    • 需要手动创建数据库
    # 备份单个数据库
    mysqldump  -uroot -p cloud2 > cloud2.db
    # 需要手动创建数据库
    mysqladmin -uroot -p create cloud2
    # 还原数据库
    mysql -uroot -p cloud2 < clou2.db
    
    # 备份数据表
    mysqldump -uroot -p cloud2 students > students.db
    # 需要手动创建数据库
    mysqladmin -uroot -p create cloud2
    # 还原数据表
    mysql -uroot -p cloud2 < clou2.db
    • 不需要手动创建数据库 –databases
    mysqldump  -uroot -p   --databases cloud2 > cloud2.db
    # 不需要手动创建数据库,直接还原
    mysql -uroot -p  < clou2.db
    
    # 备份多个数据库
    mysqldump -uroot -p --databases cloud2 woniu >  cloud3.db
    # 还原数据库
    mysql -uroot -p  < clou2.db

    shell

    1.shell概述

    1、shell概述

    1.1 shell特点

    是人机交互的接口。

    • 非图形化直接控制系统
    • 自动化运维
    • 容器和云原生

    1.2 编程语言分类

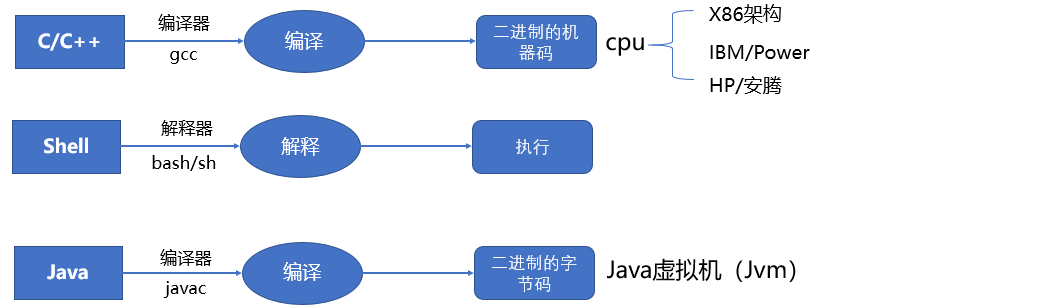
    编程语言总体上分类两类:编译型语言,解释型语言

    • 编译型语言:程序在执行之前需要一个专门的编译过程==,把程序编译成为机器语言文件,运行时不需要重新翻译,直接使用编译的结果就行了。程序执行效率高,依赖编译器,跨平台性差些。如C、C++、java
    • 解释型语言:程序不需要编译,程序在运行时由解释器翻译成机器语言,每执行一次都要翻译一次。因此效率比较低。比如Python/JavaScript/ Perl /ruby/Shell等都是解释型语言

    执行流程:

    • 编译型语言:源代码 → 编译器(Compiler)→ 机器码(二进制文件)→ 直接执行
    • 解释型语言:源代码 → 解释器(Interpreter)→ 逐行解释执行

    file

    1.3 shell脚本基础

    • 概述

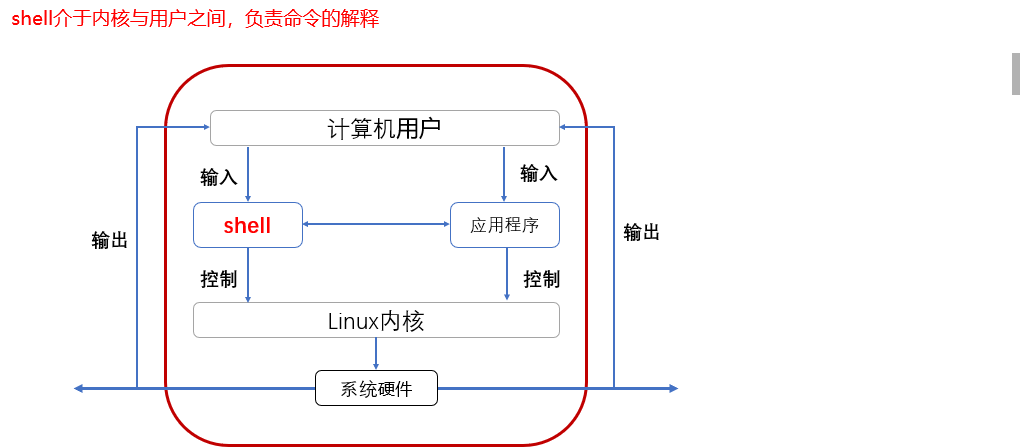
      Shell是指操作系统的用户界面,提供了一种与内核进行交互的方式,也被称为命令解释器。Shell可以让用户通过命令行或脚本来启动、挂起、停止等操作系统级别的程序,也能够进行文件操作、文本处理、调用其他程序等多种操作。通常情况下,Shell是由C语言编写的应用程序,它和命令行交互、解释命令并执行相应的操作。

      Shell通常包含两个部分:命令提示符和命令行解释器。


      • 命令提示符是Shell给出的提示,例如”$“、”%”等,用于提示用户可以输入命令了。
      • 命令行解释器则负责读取用户输入的命令,并且将其转换为可执行的操作系统命令。

      file


      shell就是人机交互的一个桥梁

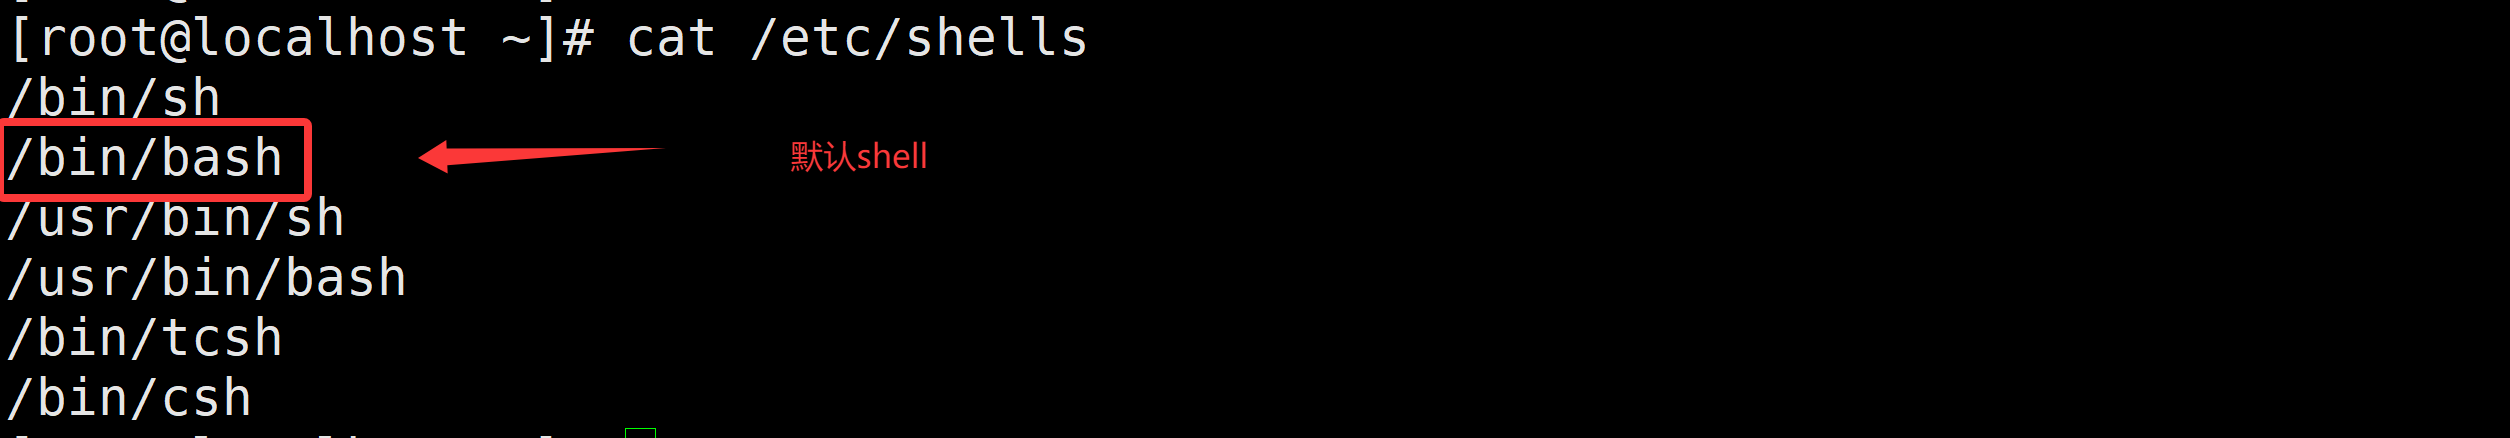
    • 分类

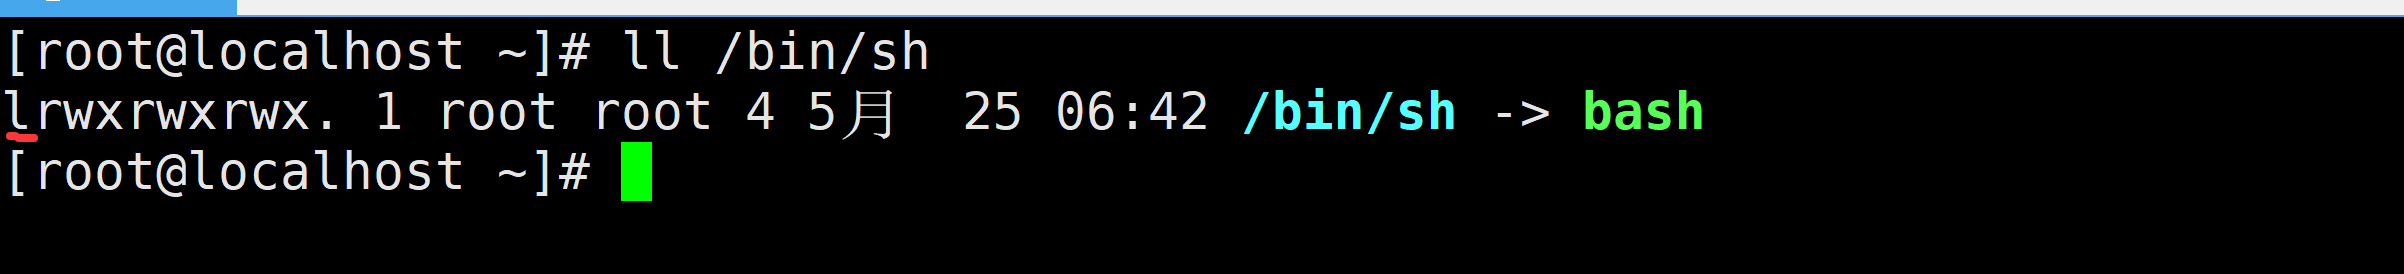
      /bin/sh                #是bash shell的一个快捷方式
      /bin/bash              #bash shell是大多数Linux默认的shell,包含的功能几乎可以涵盖shell所有的功能
      /sbin/nologin          #表示非交互,不能登录操作系统
      /bin/dash              #小巧,高效,功能相比少一些
      /bin/tcsh              #是csh的增强版,完全兼容csh
      /bin/csh               #具有C语言风格的一种shell,具有许多特性,但也有一些缺陷

      查看当前shell:

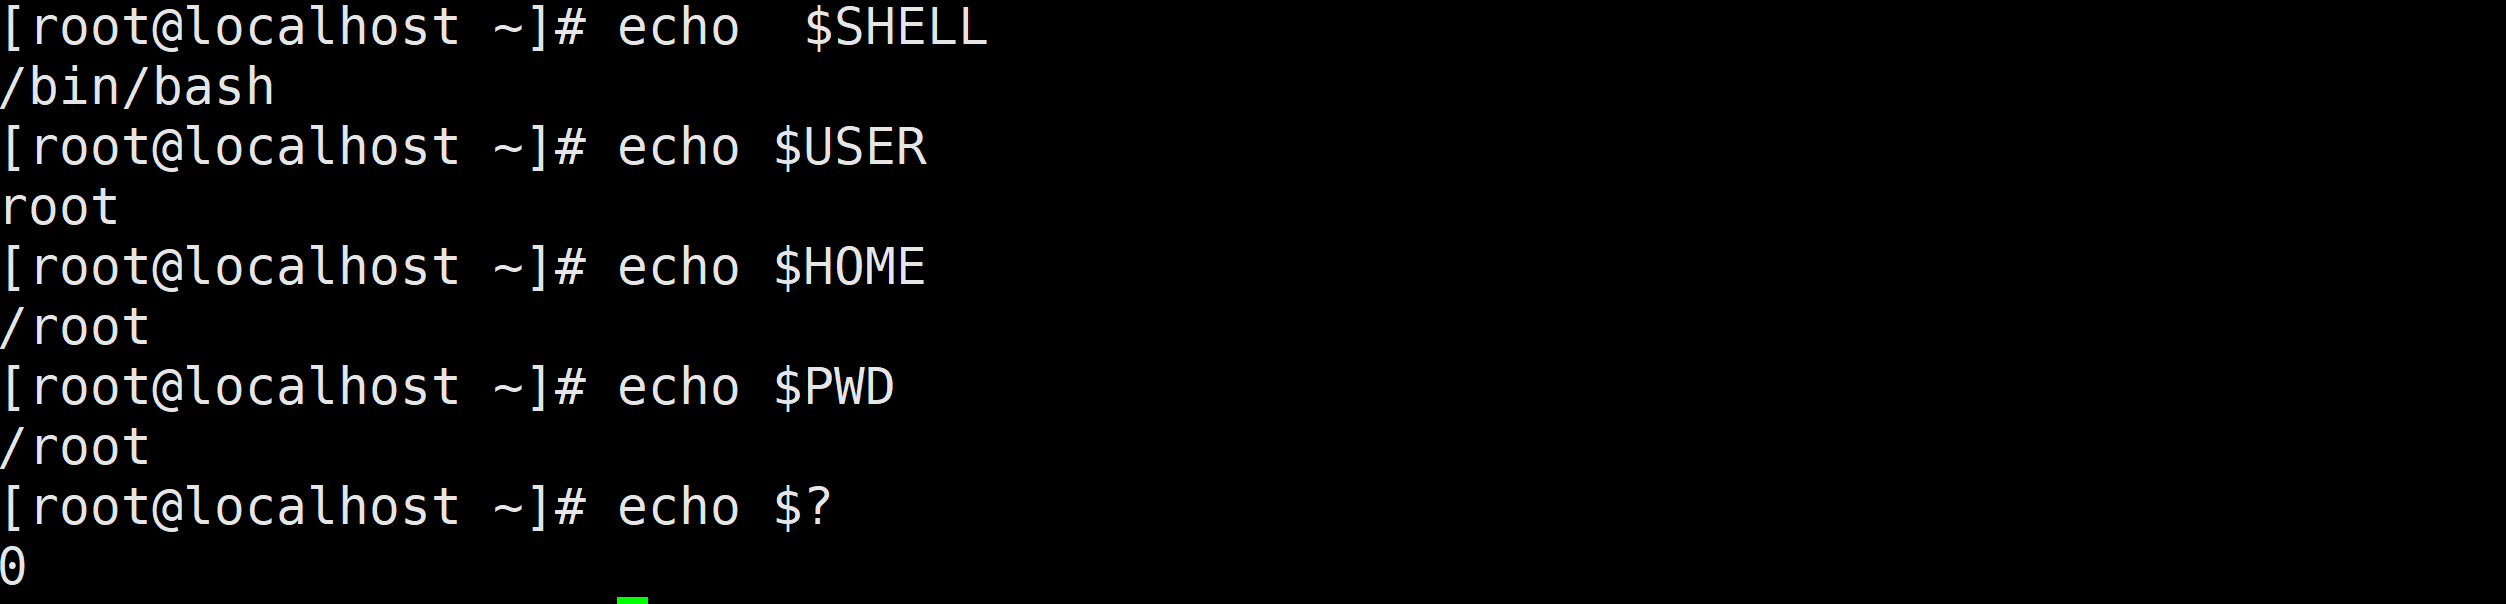
      [root@localhost ~]# echo $SHELL
      /bin/bash
    file
    file

    四个问题:

      1、查看系统支持的shell
      cat /etc/shells
      2、怎么进入其他的shell
      csh
      3、怎么退出当前shell
      exit
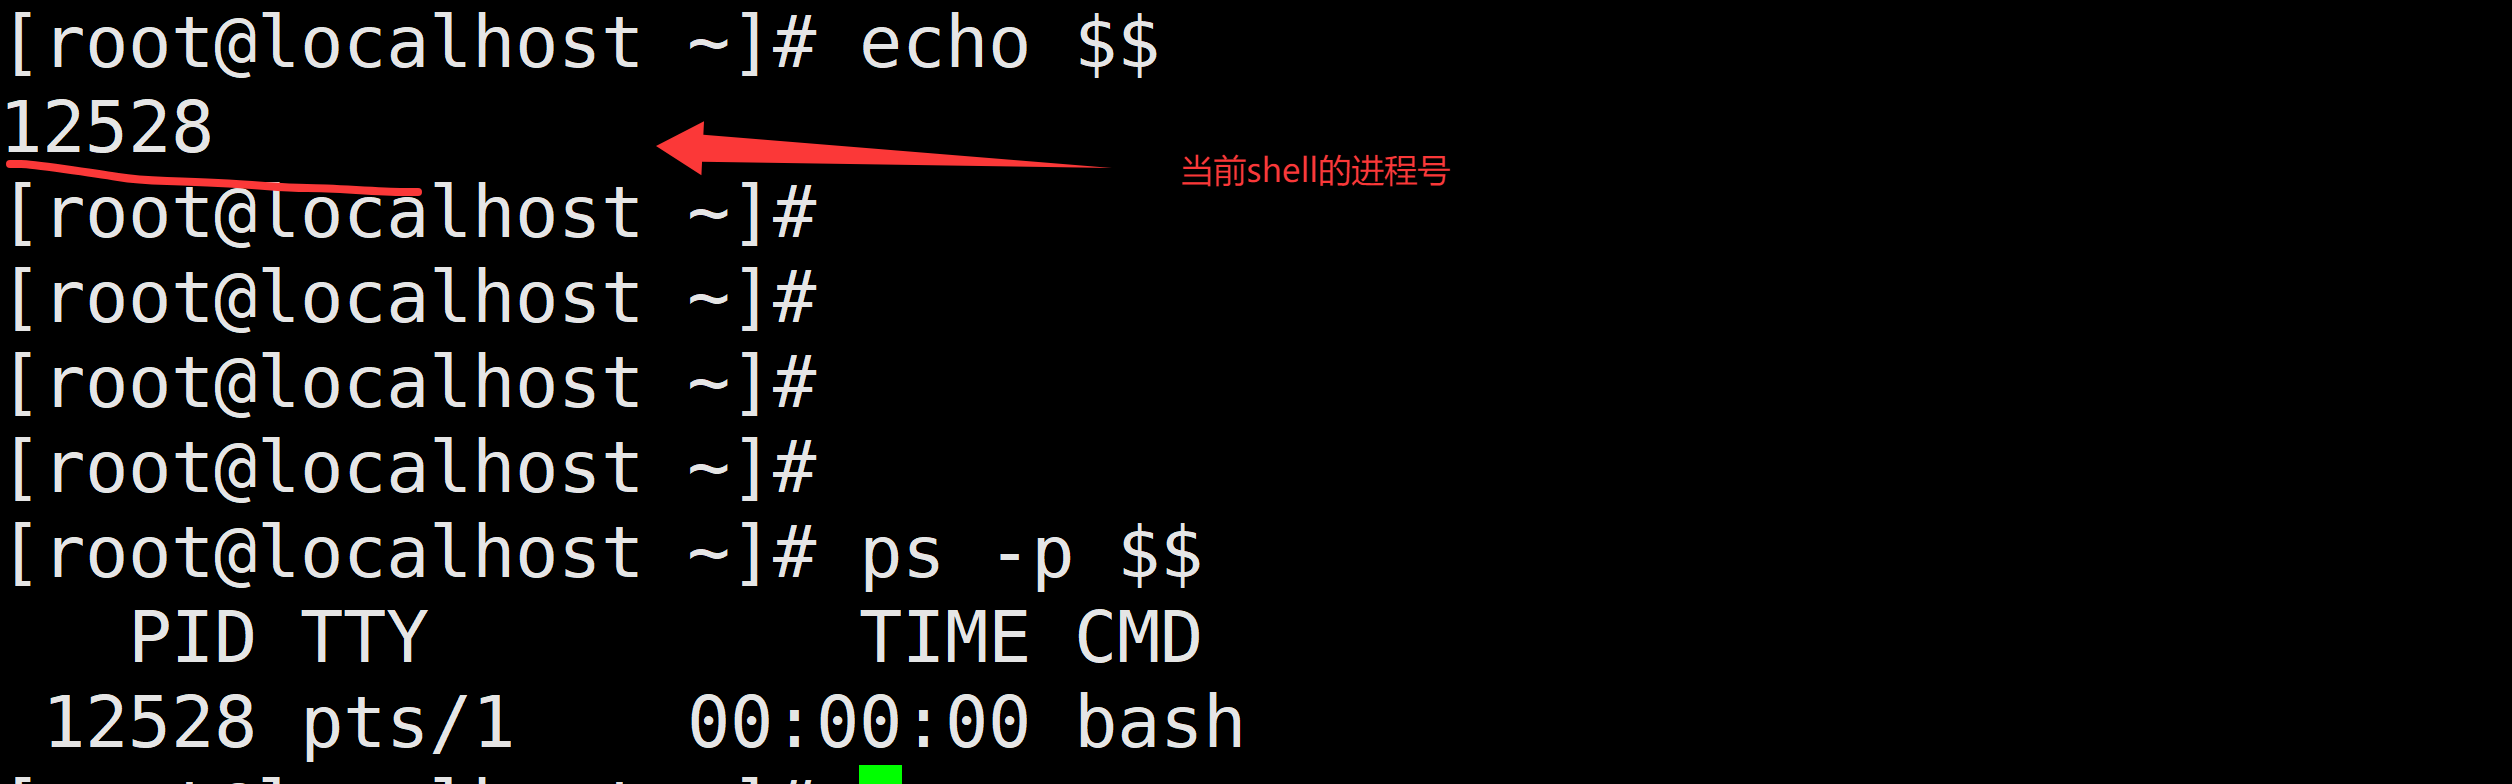
      4、如何查看当前使用的shell是什么shell
      echo $SHELL
      ps -p $$
    • 格式

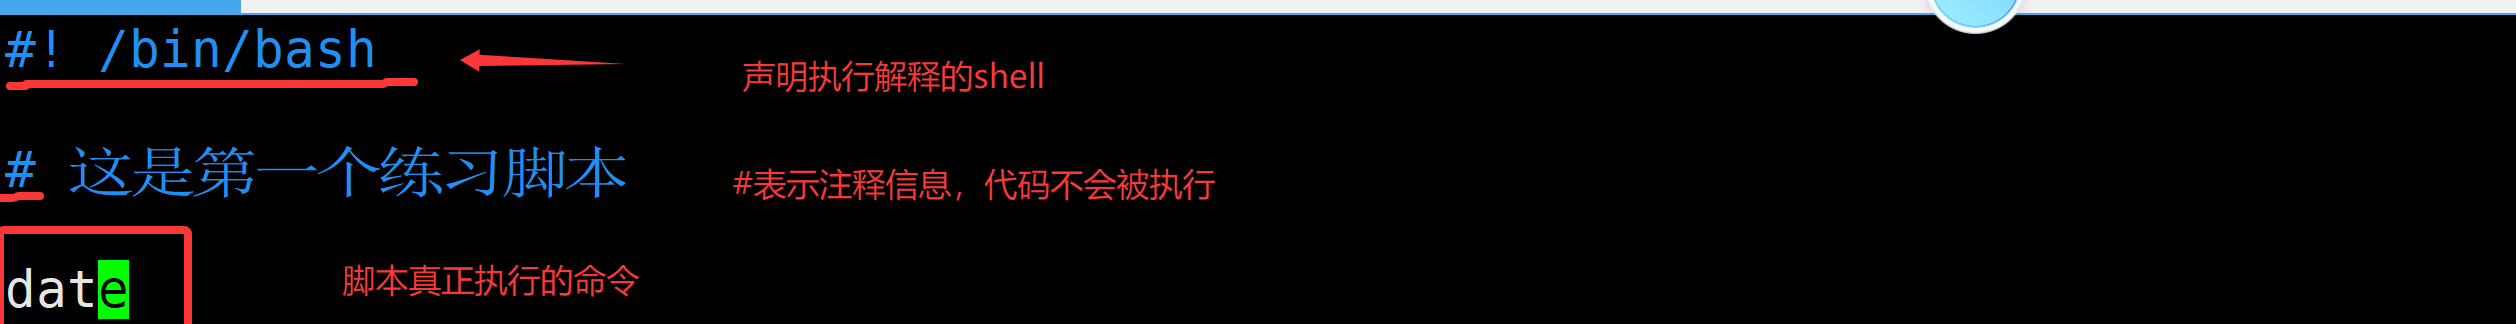
    shell脚本就是说我们把原来 linux 命令或语句放在一个文件中,然后通过这个程序文件去执行时,我们就说这个程序为 shell 脚本或 shell 程序;我们可以在脚本中输入一系统的命令以及相关的语法语句组合,比如变量,流程控制语句等,把他们有机结合起来就形成了一个功能强大的shell 脚本
    file

    1.4 运行方式(重点)

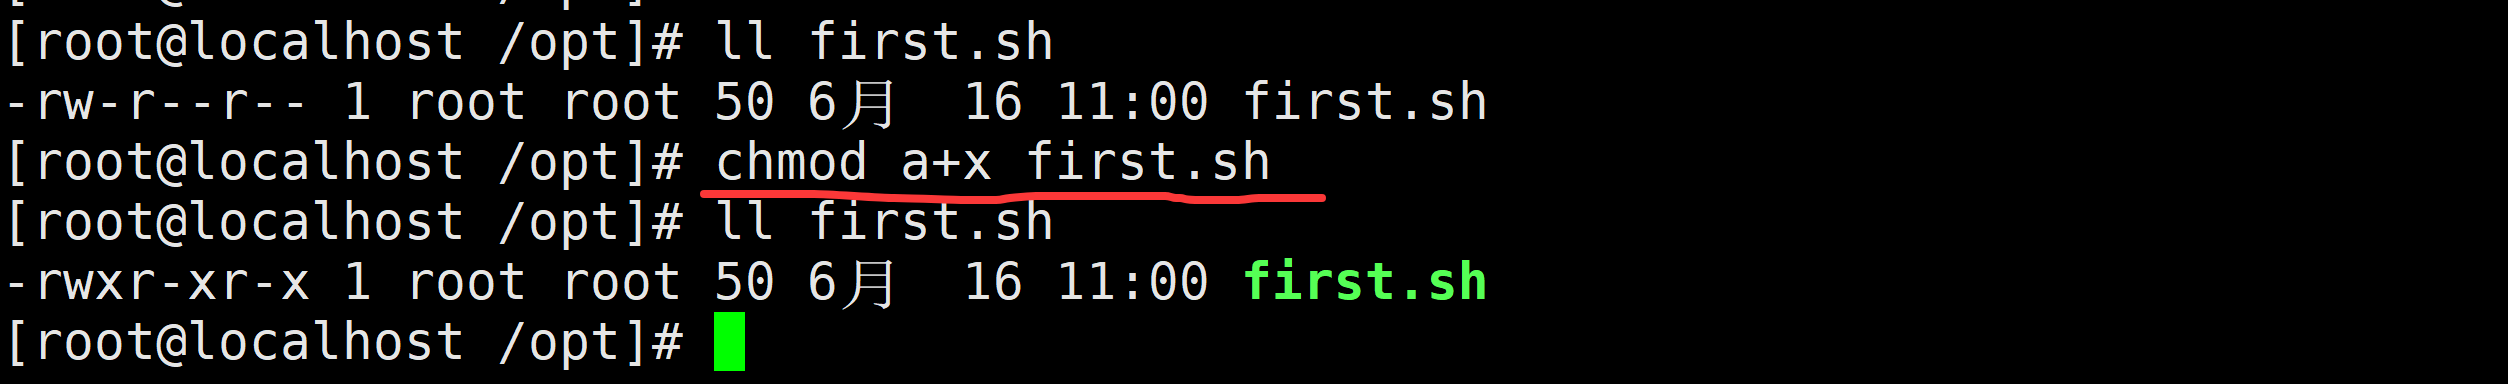
    1)标准运行

    前提:用户对文件要具有可执行权限

    chmod a+x  first.sh
    file

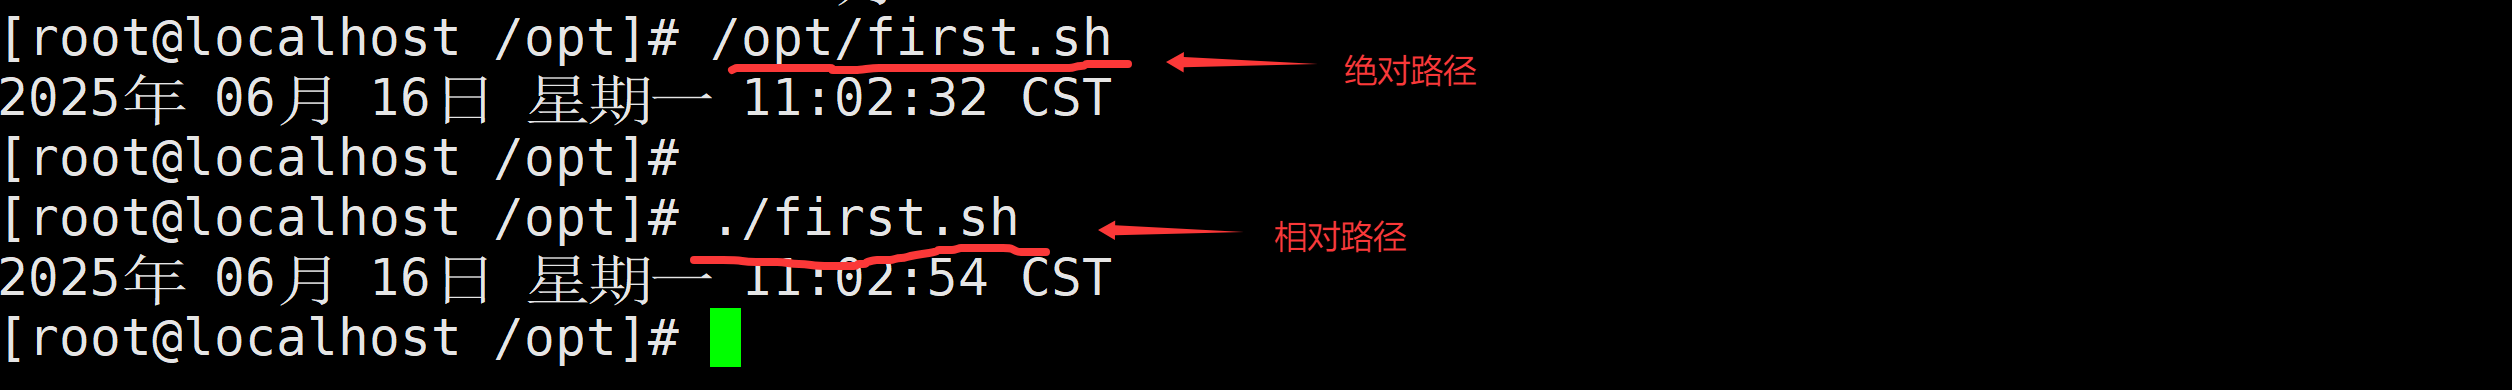
    运行分为绝对路径和相对路径

    file

    2)非标准运行

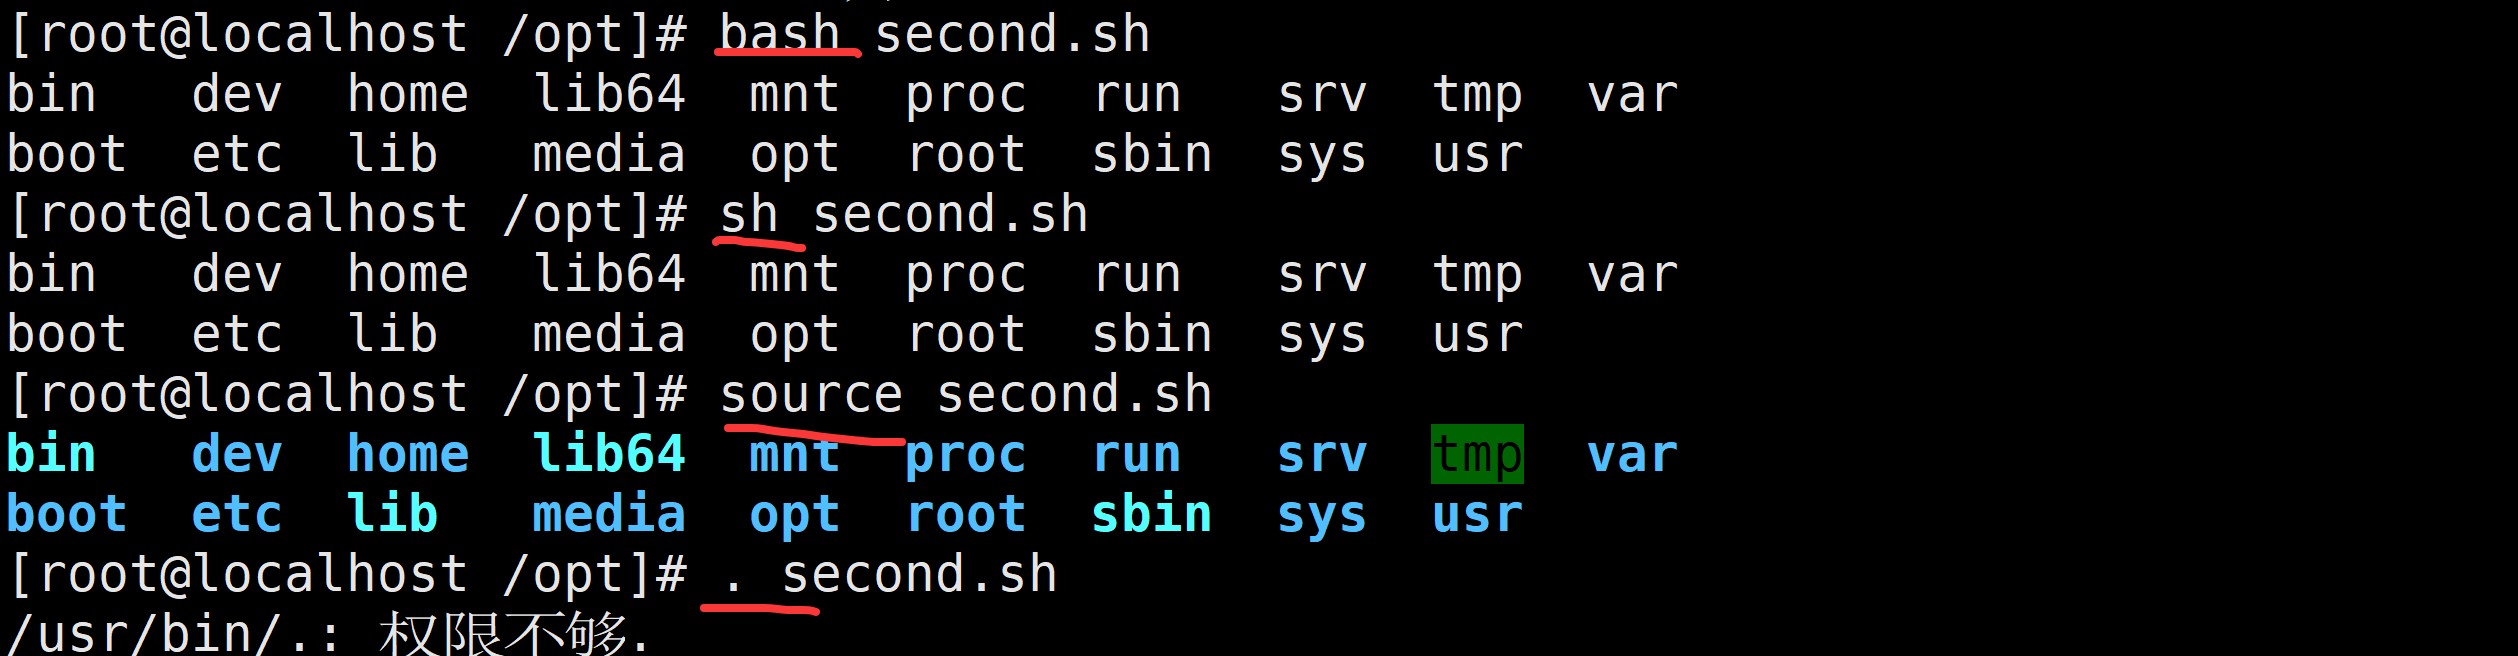
    shell脚本没有可执行权限的情况下

    bash print_date.sh
    bash -x print_date.sh
        -x:一般用于排错,查看脚本的执行过程
        -n:用来查看脚本的语法是否有问题
    sh print_date.sh
    source print_date.sh
    . print_date.sh
    file

    在 Bash 中,source(或简写为.)命令用于在当前 Shell 环境中执行脚本,与直接运行脚本(如bash script.sh)有本质区别。
    bash:新建子 Shell 进程,脚本中的变量仅限于子 Shell,仅修改子 Shell 的环境变量。
    source:直接在当前 Shell 进程中执行脚本,而非创建子 Shell。脚本中定义的变量、函数、环境变量等会直接生效于当前环境。

    2、bash基本特性(掌握)

    2.1 命令和文件自动补全

    执行命令跟使用tab键实现自动补全功能

    2.2 常见的快捷键

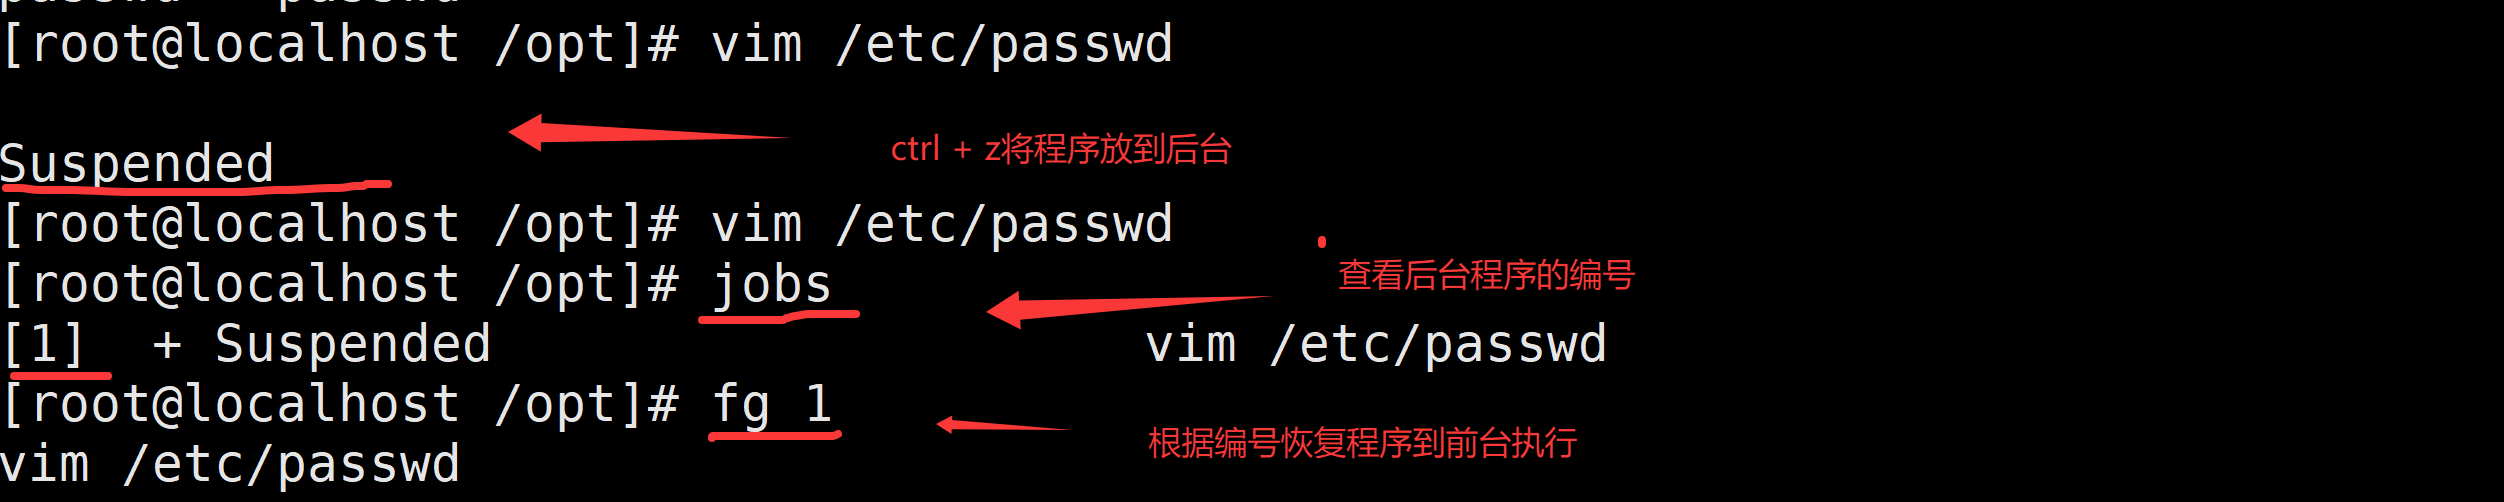
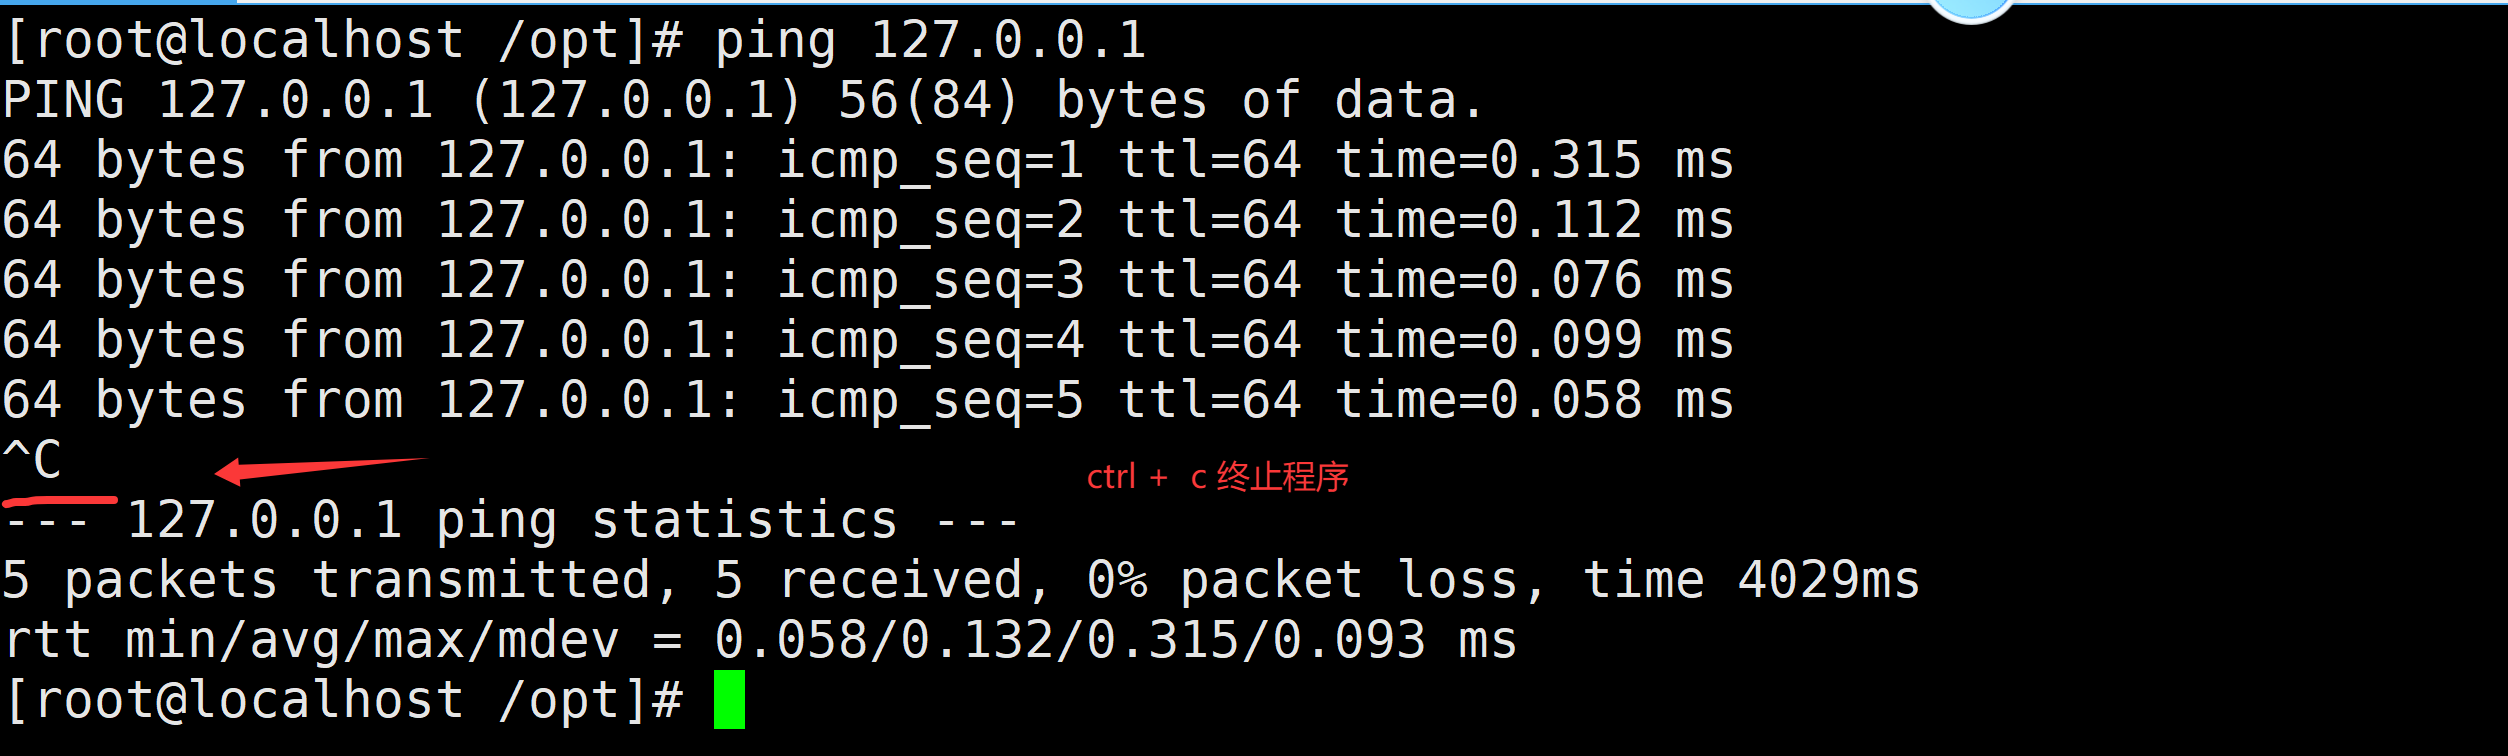
    ctrl + c                                               # 终止前台运行的程序
    ctrl + z                                              # 将前台运行的程序挂起到后台
    ctrl + d                                               # 退出 等价exit
    ctrl + l                                               # 清屏 
    ctrl + a                                              # 光标移到命令行的最前端
    ctrl + e                                               # 光标移到命令行的后端
    ctrl + u                                               # 删除光标前所有字符
    ctrl + k                                               # 删除光标后所有字符
    ctrl + r                                               # 搜索历史命令
    file

    jobs查看后台程序的编号,fg 1 根据编号恢复程序到前台执行

    file

    2.3 常用的通配符

    通配符主要是用于查找,匹配的场景,有了通配符往往会提高我们的查询效率,常用的通配符有:

    *:                        匹配0或多个任意字符
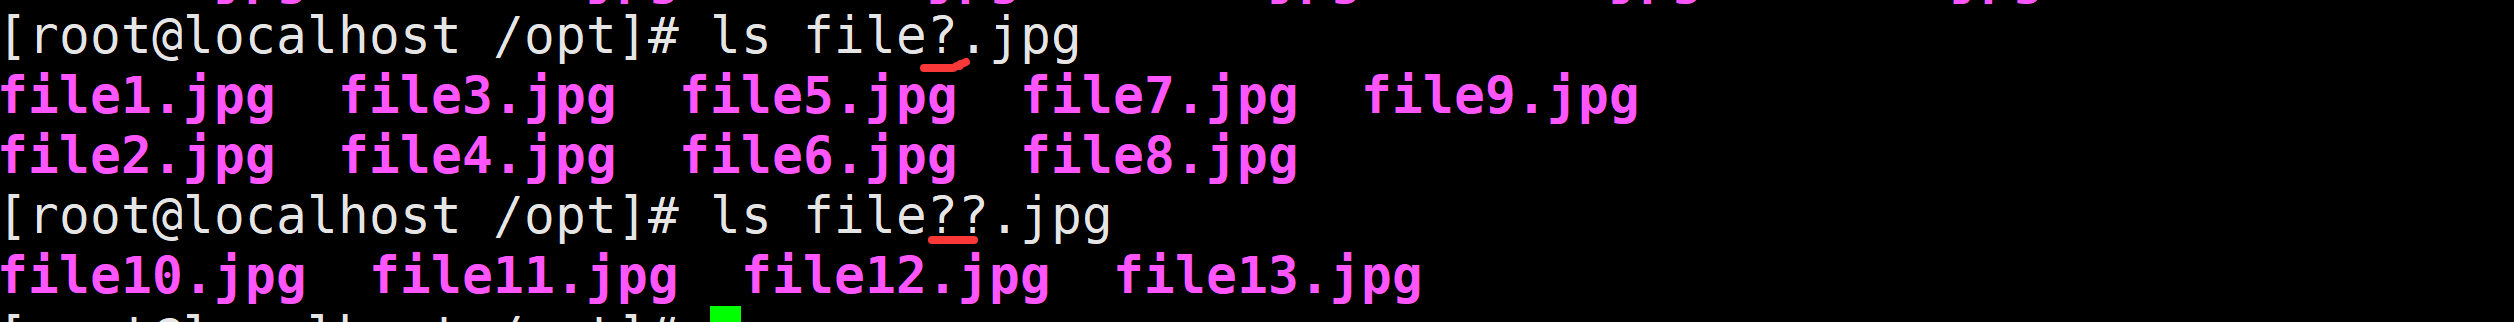
    ?:                        匹配任意单个字符
    [list]:                    匹配[list]中的任意单个字符
    [!list]:                 匹配除list中的任意单个字符
    {string1,string2,...}: 匹配string1,string2或更多字符串

    前提:切换到root账号家目录,清除所有内容,创建一下文件:touch file{1..3} touch file{1..13}.jpg
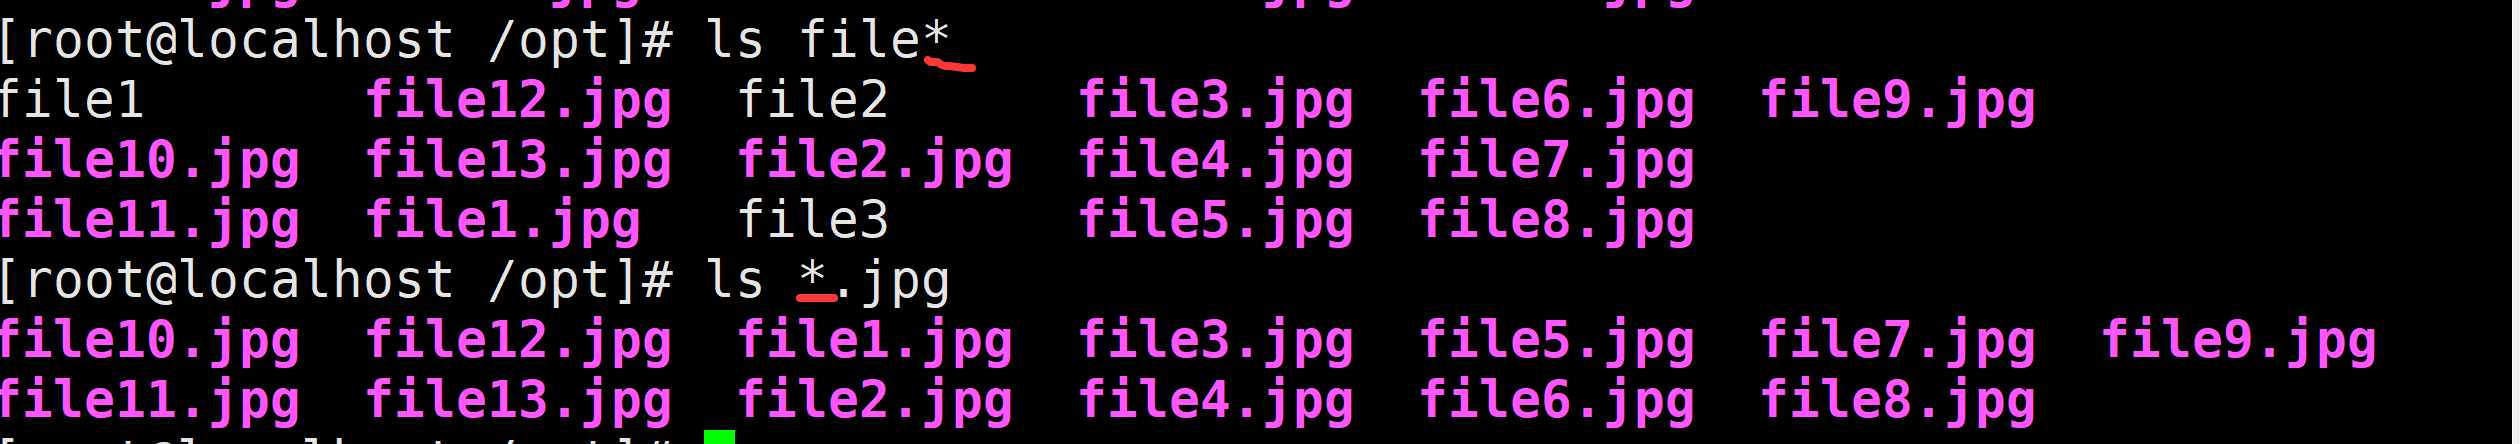
    • 星号 匹配0或多个任意字符

    file

    • ? 匹配任意当个字符

    file

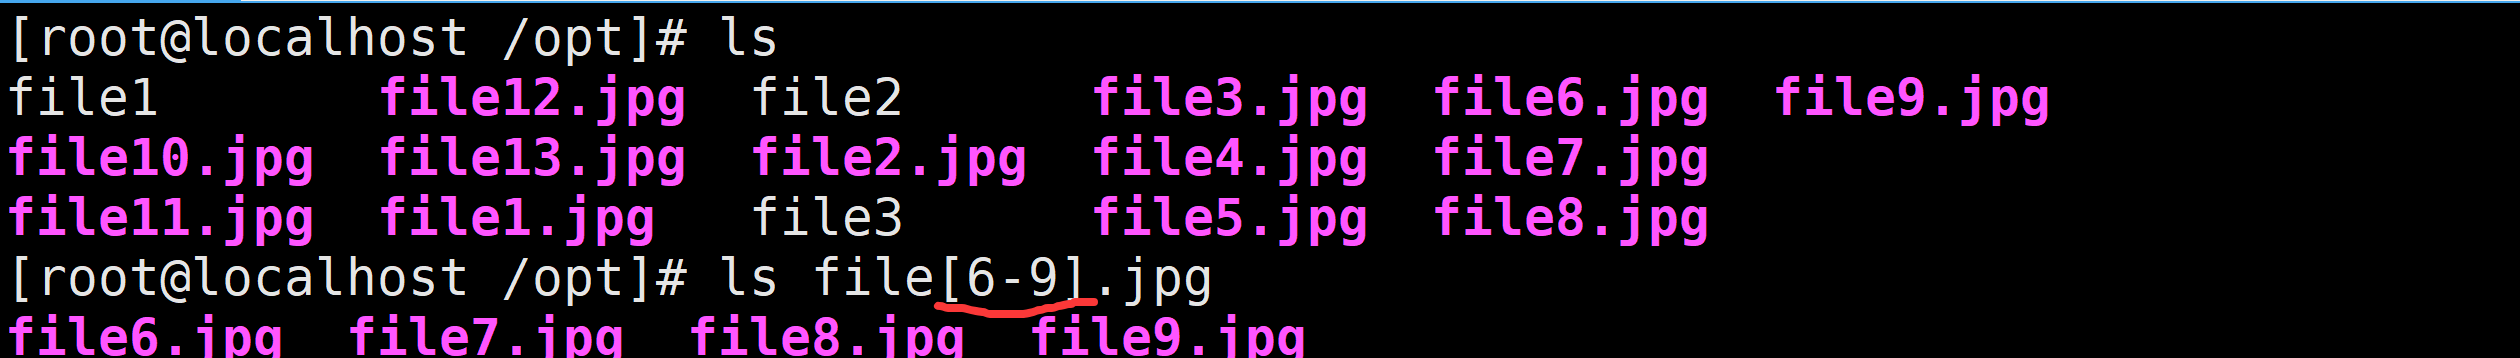
    • [6-9] 匹配一定范围的单个字符![image-file

    • 排除文件

    file

    2.4 引号

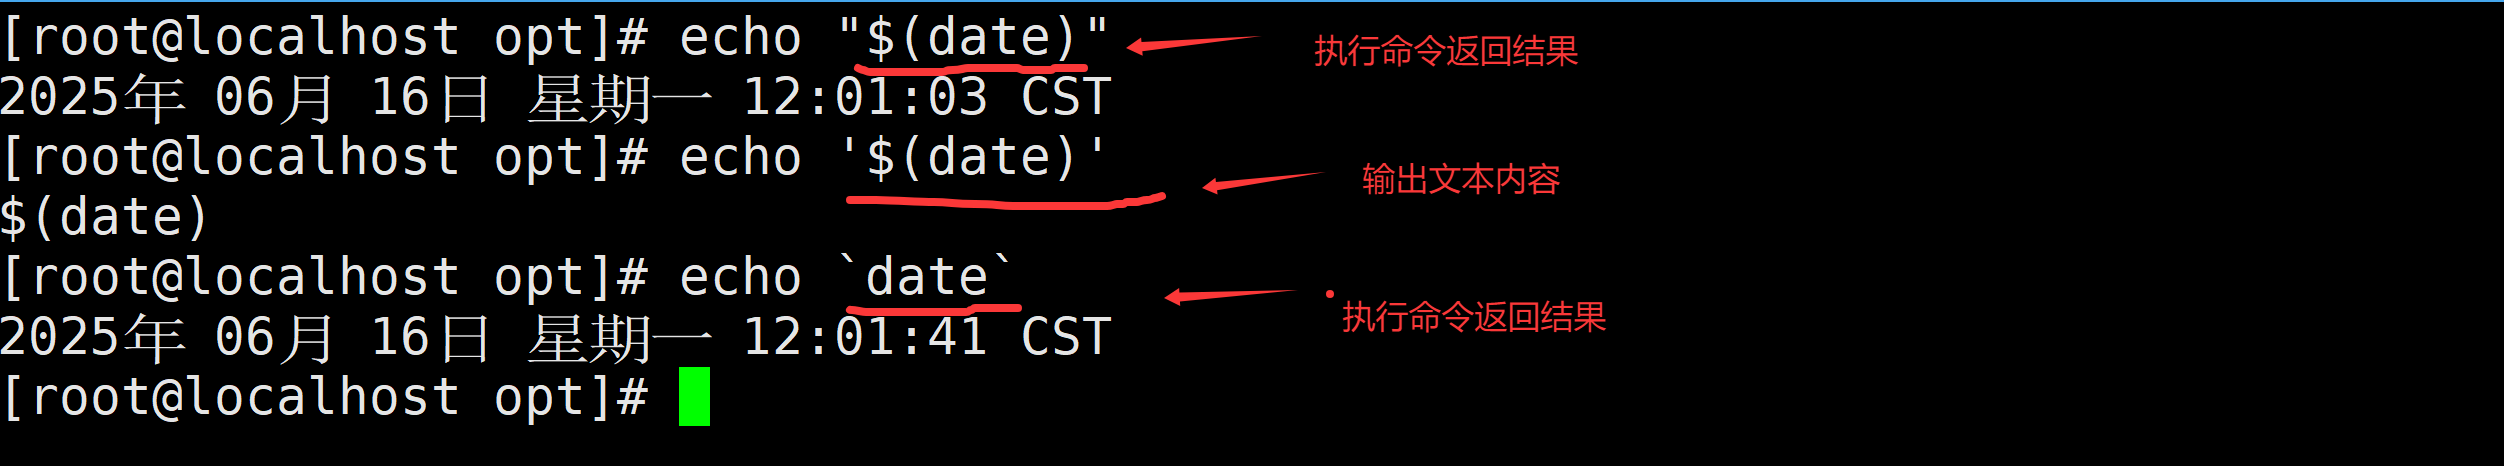
    • 双引号”” : 会把引号的内容当成整体来看待,允许通过$符号引用其他变量值
    • 单引号’’ : 会把引号的内容当成整体来看待,禁止引用其他变量值,shell中特殊符号都被视为普通字符
    • 反撇号`` : 反撇号和$()一样,引号或括号里的命令会优先执行,如果存在嵌套,反撇号不能用

    $(command) 用于命令替换,它执行命令并将输出用作其他命令或变量的值

    双引号: “” 看做一个整体,可以执行命令 $()

    单引号: ‘’ 看做一个整体,不可以执行命令

    反撇号:`` 效果跟$()一样,用于执行命令、
    file

    file

    3、变量分类(重点)

    3.1 概述

    变量:变量指的是系统中可改变的量

    定义:使用=连接,=两边不能有空格。例如:name=zhangsan num=5 java=/usr/local/java

    变量名=变量值

    分类:

    • 本地变量:当前用户自定义的变量。当前进程中有效,其他进程及当前进程的子进程无效,其它用户也无效
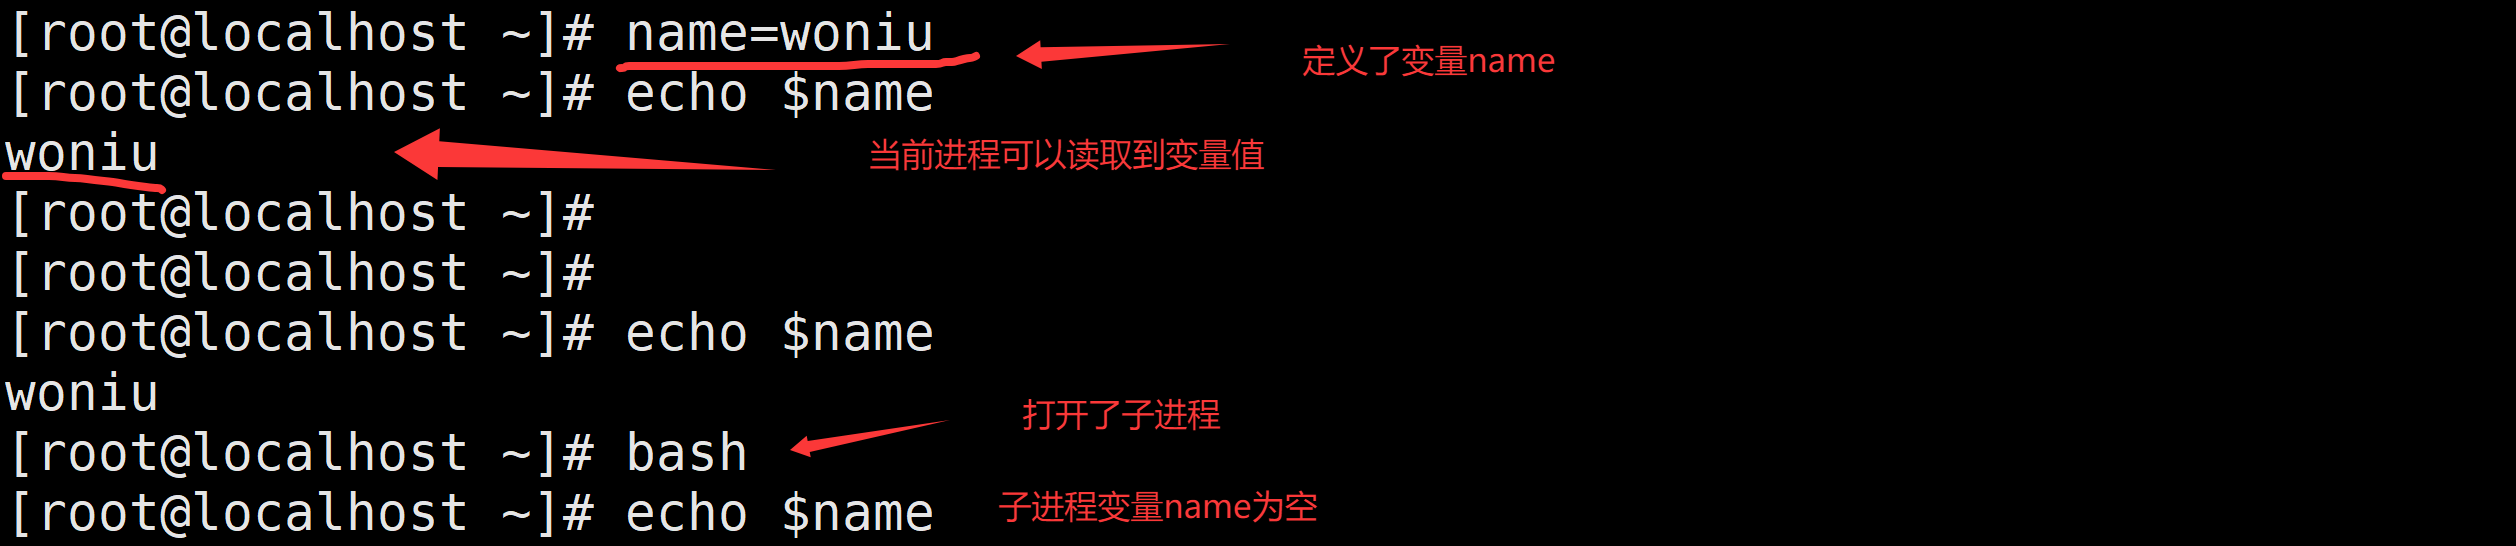
    • 环境变量:当前进程有效,并且能够被子进程调用,其它进程无效,其它用户无效
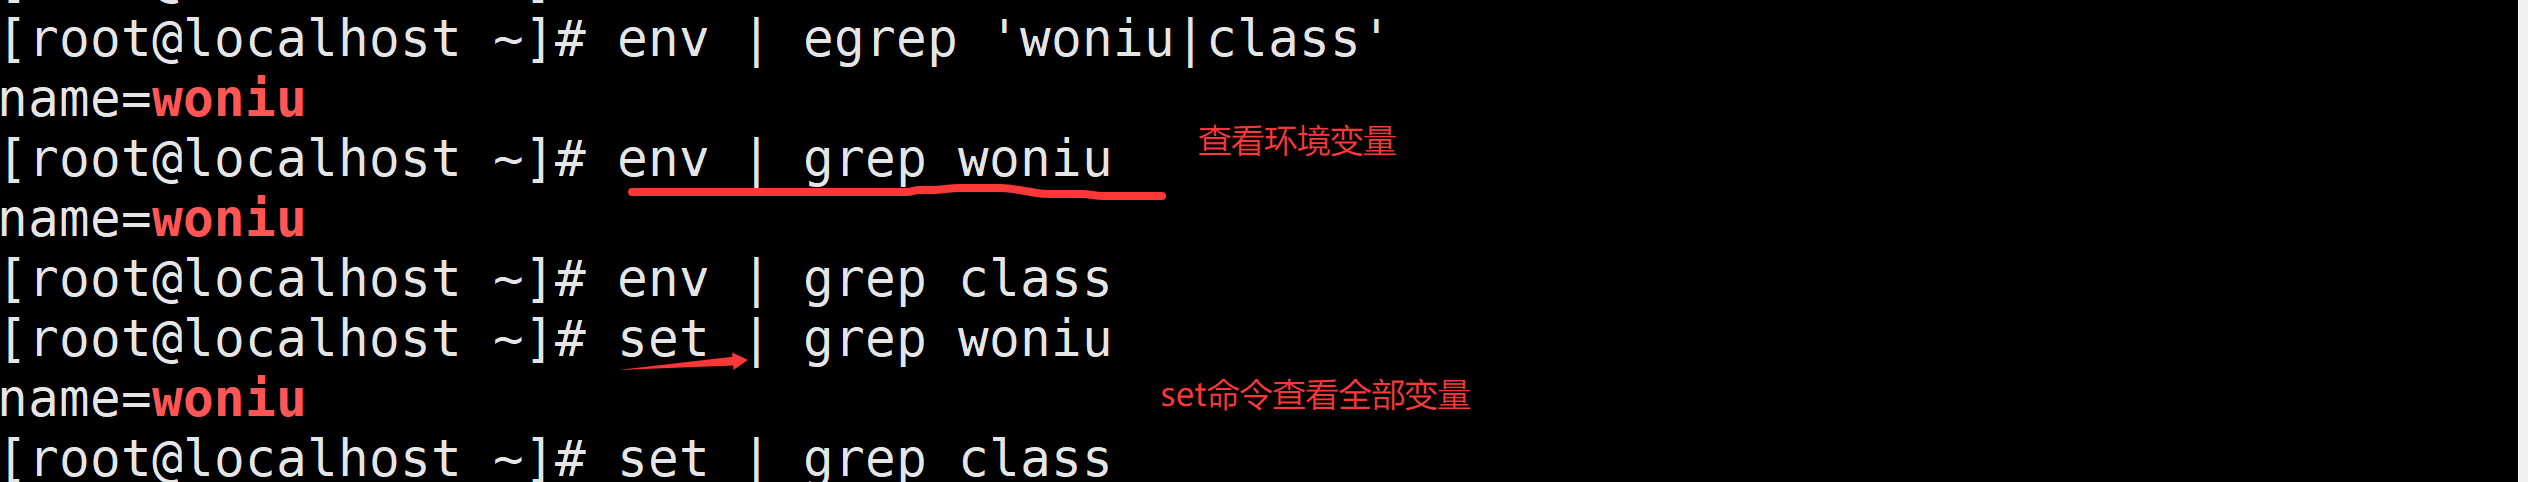
      • 查看当前用户的环境变量:env
      • 查询当前用户的所有变量(临时变量与环境变量) :set
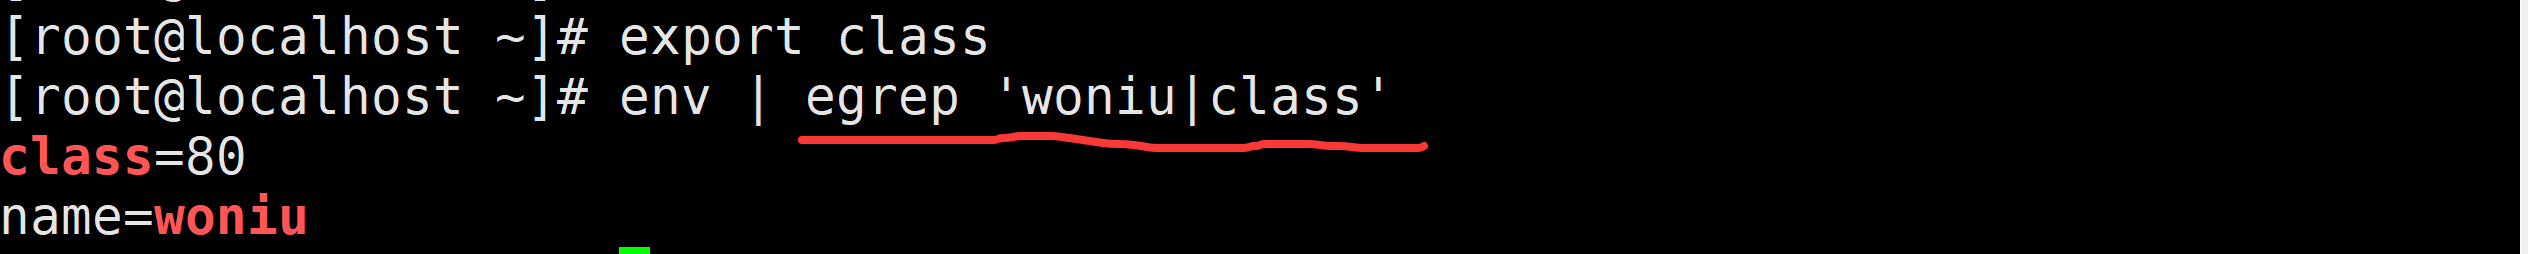
      • 将当前变量变成环境变量:export
    • 系统变量(内置bash中变量) : shell本身已经固定好了它的名字和作用

    3.2 本地变量

    当前用户自定义的变量。当前进程中有效,其他进程及当前进程的子进程无效,其它用户也无效

    file

    3.3 环境变量

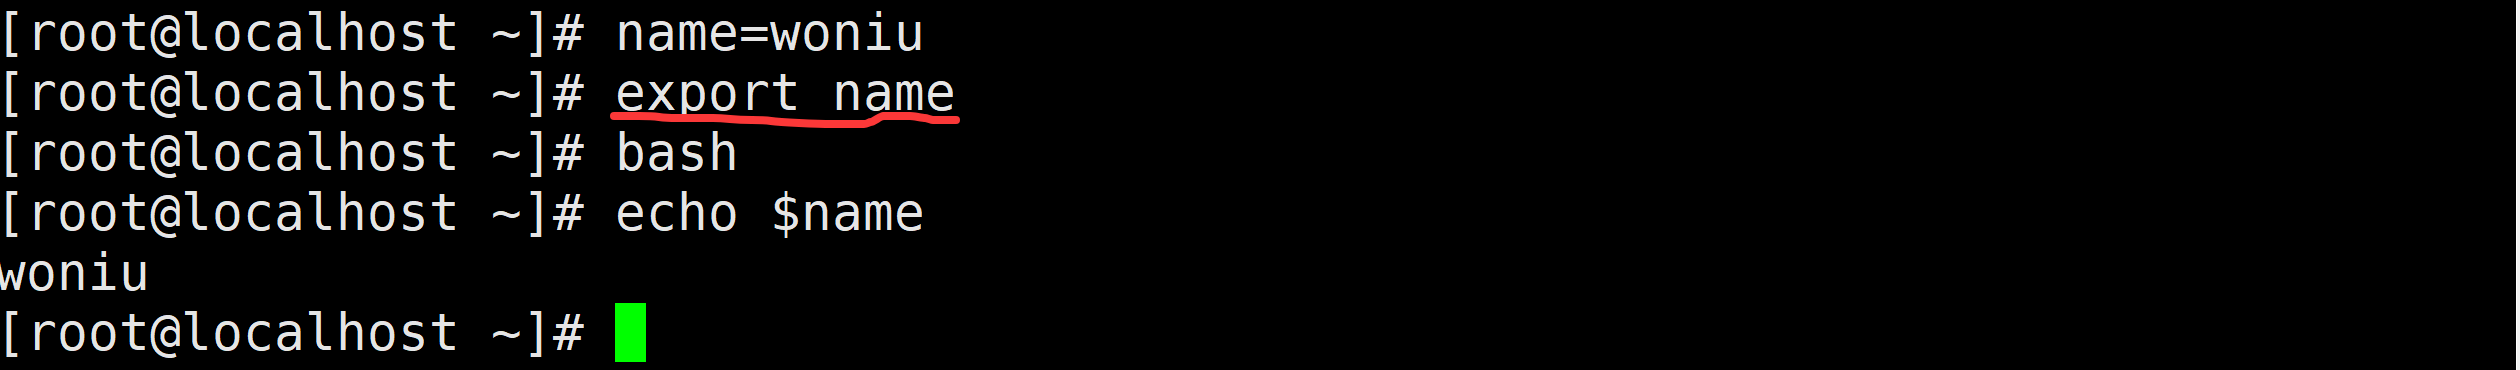
    当前进程有效,并且能够被子进程调用,其它进程无效,其它用户无效

    使用export命令可以将本地变量转化为环境变量
    file

    查看变量(env,set)
    • env - 环境变量
    • set - 全部变量

    file

    file

    3.4 系统变量

    shell本身已经固定好了它的名字和作用

    file

    特殊变量
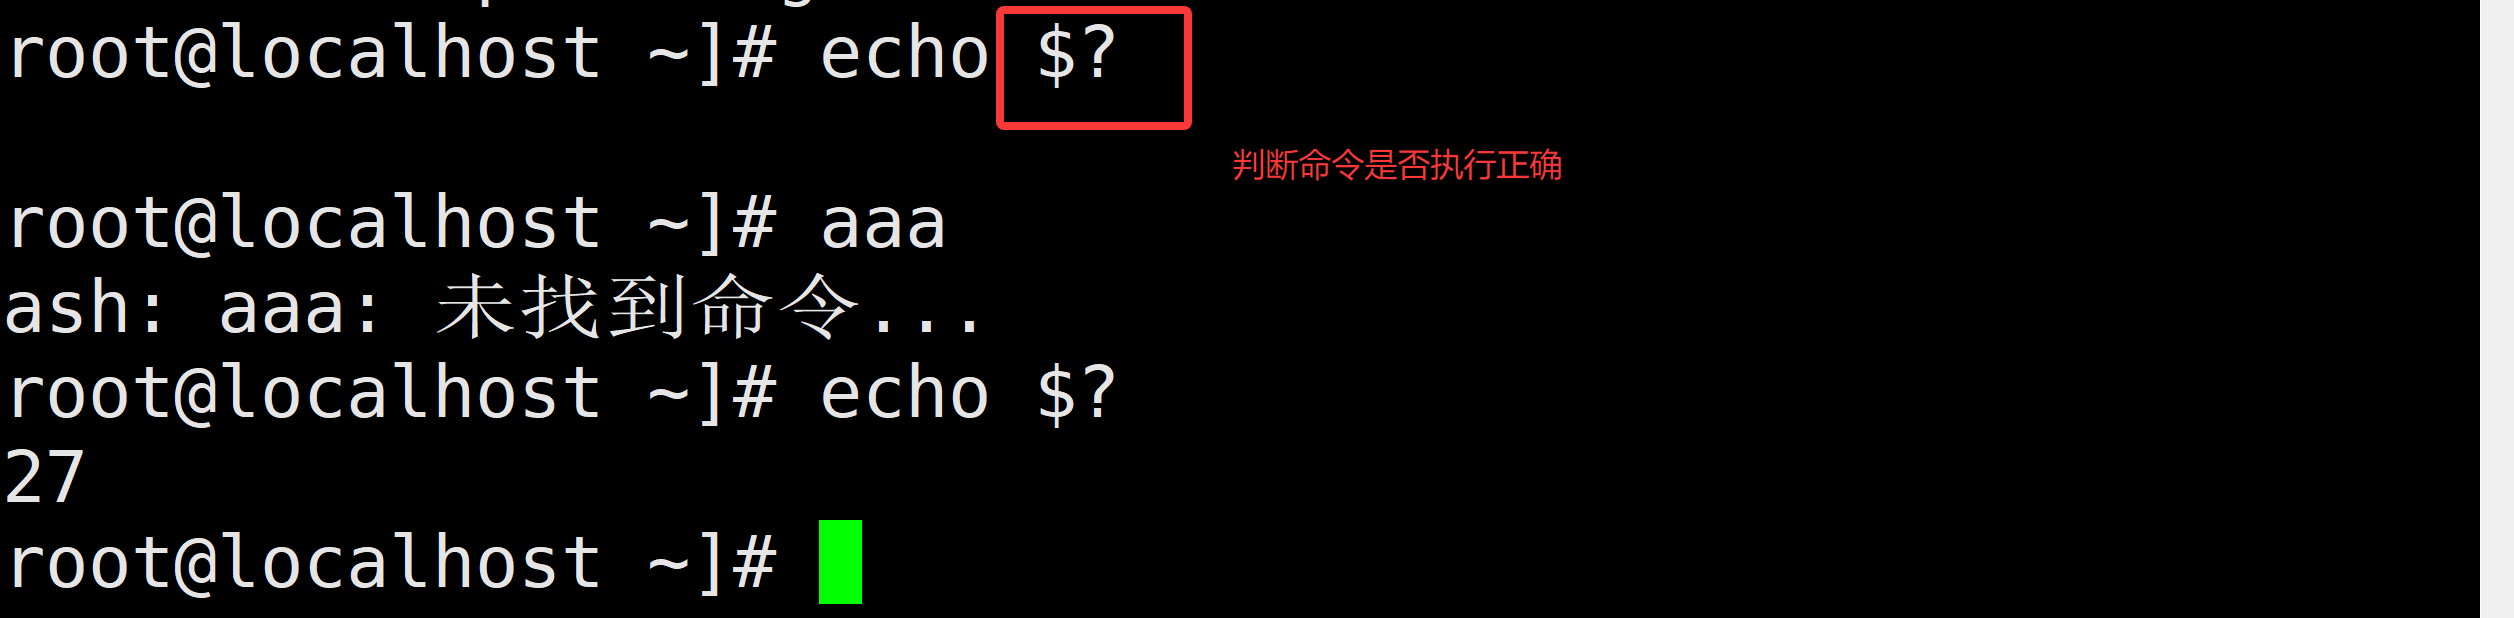
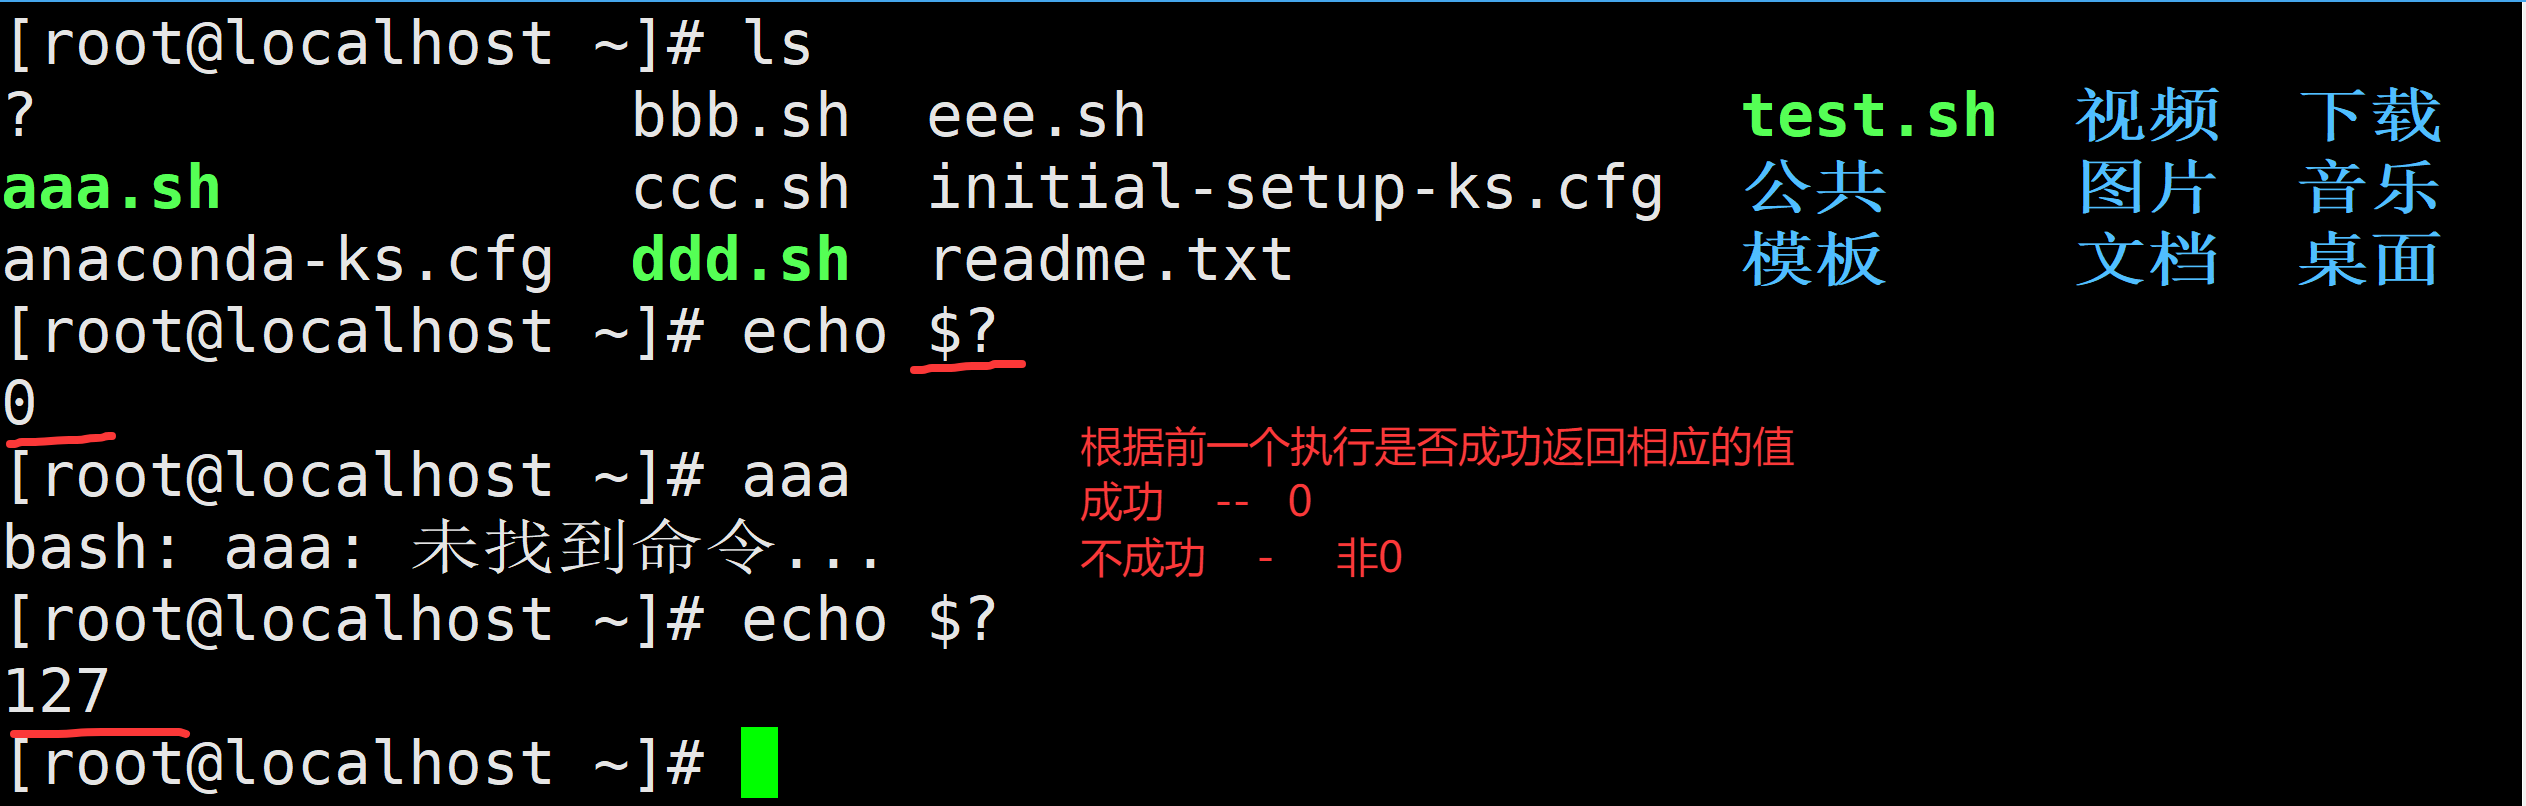
    $?(重要):上一条命令执行后返回的状态,当返回状态值为0时表示执行正常,非0值表示执行异常或出错
     若退出状态值为0,表示命令运行成功
     若退出状态值为127,表示command not found
     若退出状态值为126,表示找到了该命令但无法执行(权限不够)
     若退出状态值为1&2,表示没有那个文件或目录
    $$:当前所在进程的进程号 
    $!:后台运行的最后一个进程号  (当前终端) 
    !$    调用最后一条命令历史中的参数
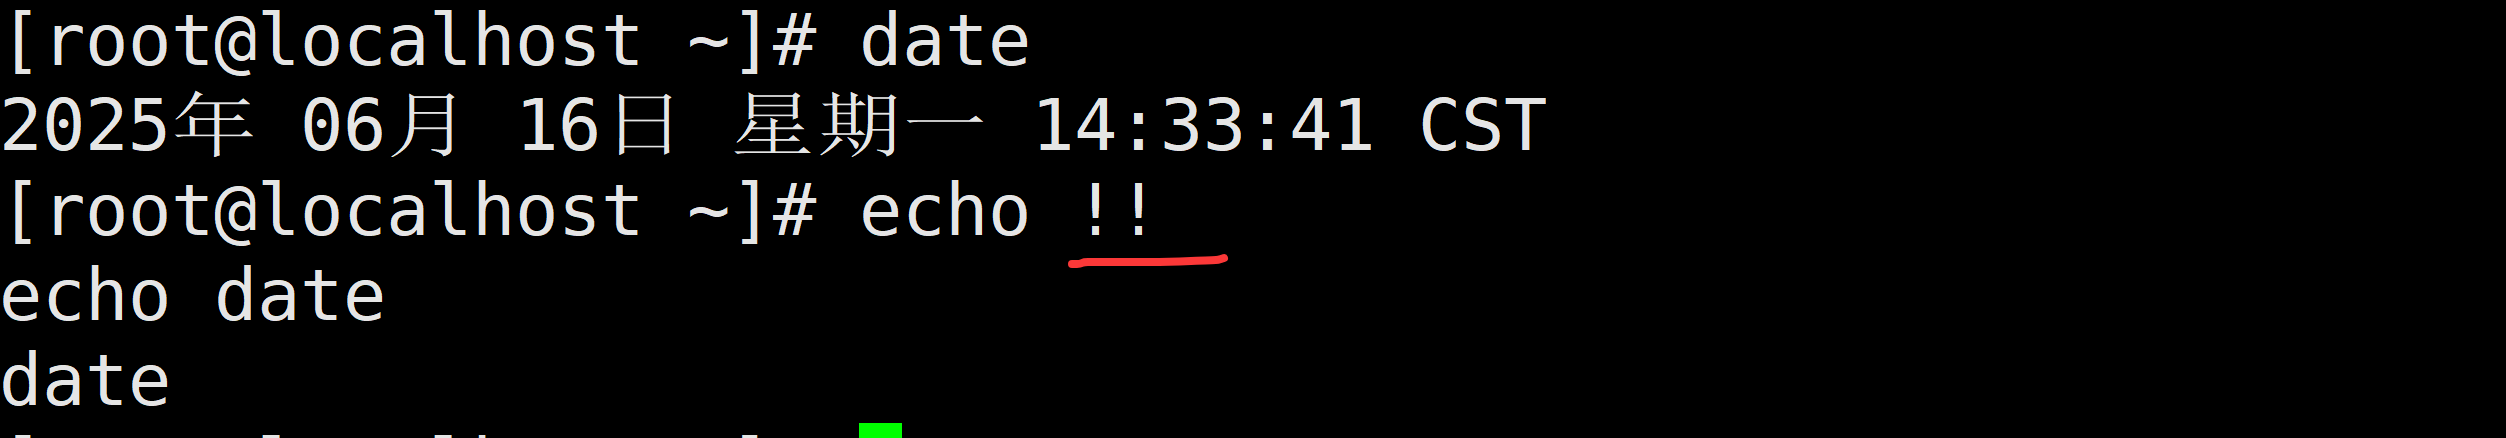
    !!    调用最后一条命令历史
    (重要)
    $#:脚本后面接的参数的个数
    $*:脚本后面所有参数,参数当成一个整体输出,每一个变量参数之间以空格隔开
    $@: 脚本后面所有参数,参数是独立的,也是全部输出
    (重要)
    $0:当前执行的进程/程序名  
    $1~$9 位置参数变量
    ${10}~${n} 扩展位置参数变量  第10个位置变量必须用{}大括号括起来
    file

    file

    file

    3.5 环境变量文件

    环境变量可以理解为全局变量,所谓全局,就是对更大范围的访问生效

    $HOME : 指的是当前用户的家目录

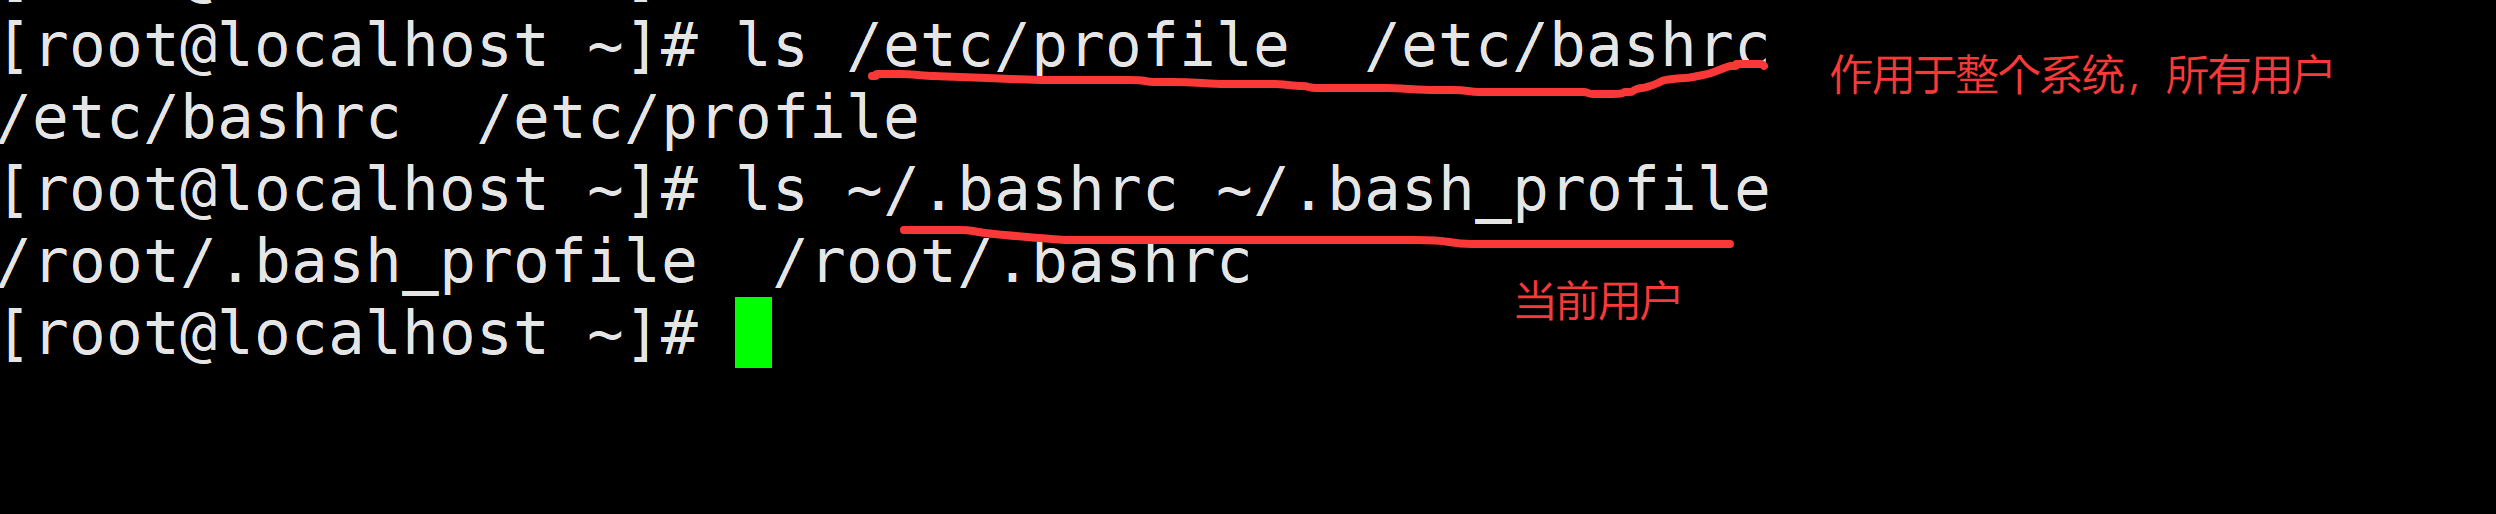
    $HOME/.bashrc                          # 当前用户的bash信息(aliase、umask等)$HOME/.bash_profile                    # 当前用户的环境变量()
    /etc/bashrc                            # 使用bash,shell用户全局变量,别名,全局变量
    /etc/profile                        # 系统和每个用户的环境变量信息,安装应用之后需要配置的地方
    $HOME/.bashrc
    Bash shell 的配置脚本,属于用户级配置文件(仅对当前用户生效)。
    $HOME/.bash_profile
    用户登录时执行的初始化脚本,用于设置环境变量、启动服务等登录相关配置。
    /etc/bashrc
    定义所有用户的交互式 Bash Shell的默认行为,属于系统级配置。
    /etc/profile
    定义所有用户登录时执行的环境变量、全局变量和脚本,属于系统级配置。
    用户级配置(如~/.bash_profile)中的变量会覆盖/etc/profile中的同名变量。
    特性 .bash_profile .bashrc
    执行场景 登录 Shell(如 SSH、本地终端登录) 非登录 Shell(如bash启动的子 Shell)
    执行次数 登录时执行一次 每次启动子 Shell 时执行
    典型用途 环境变量、系统服务启动 别名、函数定义、终端显示优化
    加载顺序 先于.bashrc执行 通常由.bash_profile调用执行

    在 Linux 系统中,这四个配置文件的执行顺序取决于 Shell 的启动方式(登录 Shell 或非登录 Shell)以及 变量的定义位置。以下是详细的执行顺序和覆盖规则:

    一、执行顺序核心规则

    1. 登录 Shell(如 SSH 登录、su - user)
    /etc/profile → ~/.bash_profile → ~/.bash_login → ~/.profile → ~/.bashrc → /etc/bashrc
    • 关键点:
      • 系统级配置优先:先加载 /etc/profile。
      • 用户级配置覆盖:~/.bash_profile 中的变量会覆盖 /etc/profile 中的同名变量。
      • .bashrc 被间接加载:通常在 .bash_profile 中会通过 source ~/.bashrc 引用用户的 .bashrc,而 .bashrc 又会引用 /etc/bashrc。
    1. 非登录 Shell(如直接运行 bash 或执行脚本)
    ~/.bashrc → /etc/bashrc
    • 关键点:


      • 仅加载用户和系统的 bashrc:不执行 /etc/profile 和 ~/.bash_profile。

      • 变量覆盖:~/.bashrc 中的变量会覆盖 /etc/bashrc 中的同名变量。

    4、变量定义

    4.1 变量规则

    变量的定义需要遵循一定的规则,如下:

    • 默认情况下,shell里定义的变量是不分类型的,可以给变量赋与任何类型的值;

    传统编程语言

    string   --    字符串   -   姓名       string name=wangxiaolong  
    
    int     -        整数       --    数字
    
    boolean  --  布尔值 -     真假
    • 等号两边不能有空格,对于有空格的字符串做为赋值时,要用引号引起来;变量名=变量值

    file

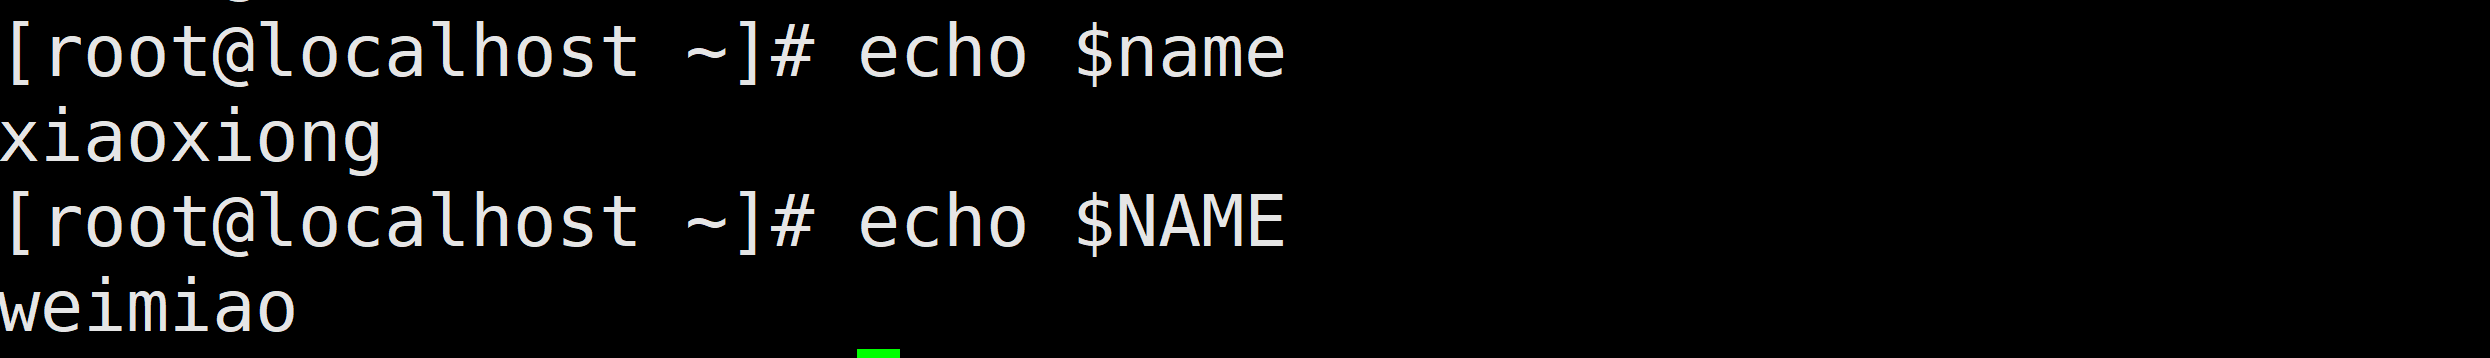
    • 变量名区分大小写

    file

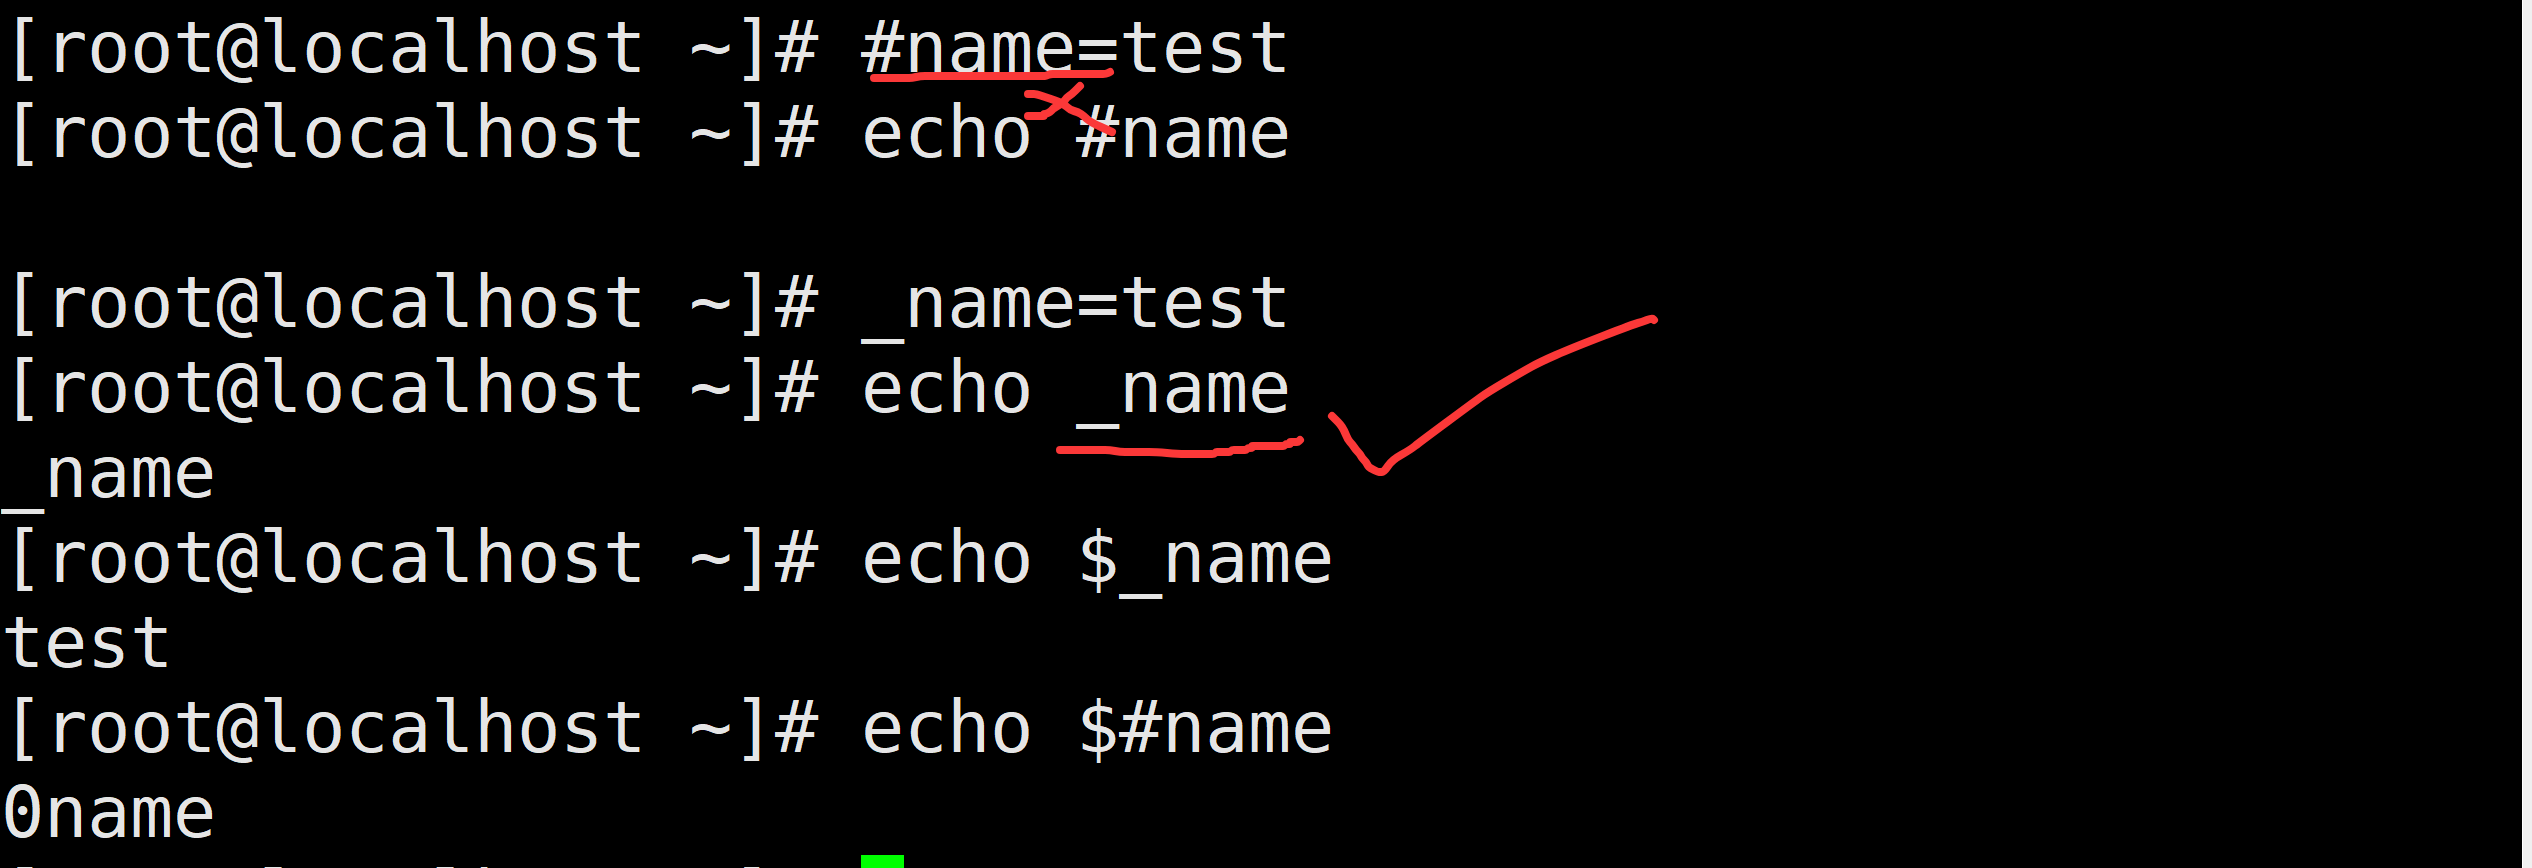
    • 变量名可以是字母或数字或下划线,但是不能以数字开头或者特殊字符(下划线开头可以)
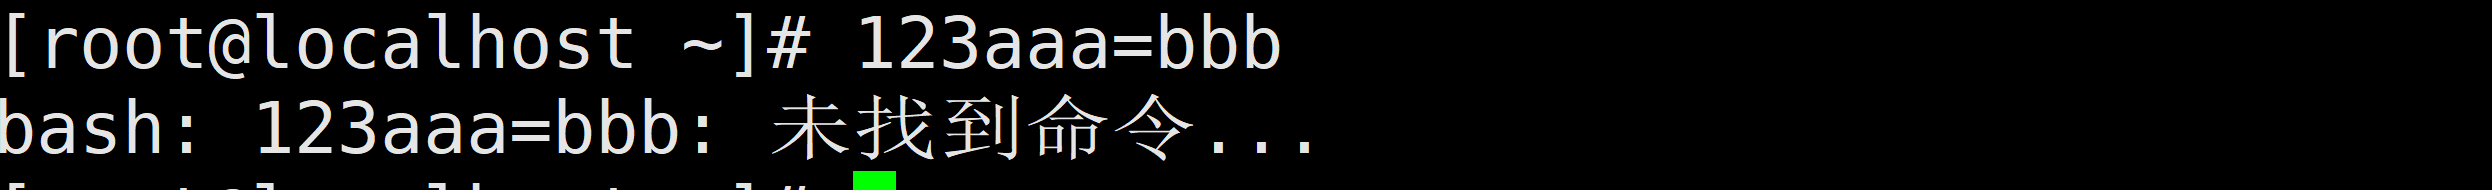
    file

    file

    • 获取变量:$变量名 或者 ${变量名}

    file

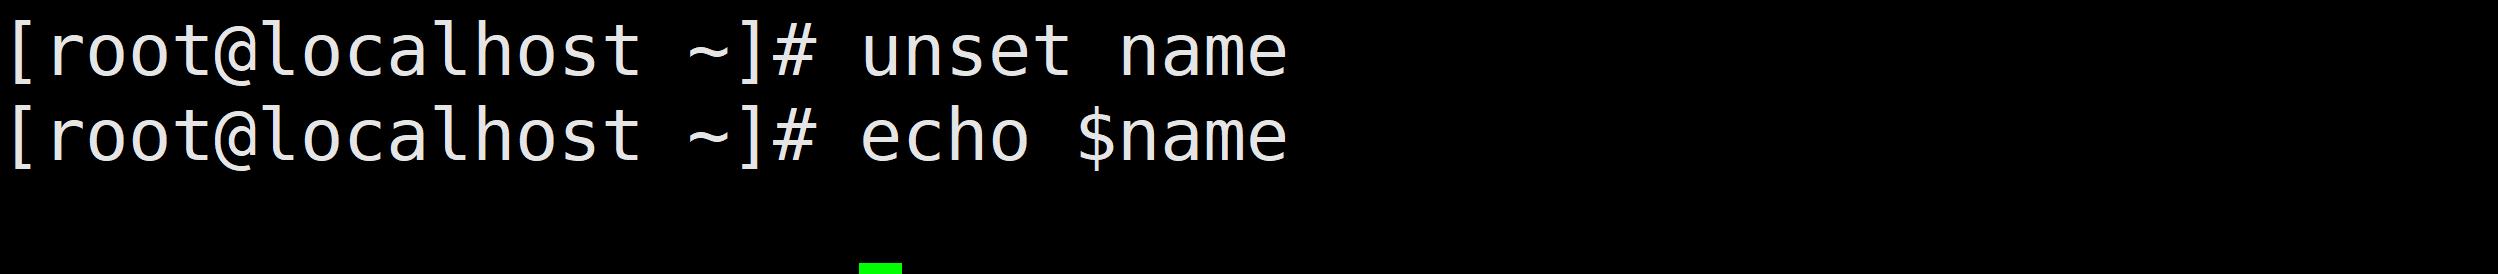
    • 取消变量:unset 变量名

    file

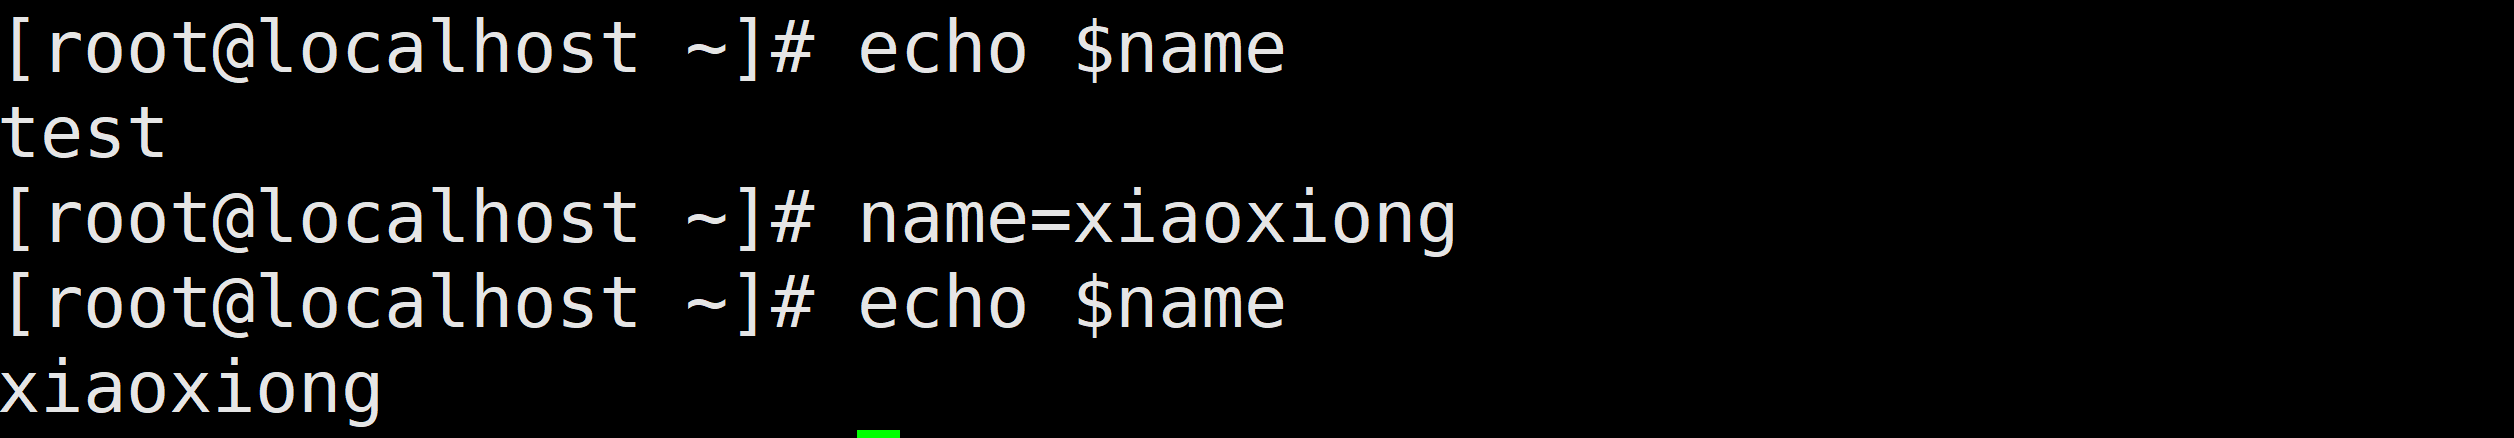
    • 定义变量是,如果该变量名已经存在,则起到修改的效果

    file

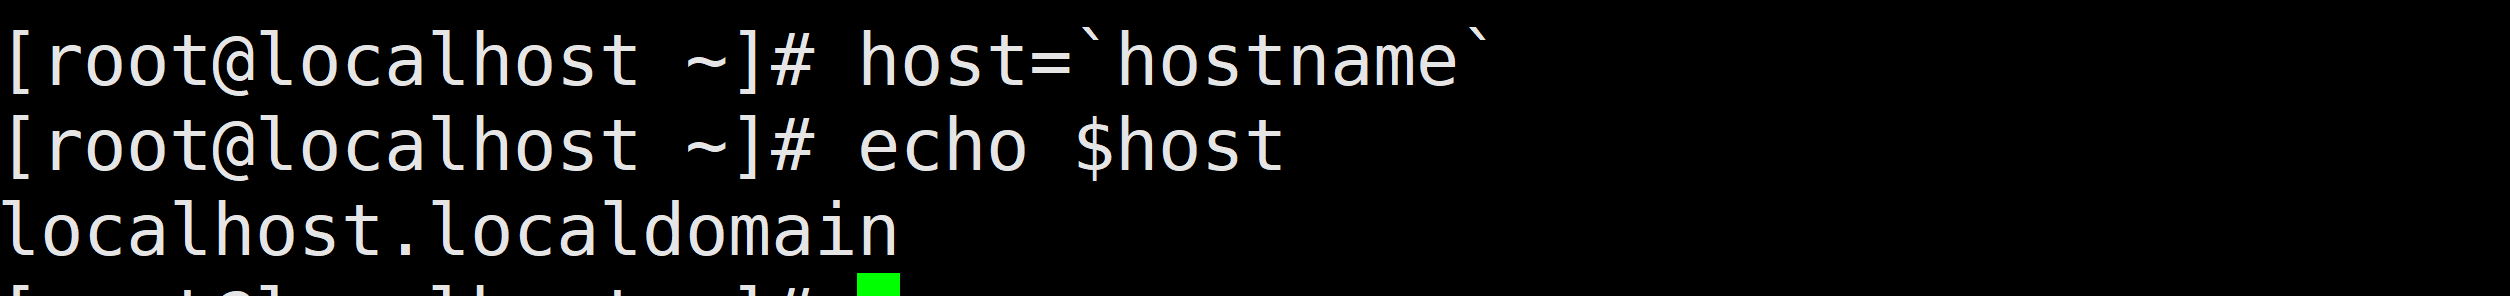
    • 可以将命令的执行结果保存到变量中

    file

    4.2 变量类型

    1)声明变量declare
    命令:declare
    作用:定义及获取有类型的变量
    语法:declare [选项] 变量名=值
    选项参数:
    -i:将变量看成整数 
    -r:使变量只读(readonly)
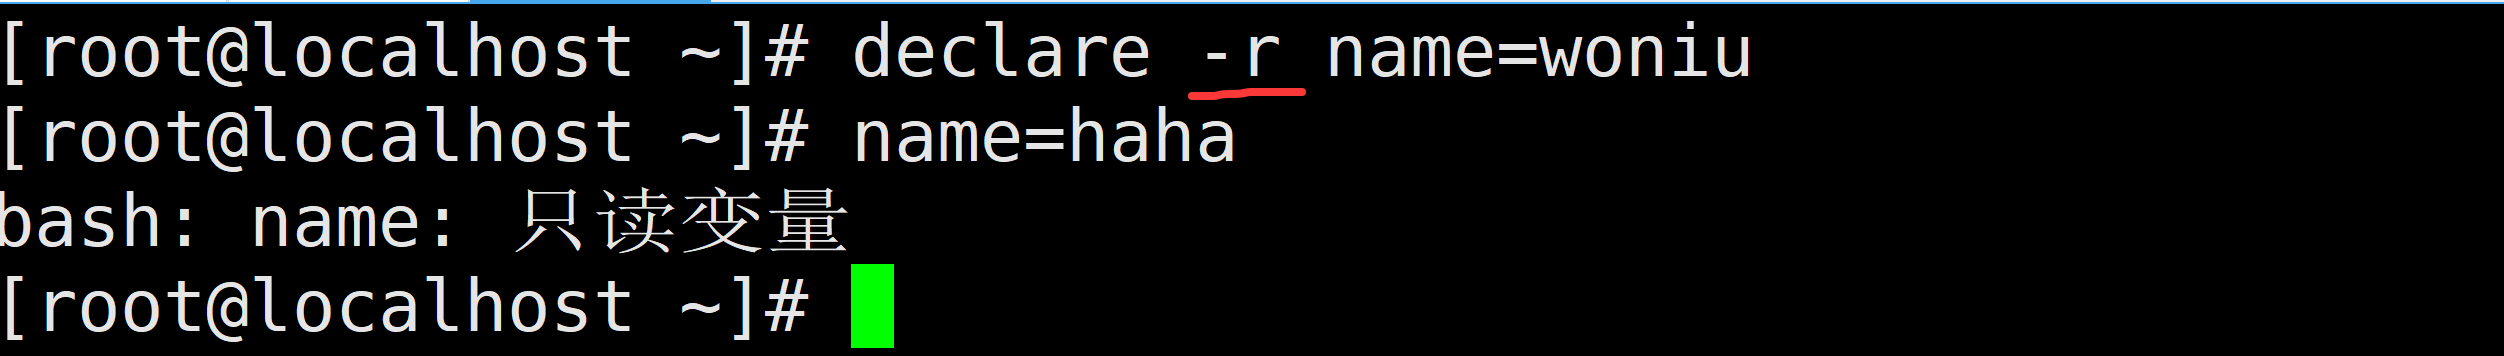
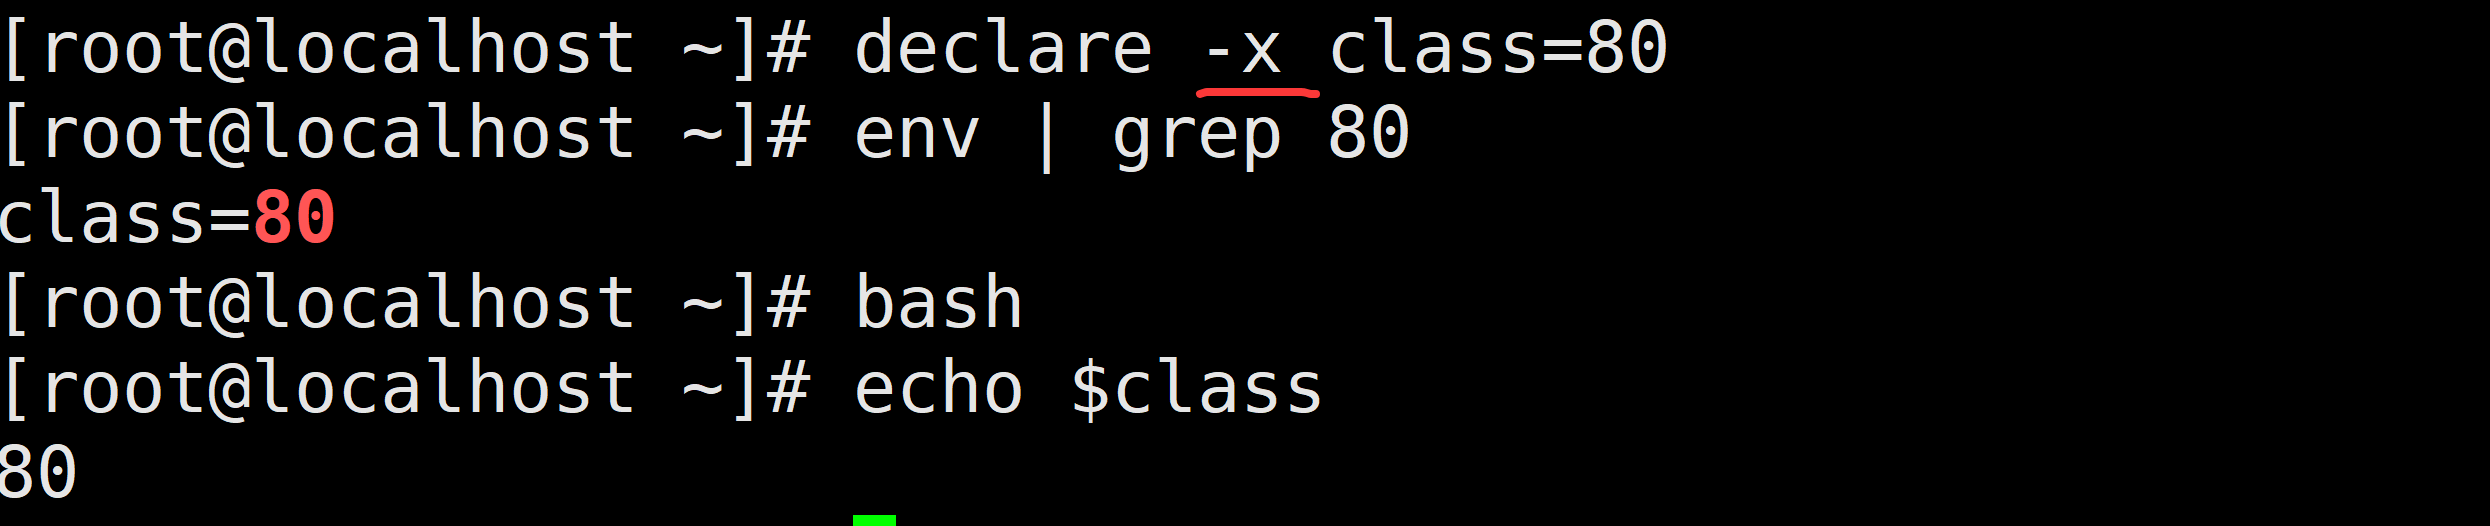
    -x:标记变量通过环境导出(export)
    -a:指定为索引数组(查看普通数组)
    -A:指定为关联数组(查看关联数组)
    使用declare命令将变量定义成整数
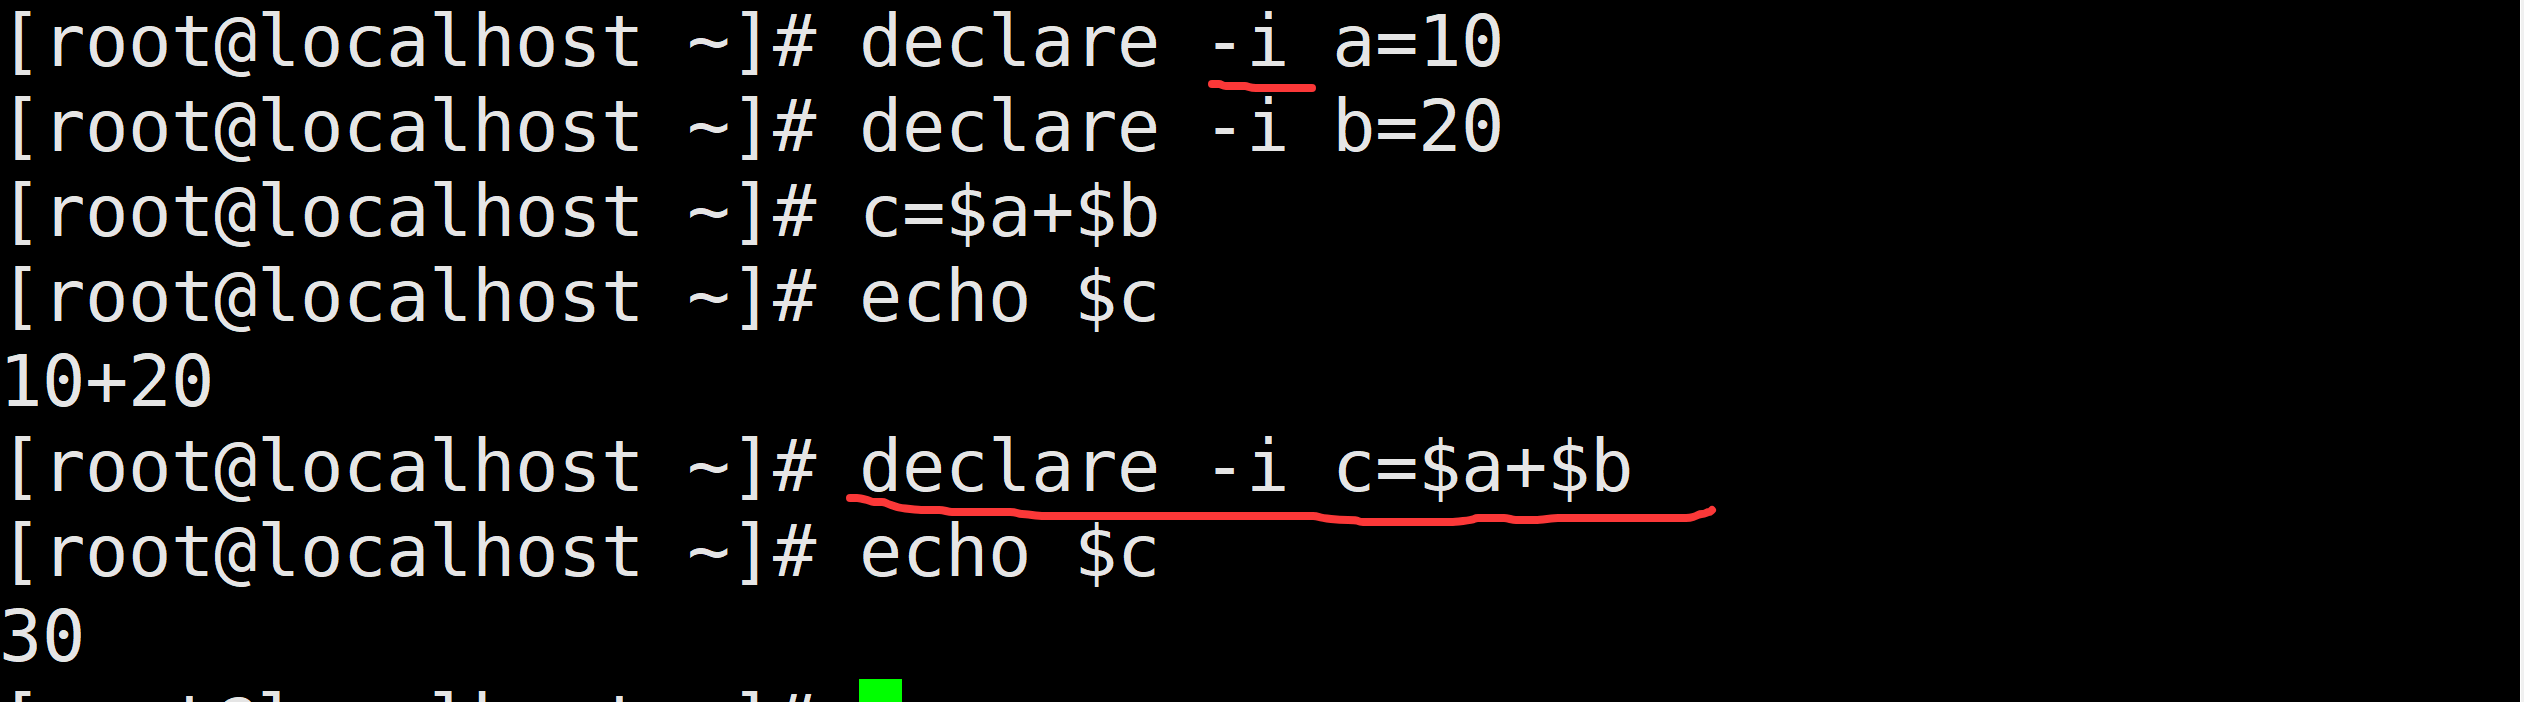
    file

    将变量声明为只读,不能修改

    file

    将变量声明成环境变量

    file

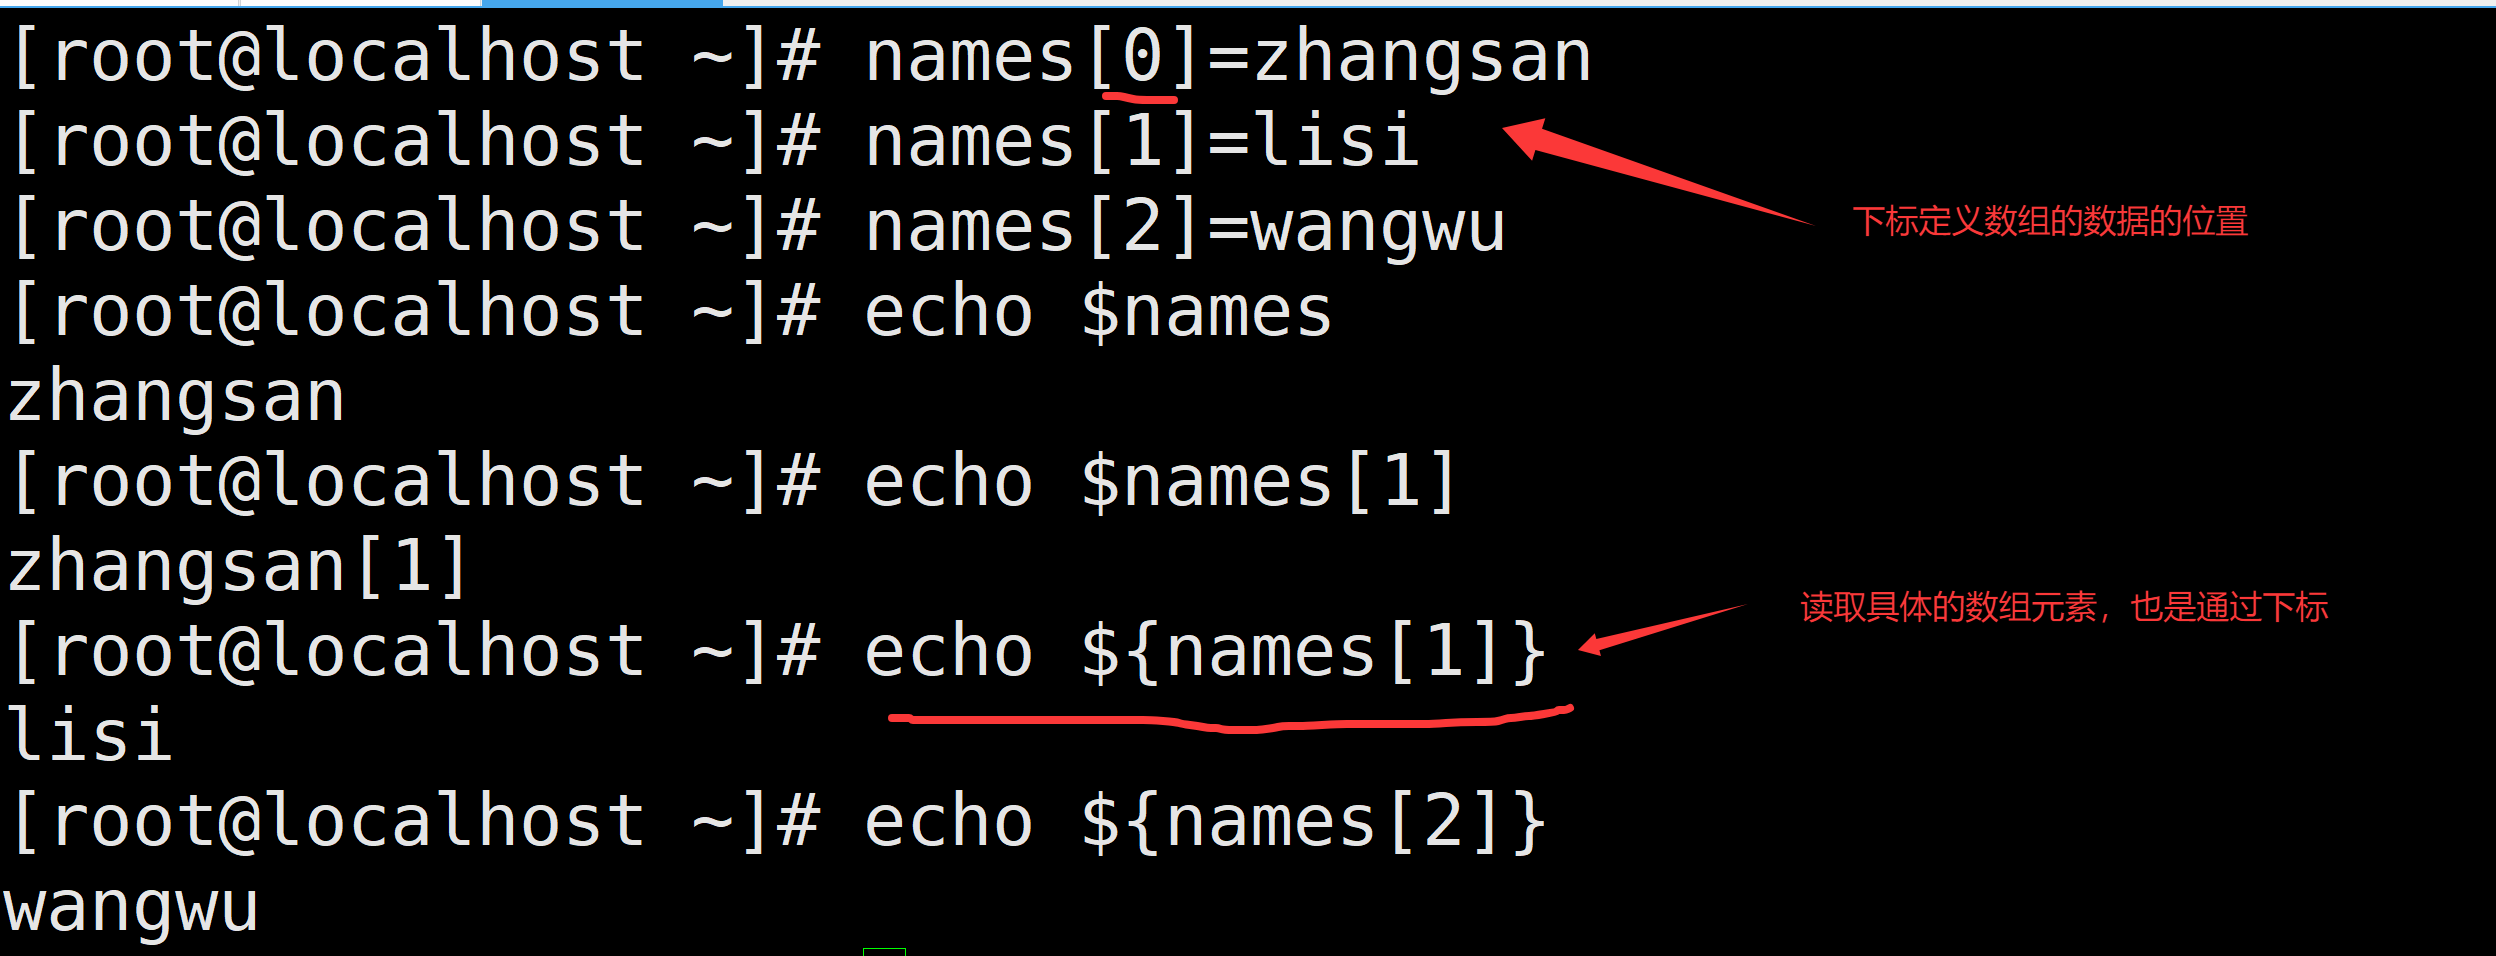
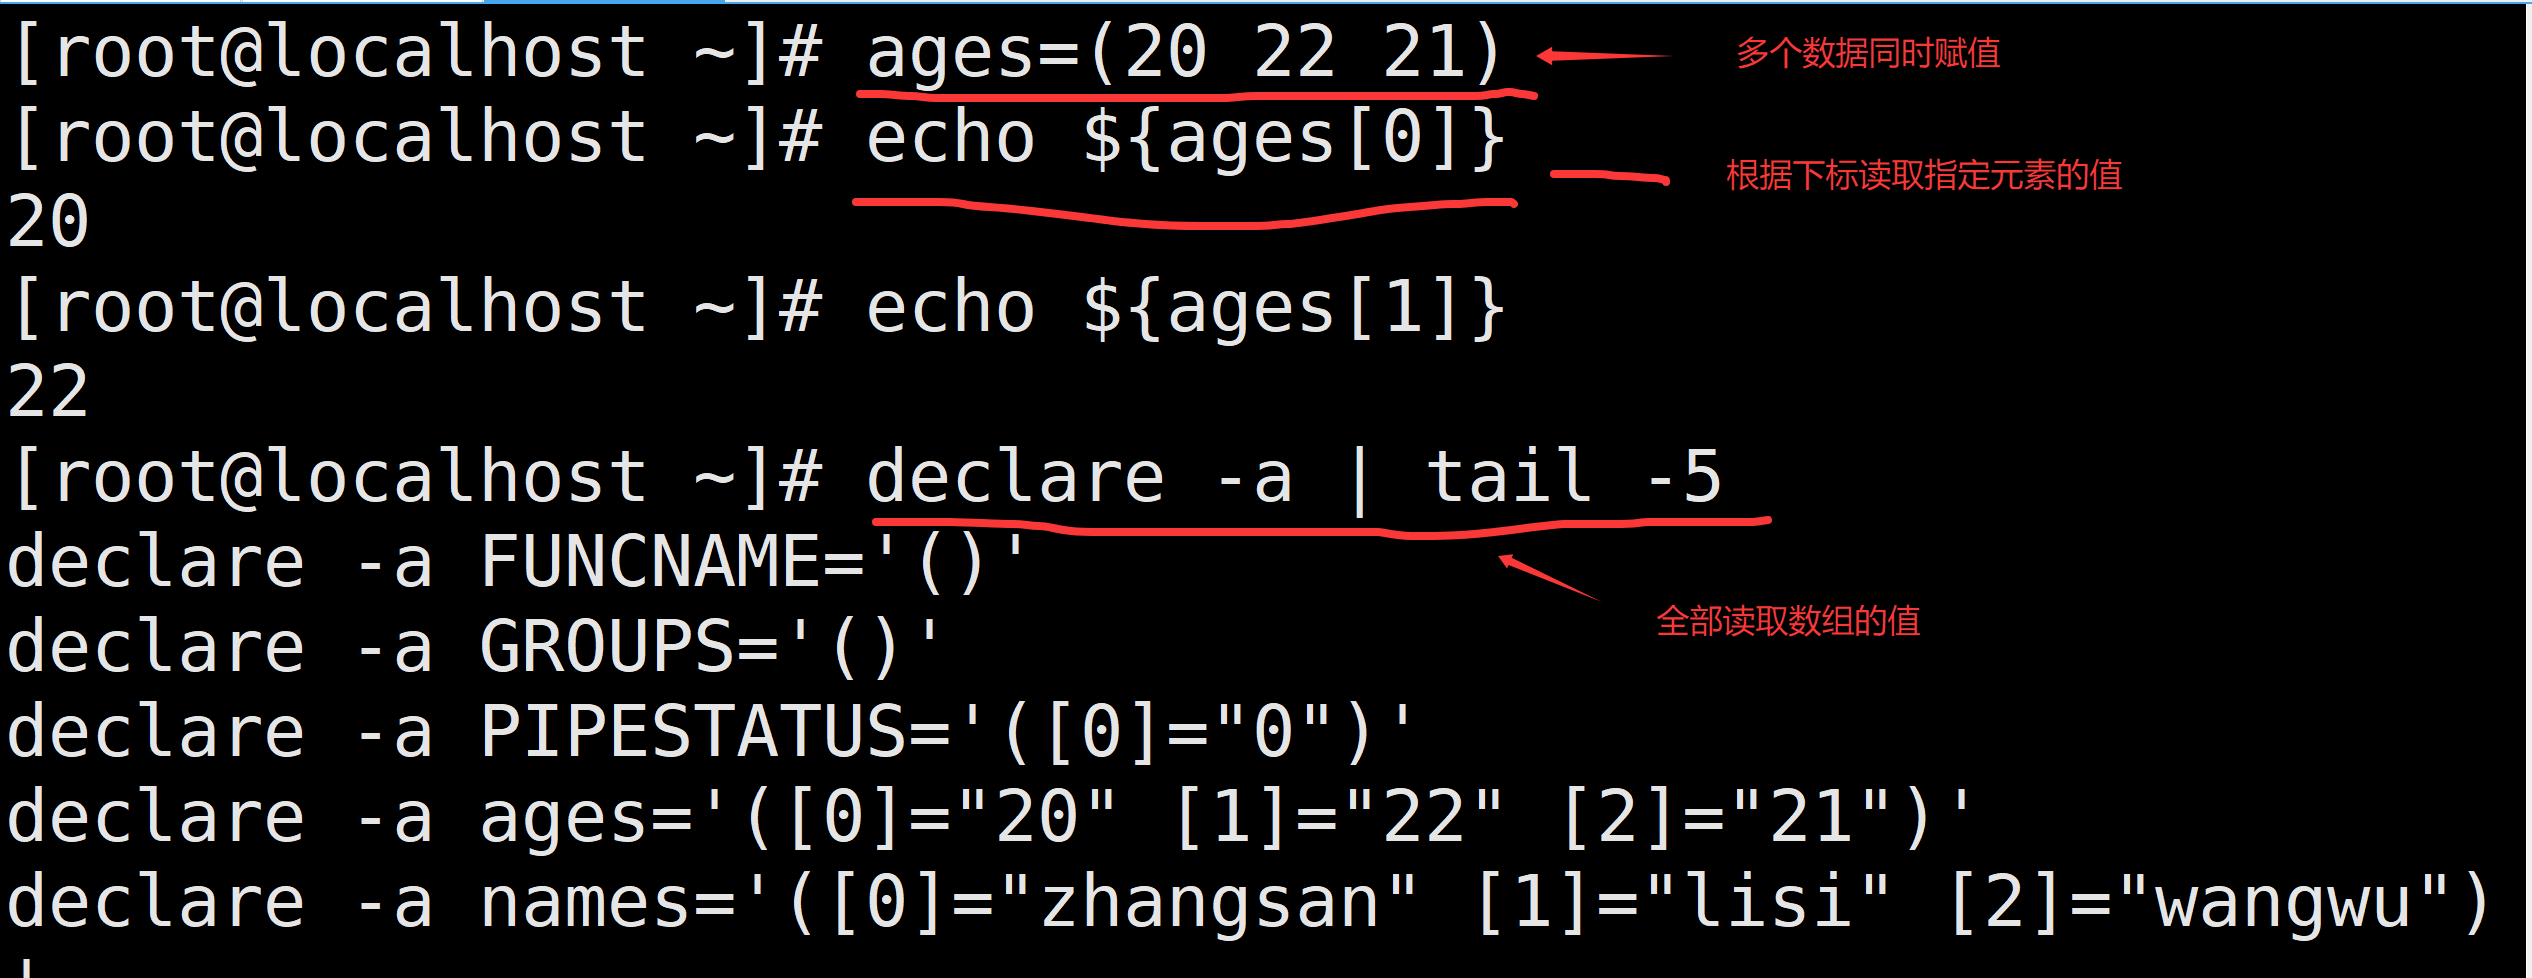
    4.3 普通数组

    多个数据组合成数组
    • 一个一个定义

    file

    file

    • 多个元素同时赋值

    file

    file

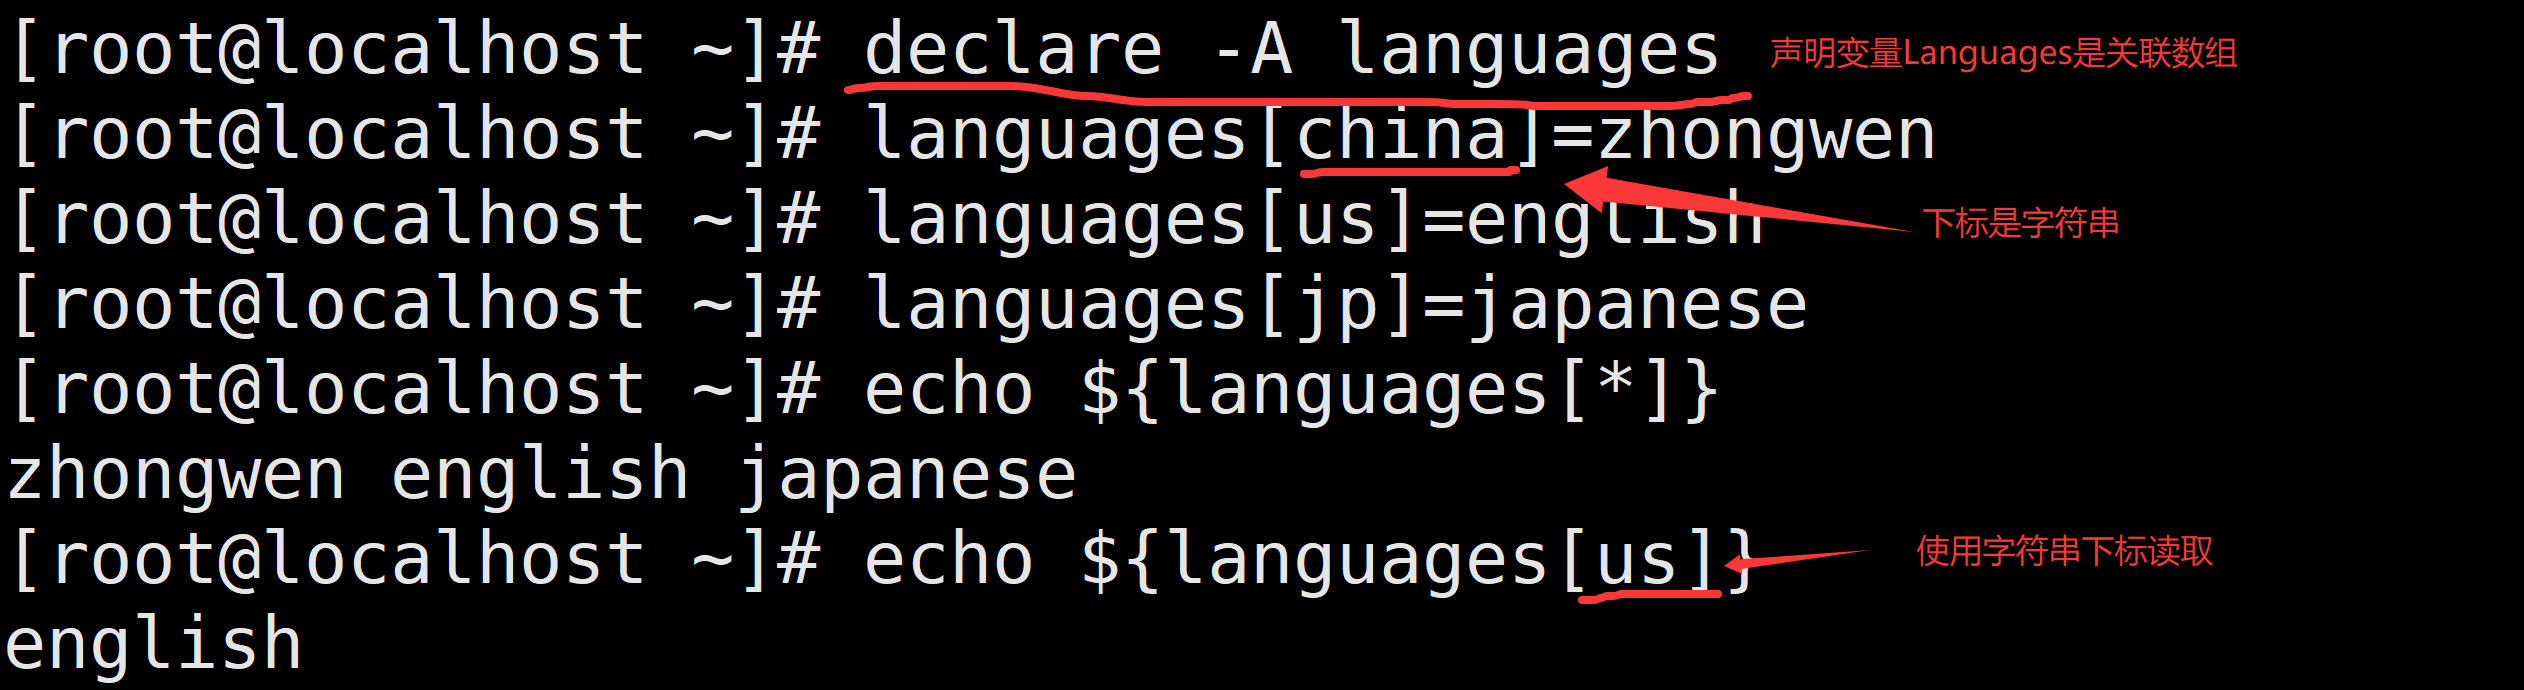
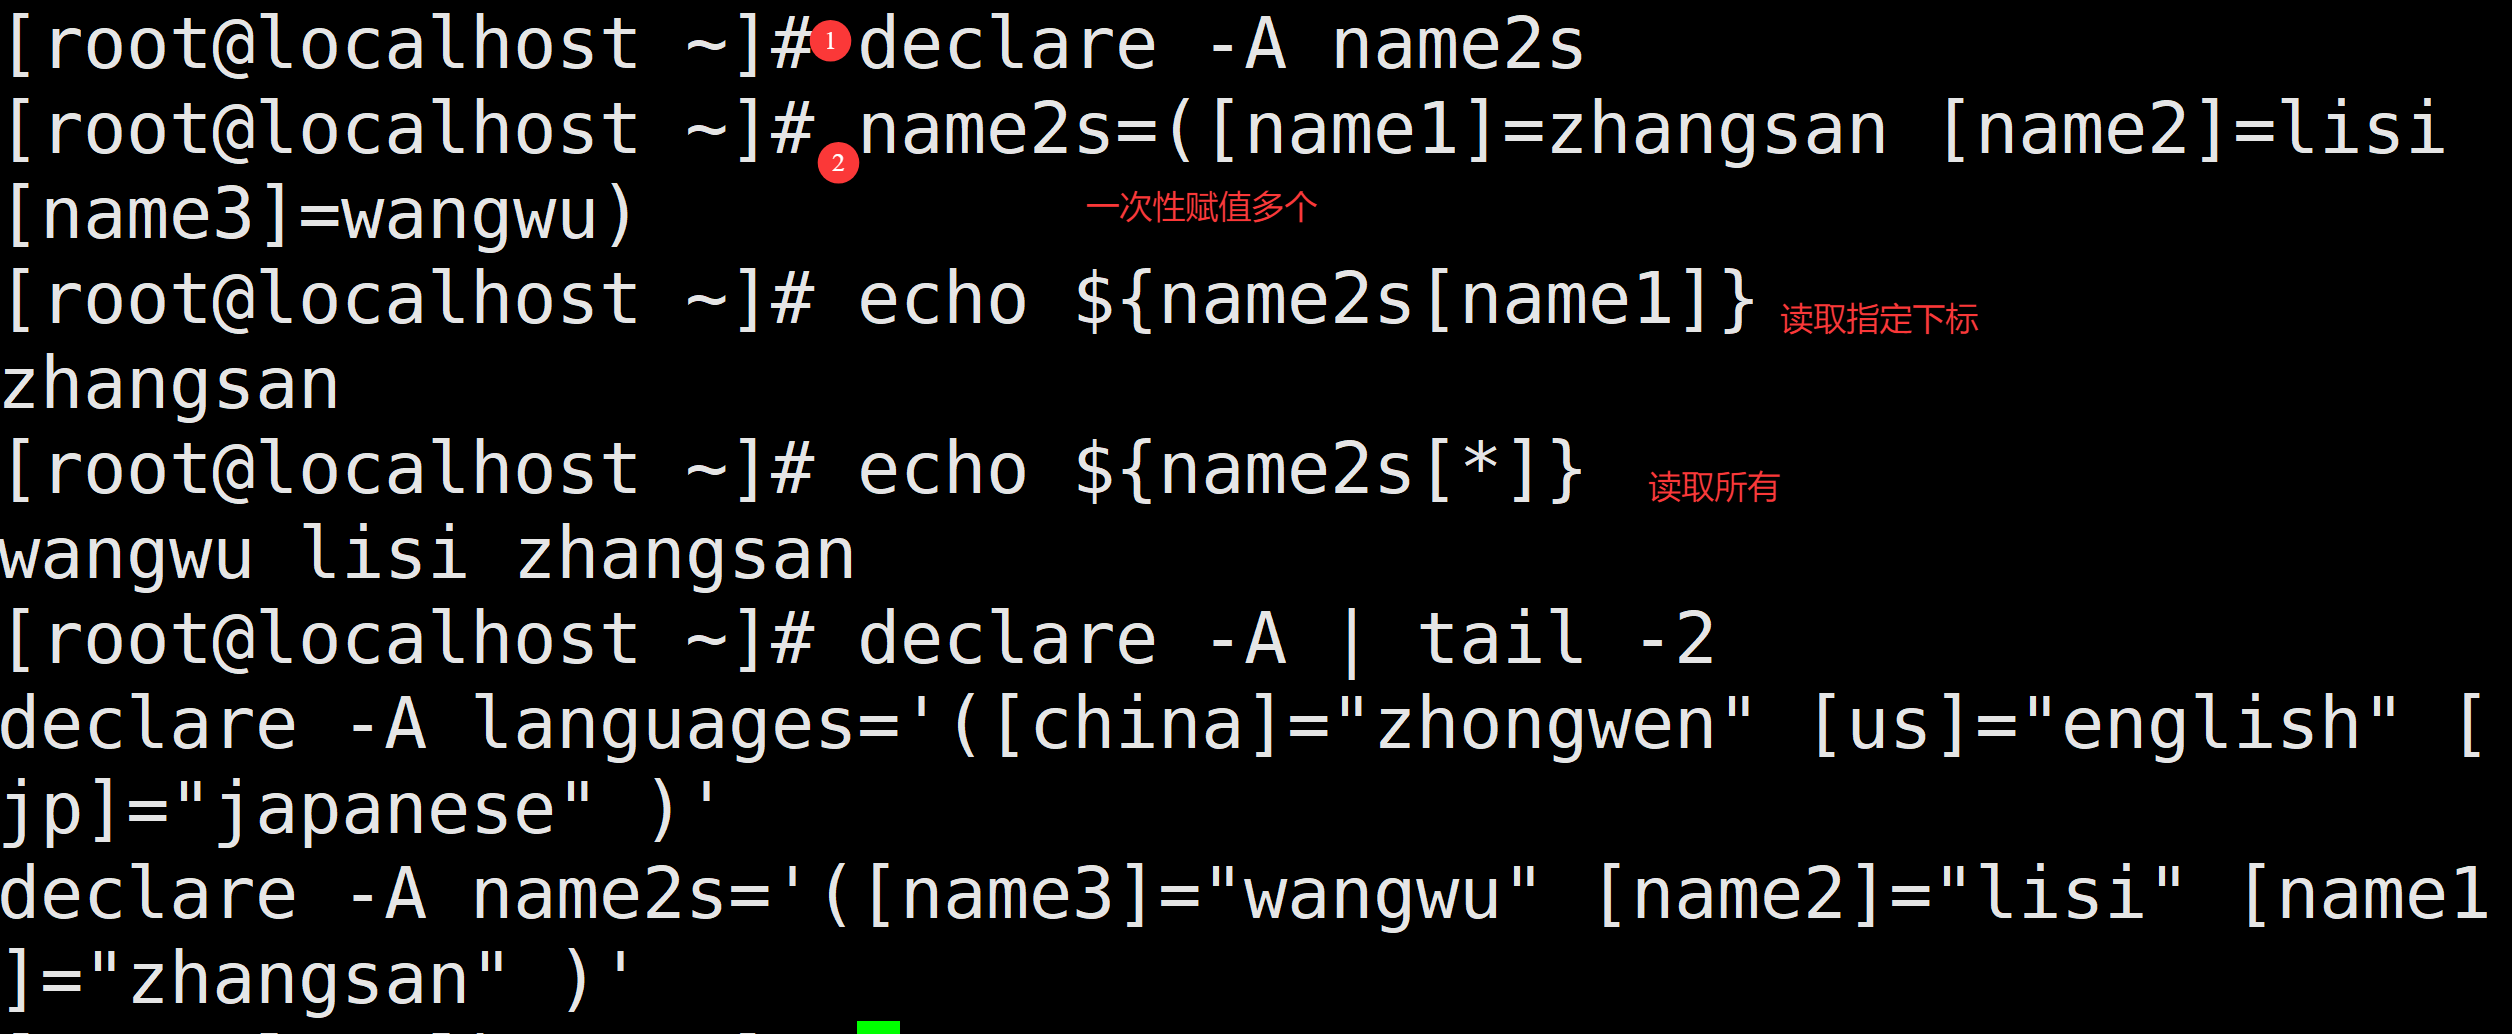
    4.4 关联数组

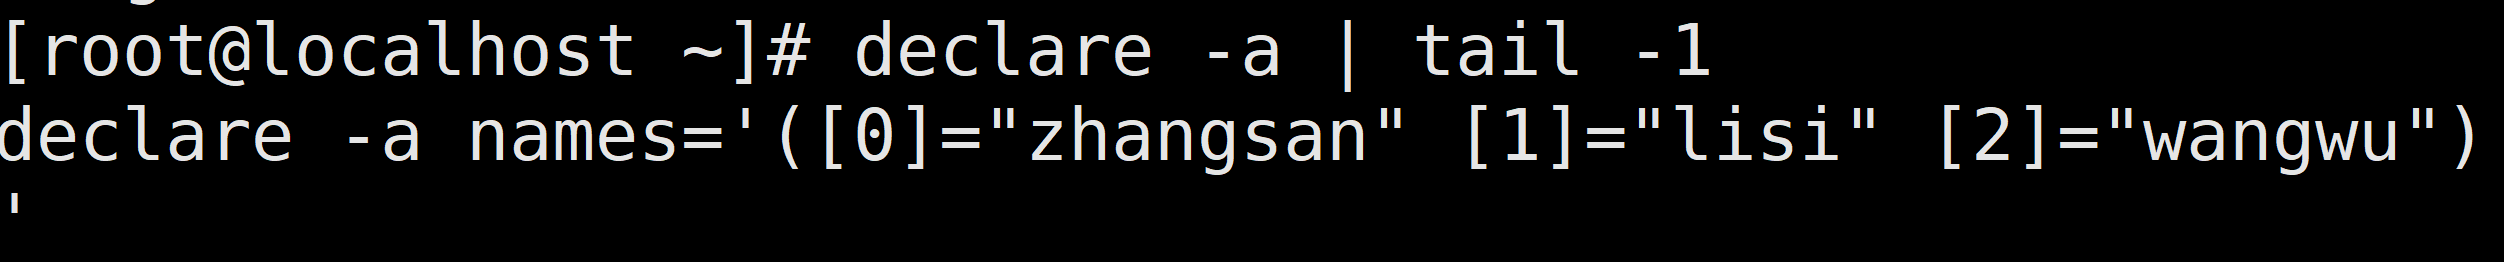
    一个一个数据的创建

    file

    多个数据同时创建

    file

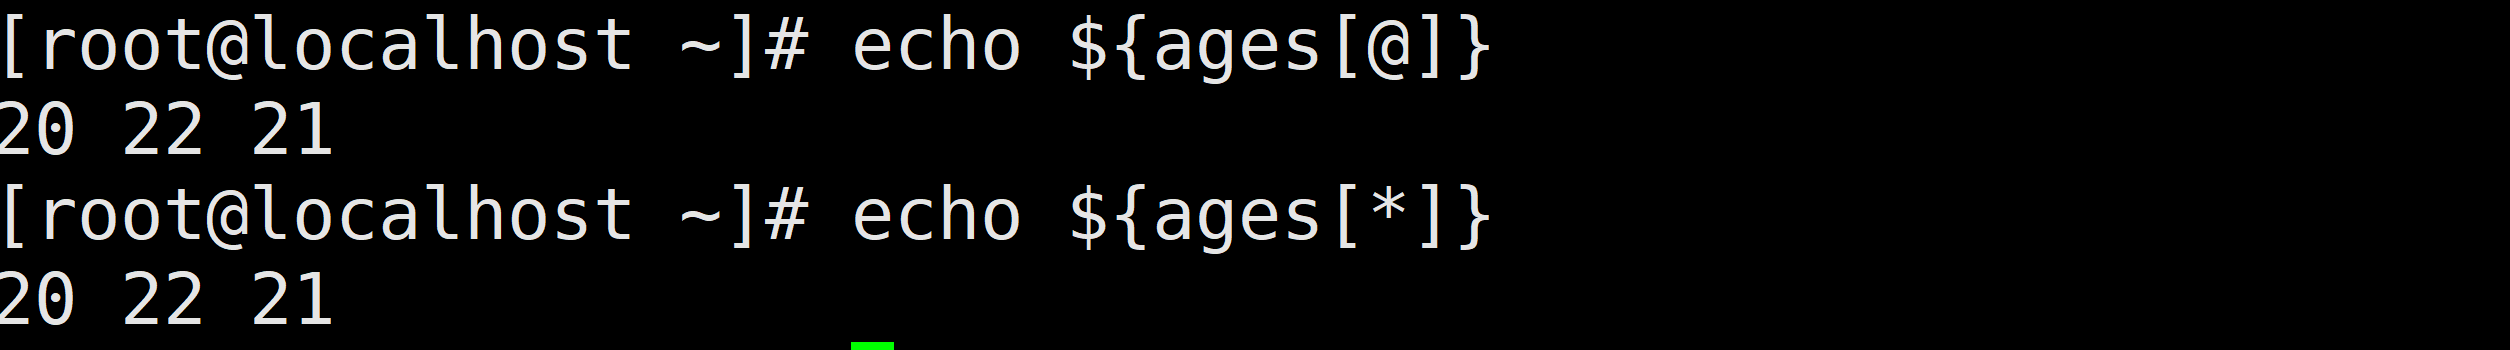
    4.5 数组的读取:

    ${array[string]}                                  # string表示该位置的名称
    使用@ 或 * 可以获取数组中的所有元素:
    echo ${array[string]}                            # 获取string位置的内容
    echo ${array[*]}                                # 获取数组里的所有元素
    echo ${#array[*]}                                # 获取数组里所有元素个数
    echo ${!array[@]}                                # 获取数组元素的索引下标
    declare -A                                        # 查看所有关联数组信息      
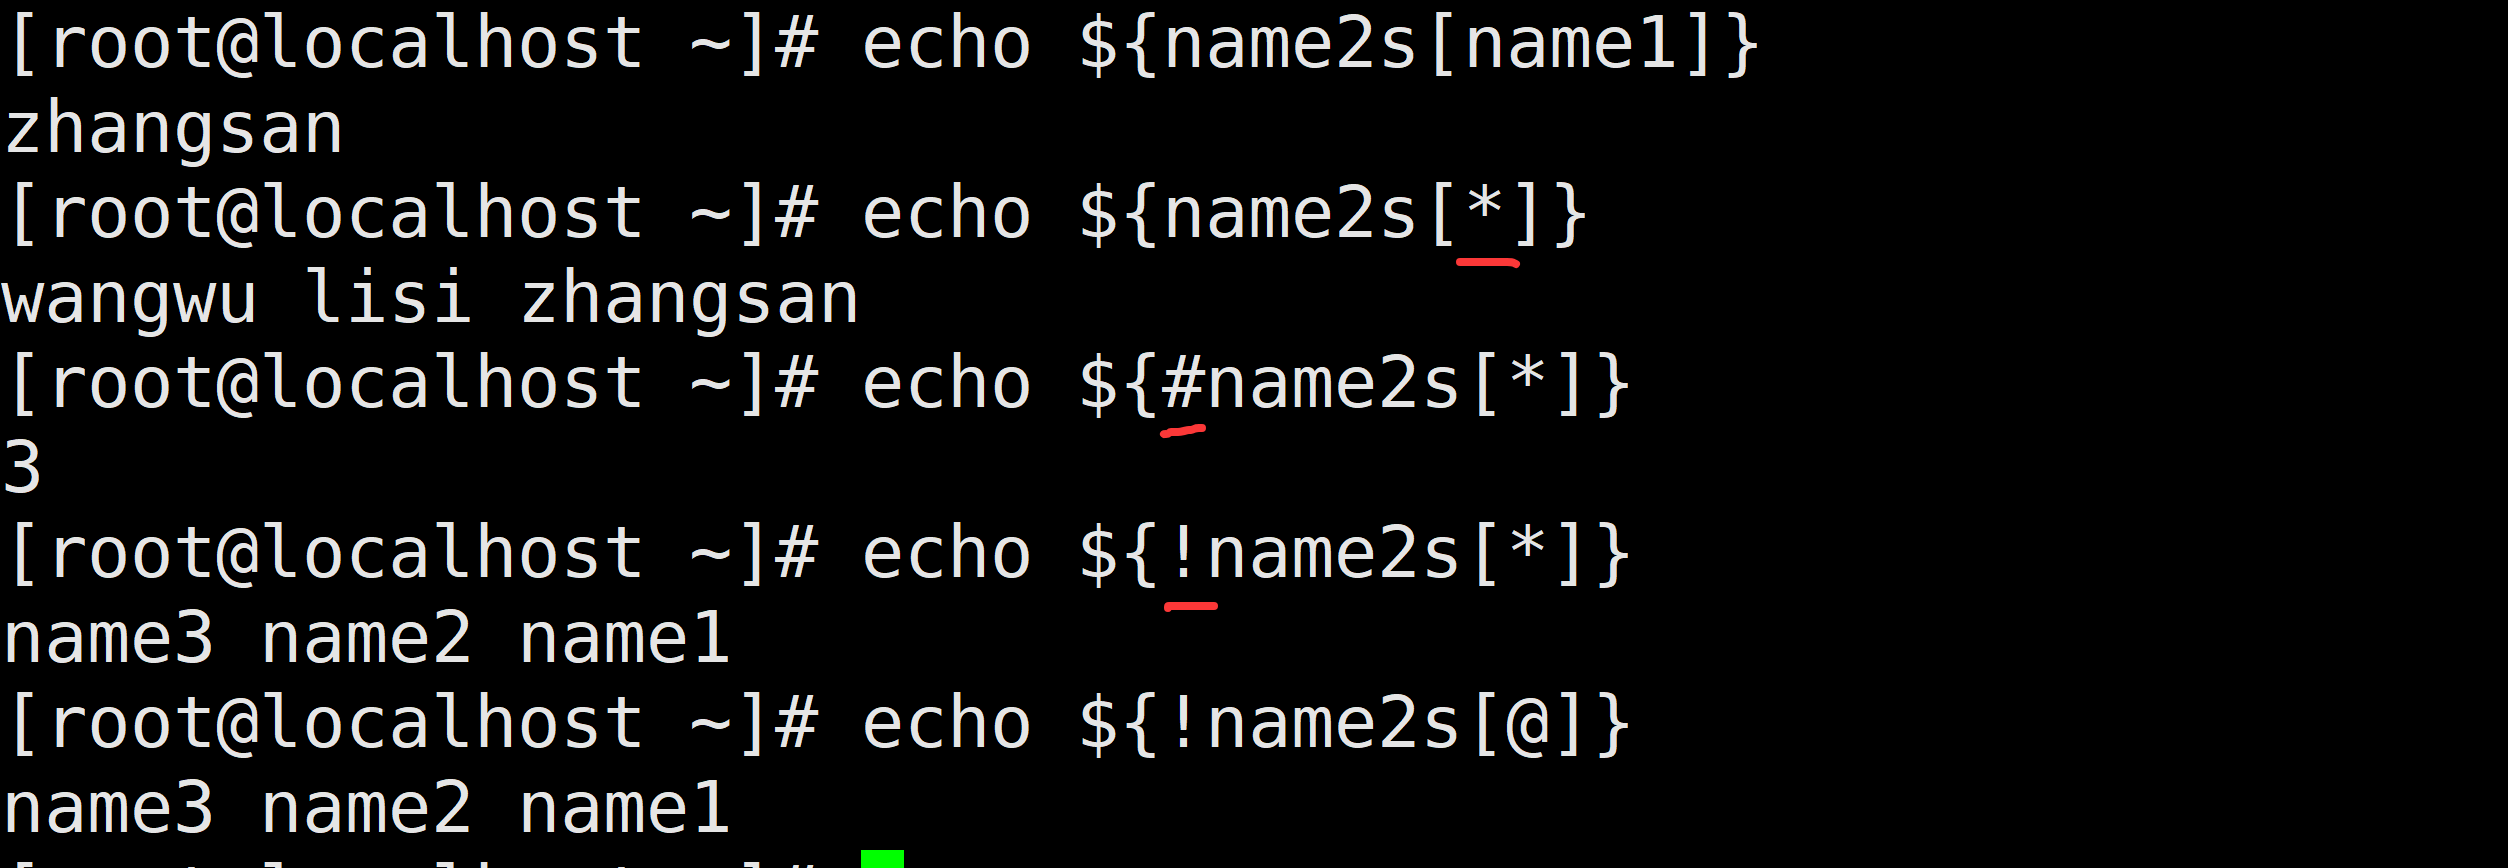
    file

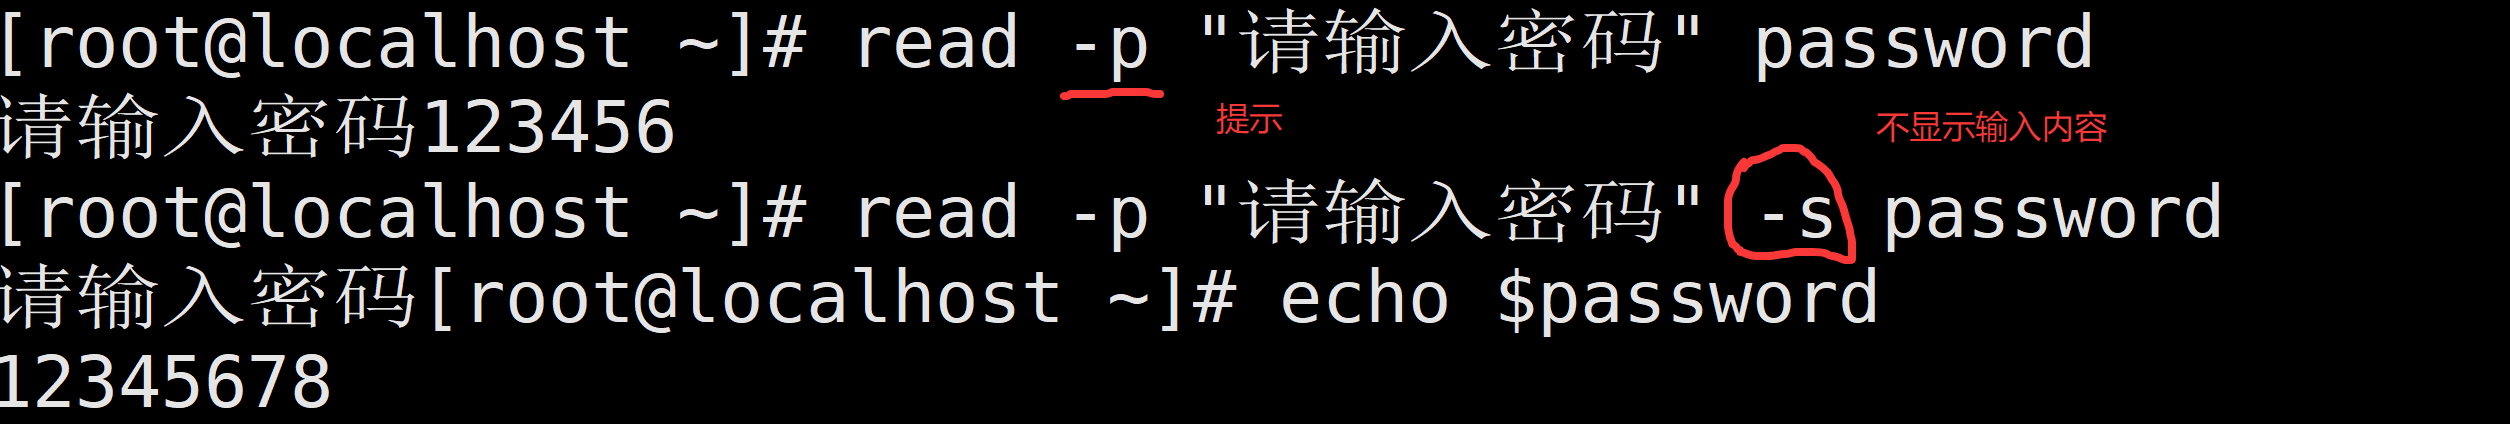
    4.6 交互式定义变量(read)

    命令:read
    作用:主要用于让用户去定义变量值
    语法:read [options] [var1 var2]
    选项参数:
    -p:提示信息
    -n:字符数 (限制变量值的字符数)
    -s:不显示   
    -t:超时(默认单位秒)(限制用户输入变量值的超时时间)
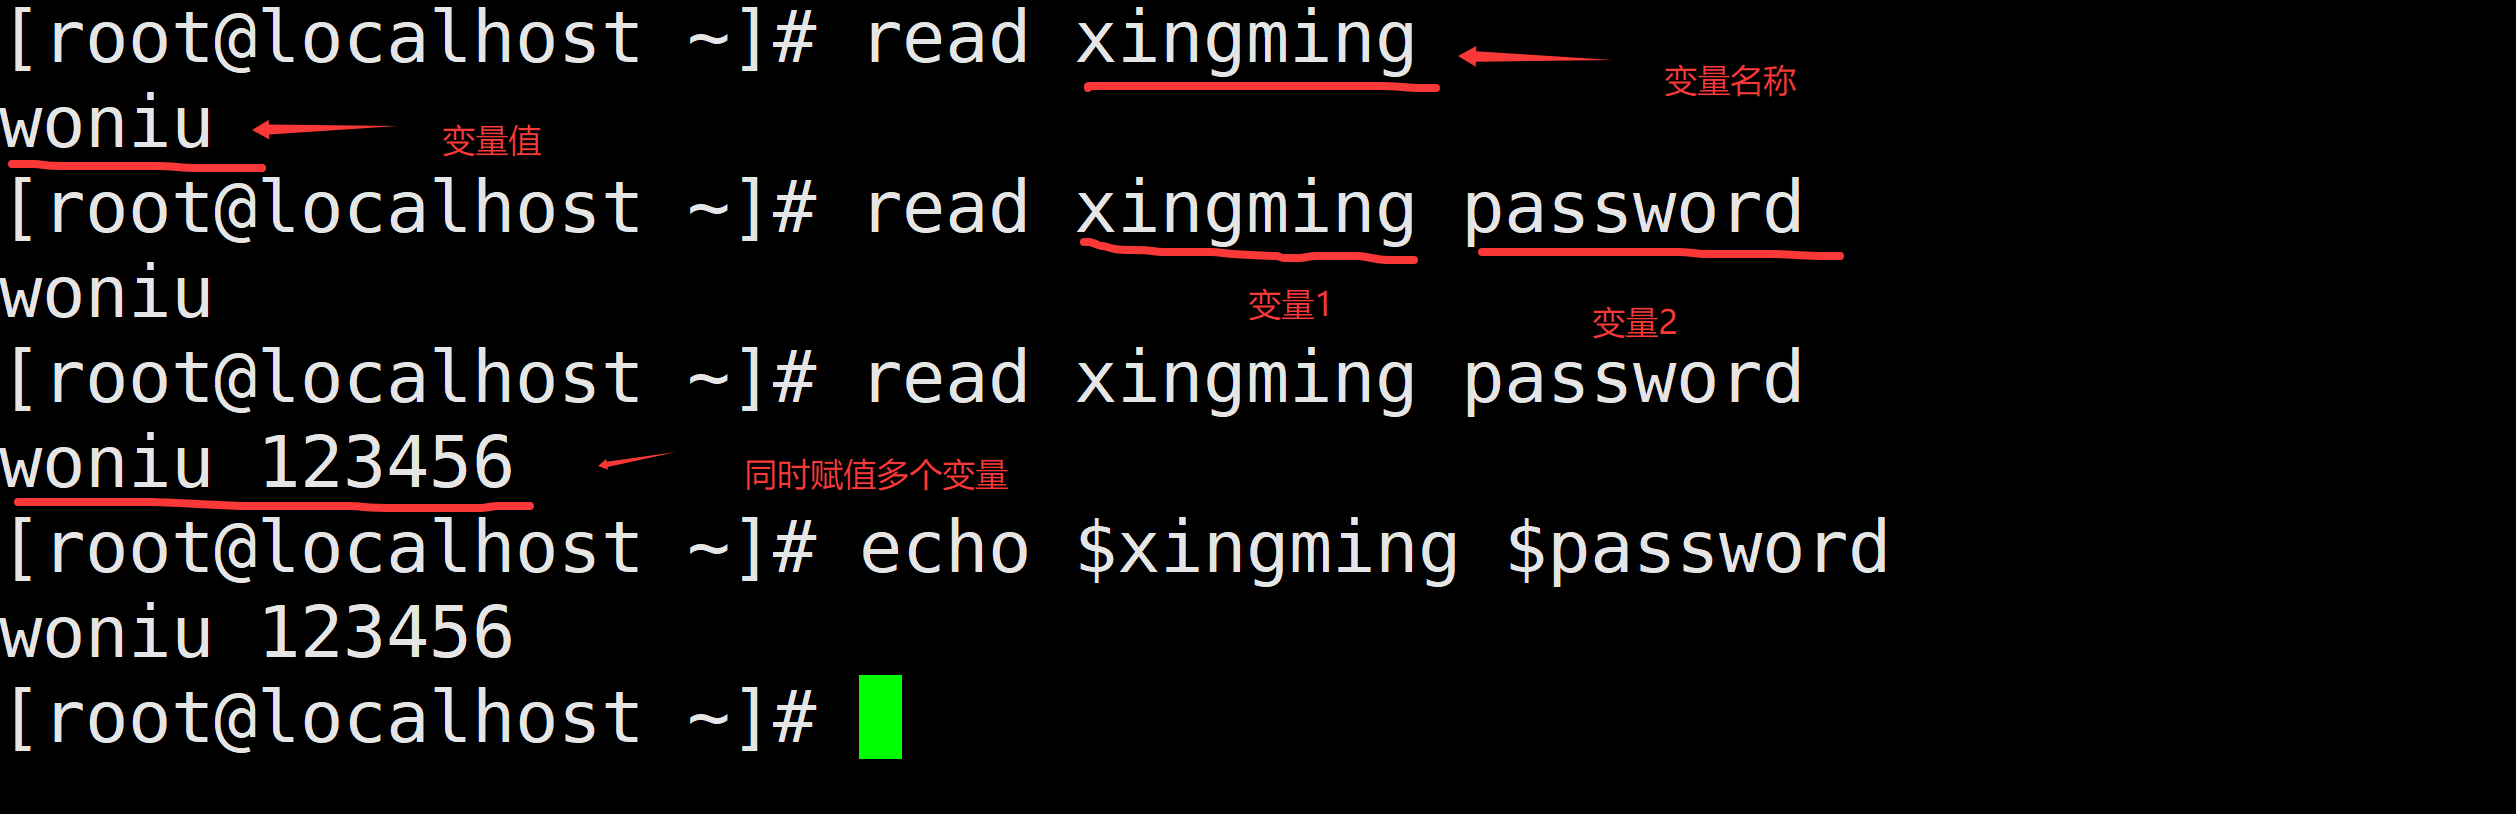
    file

    file

    案例:

    需求:定义一个变量`r1`,通过交互式进行赋值
    read  r1
    需求:定义两个变量`r2``r3`,通过交互式进行赋值(同时赋值)
    read r2  r3
    需求:定义一个变量`passwd`,通过交互式进行赋值。提示信息为`input your Passwd:`,并设置不显示用户的输入
    read -s  -p  "input your passwd"  passwd
    需求:定义一个文件`p.txt`,在文件中中写入两个IP,以空格隔开,将文件中的值赋值给变量`p1``p2`
    
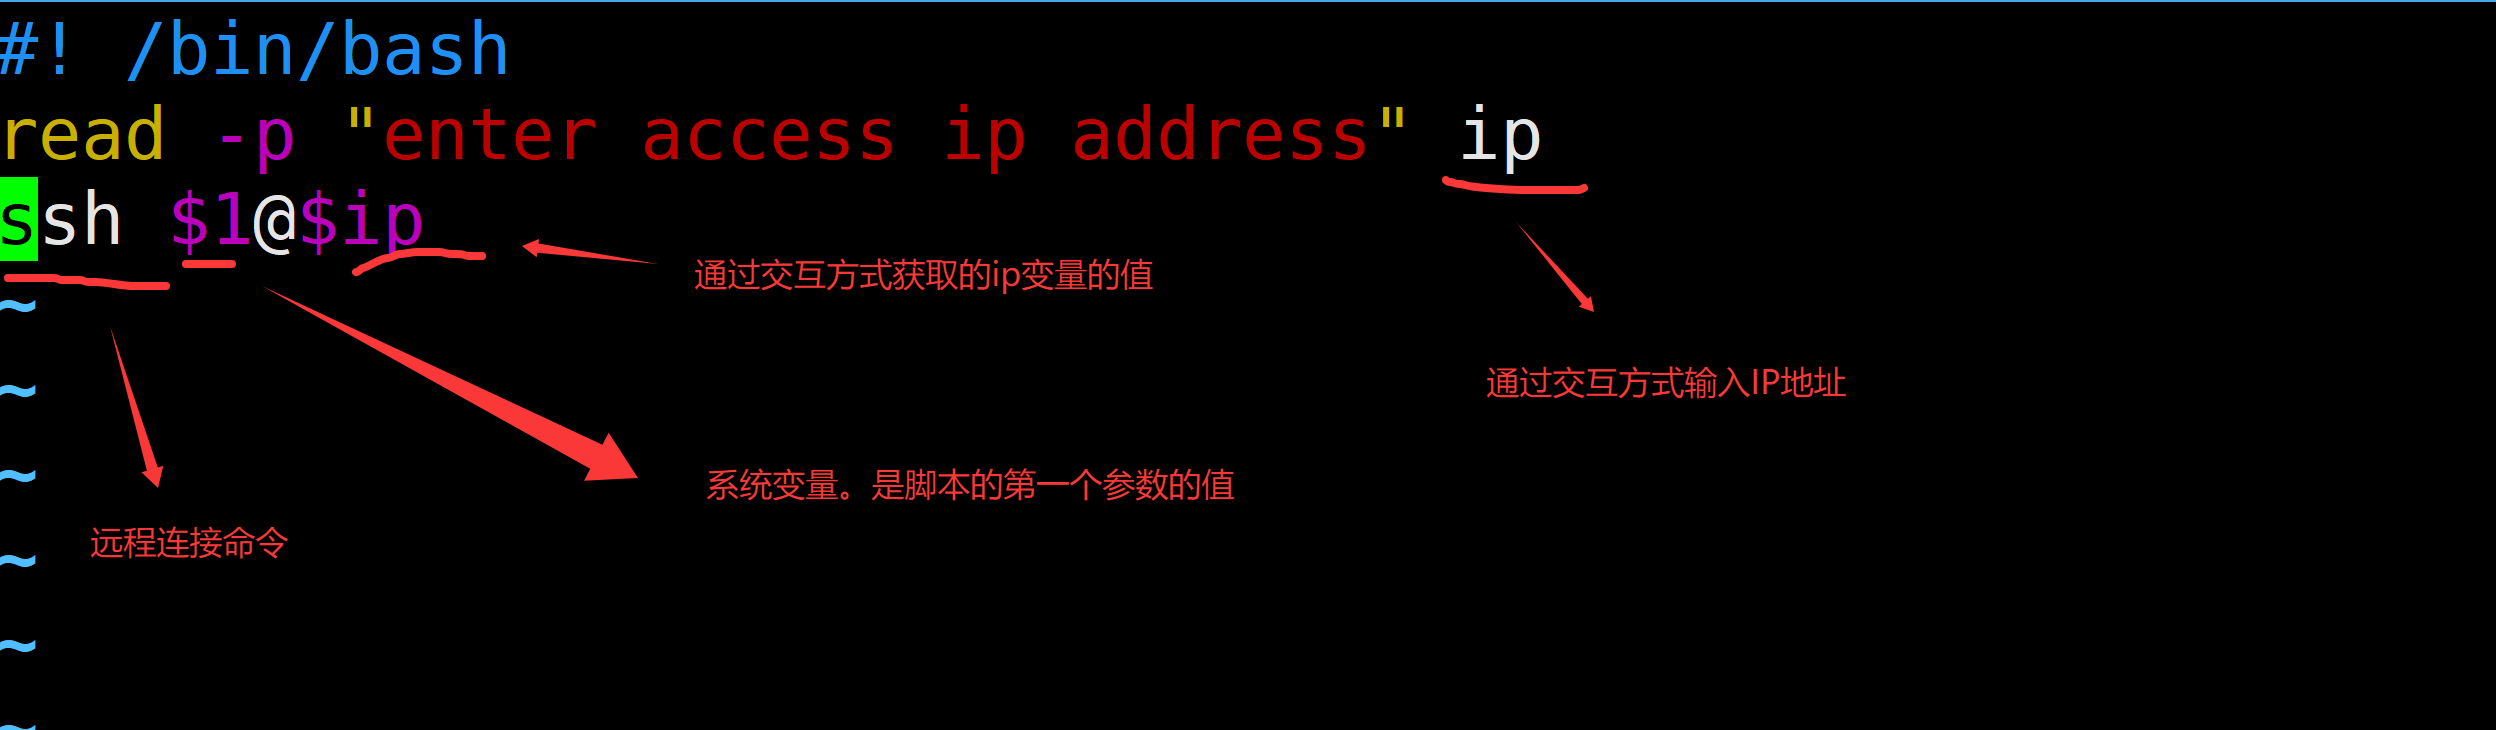
    1. 定义一个脚本,ss.sh
    2. 从控制台录入一个数据,一个IP
    3. 远程连接该主机(账号通过参数的方式传递) ss.sh root
    #!/bin/bash
    read -p "请输入远程主机的地址:" ip
    ssh -p 10086 $1@$ip
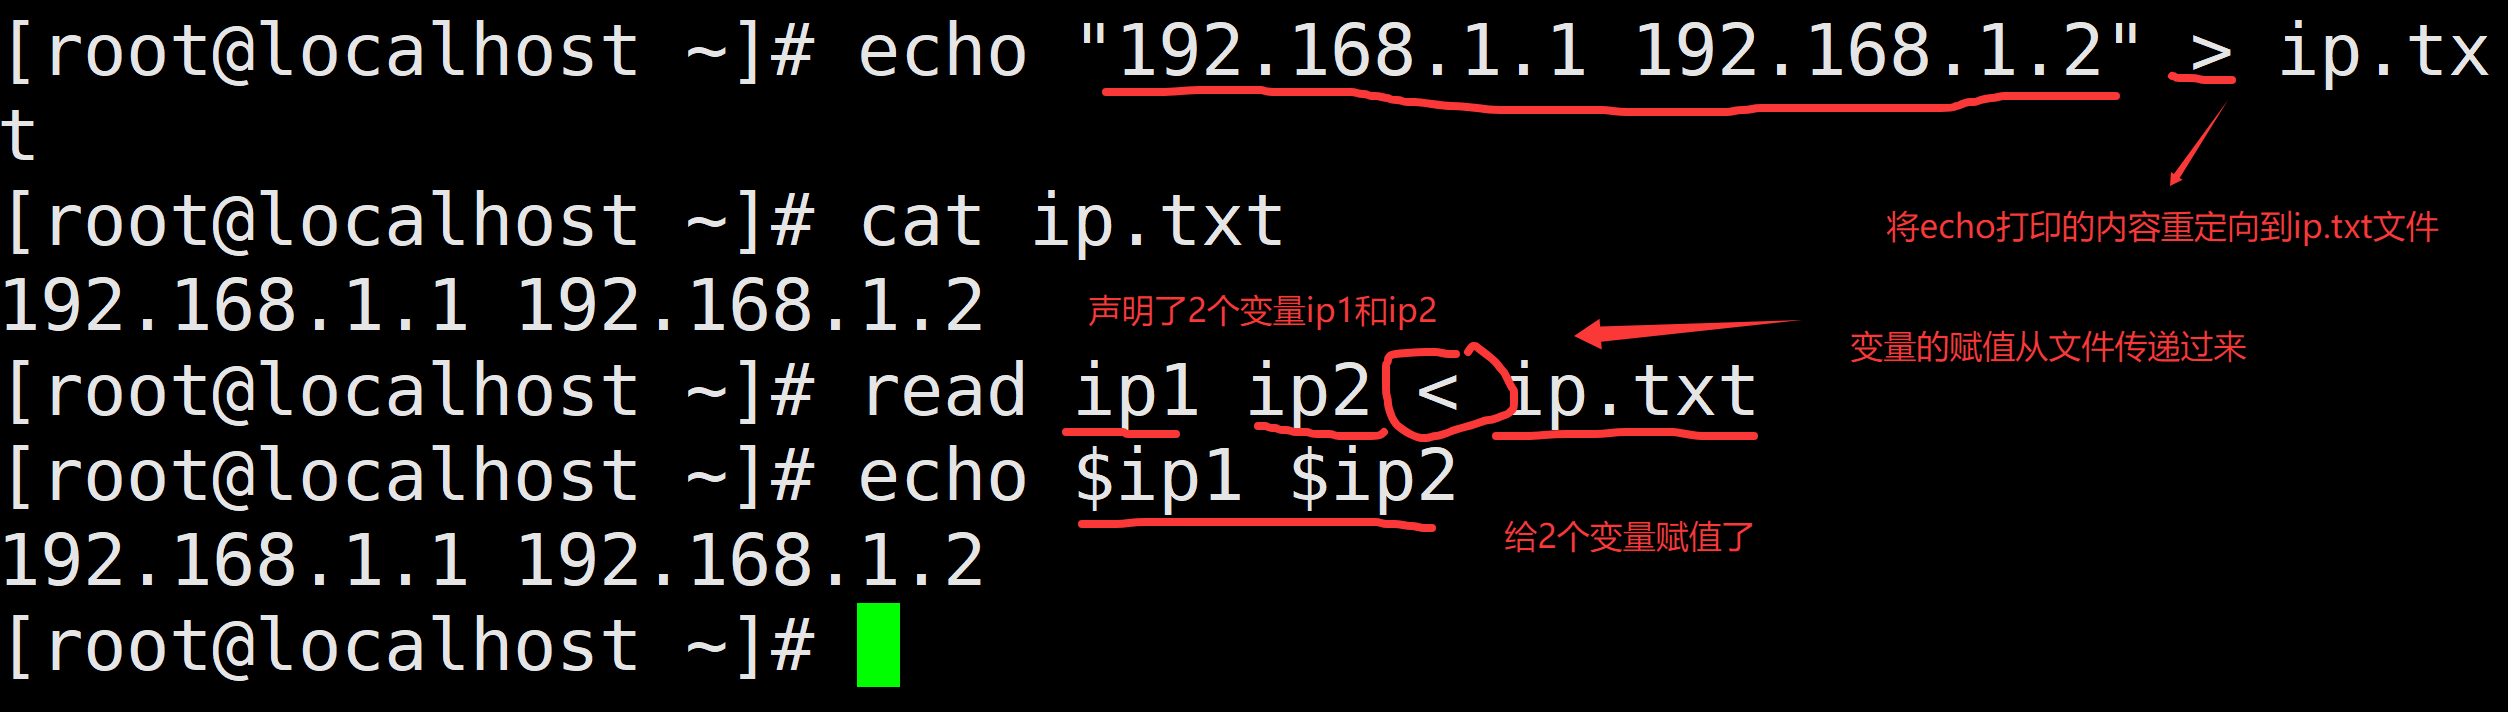
    file

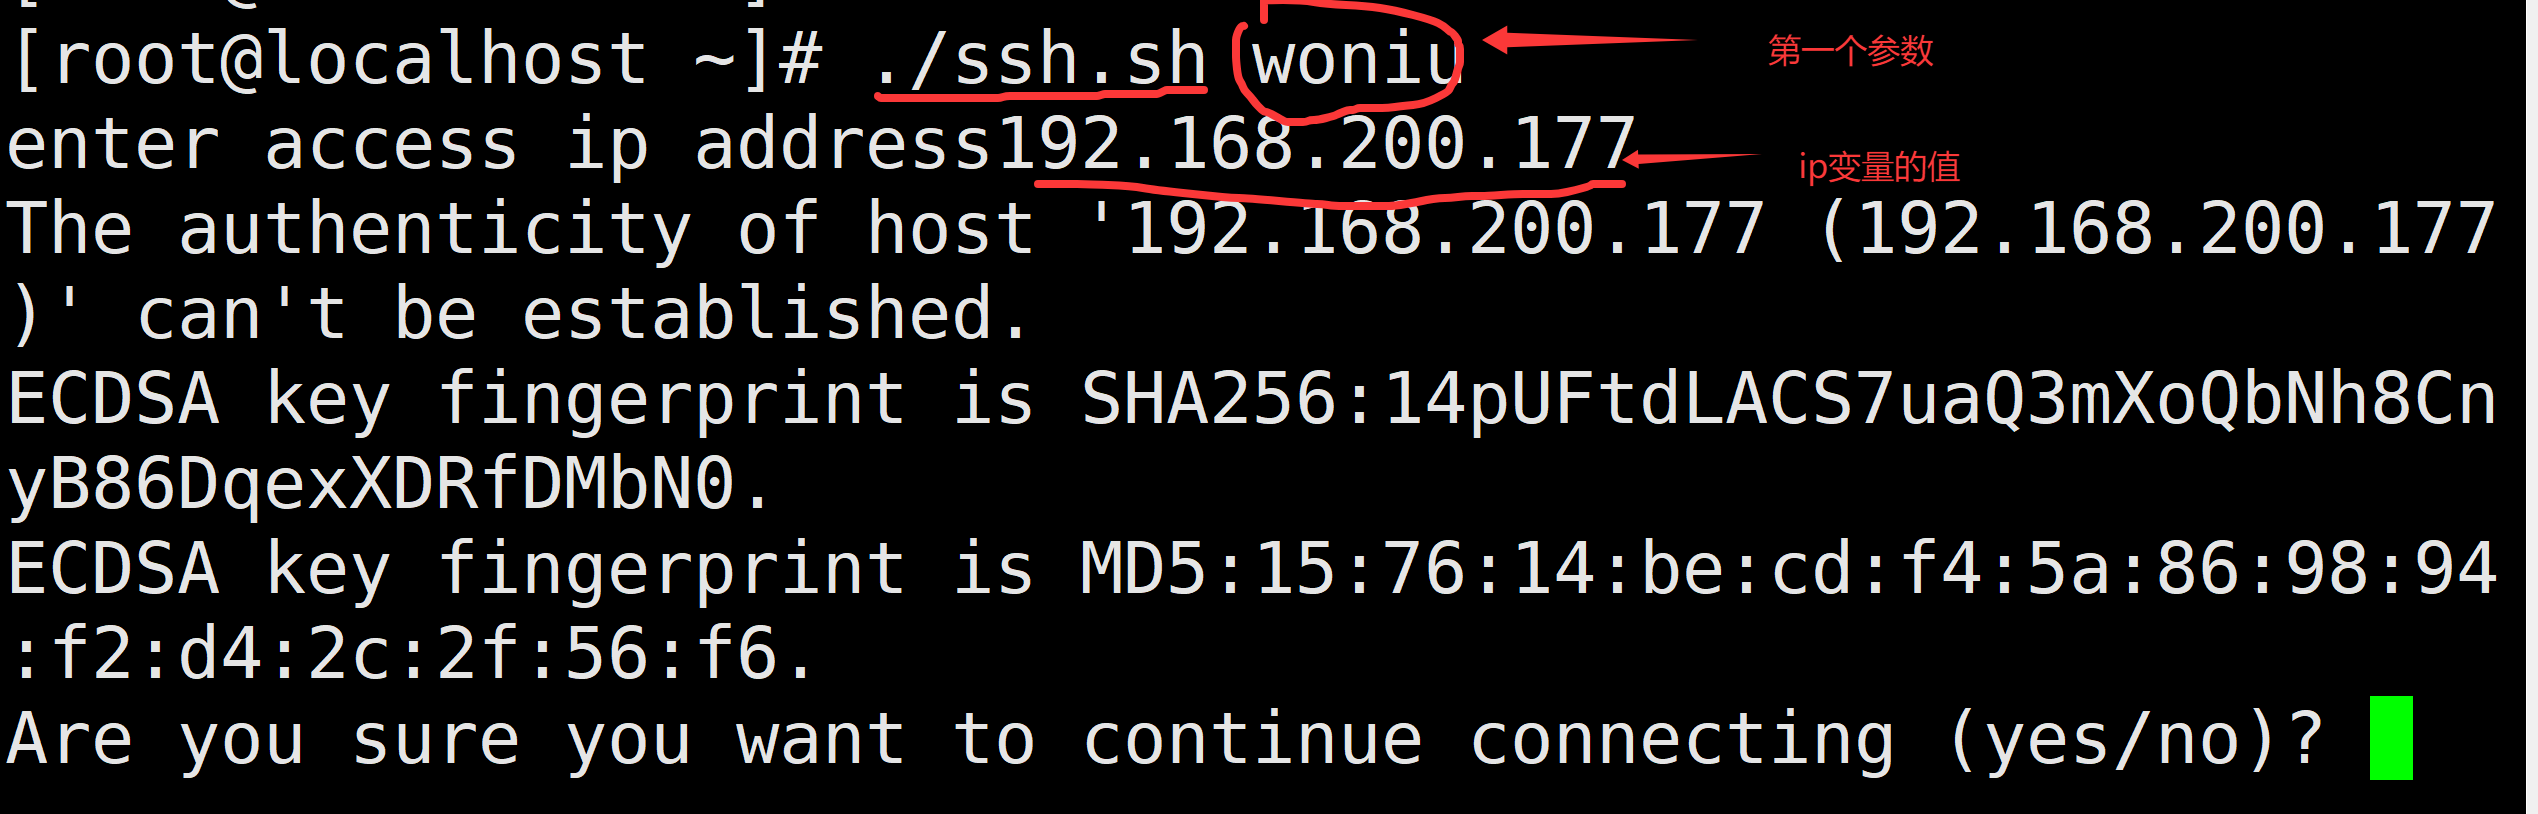
    SSH远程连接脚本:

    file

    file

    2. 四则运算

    1 概述

    算术运算:默认情况下,shell就只能支持简单的整数运算,就是数字运行,数字运算支持以下:

    + - * /  %(取模,求余数)

    复杂运算需要借助其他工具(bc)

    bc是一个用于计算的命令行工具,可以执行高精度算术运算、逻辑运算、函数操作、数值比较、赋值等操作。bc具有一个交互式环境,也可以从脚本文件中读取命令。在终端中输入bc,就可以进入bc的交互模式。

    2 运算的方式

    Bash shell 的算术运算有四种方式:

    • 使用 $(( ))
    • 使用$[ ]
    • 使用 expr 外部程式
    • 使用let 命令

    演示:

    使用$(())

    file

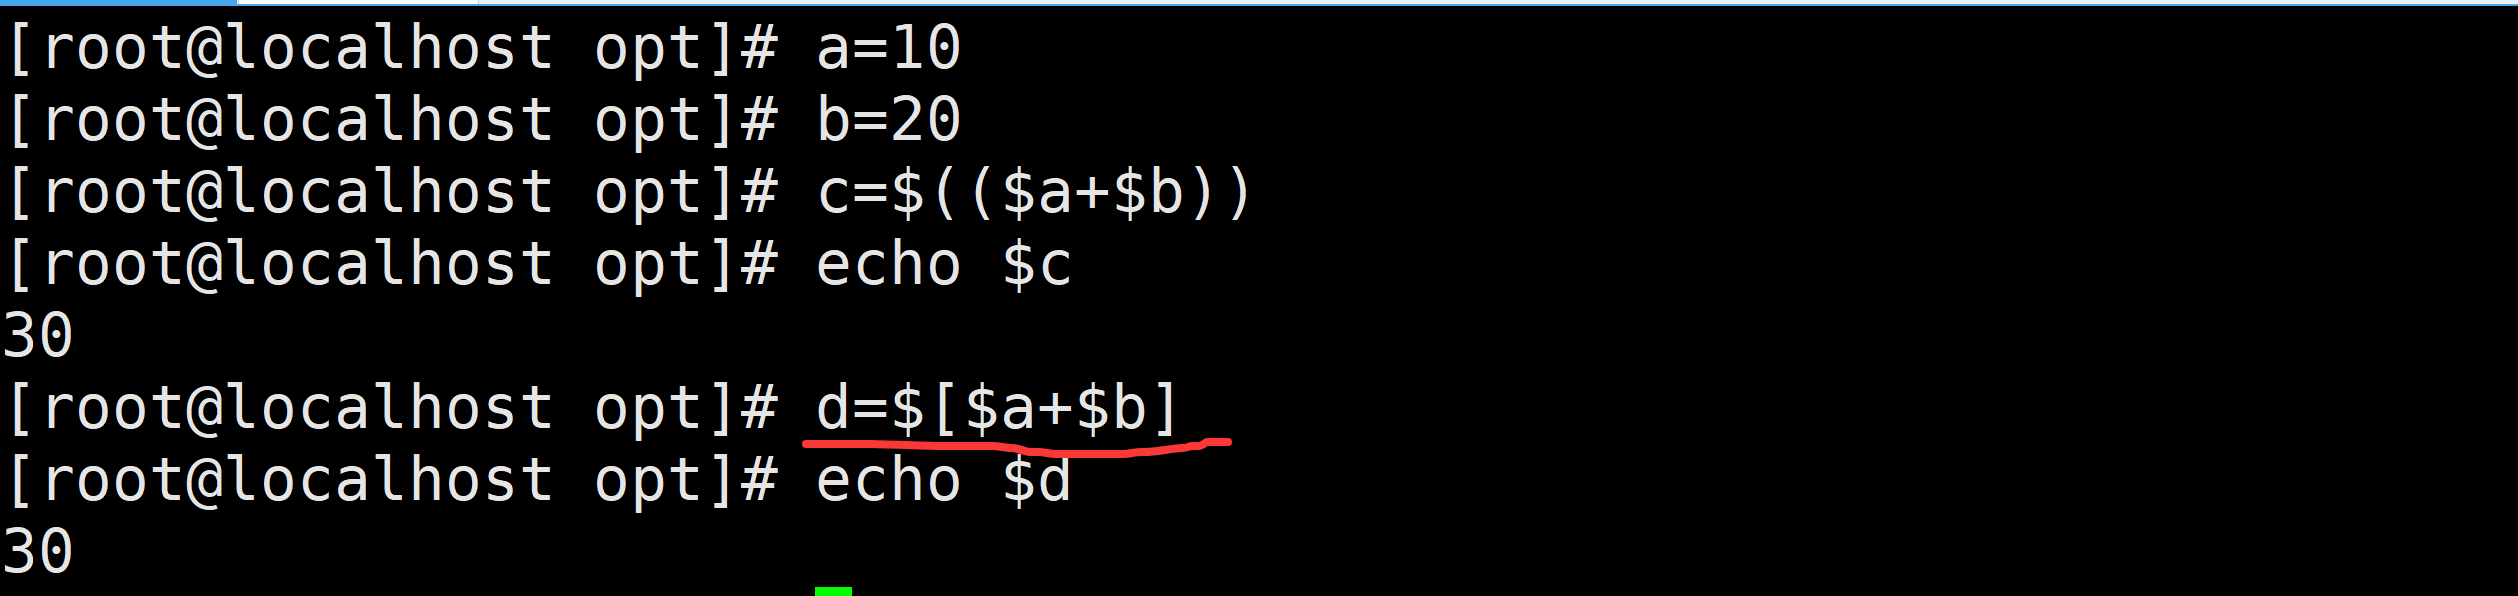
    使用$[]

    file

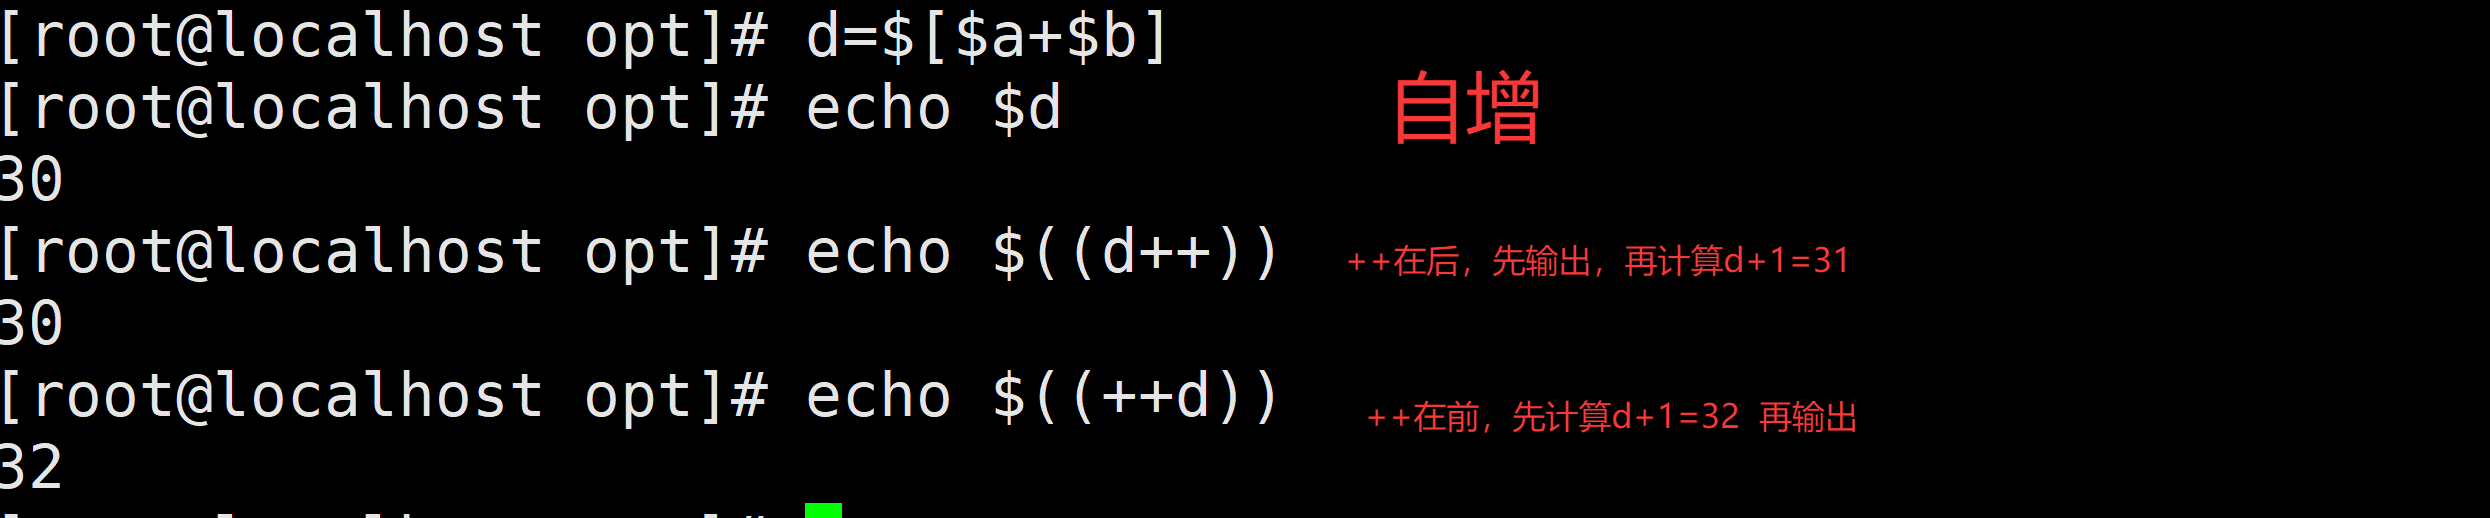
    自增

    file

    echo $(($a+$b))
    这种写法运用了双括号 ((...)) 结构,这是 bash 里专门用于进行算术扩展的结构。其优势在于支持丰富的算术表达式,像 +、-、*、/、% 等运算符都能使用,而且还能处理变量赋值、自增自减等操作。使用时,需把表达式放在双括号内部,并且通过 $() 把整个双括号结构括起来,从而将运算结果展开成一个值。
    echo $[$a+$b]
    此写法采用了中括号 [ ... ] 结构,这是较早期的 Shell 语法,同样用于算术扩展。它的功能和双括号结构类似,不过在表达式的书写上有一些限制,例如某些运算符需要添加转义符号,而且部分高级特性它并不支持。要注意的是,中括号必须用 $ 符号包裹,这样才能实现算术扩展。
    在现代的 bash 脚本编写中,推荐优先使用双括号 ((...)) 结构,原因如下:
    它的语法更加清晰直观。
    支持更多的算术操作符和特性。
    与其他编程语言(如 C、Python)的算术表达式更为接近,便于记忆和使用。
    而中括号 [ ... ] 结构虽然兼容性良好,但由于其语法存在一些限制,在新脚本中使用得越来越少。
    
    bash
    #!/bin/bash
    a=1
    b=2
    echo $(($a+$b))  # 输出 3
    echo $[$a+$b]    # 输出 3
    
    # 双括号支持更复杂的表达式
    echo $(($a+$b*2))  # 输出 5
    echo $[$a+$b*2]    # 输出 5
    
    # 双括号支持自增操作
    echo $((a++))      # 输出 1
    echo $a            # 输出 2
    
    # 中括号的一些限制(例如取模运算需要转义)
    echo $[$a % $b]    # 输出 0
    使用let命令

    基本语法 ---

    let 表达式
    表达式:可以包含变量、算术运算符(如 +、-、*、/、%)、赋值运算符(如 =、+=、*=)等。
    变量引用:let 命令中的变量名前不需要加 $ 符号(但加了也不会报错)。
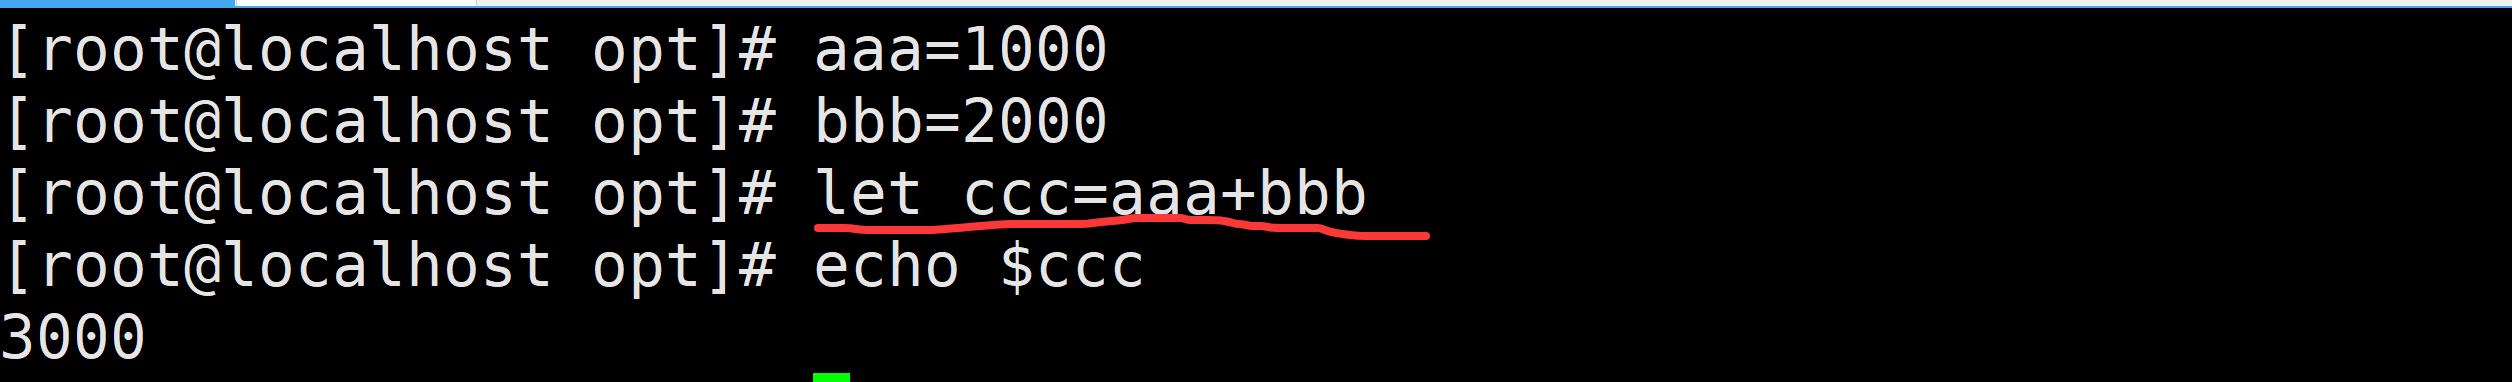
    file

    案例 ---

    1. 简单赋值运算
    let a=1+2     # a = 3
    let "a = 1 + 2"  # 引号可处理包含空格的表达式
    echo $a       # 输出 3
    1. 使用变量进行计算
    a=5
    let b=a*2     # b = 5 * 2 = 10
    echo $b       # 输出 10
    1. 复合赋值运算符
    a=10
    let a+=5      # 等价于 a = a + 5,结果 a = 15
    let a*=2      # 等价于 a = a * 2,结果 a = 30
    echo $a       # 输出 30
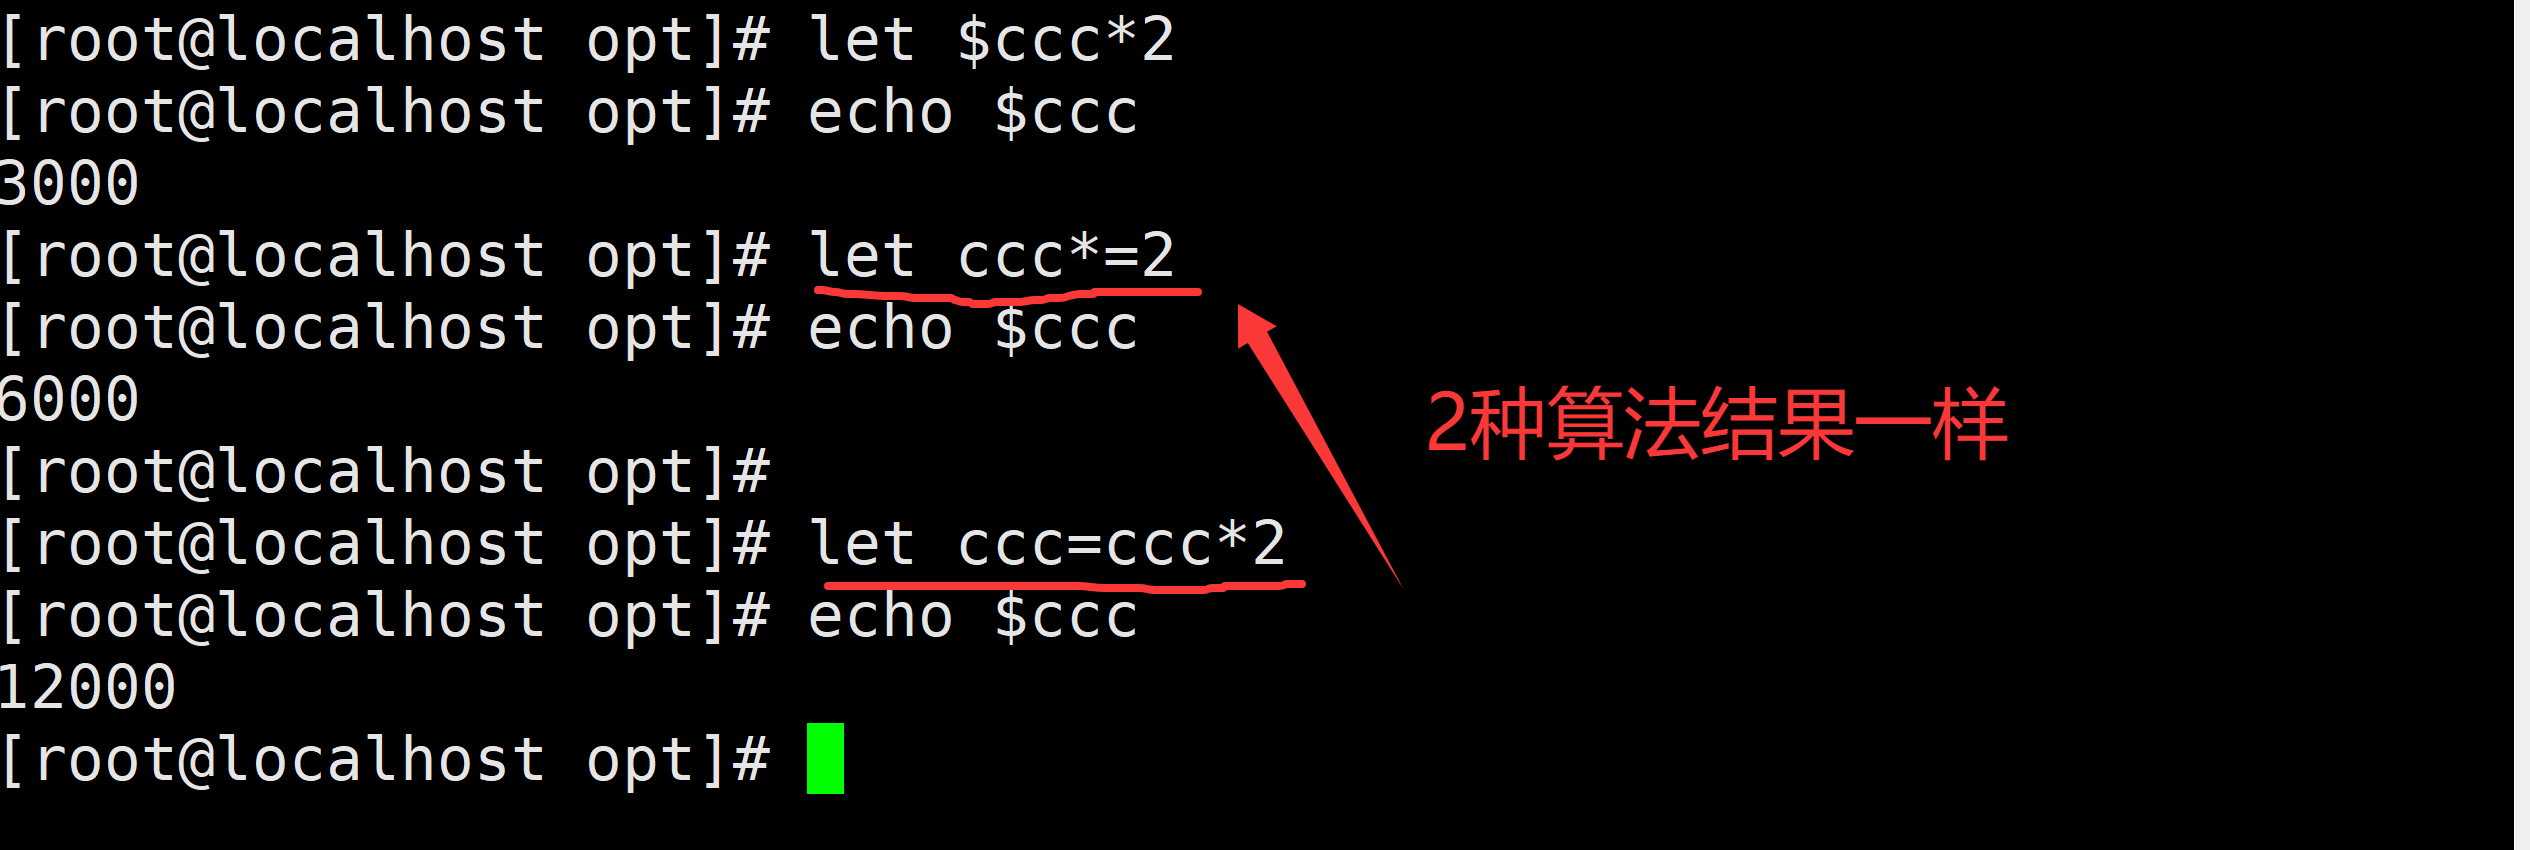
    file

    1. 自增 / 自减运算
    a=1
    let a++       # 自增,等价于 a = a + 1
    echo $a       # 输出 2
    let a--       # 自减,等价于 a = a - 1
    echo $a       # 输出 1
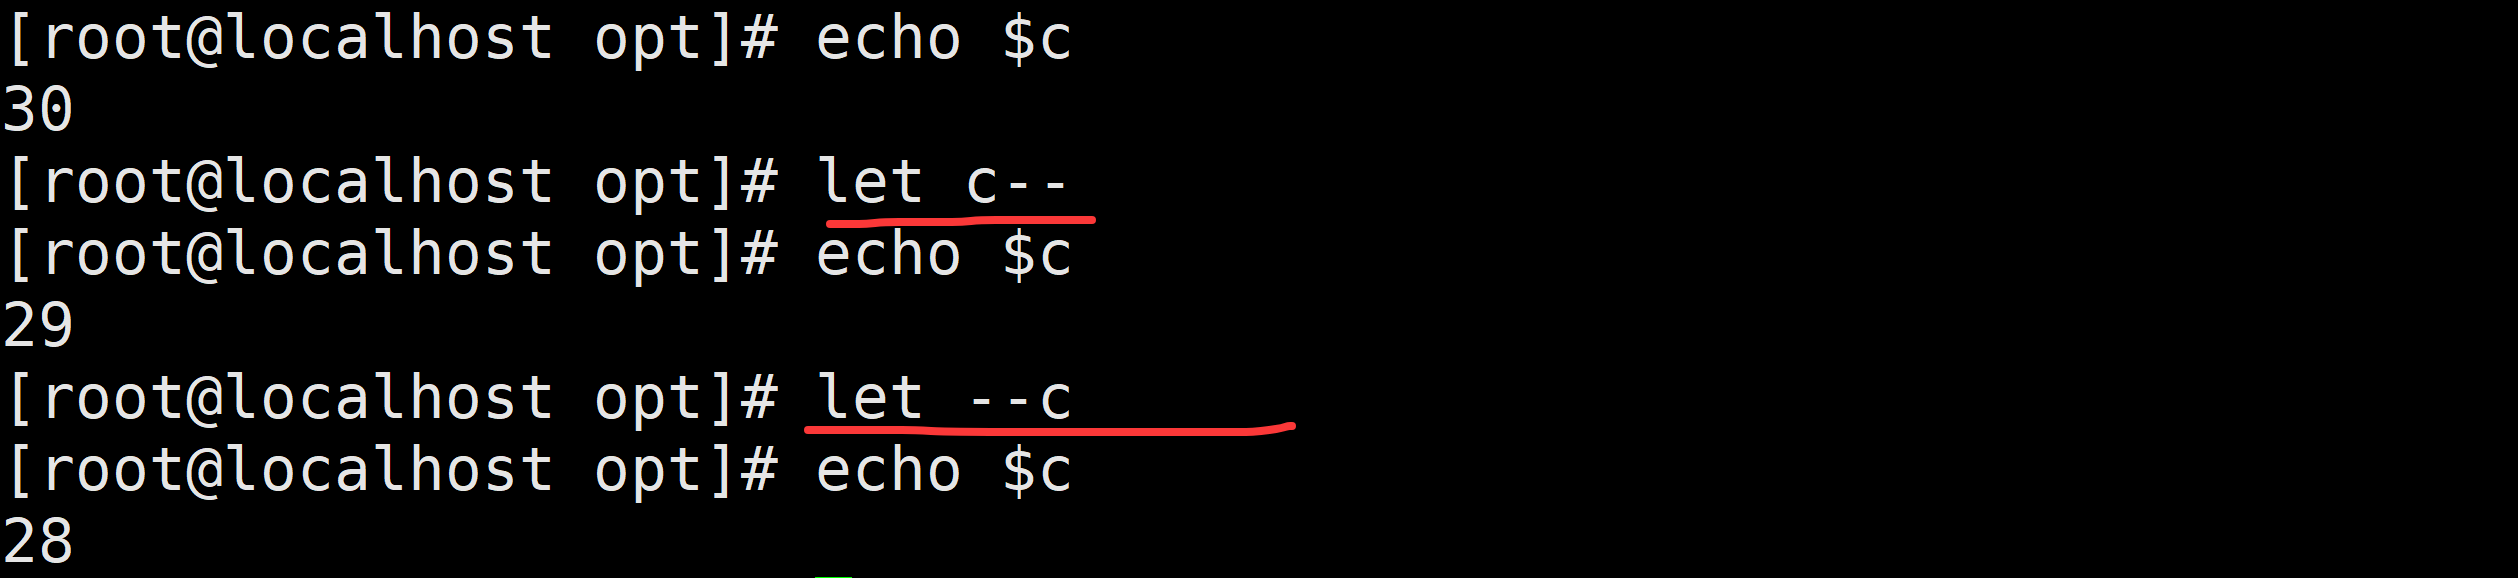
    file

    1. 多个表达式用空格分隔
    let "a=10 b=a*2 c=a+b"  # 连续赋值,a=10, b=20, c=30
    echo $c                 # 输出 30
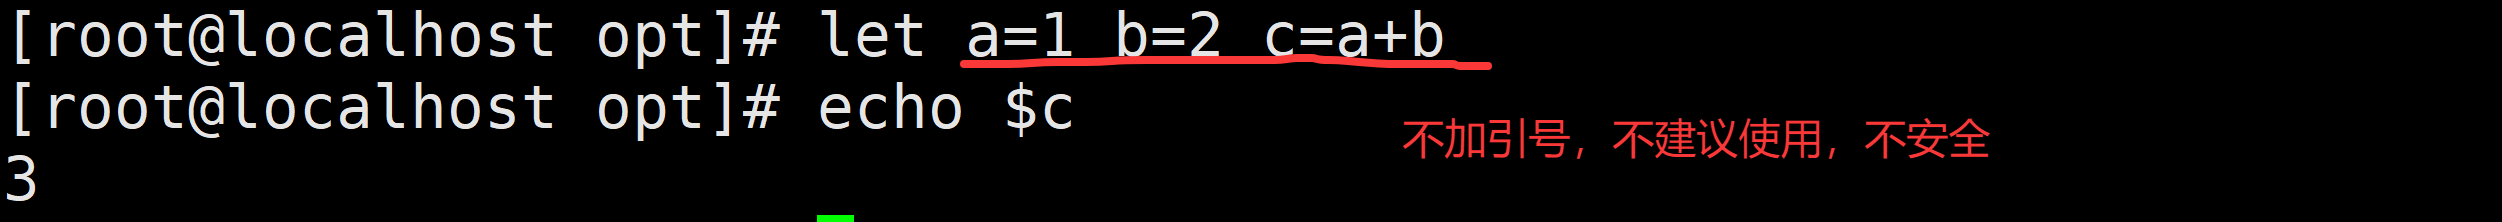
    file

    使用expr外部方程式

    基本语法 ---

    expr expression
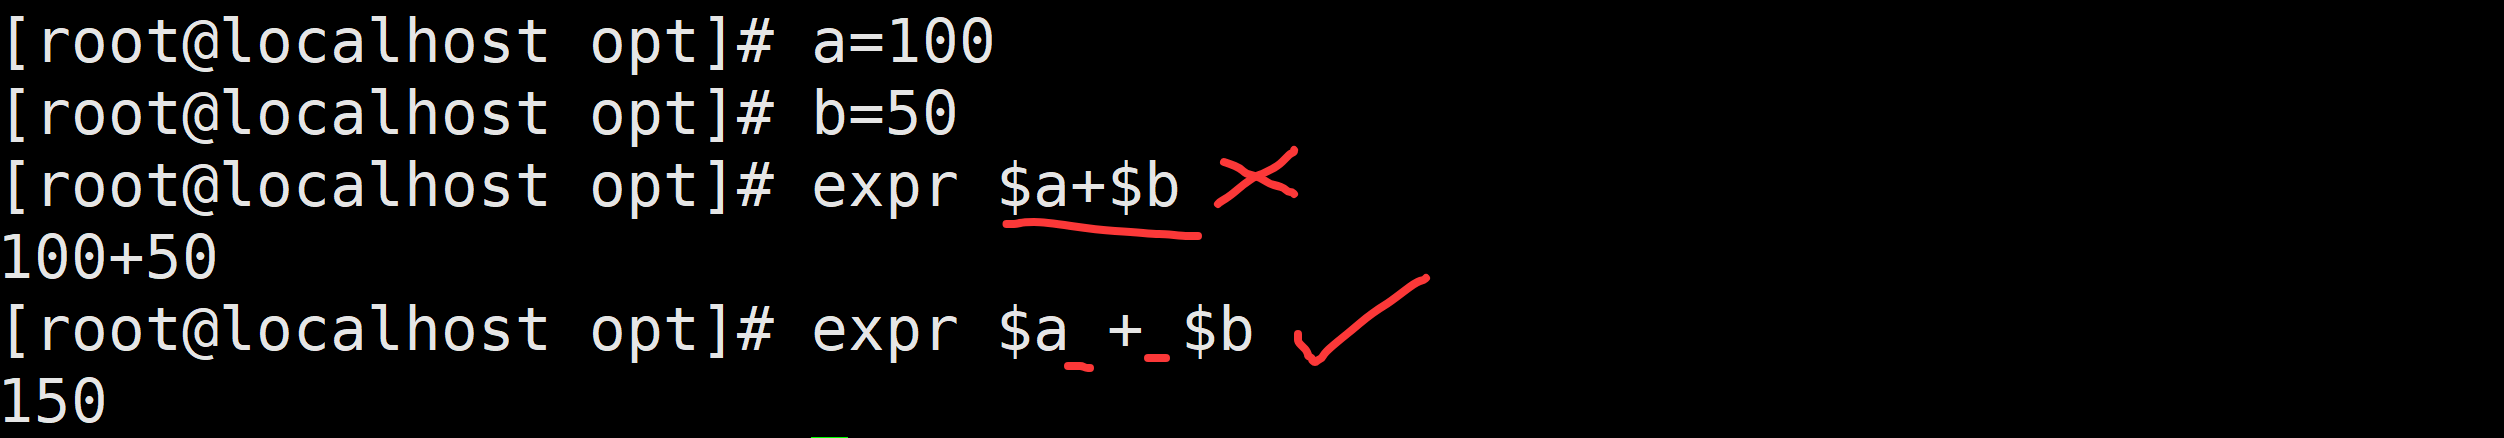
    注意:
    表达式中的运算符和操作数必须用空格分隔(如 2 + 3,而非 2+3)。
    特殊字符(如 *、(、))需要转义(前面加 \)。
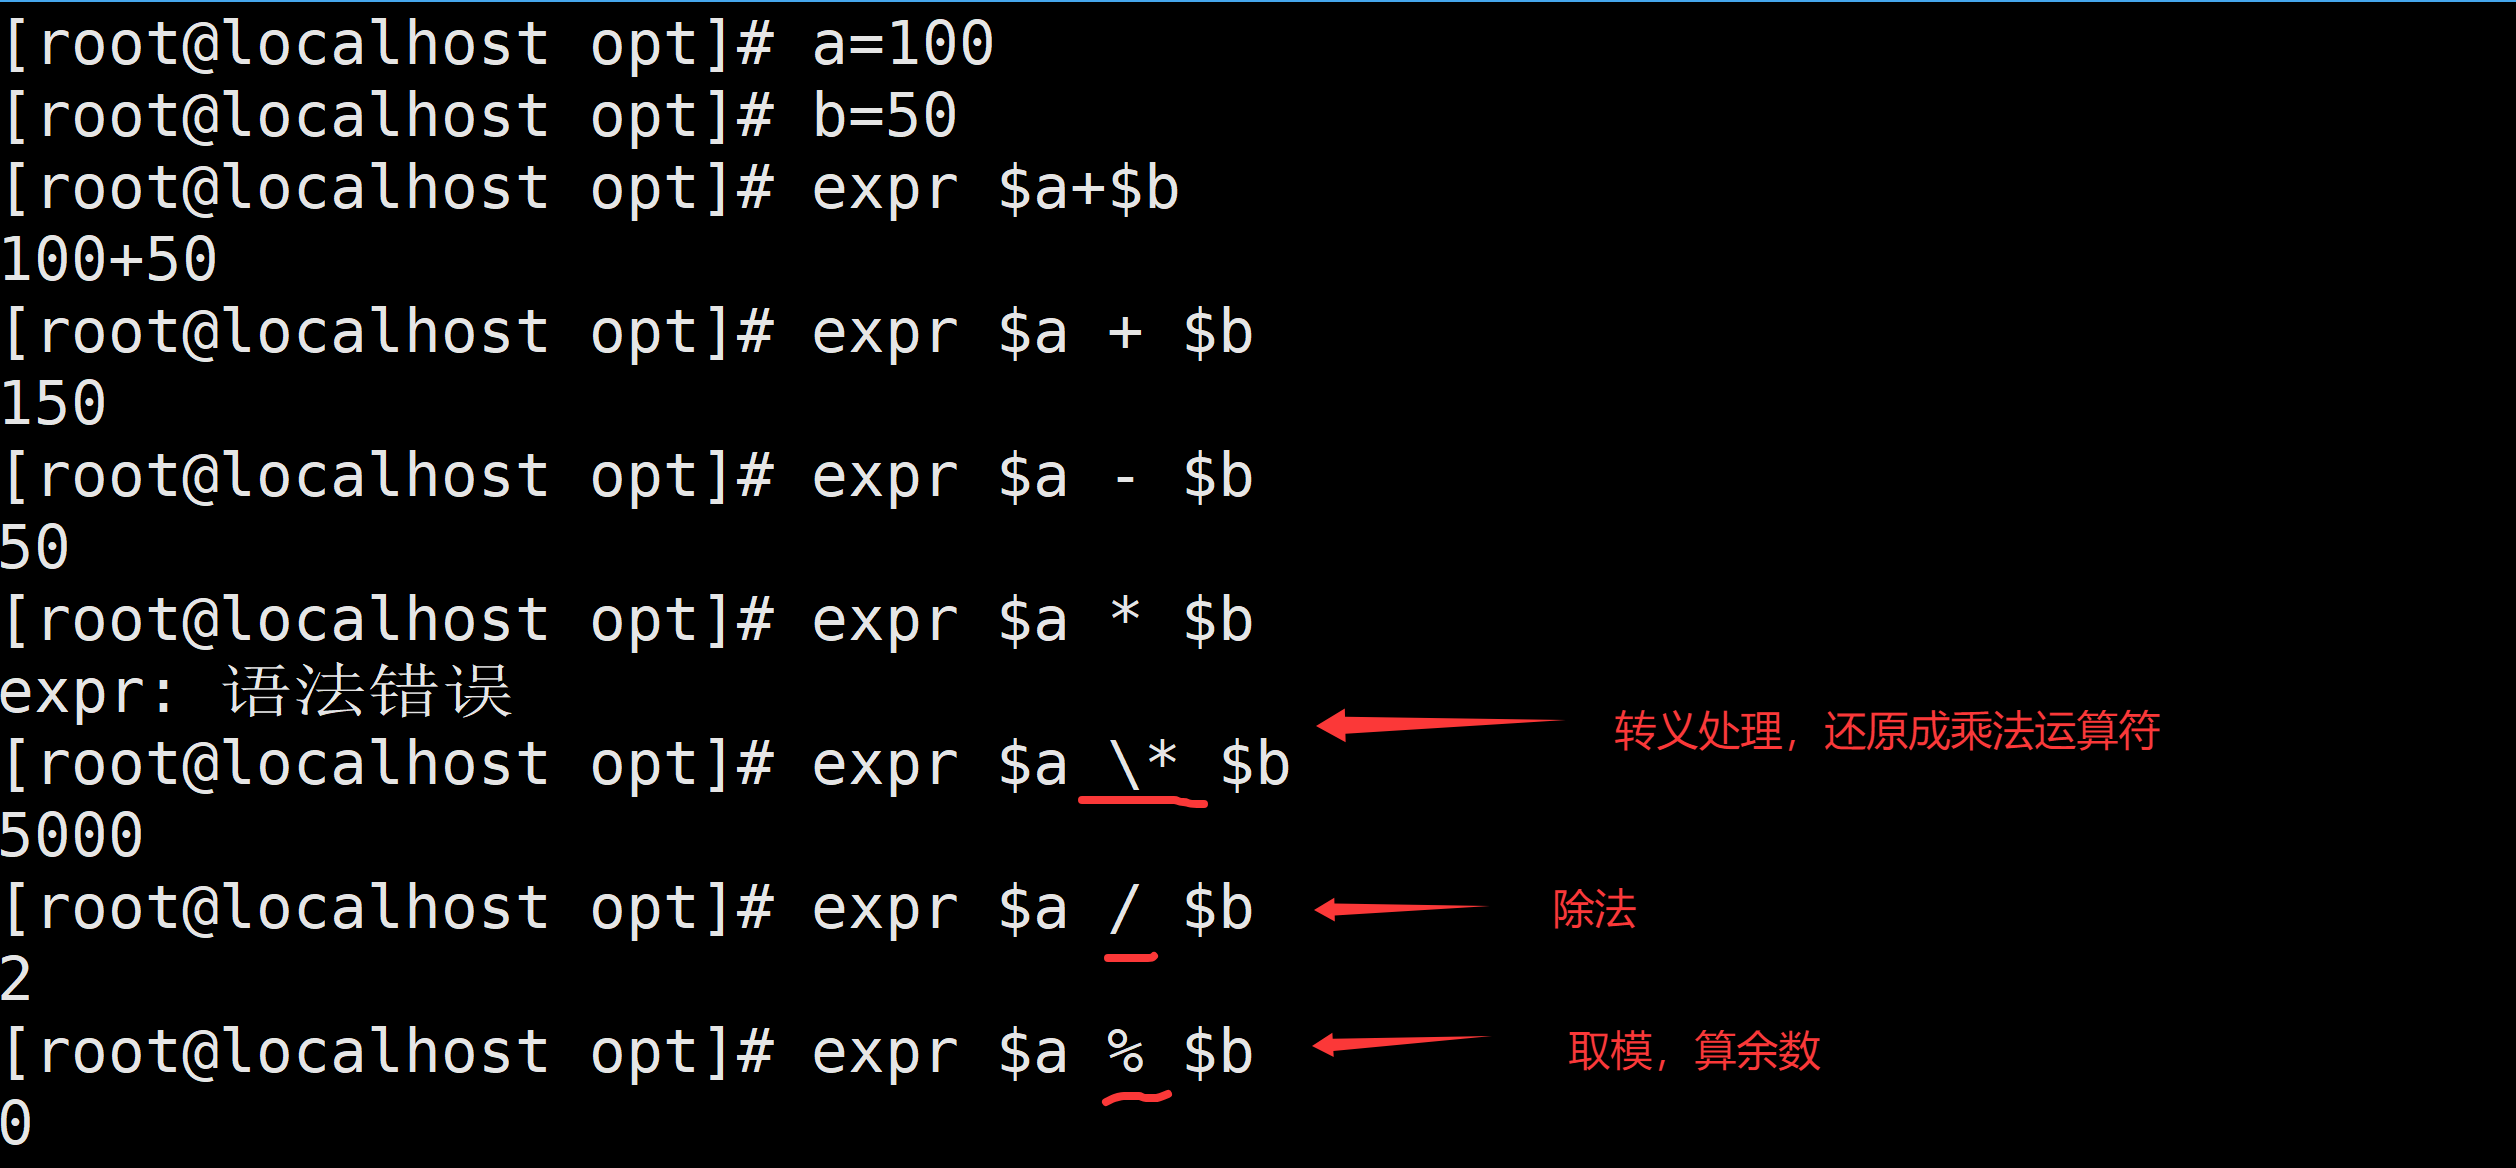
    file

    案例 --

    file

    1. 加法与减法
    expr 5 + 3     # 输出 8
    expr 10 - 4    # 输出 6
    1. 乘法与除法
    expr 5 \* 3    # 输出 15(* 需要转义)
    expr 10 / 3    # 输出 3(整数除法,直接截断小数)
    1. 取模与幂运算
    expr 10 % 3    # 输出 1(余数)
    # expr 不直接支持幂运算,需结合其他工具(如 bc)
    bc 是 Linux 系统中的一个命令行计算器,用于执行各种数学运算。它支持任意精度的算术运算,包括整数、小数和科学计数法。bc 是一个交互式的计算器,也可以通过脚本进行批量计算。 可以处理整数和浮点数计算。它还支持条件语句、循环以及函数定义,因此可以用来编写复杂的数学脚本。
    1. 变量计算
    a=5
    b=3
    expr $a + $b   # 输出 8

    3.字符串操作

    字符串操作
    file

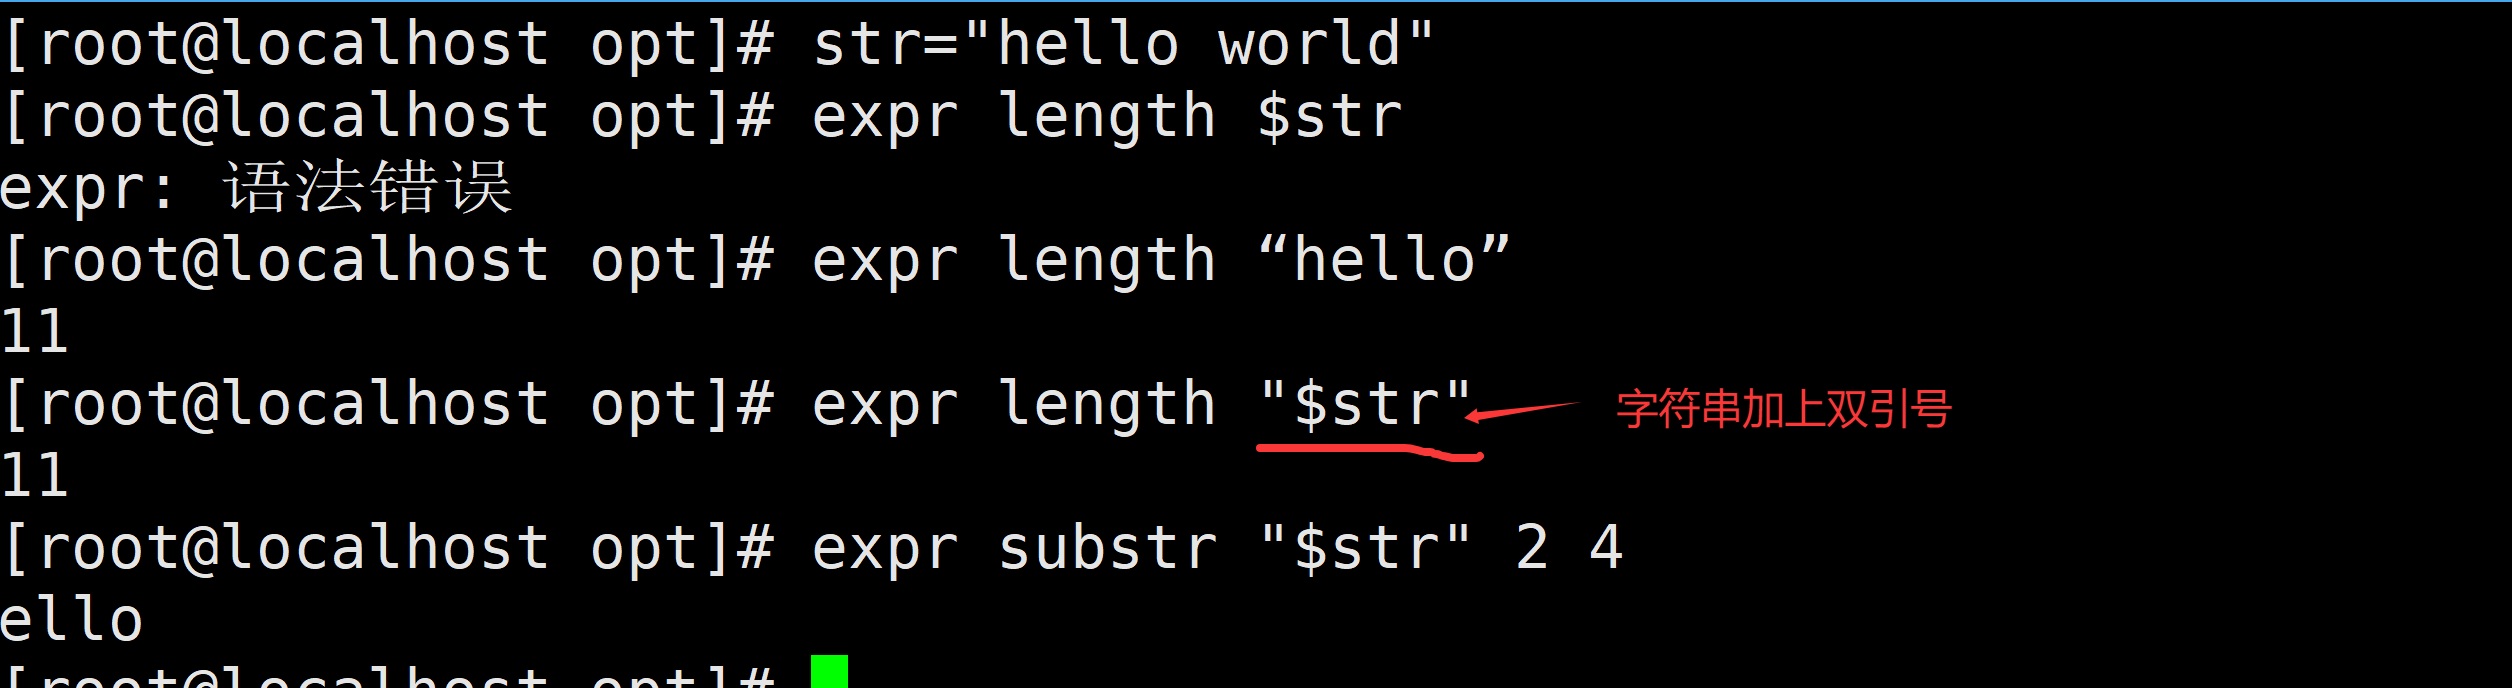
    1.字符串长度

    expr length "hello"   # 输出 5

    2.子串截取

    str="hello world"
    expr substr "$str" 2 4   # 输出 "ello"(从位置2开始,长度4)

    3.子串位置

    expr index "hello" "l"   # 输出 3(第一个 "l" 的位置,从1开始)
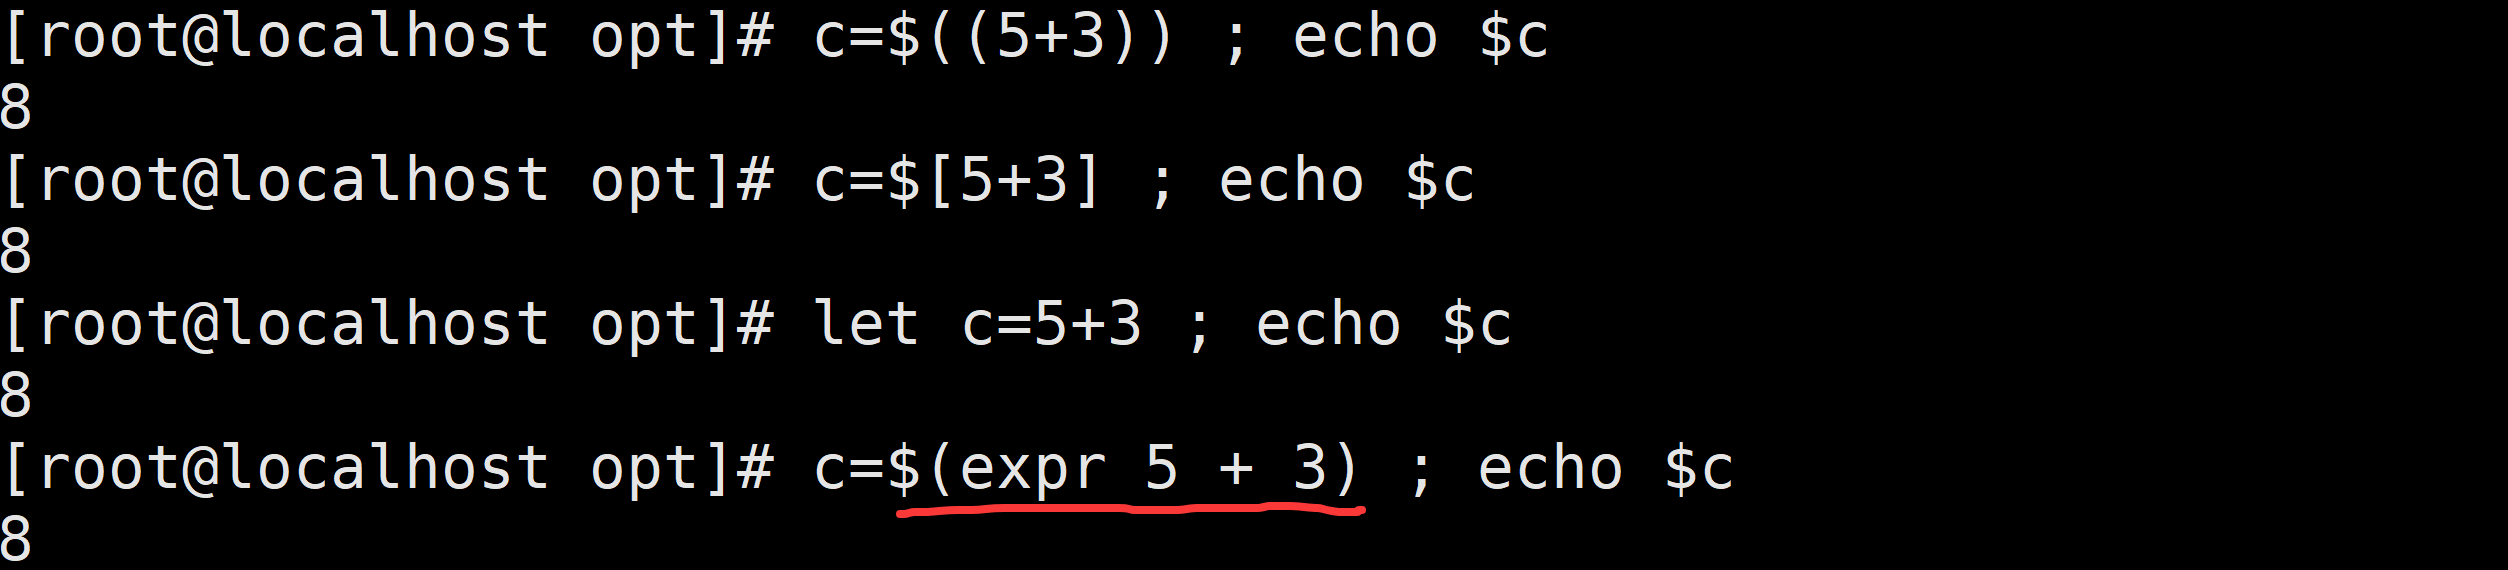
    题目 1:计算 5 + 3,分别用四种方式实现,并打印结果。
    题目 2:定义变量 a=10,b=2,计算 a * b - 5,用四种方式实现。
    题目 1:计算 5 + 3,分别用四种方式实现,并打印结果。
    [root@localhost opt]# a=$((5+3));echo $a
    8
    [root@localhost opt]# a=$[5+3];echo $a
    8
    [root@localhost opt]# let a=5+3;echo $a
    8
    [root@localhost opt]# a=$(expr 5 + 3) ; echo $a
    8
    题目 2:定义变量 a=10,b=2,计算 a * b - 5,用四种方式实现。
    [root@localhost opt]# a=10 b=2
    [root@localhost opt]# c=$(($a*$b-5)); echo $c
    15
    [root@localhost opt]# c=$[$a*$b-5]; echo $c
    15
    [root@localhost opt]# let c=a*b-5; echo $c
    15
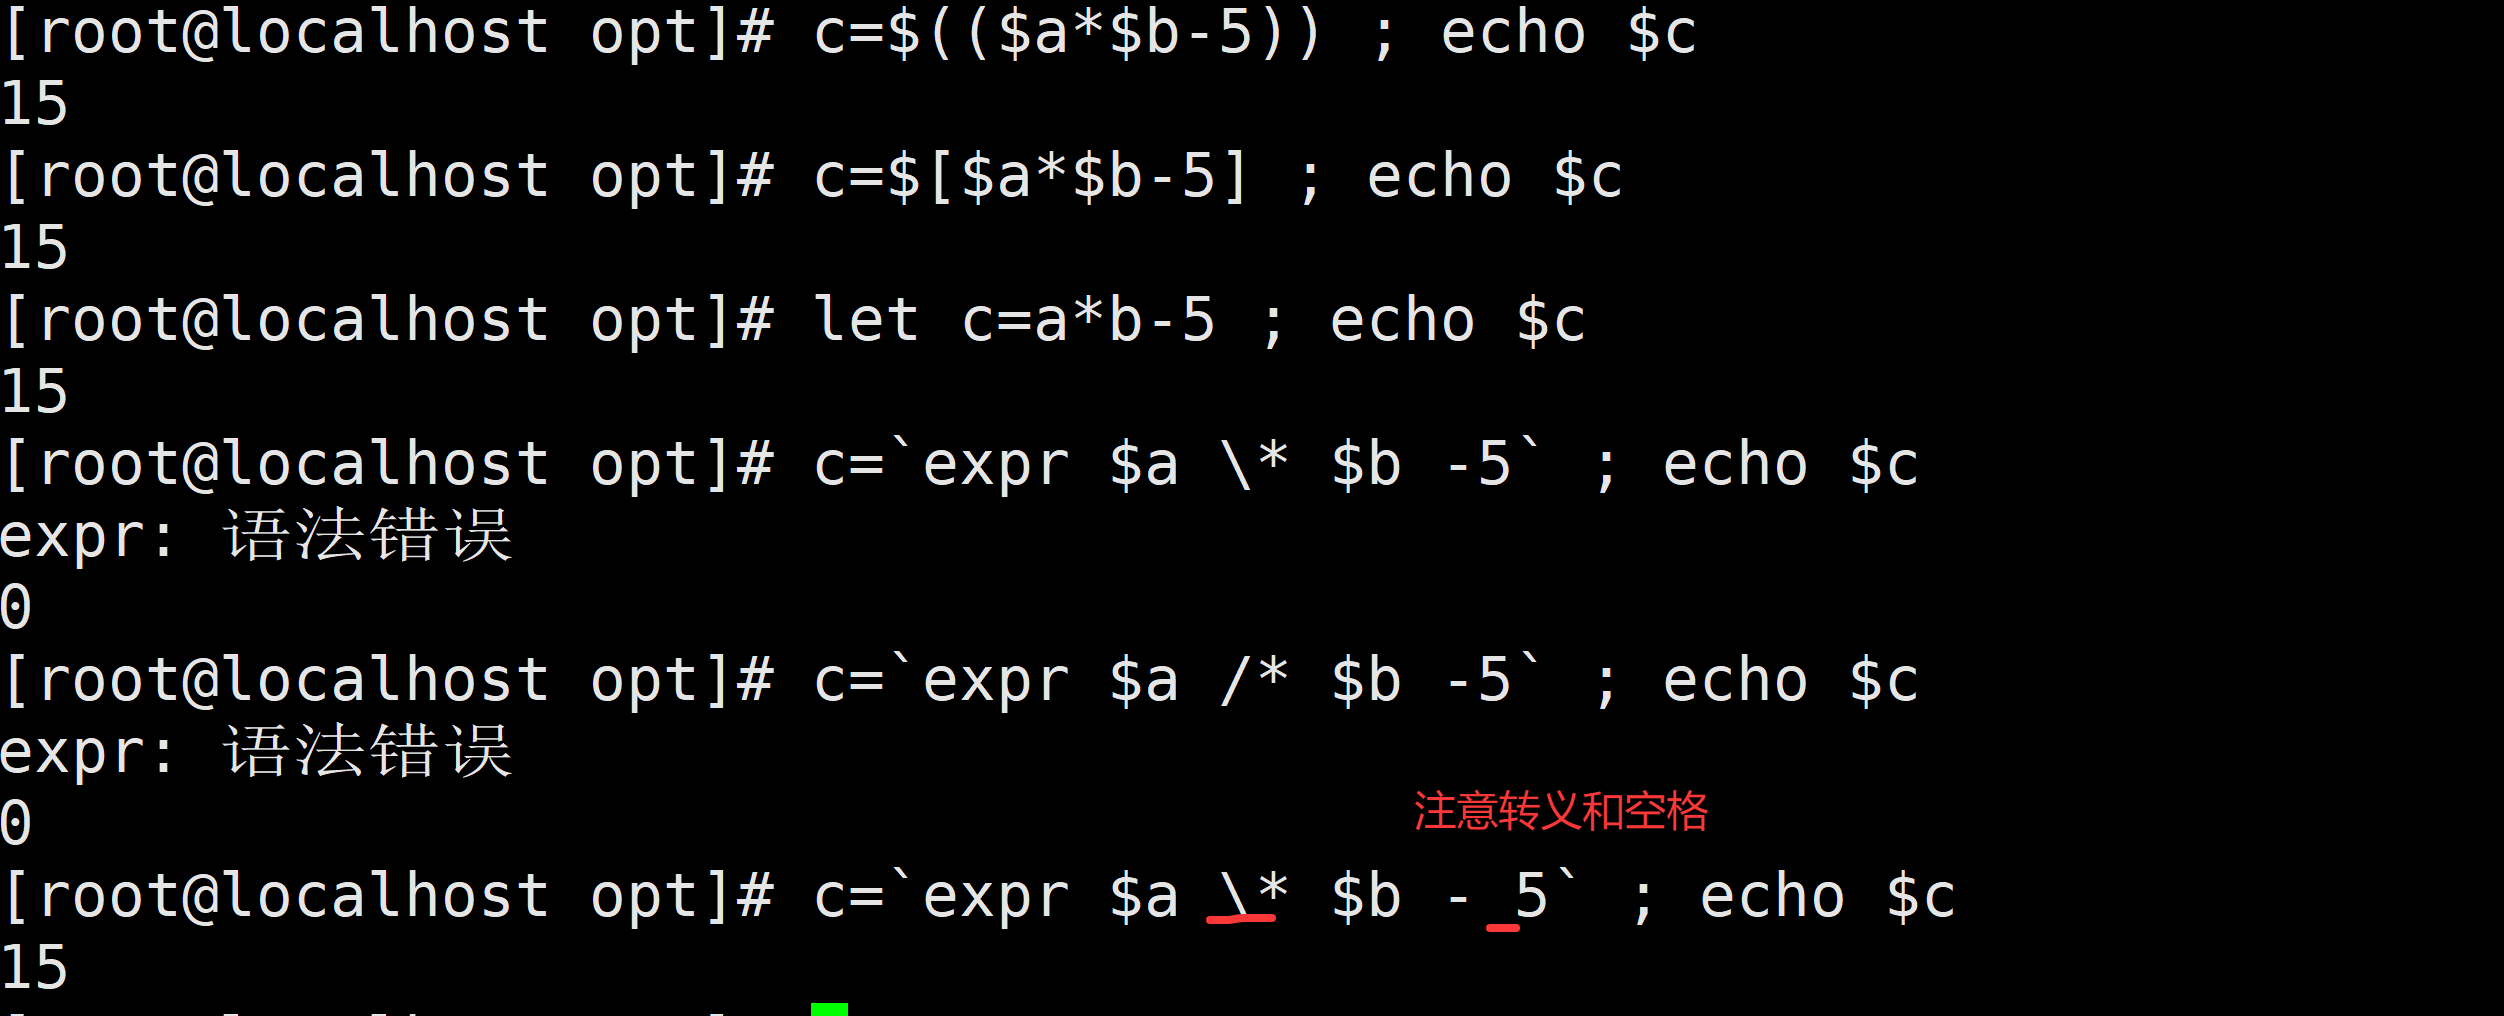
    [root@localhost opt]# c=`expr $a \* $b - 5`; echo $c
    15
    file

    file

    4.环境变量文件

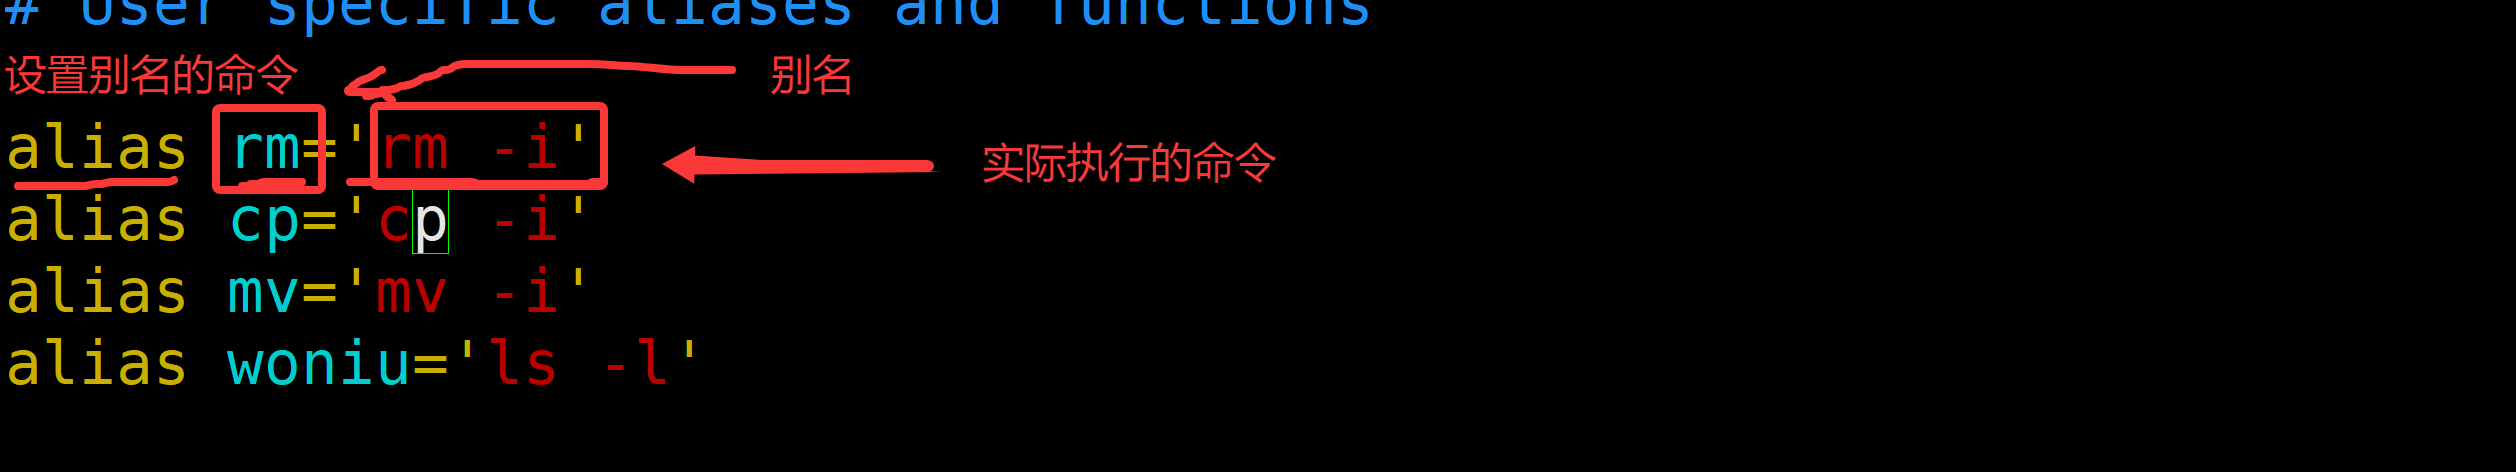
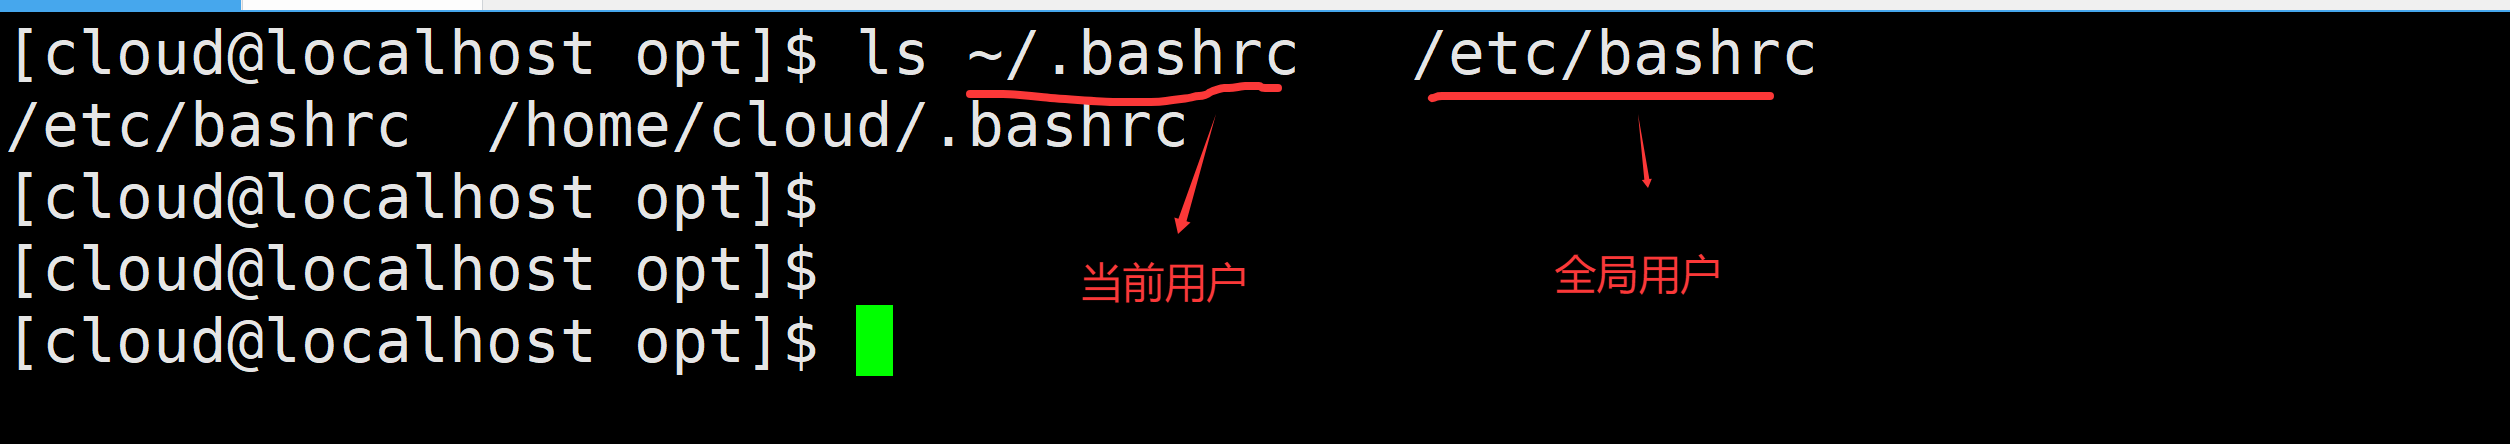
    $HOME/.bashrc                       # 当前用户的bash信息(aliase、umask等)$HOME/.bash_profile                 # 当前用户的环境变量()
    /etc/bashrc                         # 使用bash,shell用户全局变量,别名,全局变量
    /etc/profile                        # 系统和每个用户的环境变量信息,安装应用之后需要配置的地方
    file

    file

    file

    $HOME/.bashrc
    Bash shell 的配置脚本,属于用户级配置文件(仅对当前用户生效)。
    $HOME/.bash_profile
    用户登录时执行的初始化脚本,用于设置环境变量、启动服务等登录相关配置。
    /etc/bashrc
    定义所有用户的交互式 Bash Shell的默认行为,属于系统级配置。
    /etc/profile
    定义所有用户登录时执行的环境变量、全局变量和脚本,属于系统级配置。
    用户级配置(如~/.bash_profile)中的变量会覆盖/etc/profile中的同名变量。
    特性 .bash_profile .bashrc
    执行场景 登录 Shell(如 SSH、本地终端登录) 非登录 Shell(如bash启动的子 Shell)
    执行次数 登录时执行一次 每次启动子 Shell 时执行
    典型用途 环境变量、系统服务启动 别名、函数定义、终端显示优化
    加载顺序 先于.bashrc执行 通常由.bash_profile调用执行

    在 Linux 系统中,这四个配置文件的执行顺序取决于 Shell 的启动方式(登录 Shell 或非登录 Shell)以及 变量的定义位置。以下是详细的执行顺序和覆盖规则:

    一、执行顺序核心规则

    1. 登录 Shell(如 SSH 登录、su - user)
    /etc/profile → ~/.bash_profile → ~/.bash_login → ~/.profile → ~/.bashrc → /etc/bashrc
    • 关键点:
      • 系统级配置优先:先加载 /etc/profile。
      • 用户级配置覆盖:~/.bash_profile 中的变量会覆盖 /etc/profile 中的同名变量。
      • .bashrc 被间接加载:通常在 .bash_profile 中会通过 source ~/.bashrc 引用用户的 .bashrc,而 .bashrc 又会引用 /etc/bashrc。
    1. 非登录 Shell(如直接运行 bash 或执行脚本)
    ~/.bashrc → /etc/bashrc
    • 关键点:


      • 仅加载用户和系统的 bashrc:不执行 /etc/profile 和 ~/.bash_profile。

      • 变量覆盖:~/.bashrc 中的变量会覆盖 /etc/bashrc 中的同名变量。

    5.条件判断

    5.1 概述

    条件判断:就是对数据或者字符的判断,判断的结果只有两种,要么为真,要么为假。比如:1=1结果为真;1>2结果为假等

    条件判断的结果:

    • true:表示结果为真
    • false:表示结果为假

    shell中我们通常是对变量的判断,或者命令是否执行成功的判断

    思考:如何判断一个命令是否执行成功?

    $?:上一条命令执行后返回的状态,当返回状态值为0时表示执行正常,非0值表示执行异常或出错
    file

    5.2 语法

    条件判断在shell中有三种表现形式,用哪一种都可以,但是在某一些情况下会存在一些差异(这些差异我们暂时不管,后面在单独说)
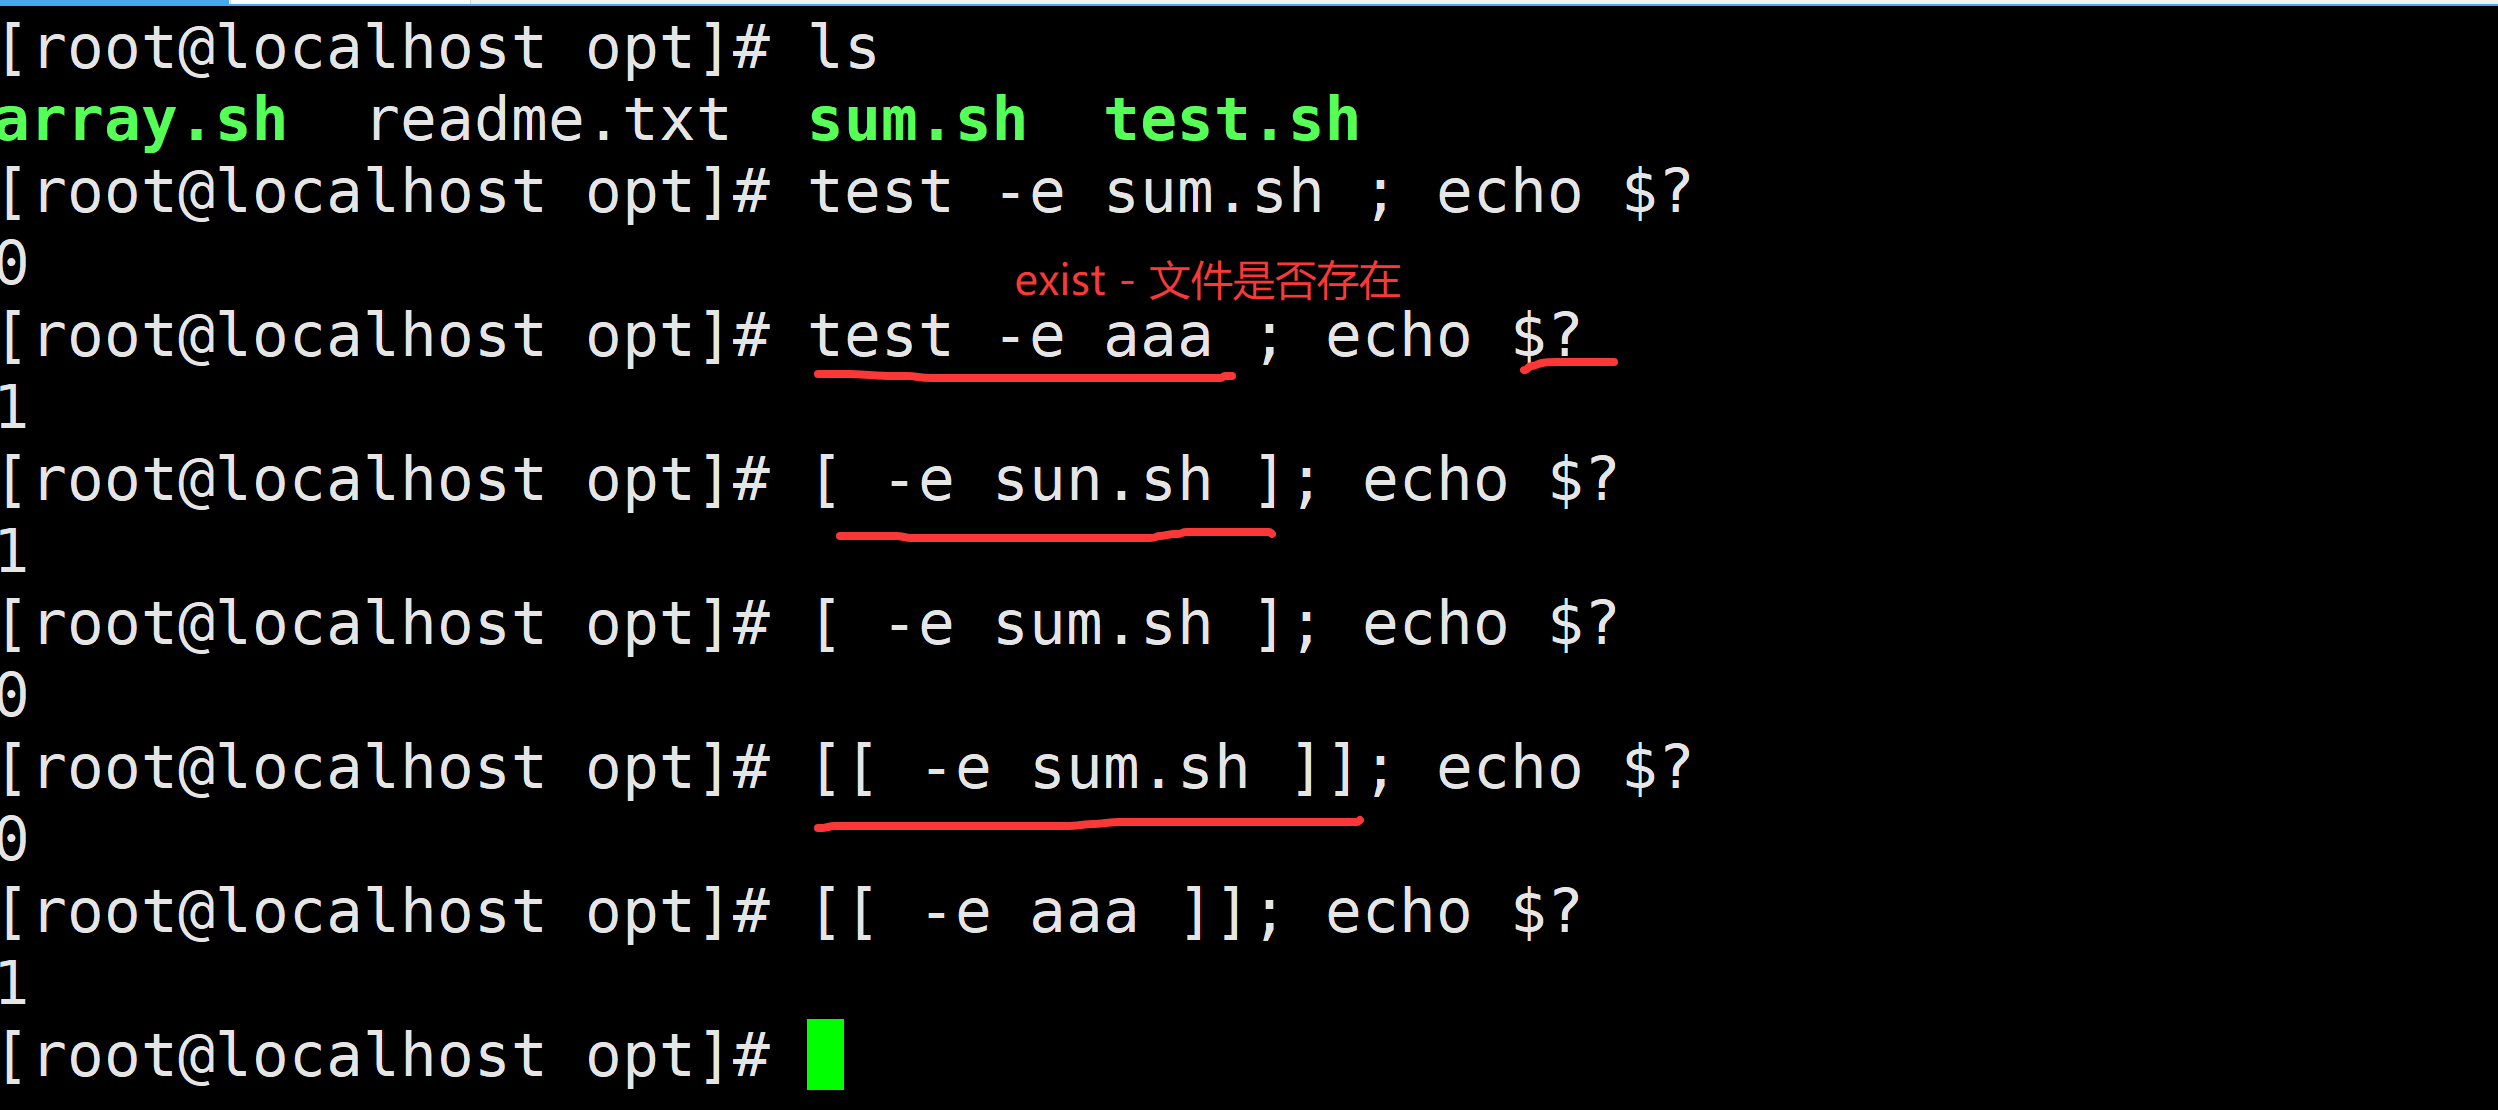
    • 格式1: test 条件表达式

    • 格式2: [ 条件表达式 ] # 注意:[]括号跟里面的内容之间都必须要存在一个空格

    • 格式3: [[ 条件表达式 ]] # 注意:里层的[]括号跟里面的内容之间都必须要存在一个空格

      test格式

    file

    示例:

    三种语法格式:
    test -e abc.txt                                    # 只要文件存在条件为真
    [ -d aaa ]                                         # 判断目录是否存在,存在条件为真
    [ ! -d aaa ]                                    # 判断目录是否存在,不存在条件为真
    [[ -f abc.txt ]]                                # 判断文件是否存在,并且是一个普通的文件

    5.3 常见判断参数

    1)与文件存在与否的判断
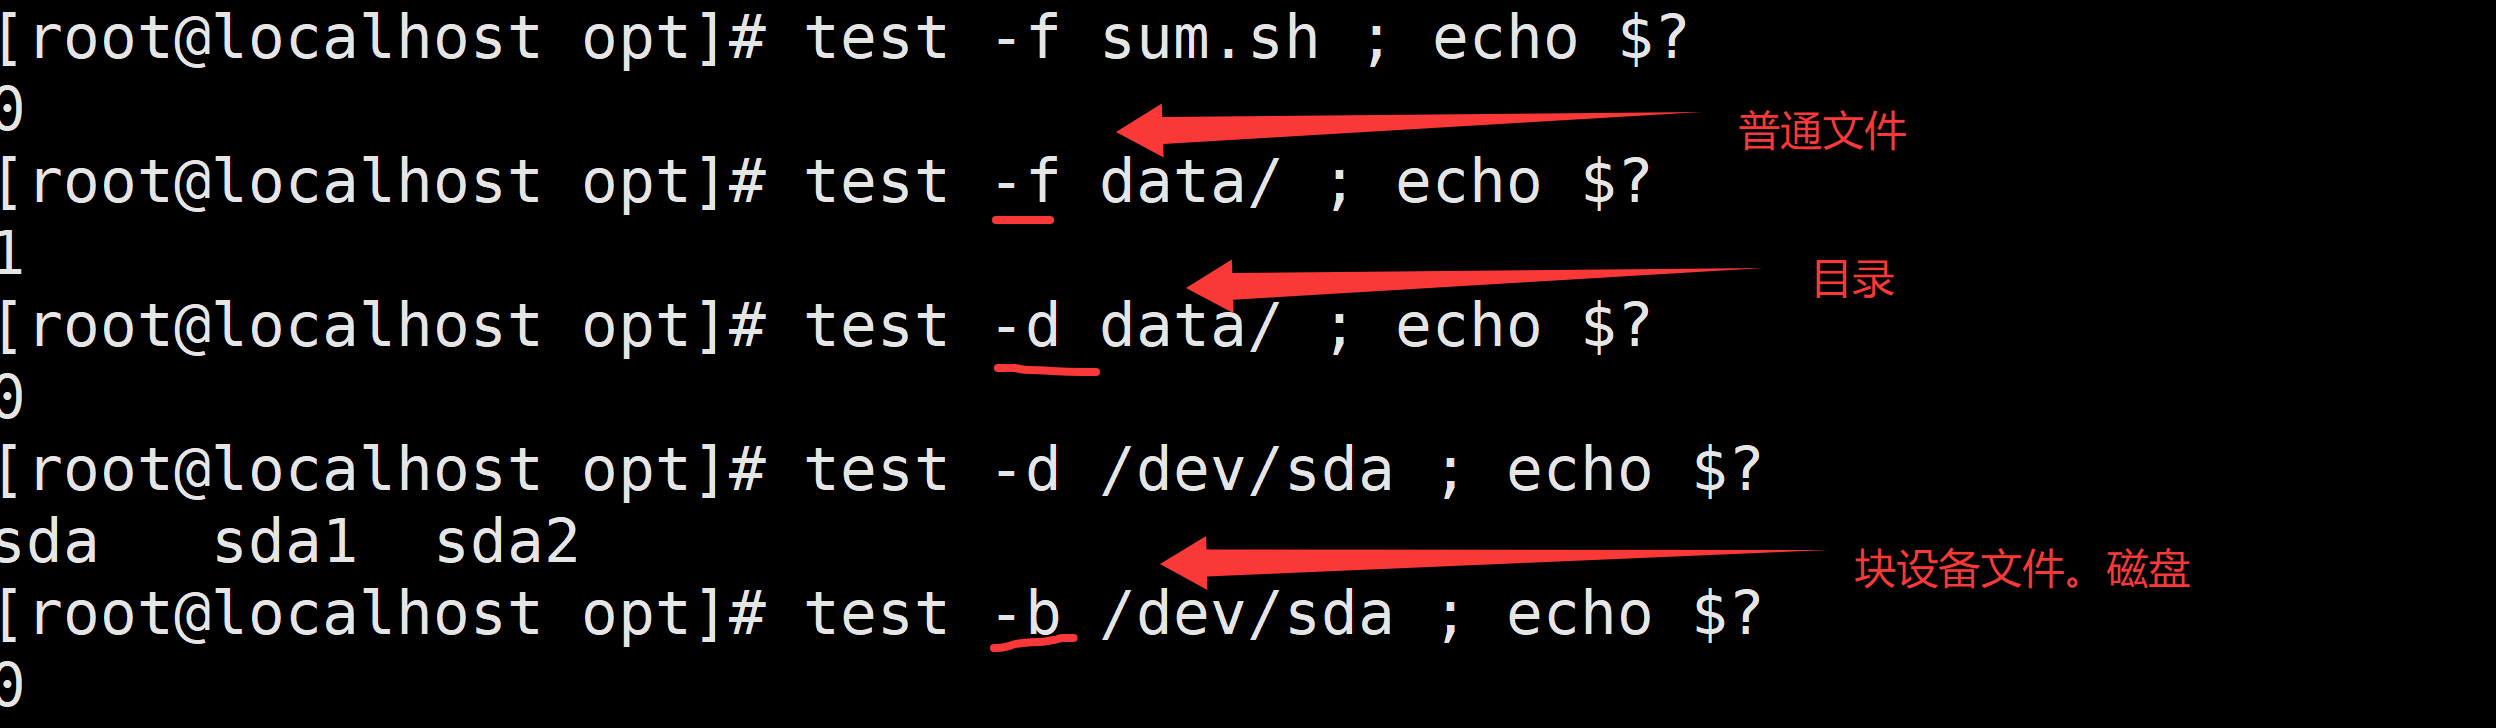
    -e(Exist)            是否存在(不管是文件还是目录,只要存在,条件就成立)
    -f(file)            是否为普通文件
    -d(directory)        是否为目录
    -S    socket
    -p    pipe
    -c    character
    -b    block                块设备文件、磁盘
    -L    软link
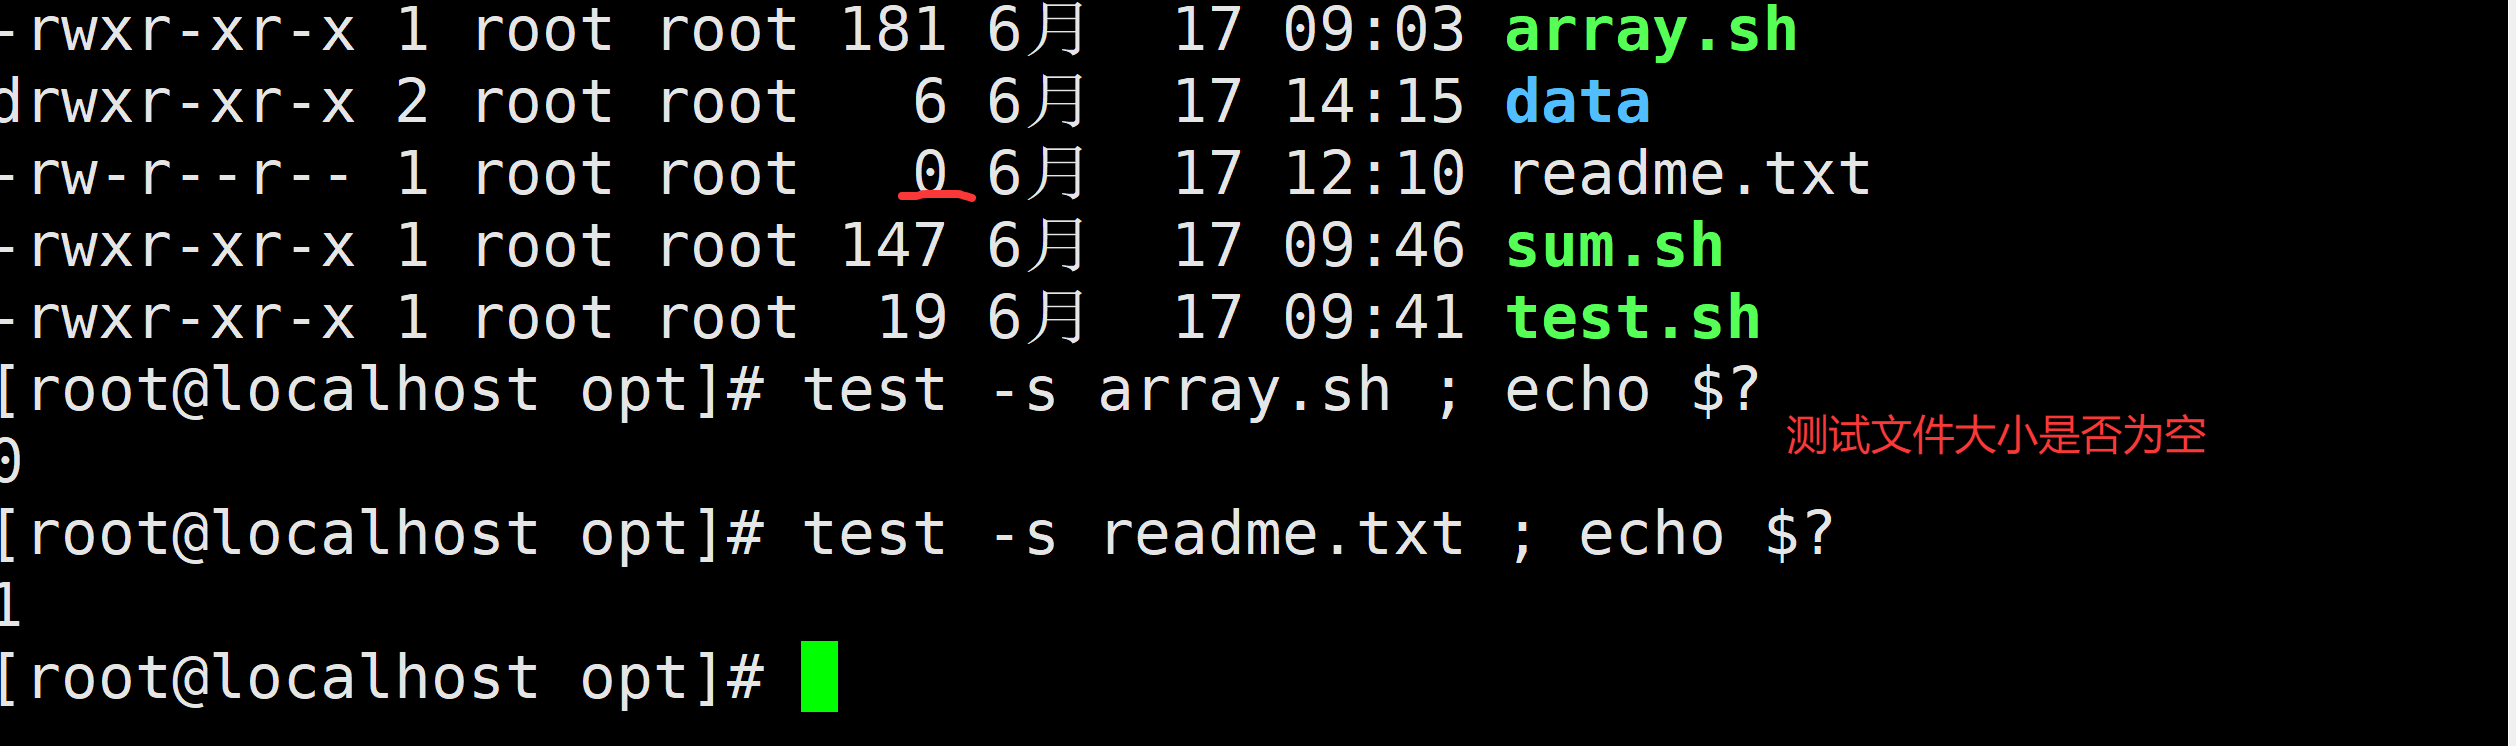
    -s(size)              判断文件是否有内容(大小),非空文件条件满足
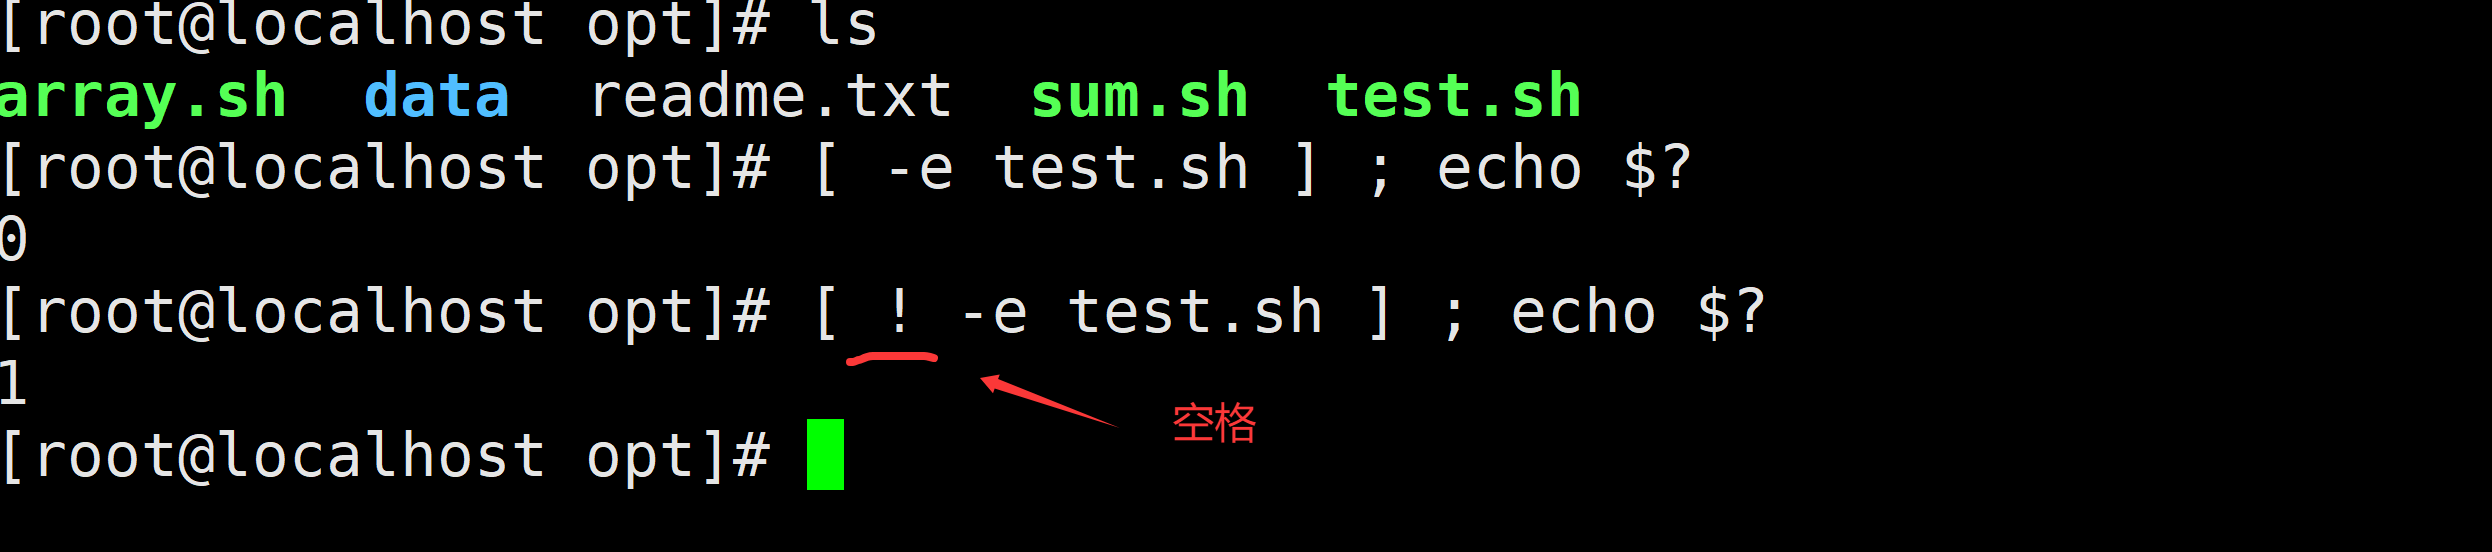
    !  表示取反(真变假 假变真)

    ; (分号):表示执行完上一个命令,接着执行下一个命令
    file

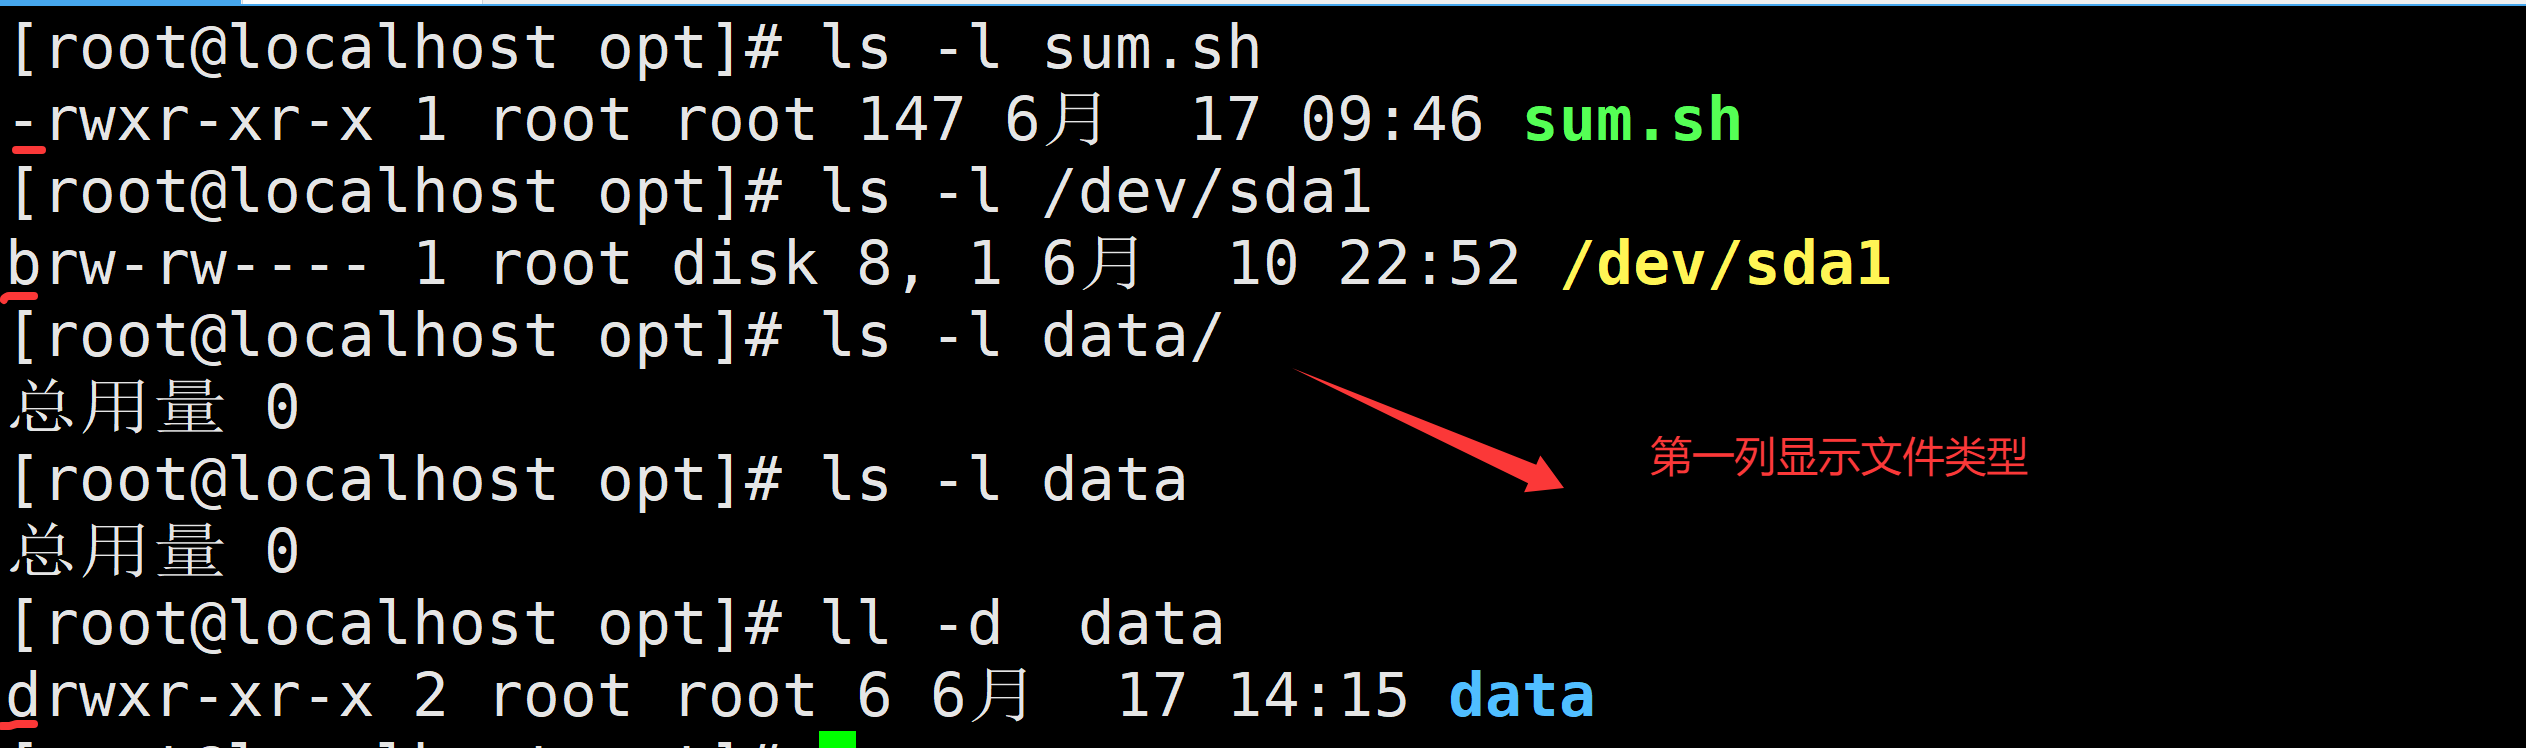
    查看文件类型

    file

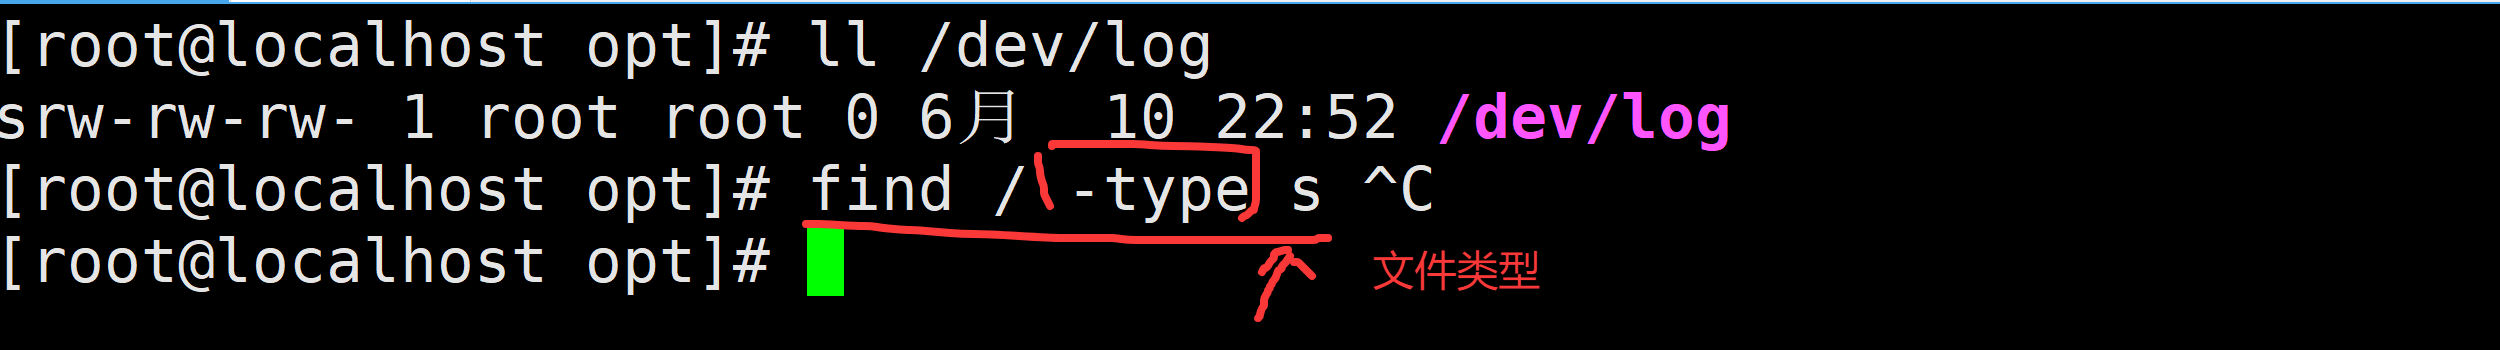
    查找指定类型的文件

    file

    -s选项 文件是否为空

    file

    取反

    file

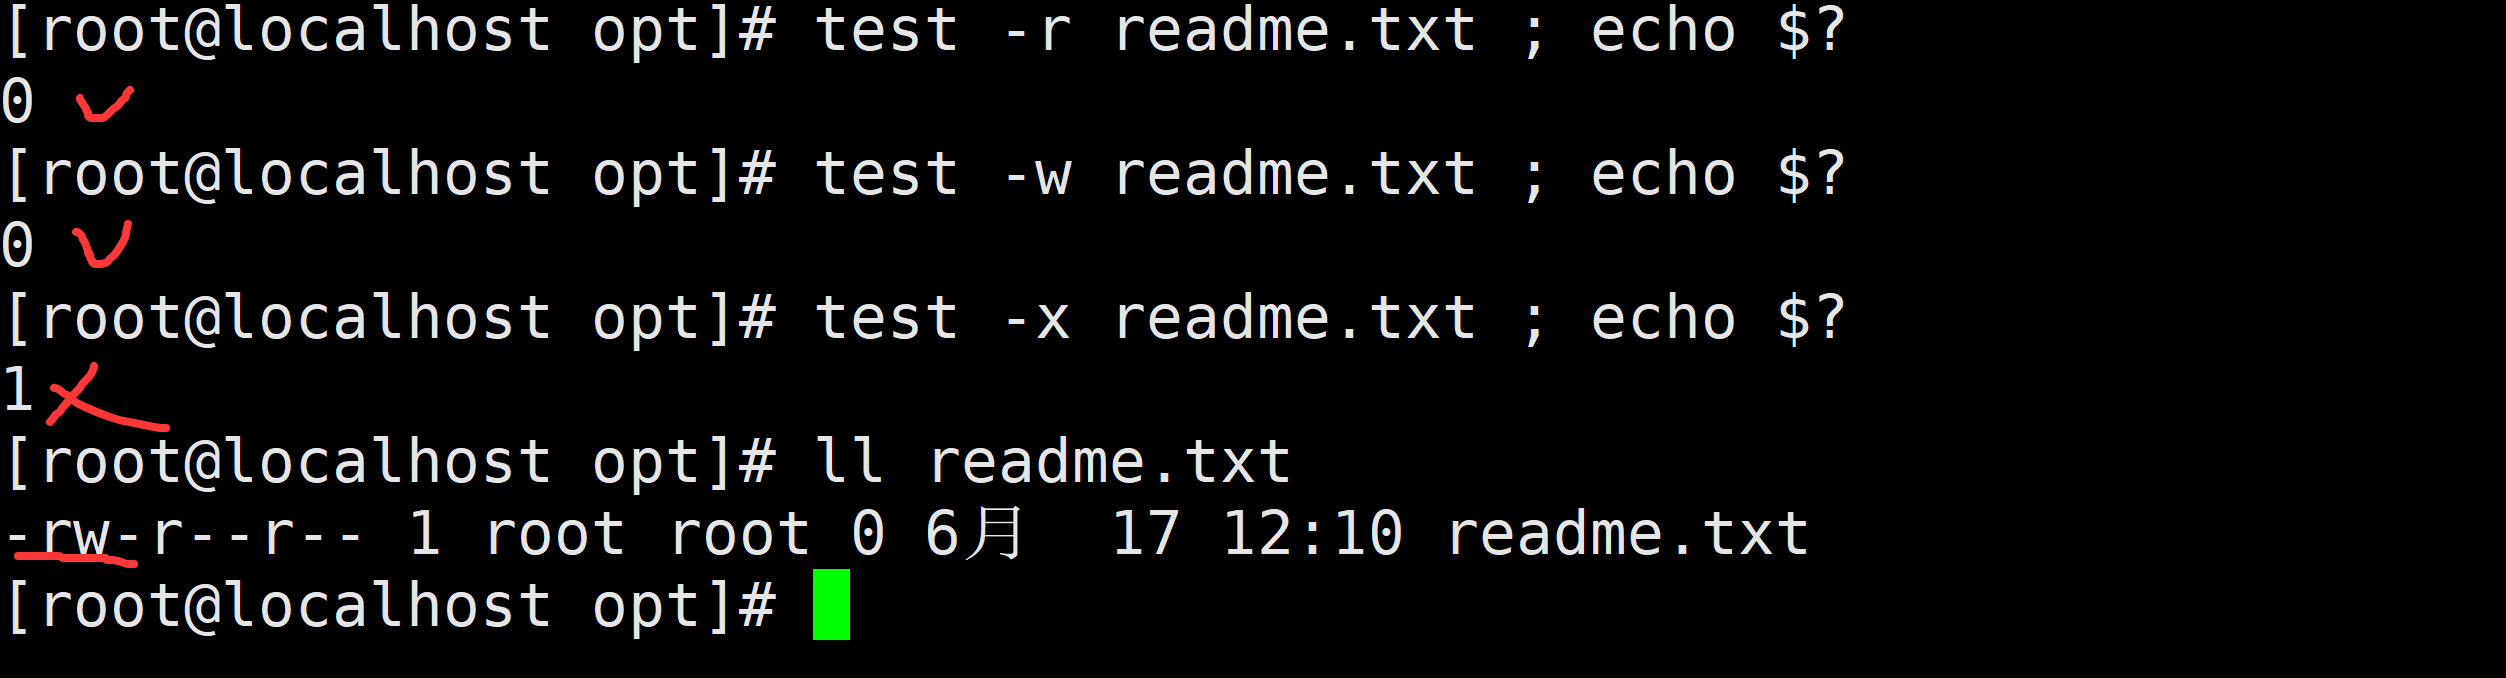
    2)文件权限相关的判断

    文件权限相关的判断

    -r    当前用户对其是否可读
    -w    当前用户对其是否可写
    -x    当前用户对其是否可执行
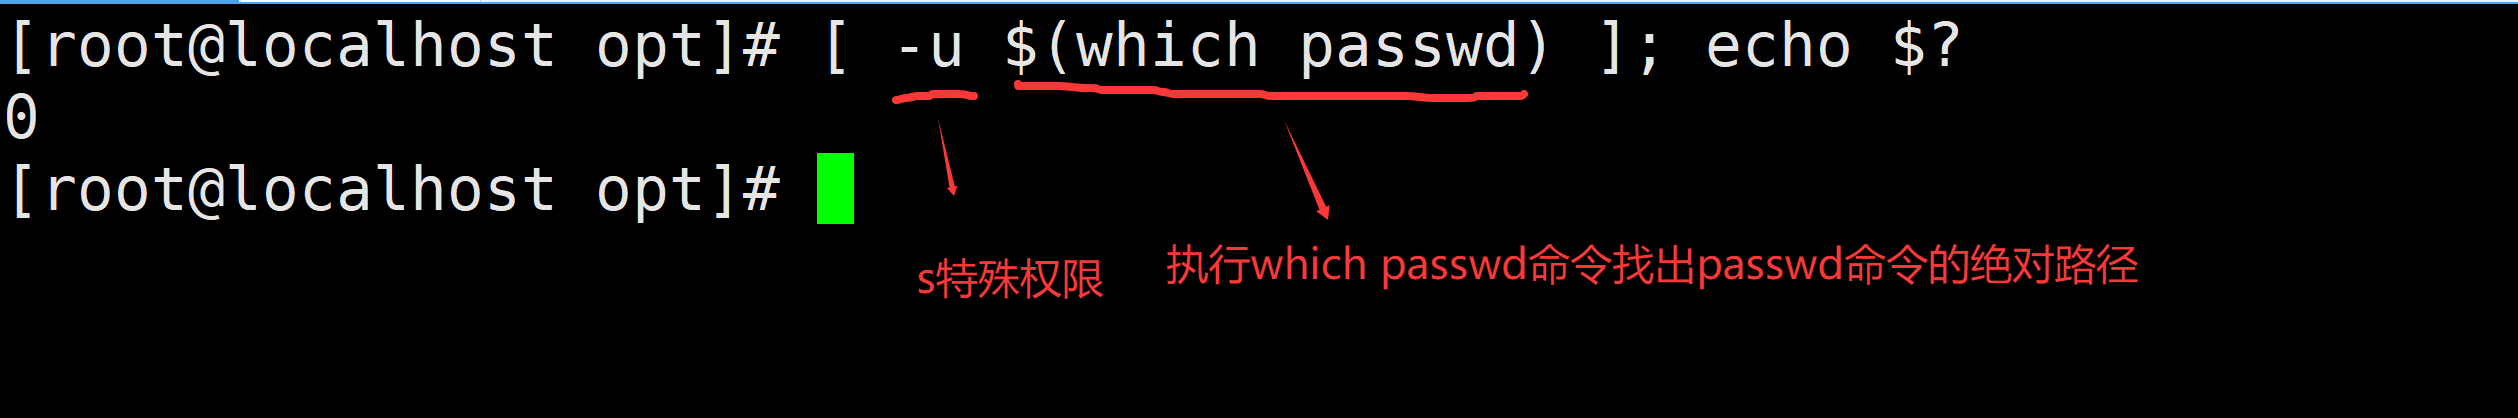
    -u    是否有suid
    -g    是否sgid
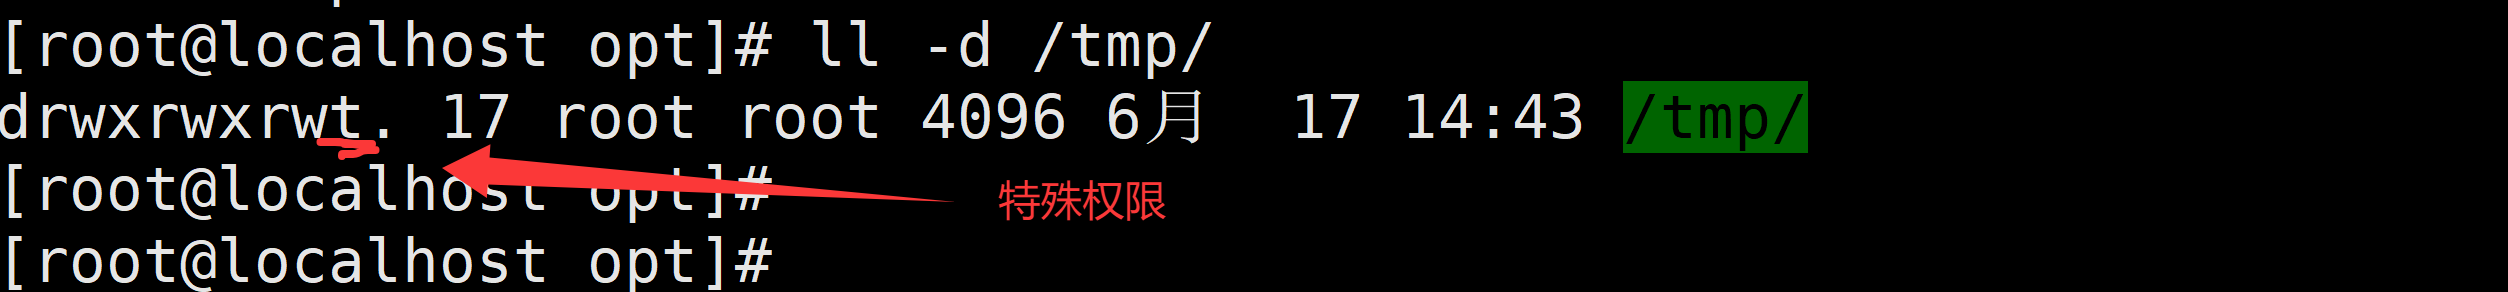
    -k    是否有t位
    file

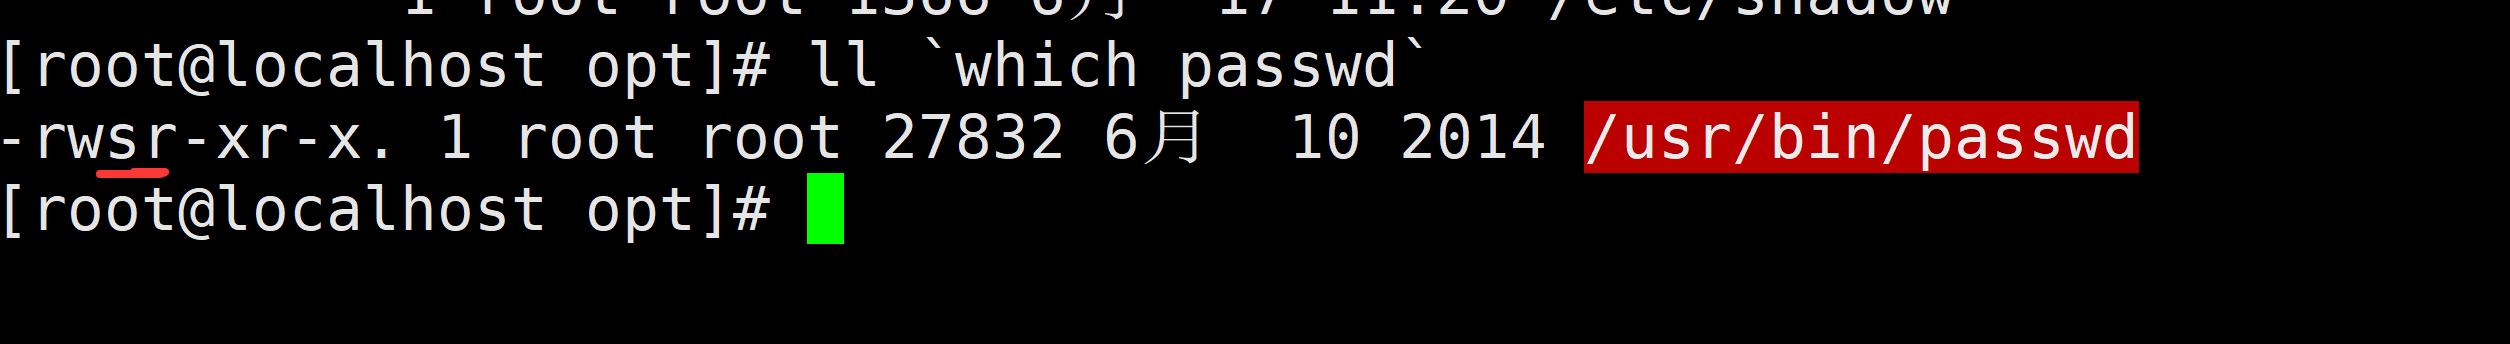
    特殊权限 - passwd命令

    file

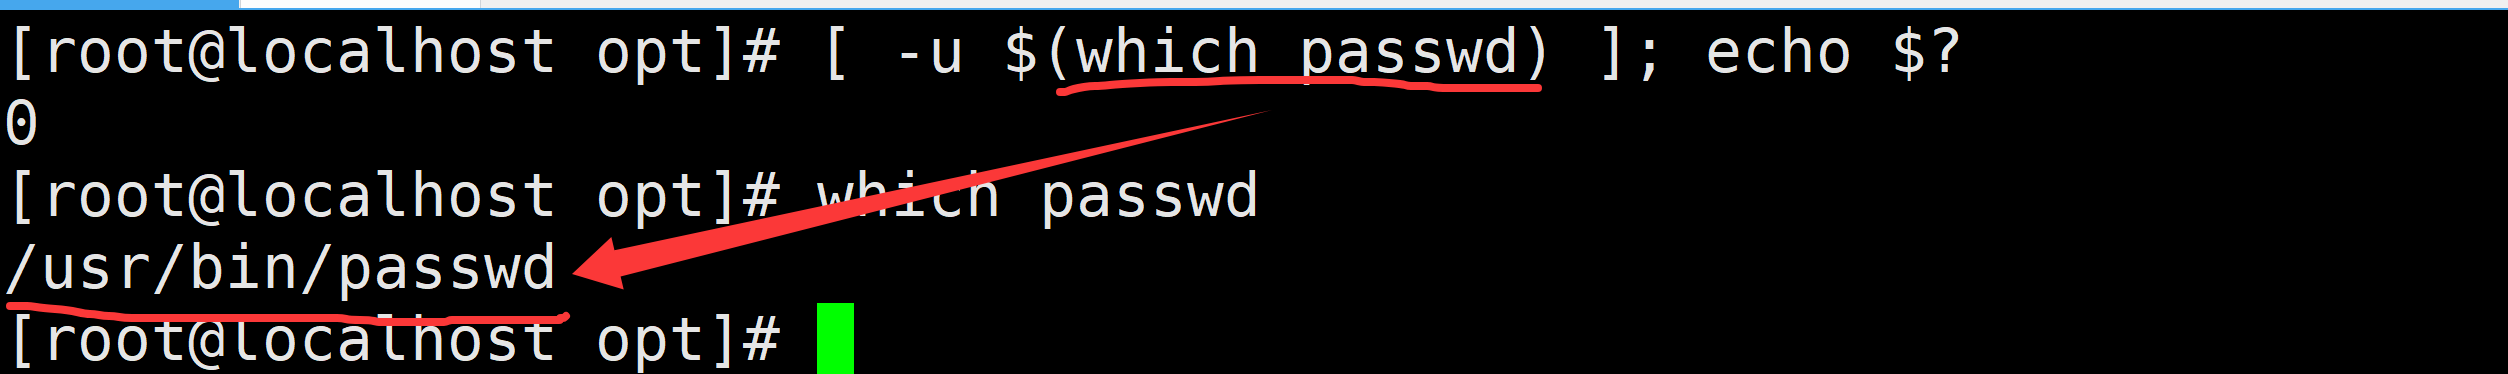
    判断执行passwd命令的文件是否有特殊权限s

    file

    which命令的作用

    file

    特殊的t权限

    file

    3)两个文件的比较判断
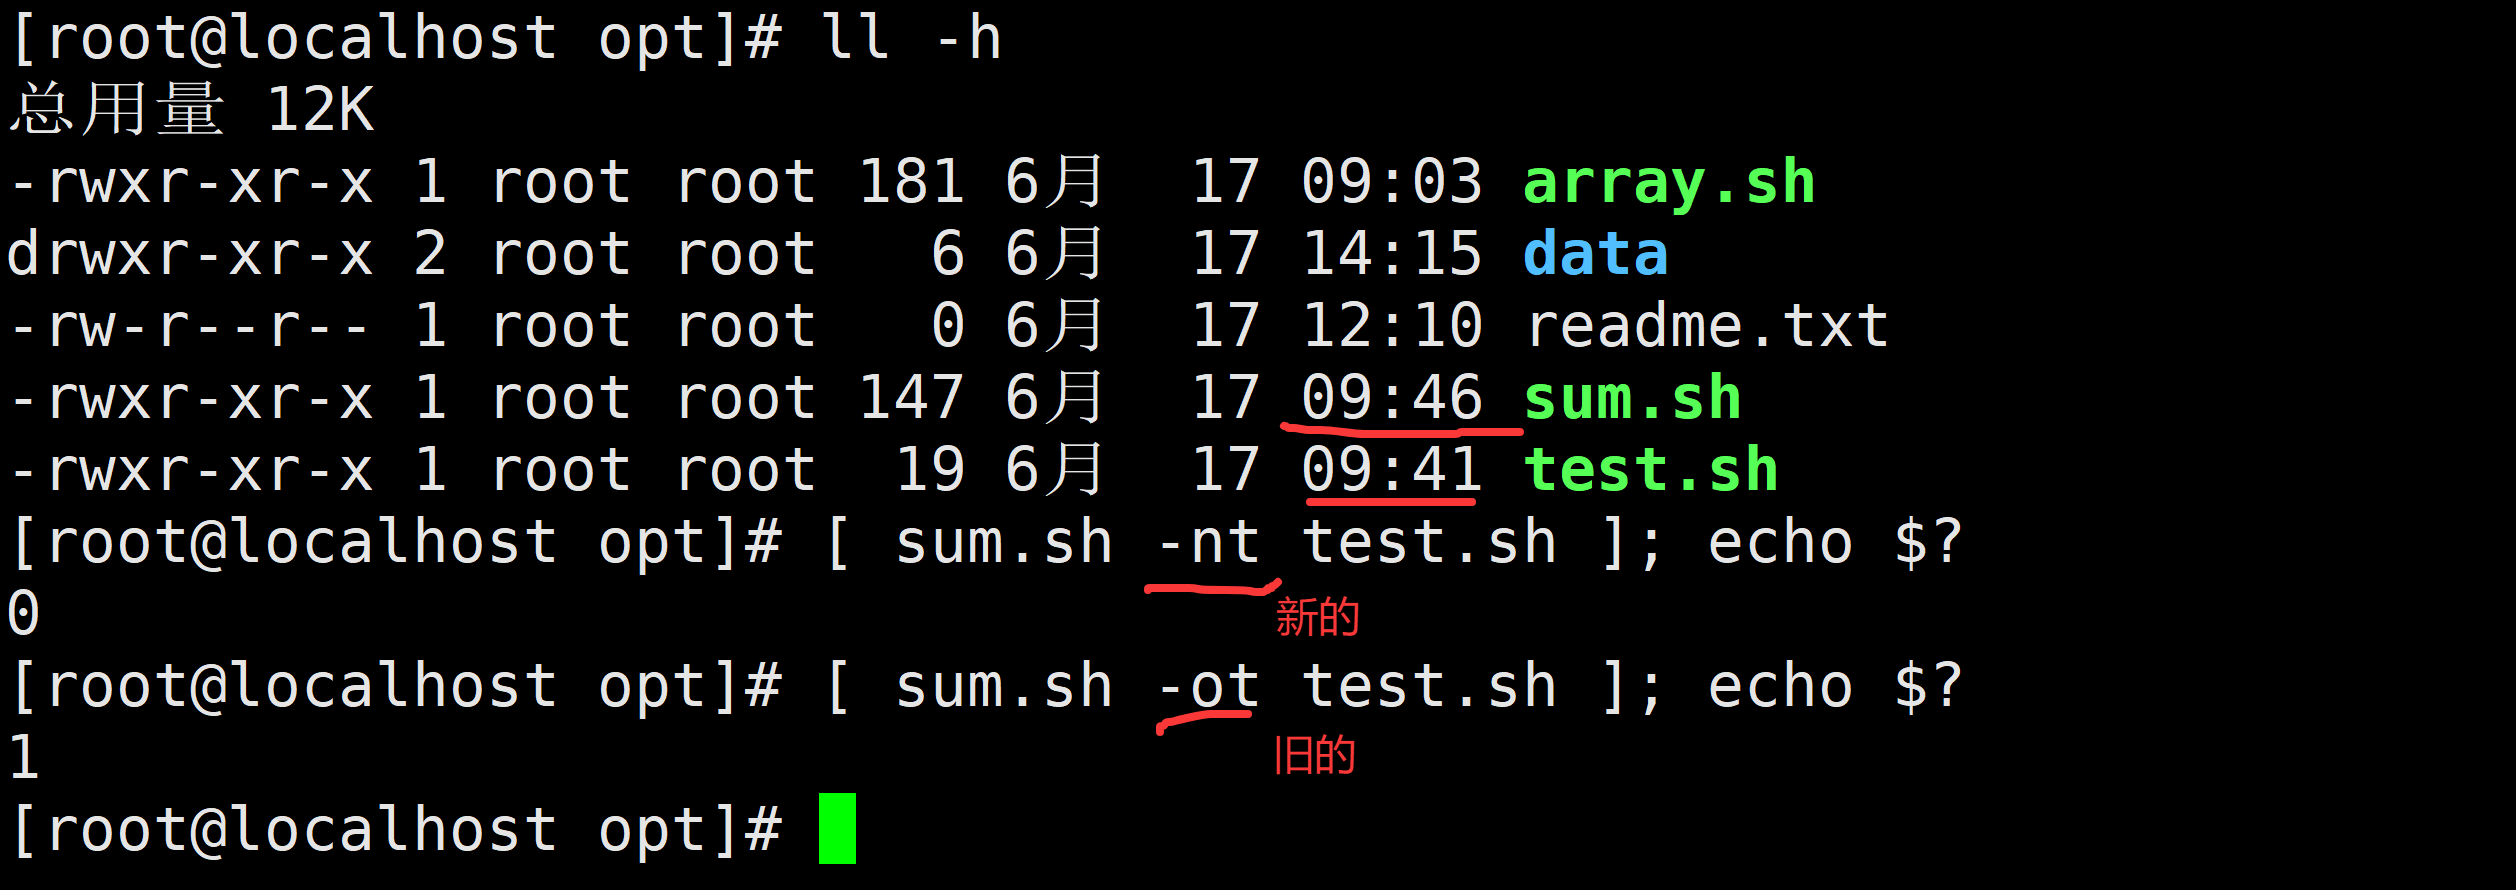
    两个文件的比较判断(-nt -ot -ef)
    file1 -nt  file2    比较file1是否比file2新(新旧主要判断修改的时间)    new
    file1 -ot  file2     比较file1是否比file2旧                        old
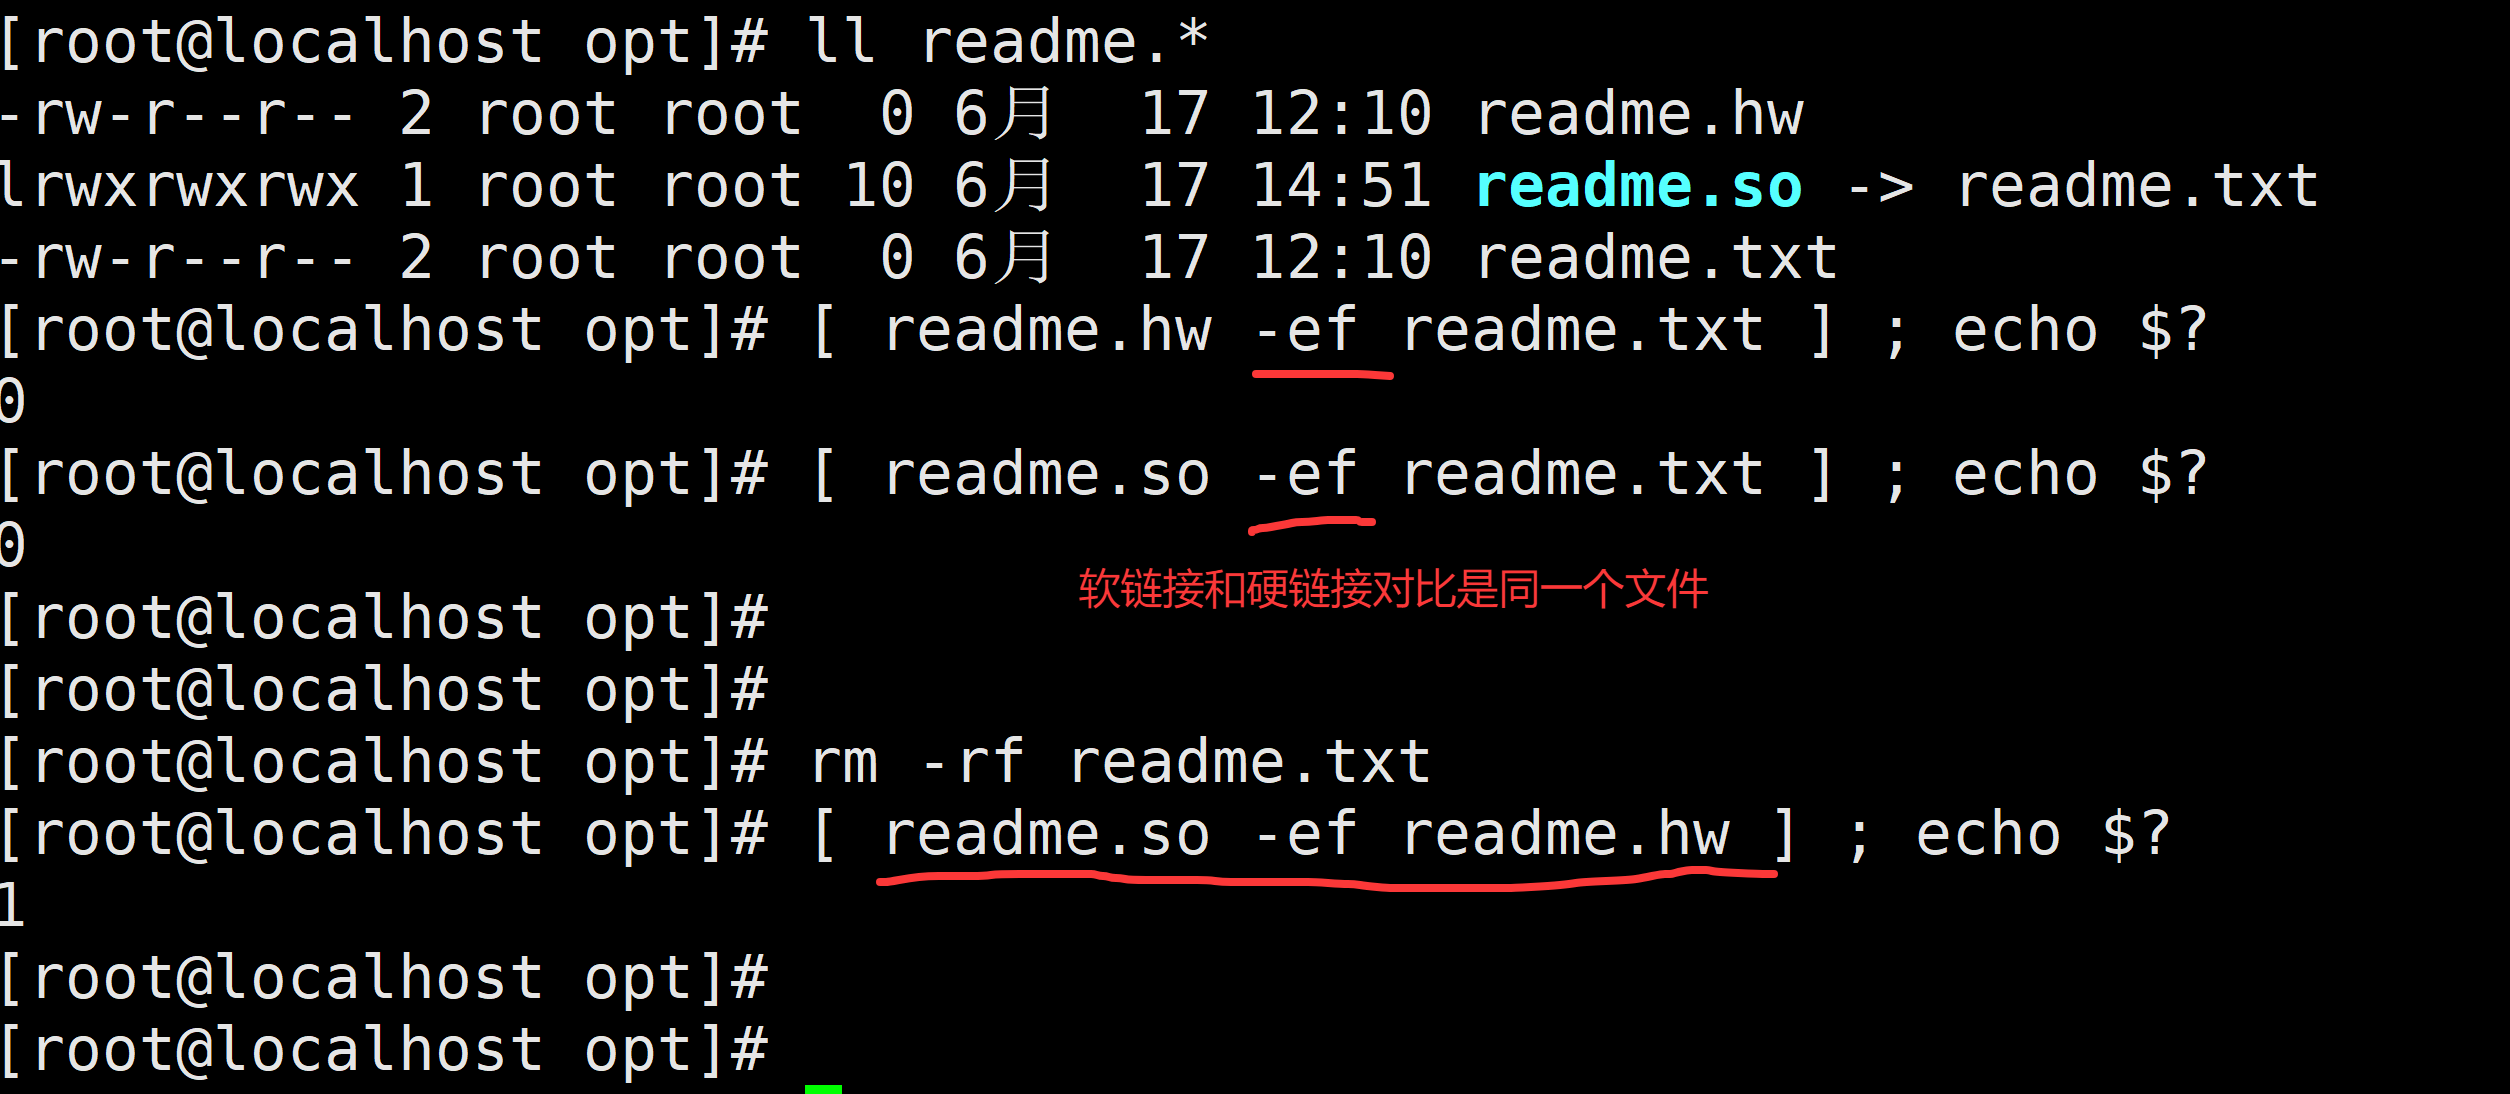
    file1 -ef  file2    比较是否为同一个文件                            equals
    -nt   :  new  than 。。。 
    -ot   :  old  than .....
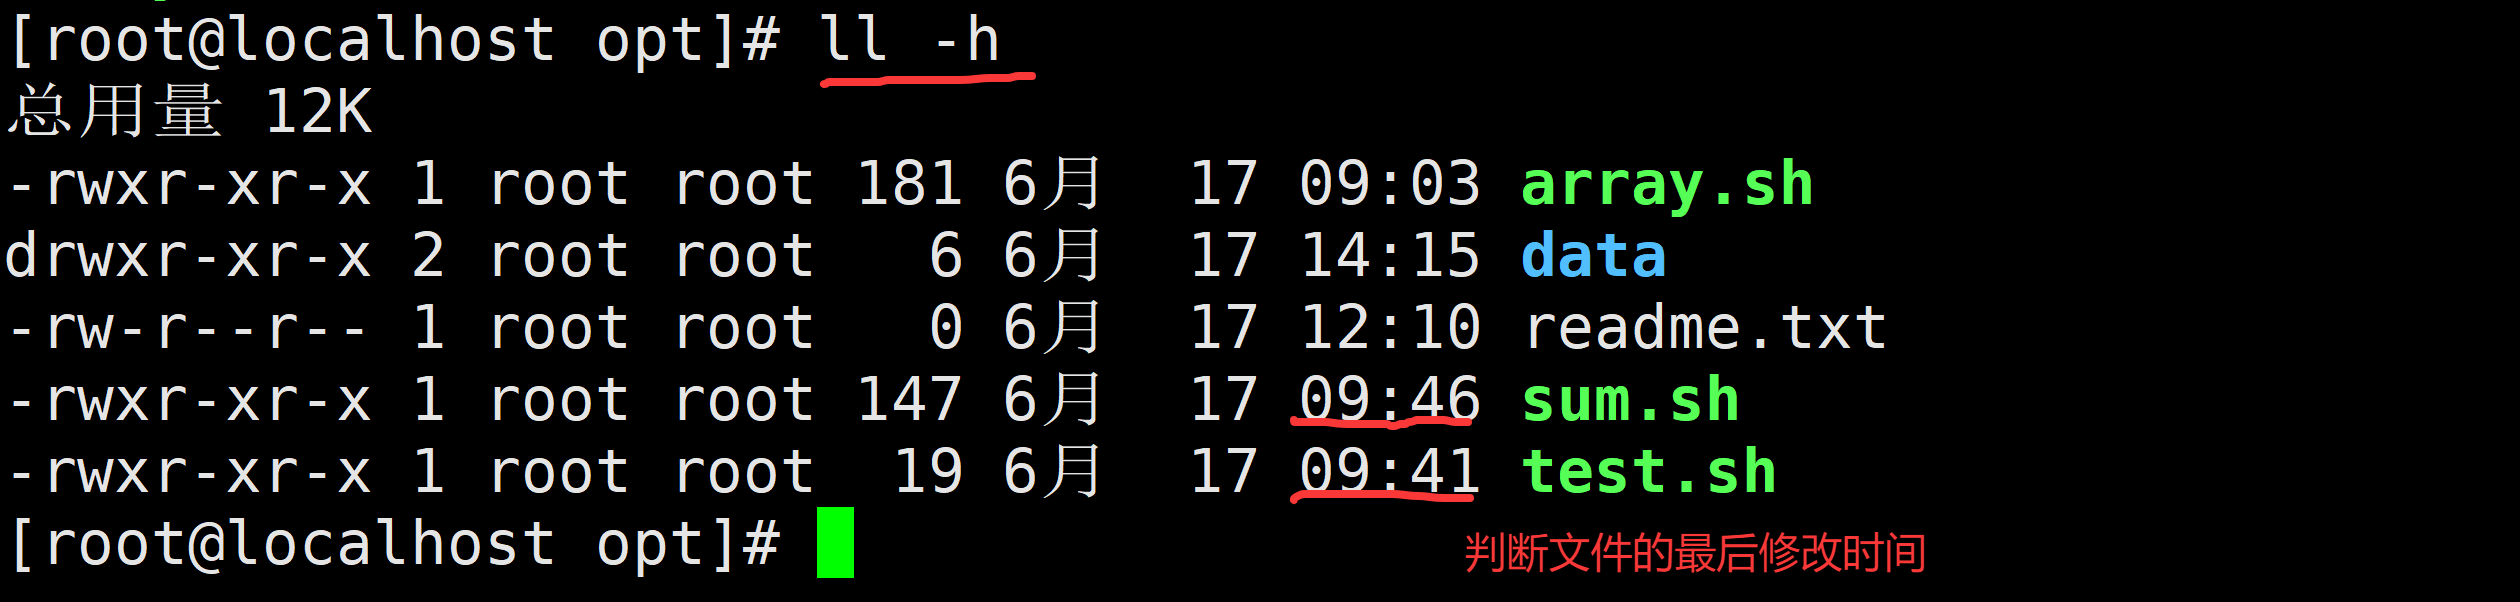
     Linux Shell 中,file1 -nt file2 是一个用于比较文件修改时间的测试表达式,通常在 if 语句或条件判断中使用。其中:
    -nt 是比较操作符,含义为 newer than(比... 更新)。
    file1 和 file2 是要比较的两个文件路径。

    查看文件的最后修改时间
    file

    新旧判断

    file

    软硬链接

    file

    需求:判断abc.txt是否比test.sh文件新

    [ abc.txt -nt test.sh ];echo $?

    需求:判断abc.txt是否比test.sh文件旧

    [ abc.txt -ot test.sh ];echo $?

    需求:给abc.txt文件创建一个硬链接a1,判断abc.txt与a1是否为同一个文件

    ln abc.txt a1
    [ abc.txt -ef a1 ];echo $?

    需求:给abc.txt文件创建一个软链接a2,判断abc.txt与a2是否为同一个文件

    ln -s abc.txt a2
    [ abc.txt -ef a2 ];echo $?
    
    需求:判断`abc.txt`是否比`test.sh`文件新
    需求:判断`abc.txt`是否比`test.sh`文件旧
    需求:给`abc.txt`文件创建一个硬链接`a1`,判断`abc.txt`与`a1`是否为同一个文件
    需求:给`abc.txt`文件创建一个软链接`a2`,判断`abc.txt`与`a2`是否为同一个文件
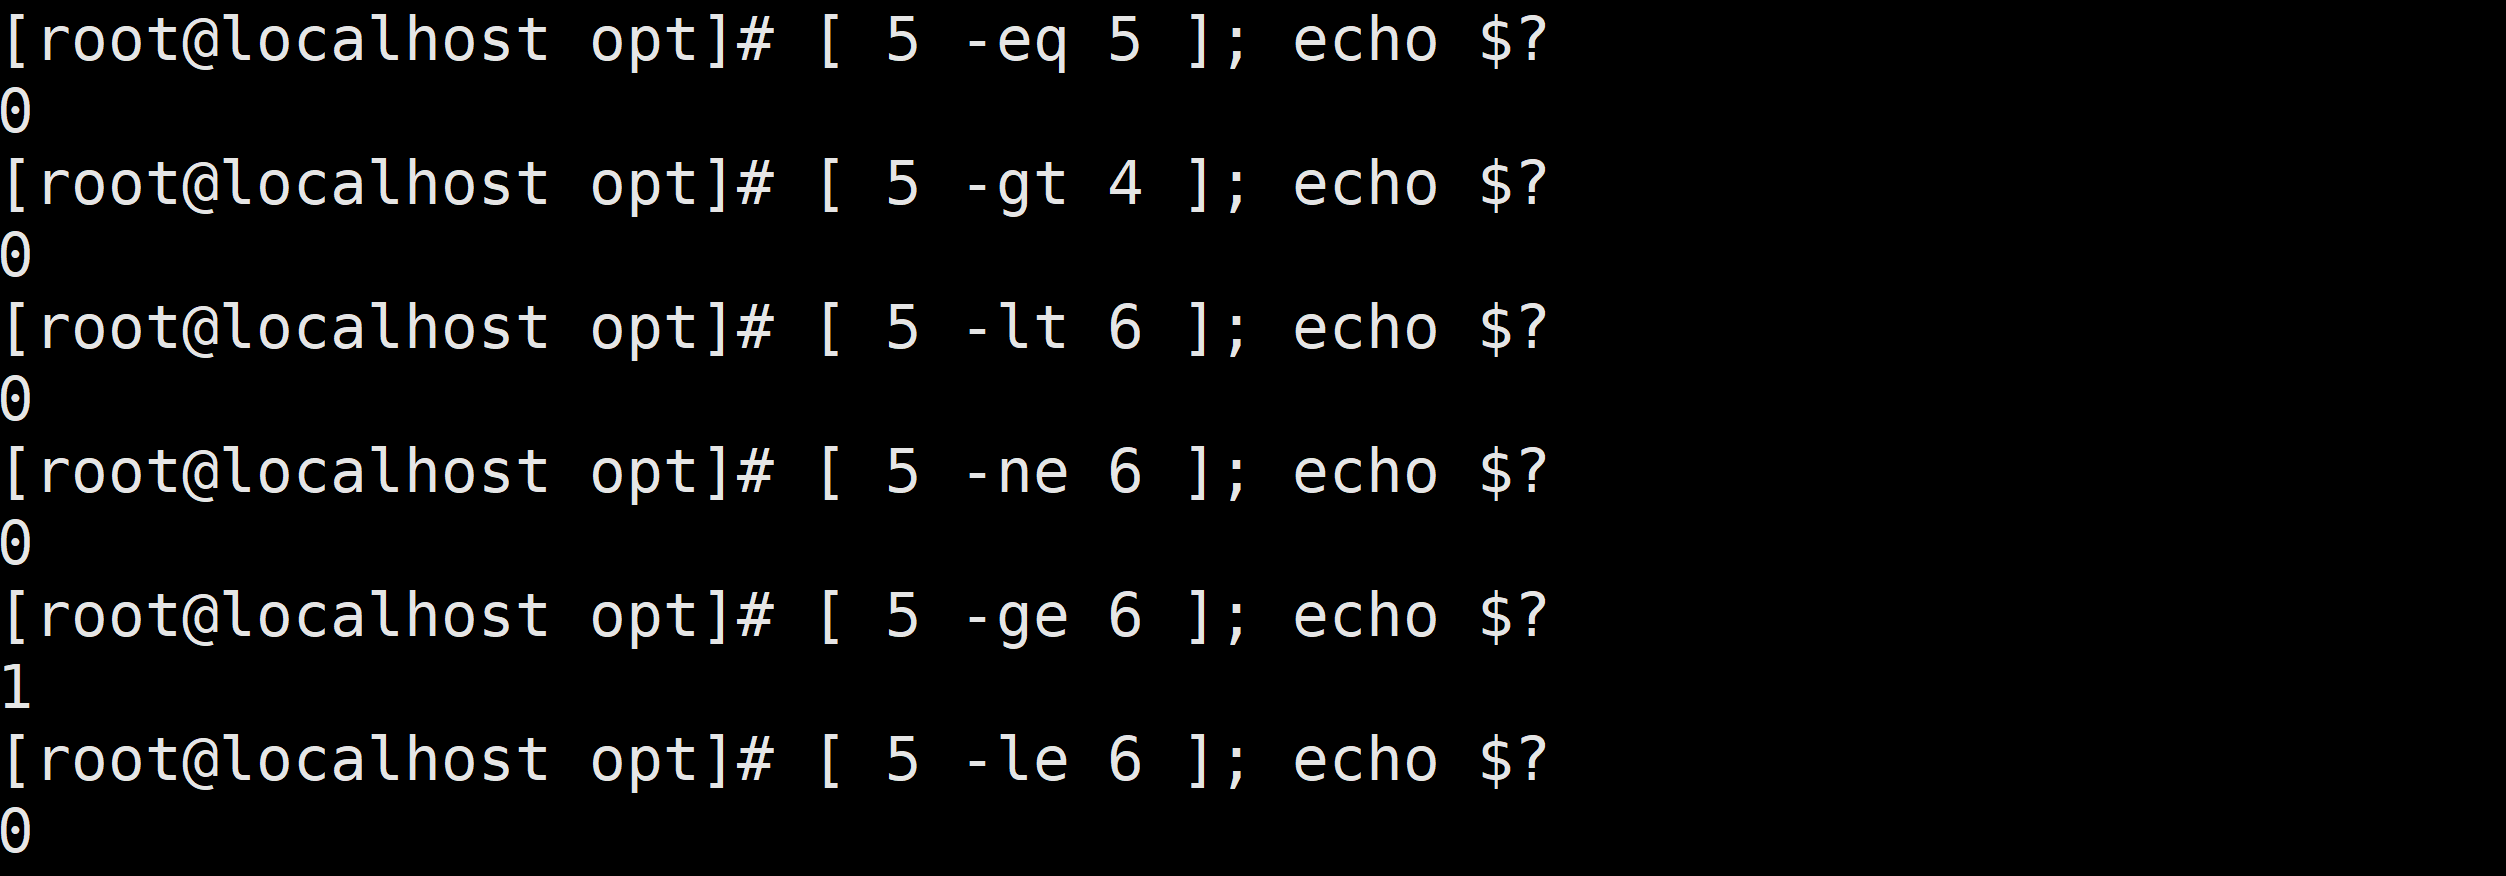
    4)整数判断(大于等于小于)

    整数判断(需要记忆)

    -eq     相等        equals              =
    -ne     不等        not equals            != 
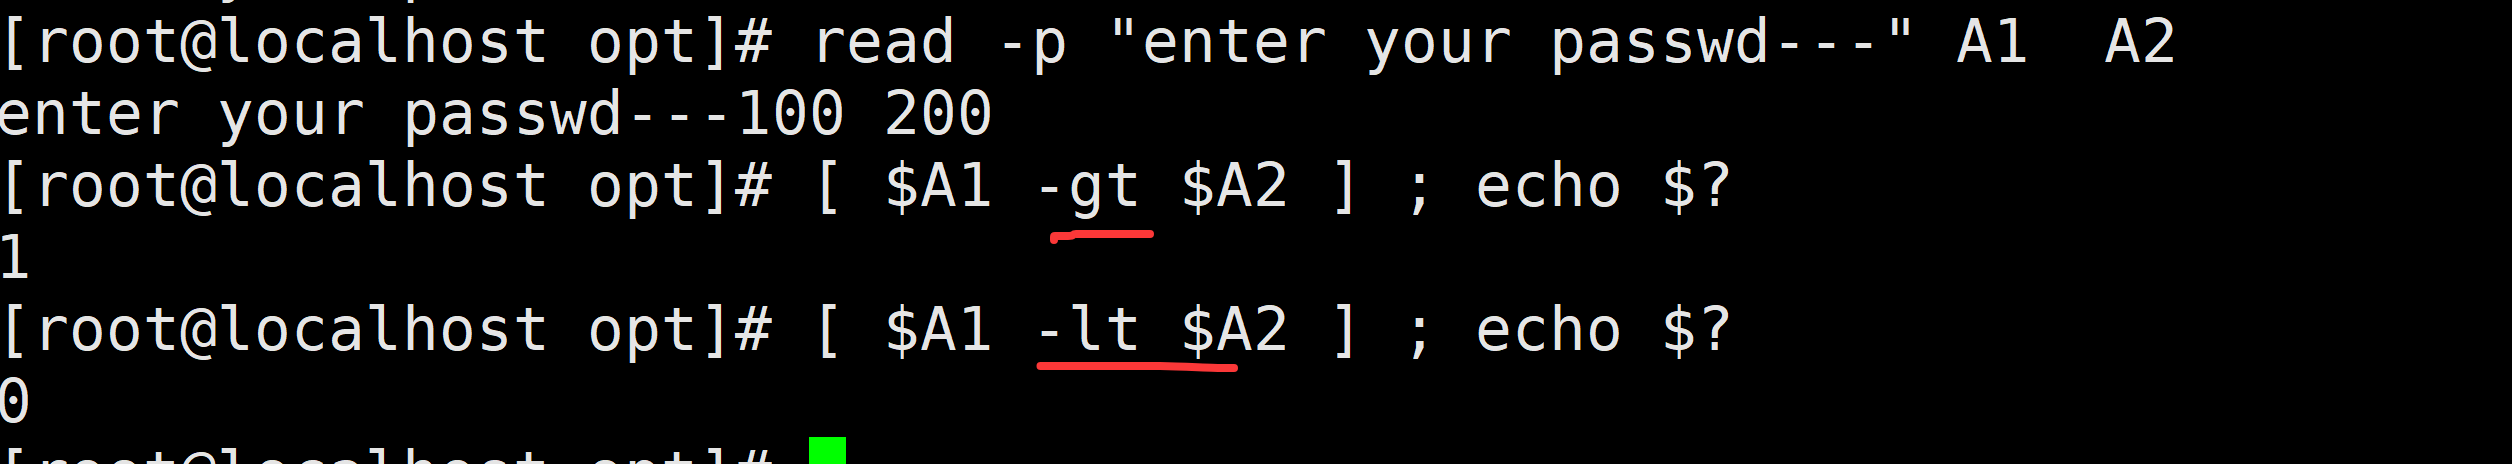
    -gt     大于        greater than        >       
    -lt     小于        less than            <
    -ge  大于等于    greater equals        >=
    -le     小于等于   less equals            <= 

    早期的 Shell(如 Bourne Shell)为避免与重定向符号(>、<)冲突,设计了 -gt、-lt 等符号:

    为了保持语法一致性:在 [ ... ] 测试命令中,所有操作符统一使用 -xxx 格式

    避免歧义:Shell 需要明确区分数值比较和字符串比较
    file

    需求:判断5与4是否相等

    [ 5 -eq 4 ];echo $?

    需求:判断5是否大于4

    [ 5 -gt 4 ];echo $?

    需求:判断5是否小于4

    [ 5 -lt 4 ];echo $?

    需求:判断1是否不等于0

    [ ! 1 -eq 0 ];echo $?
    需求:判断5与4是否相等
    需求:判断5是否大于4
    需求:判断5是否小于4
    需求:判断1是否不等于0
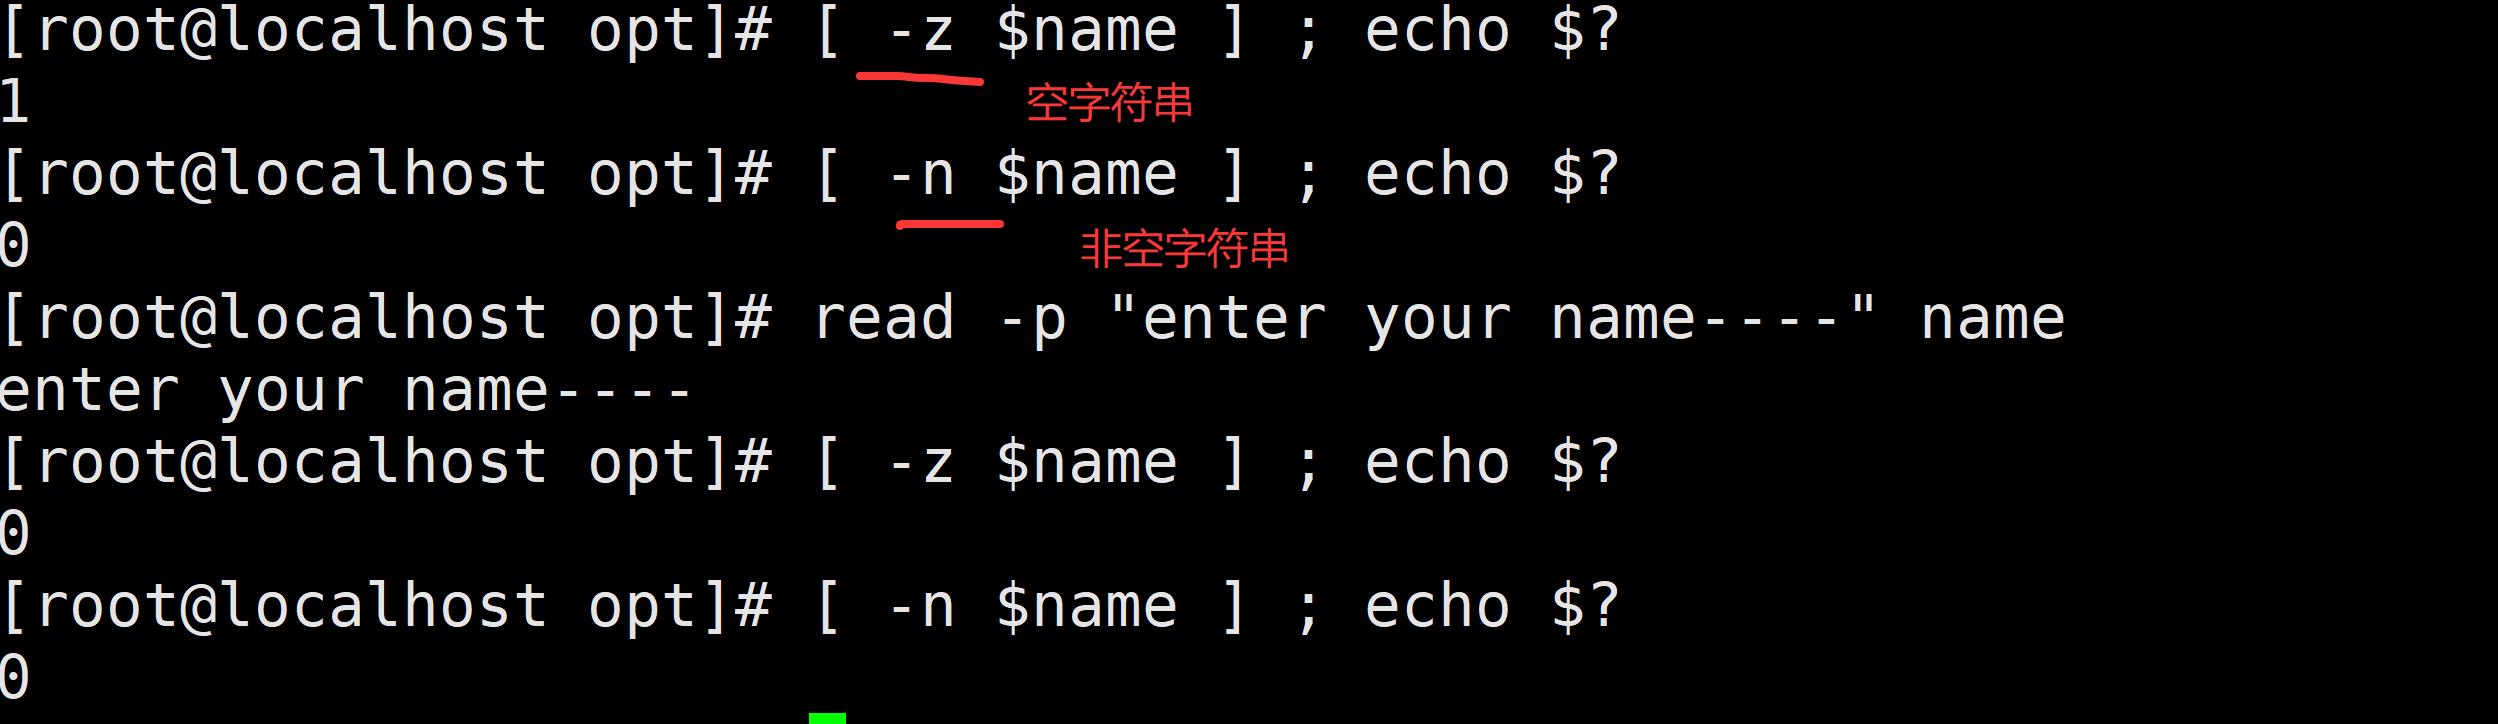
    5)字符串之间的判断
    -z  是否为空字符串           字符串长度为0,就成立
    -n  是否为非空字符串       只要字符串非空,就是成立(如果字符串为空,则必须使用""包起来)
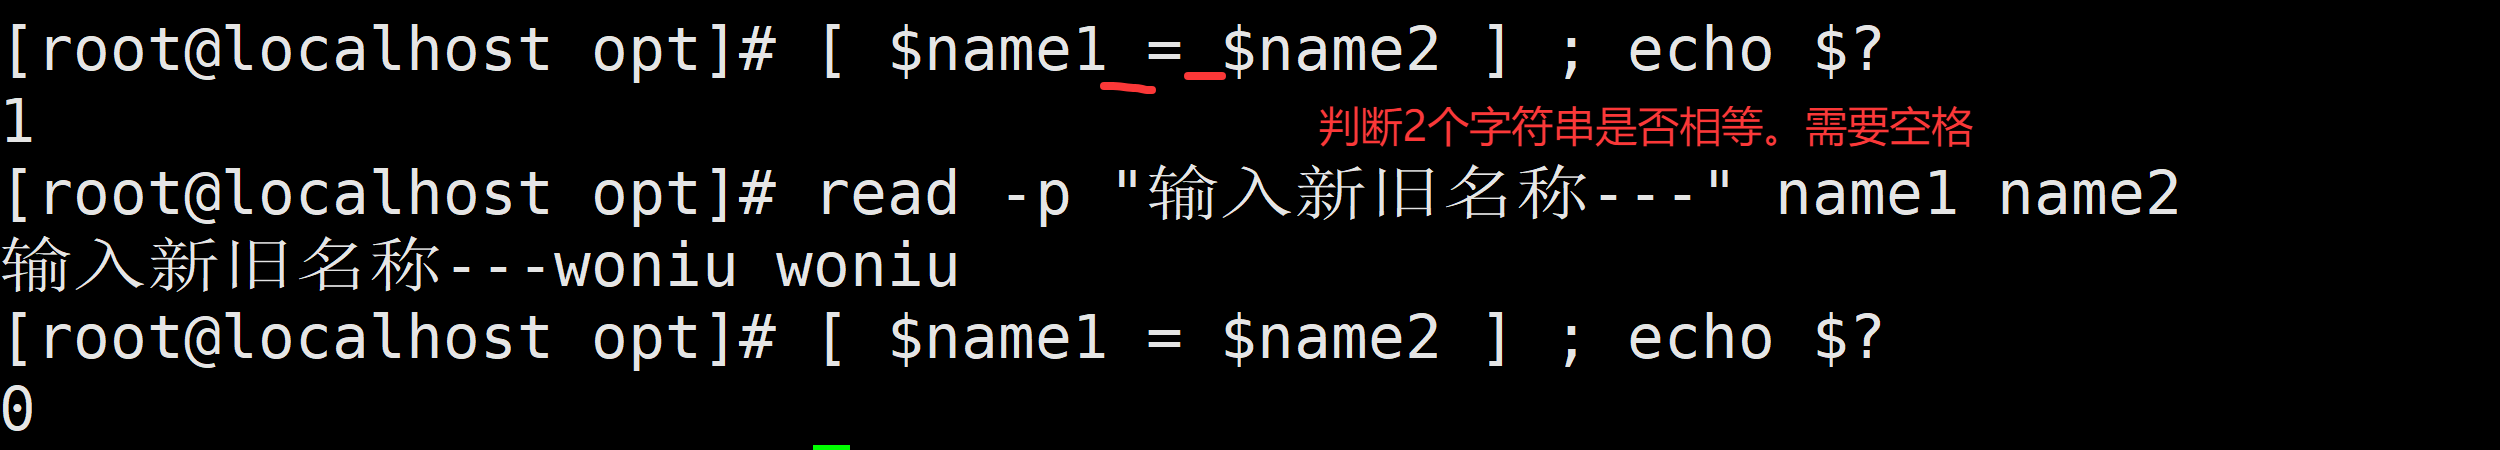
    string1 = string2         是否相等
    string1 != string2         不等
    file

    判断字符串是否相等

    file

    前提:定义两个变量AAA=hello与BBB=world

    需求:判断变量AAA是否为空字符串

    [ -z AAA ];echo $?

    需求:判断BBB是否为非空字符串

    [ -n AAA ];echo $?
    [ ! -z AAA ];echo $?

    需求:判断AAA与BBB字符是否相等

    [ AAA = BBB ];echo $?

    需求:判断AAA与BBB字符是否不相等

    [ AAA != BBB ];echo $?
    [ ! AAA = BBB ];echo $?
    前提:定义两个变量`AAA=hello`与`BBB=world`
    需求:判断变量AAA是否为空字符串
    需求:判断BBB是否为非空字符串
    需求:判断AAA与BBB字符是否相等
    需求:判断AAA与BBB字符是否不相等

    课堂案例

    需求1:定义一个变量name1=zhangsan,使用交互式方式给变量name2赋值,判断name1是否等于name2
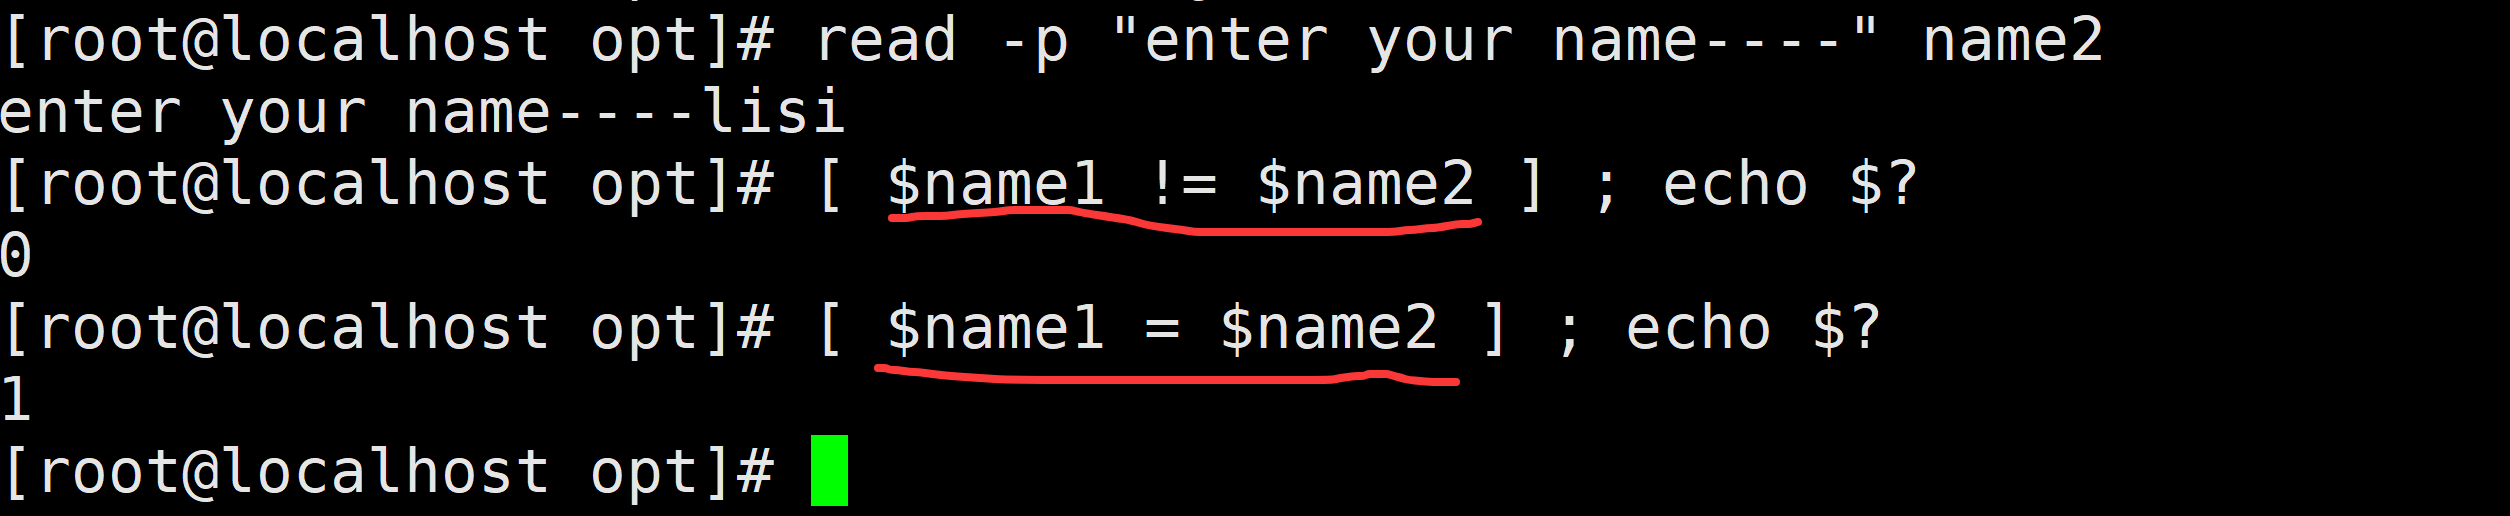
    file

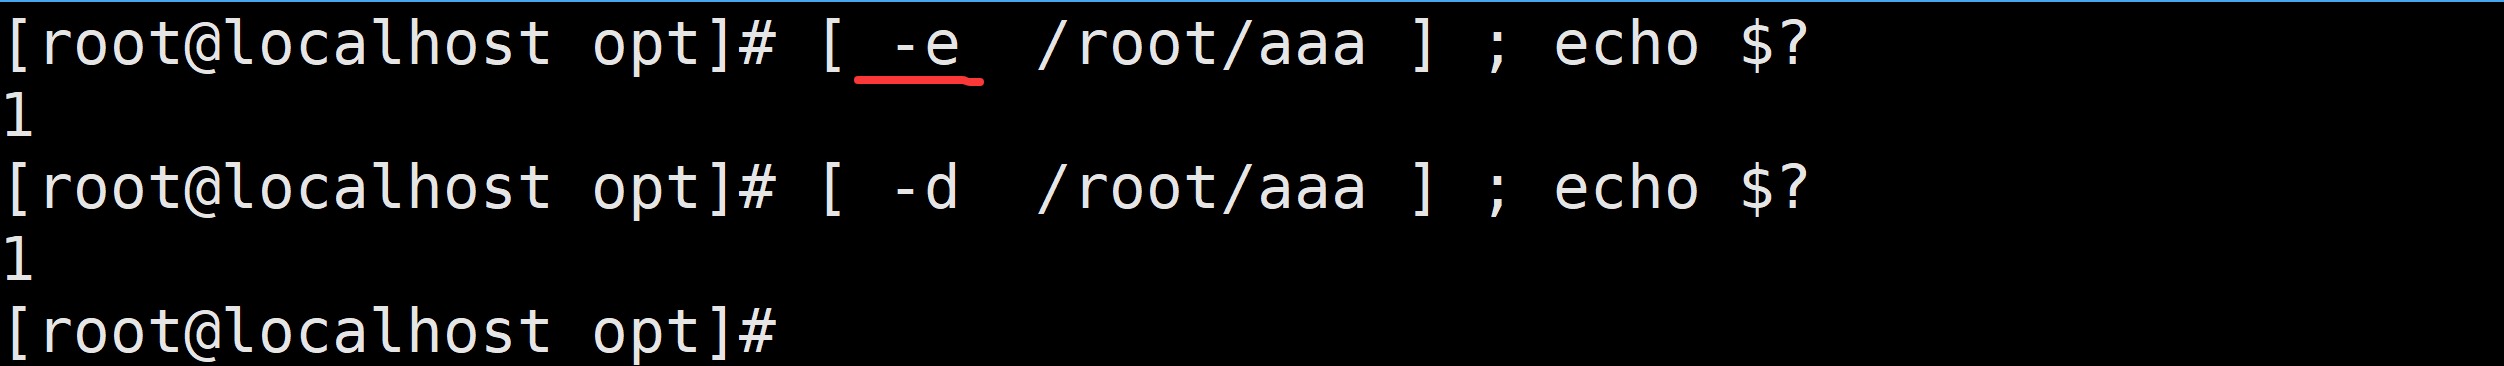
    需求2:判断root账号的家目录中是否存在aaa目录

    file

    需求3:使用交互方式给变量A1与A2赋值,判断A1是否大于A2`

    file

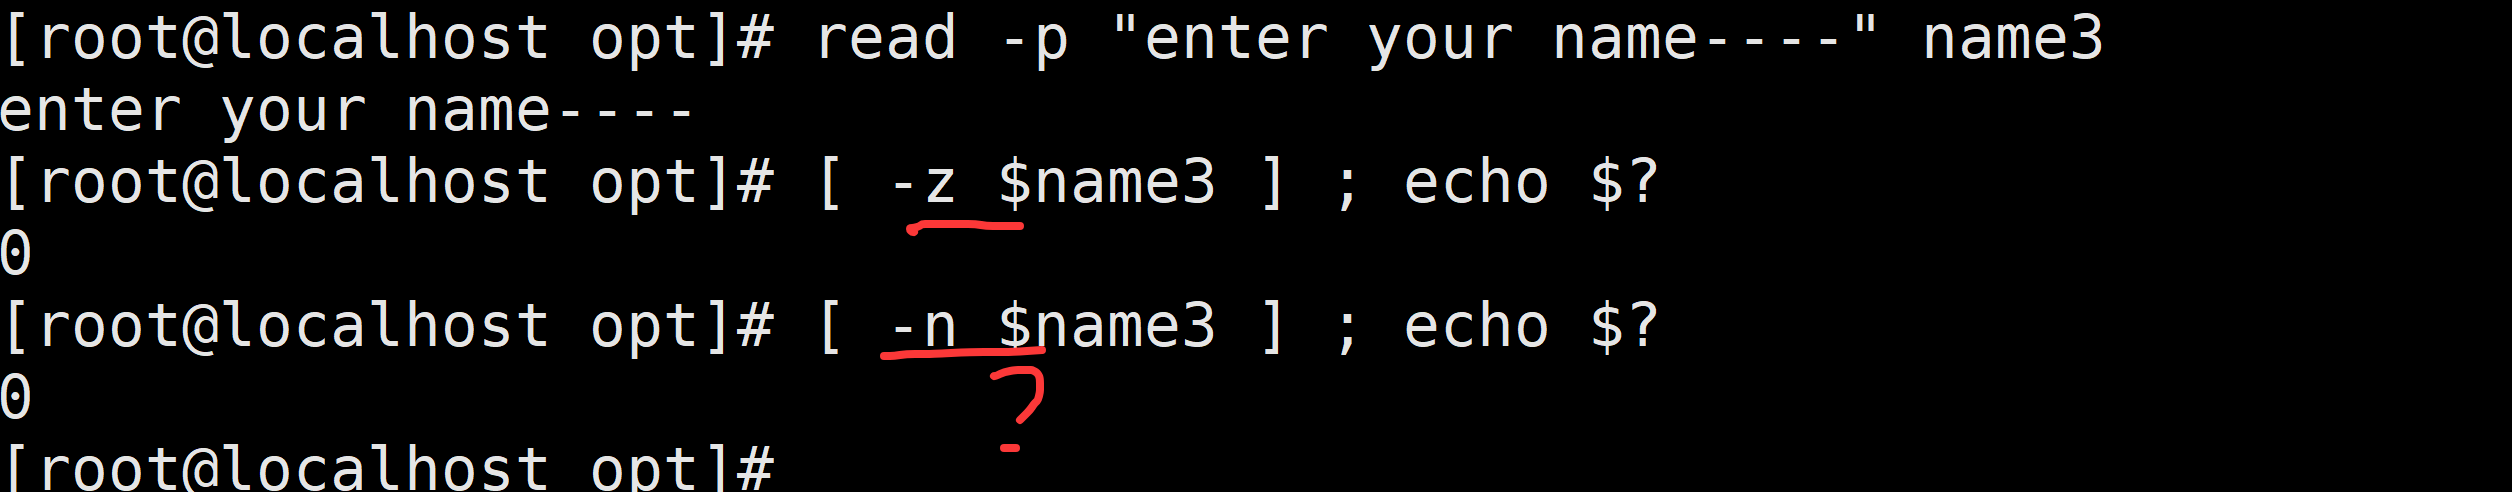
    需求4:使用交互式方式给变量name3赋值,判断name3是否有内容

    file

    需求5:判断root账号的家目录中是否存在readme.txt文件,如果不存在,则创建该文件
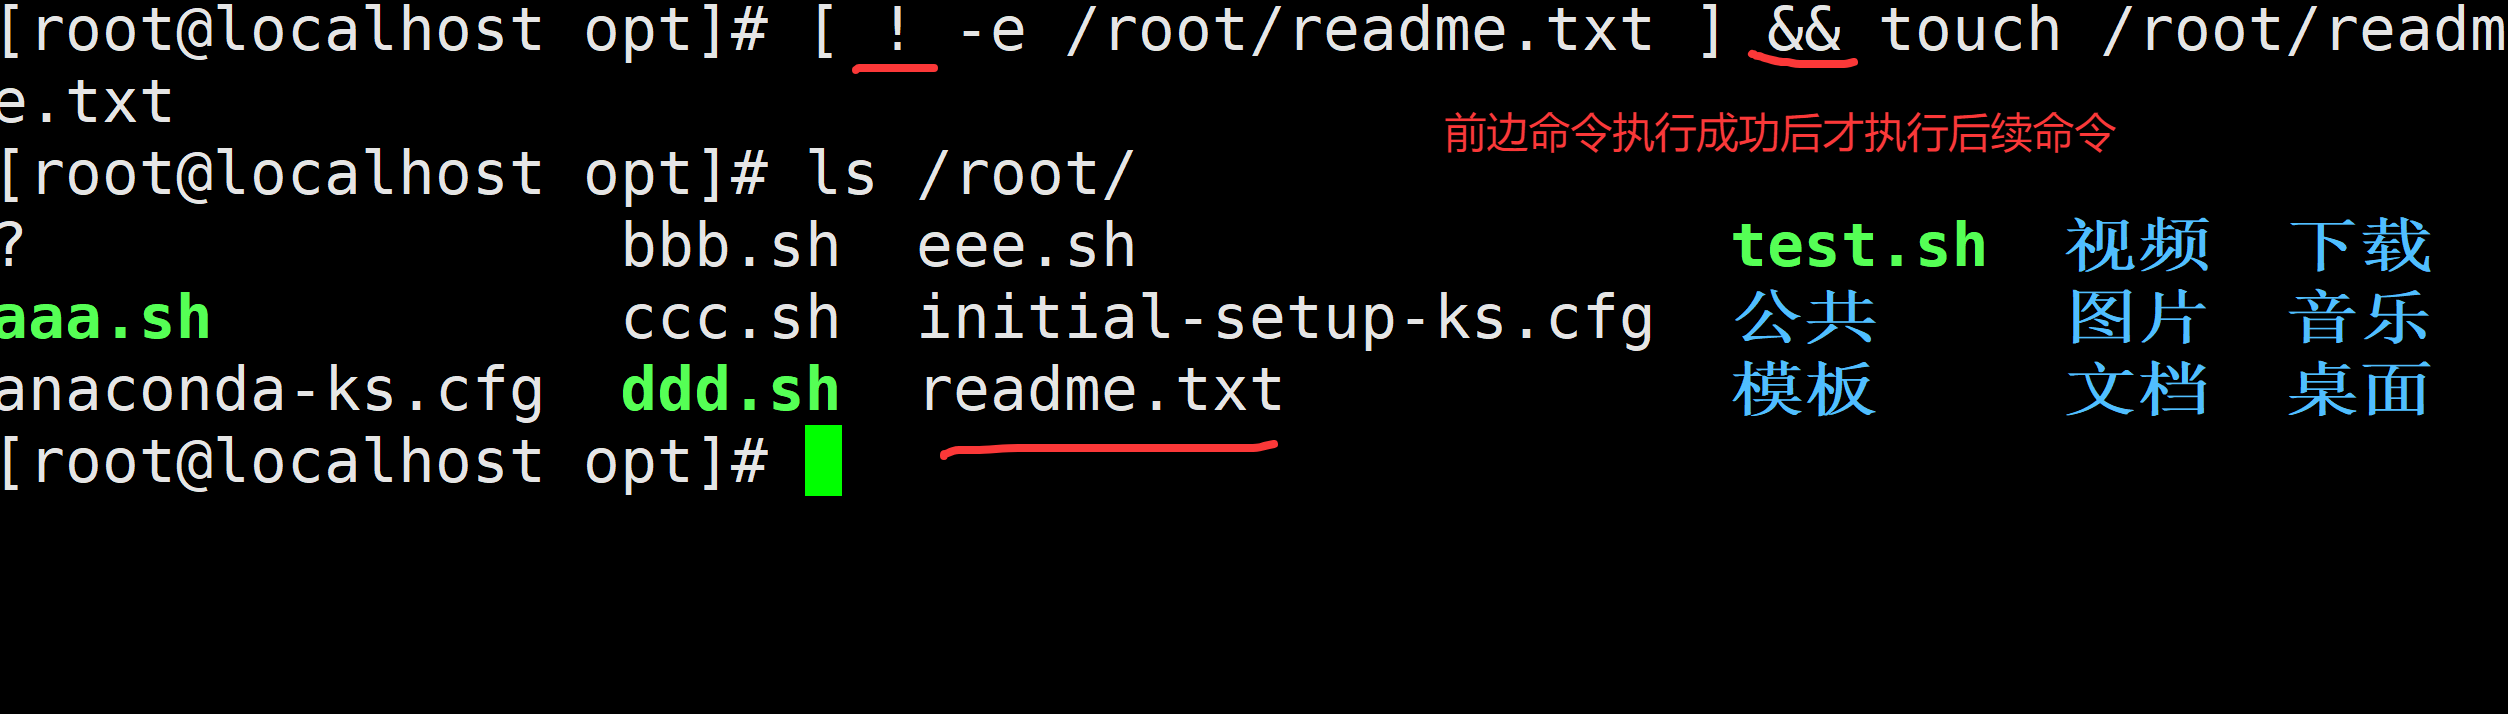
    file

    6.逻辑表达式(&& || )

    6.1 概述

    在上一章中,我们都是单个条件的判断,如果有多个条件的判断,我们就得分开几个步骤执行,而且上一个步骤的结果或影响下一个步骤

    那么,如果存在多个条件,那么条件与条件之间的关系是如何呢?

    生活举例:

    在深圳买车要上牌的话,需要摇号,那么摇号就会存在一些条件

    • 购买社保需要满2年
    • 需要有驾驶证

    请问,这两个条件是必须同时满足还是只要满足一个就可以了?

    6.2 语法

    符号 作用 说明
    -a && 逻辑与(and) 两个条件同时满足,整个大条件为真
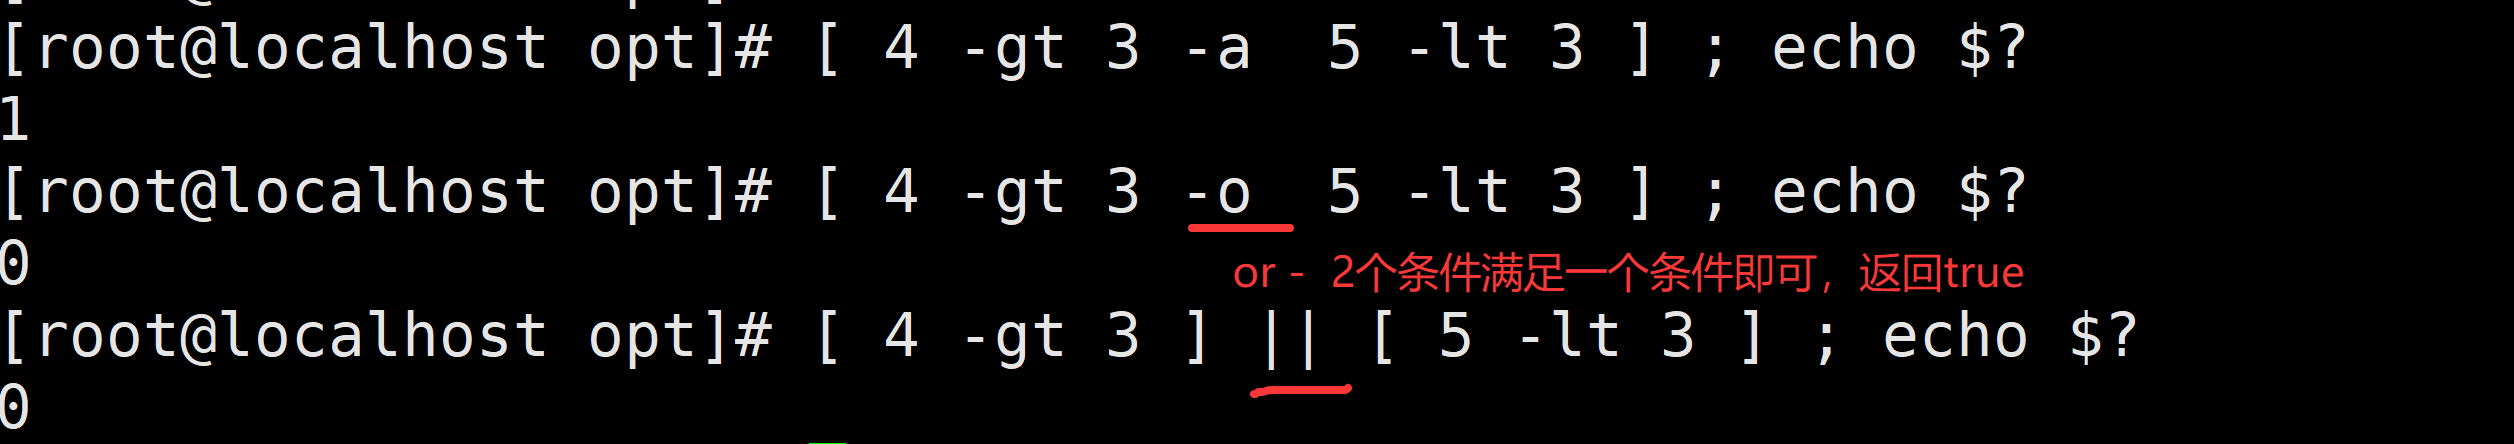
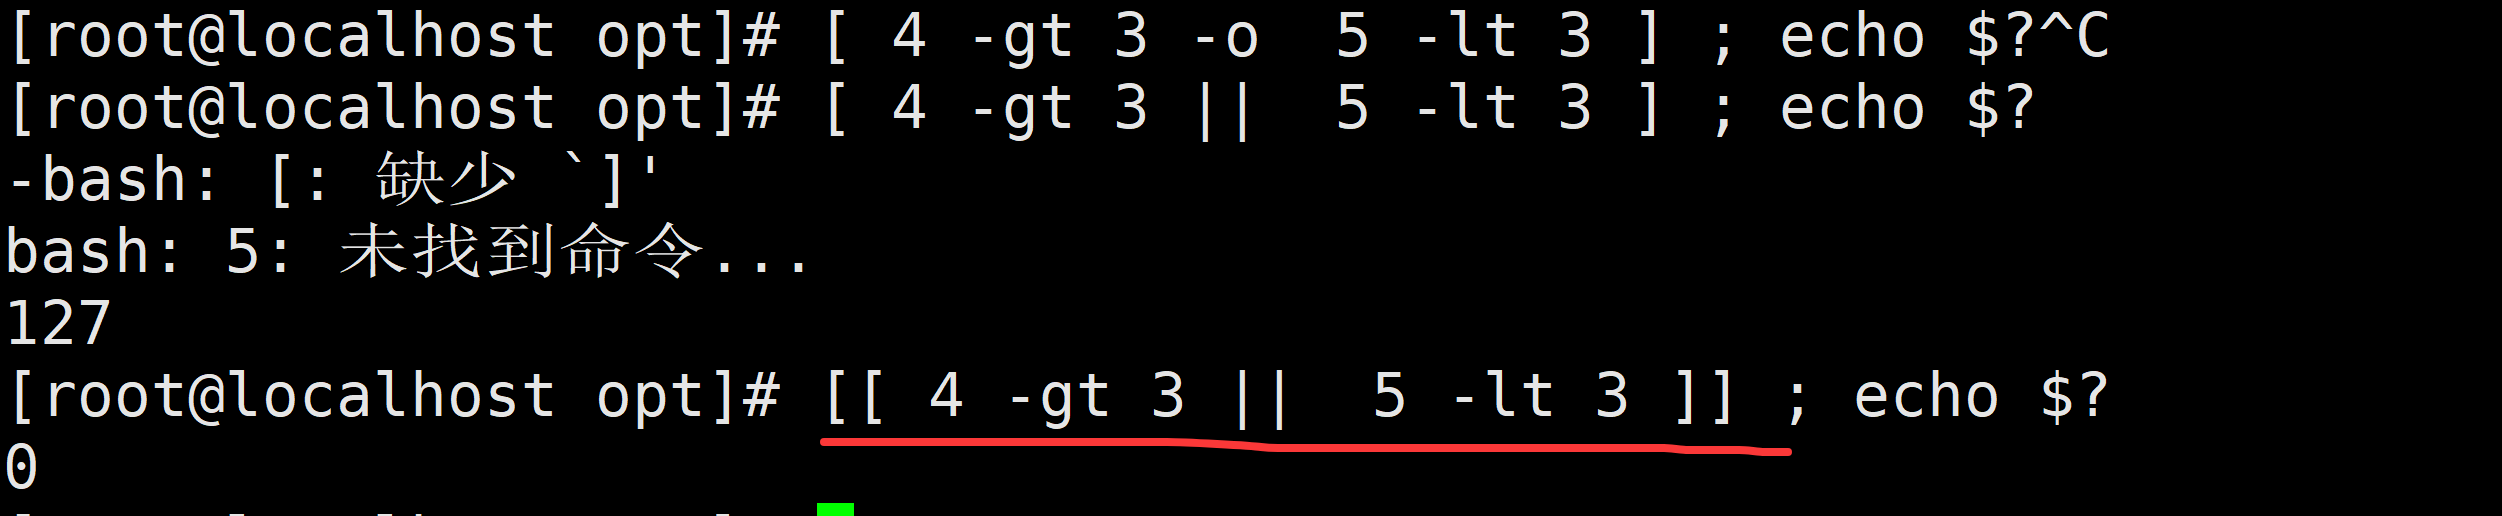
    -o \ \ 逻辑或(or) 两个条件满足任意一个,整个大条件为真

    在逻辑与运算中,只要有一个表达式的值为false,那么结果就可以判定为false了,没有必要将所有表达式的值都计算出来。同理在逻辑或运算中,一旦发现值为true,右边的表达式将不再参与运算。

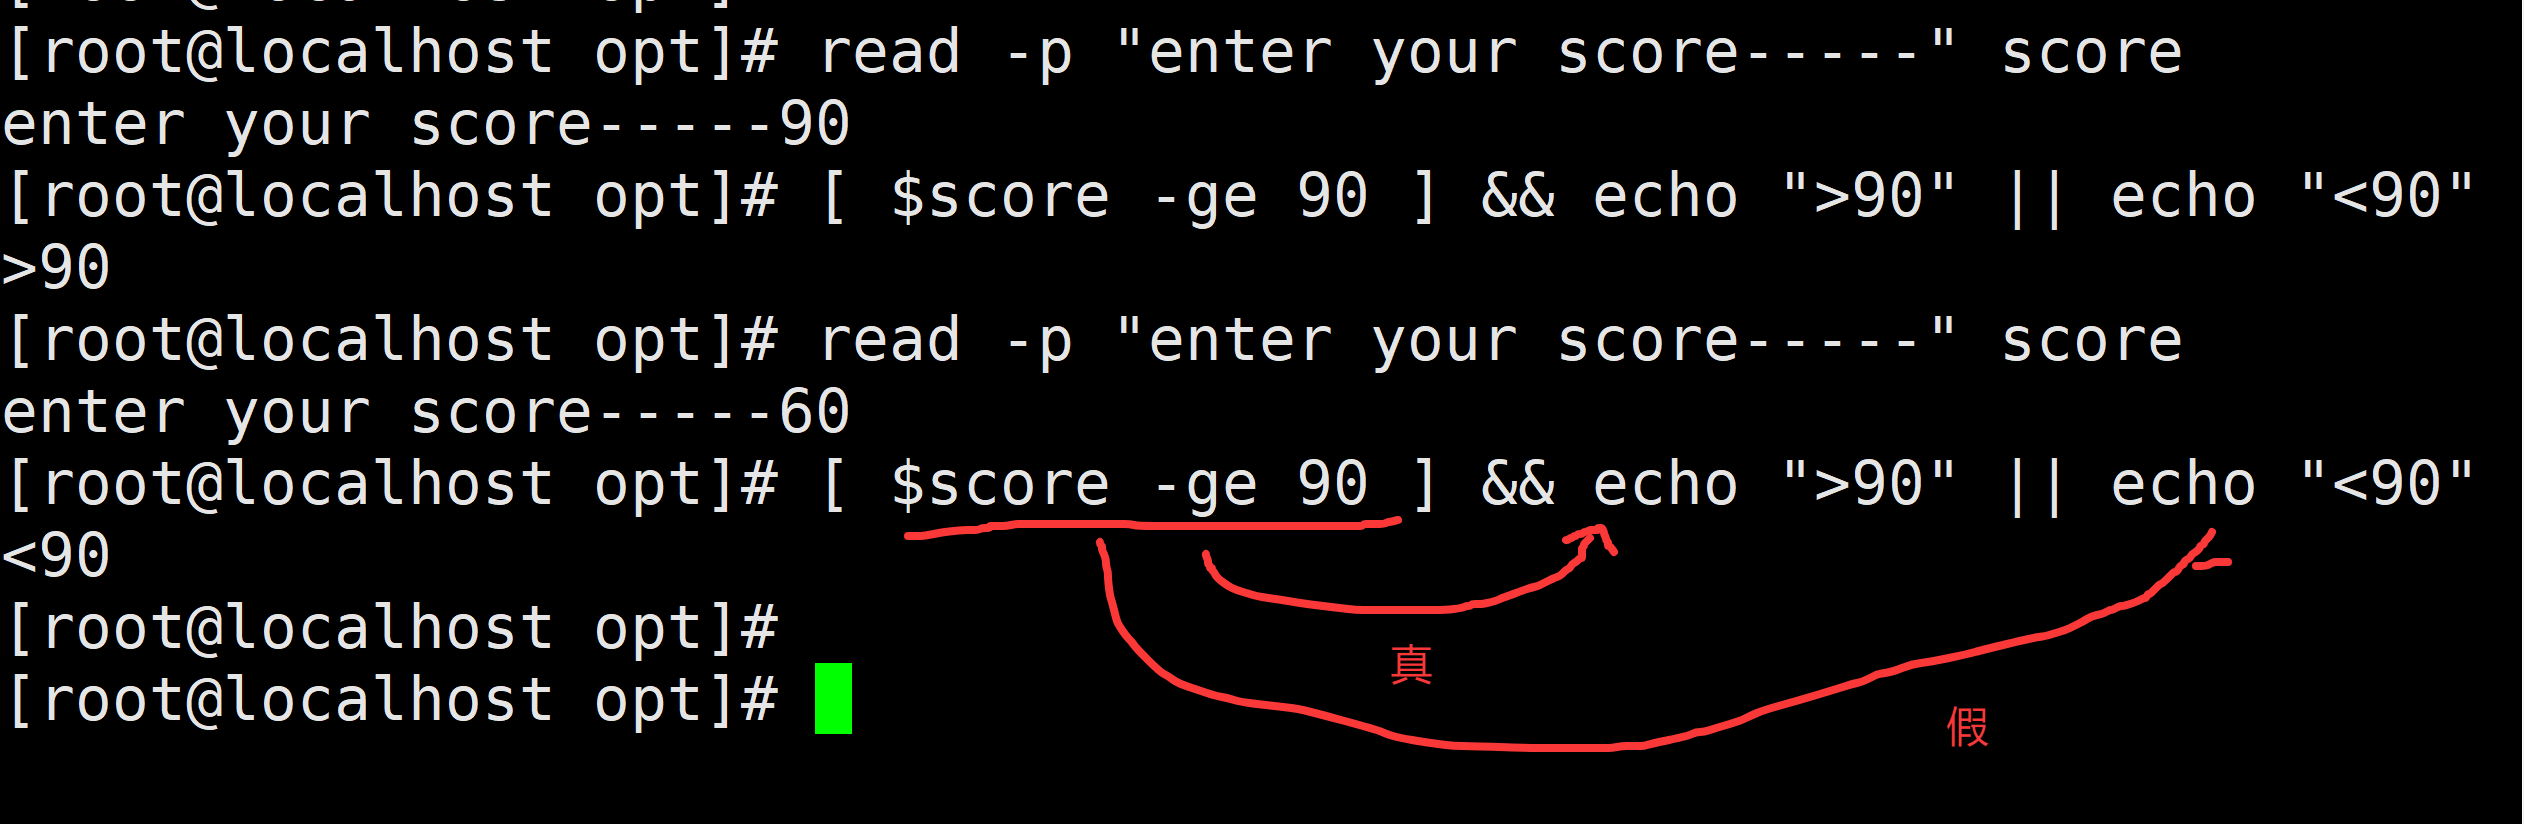
    • 逻辑与:如果左边为真,右边执行;如果左边为假,右边不执行。
    • 逻辑或:如果左边为假,右边执行;如果左边为真,右边不执行。

    示例:

    [ 1 -eq 1 -a 1 -ne 0 ]                        # 前面为真,后面也为真,整个运算结果为真
    [ 1 -eq 1 ] && [ 1 -ne 0 ]                    # 相较上面的另外一种写法
    [ 1 -eq 1 -o 1 -ne 1 ]       # 前面为真,整个运算结果为真(如果前面为真,与后面的表达式就没有关系了)
    [ 1 -eq 1 ] || [ 1 -ne 1 ]                    # 相较上面的另外一种写法

    与操作 - - - 2种表示方法:
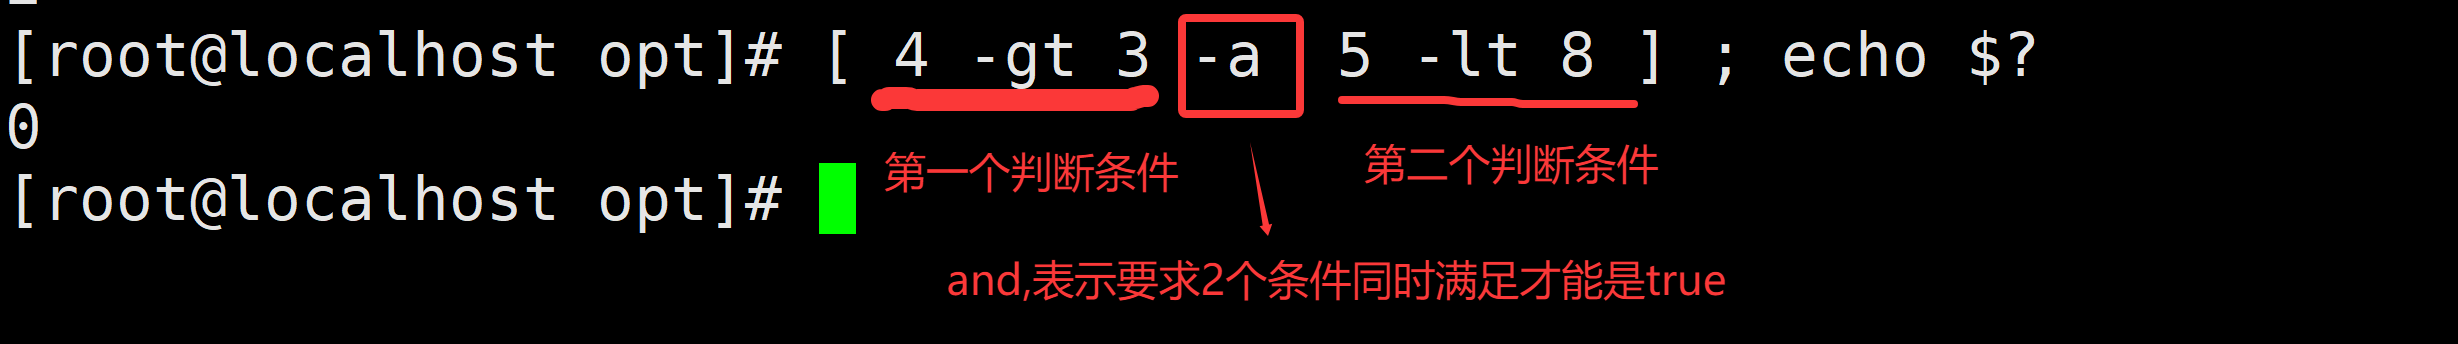
    file

    file

    或操作2种表示方法:

    file

    6.3 小结

    1、; && ||都可以用来分割命令或者表达式
    2、; 完全不考虑前面的语句是否正确执行,都会执行;号后面的内容
    3、&& 需要考虑&&前面的语句的正确性,前面语句正确执行才会执行&&后的内容;反之亦然(./configure && make && make install)
    4、|| 需要考虑||前面的语句的非正确性,前面语句执行错误才会执行||后的内容;反之亦然
    5、如果&&和||一起出现,从左往右依次看,按照以上原则
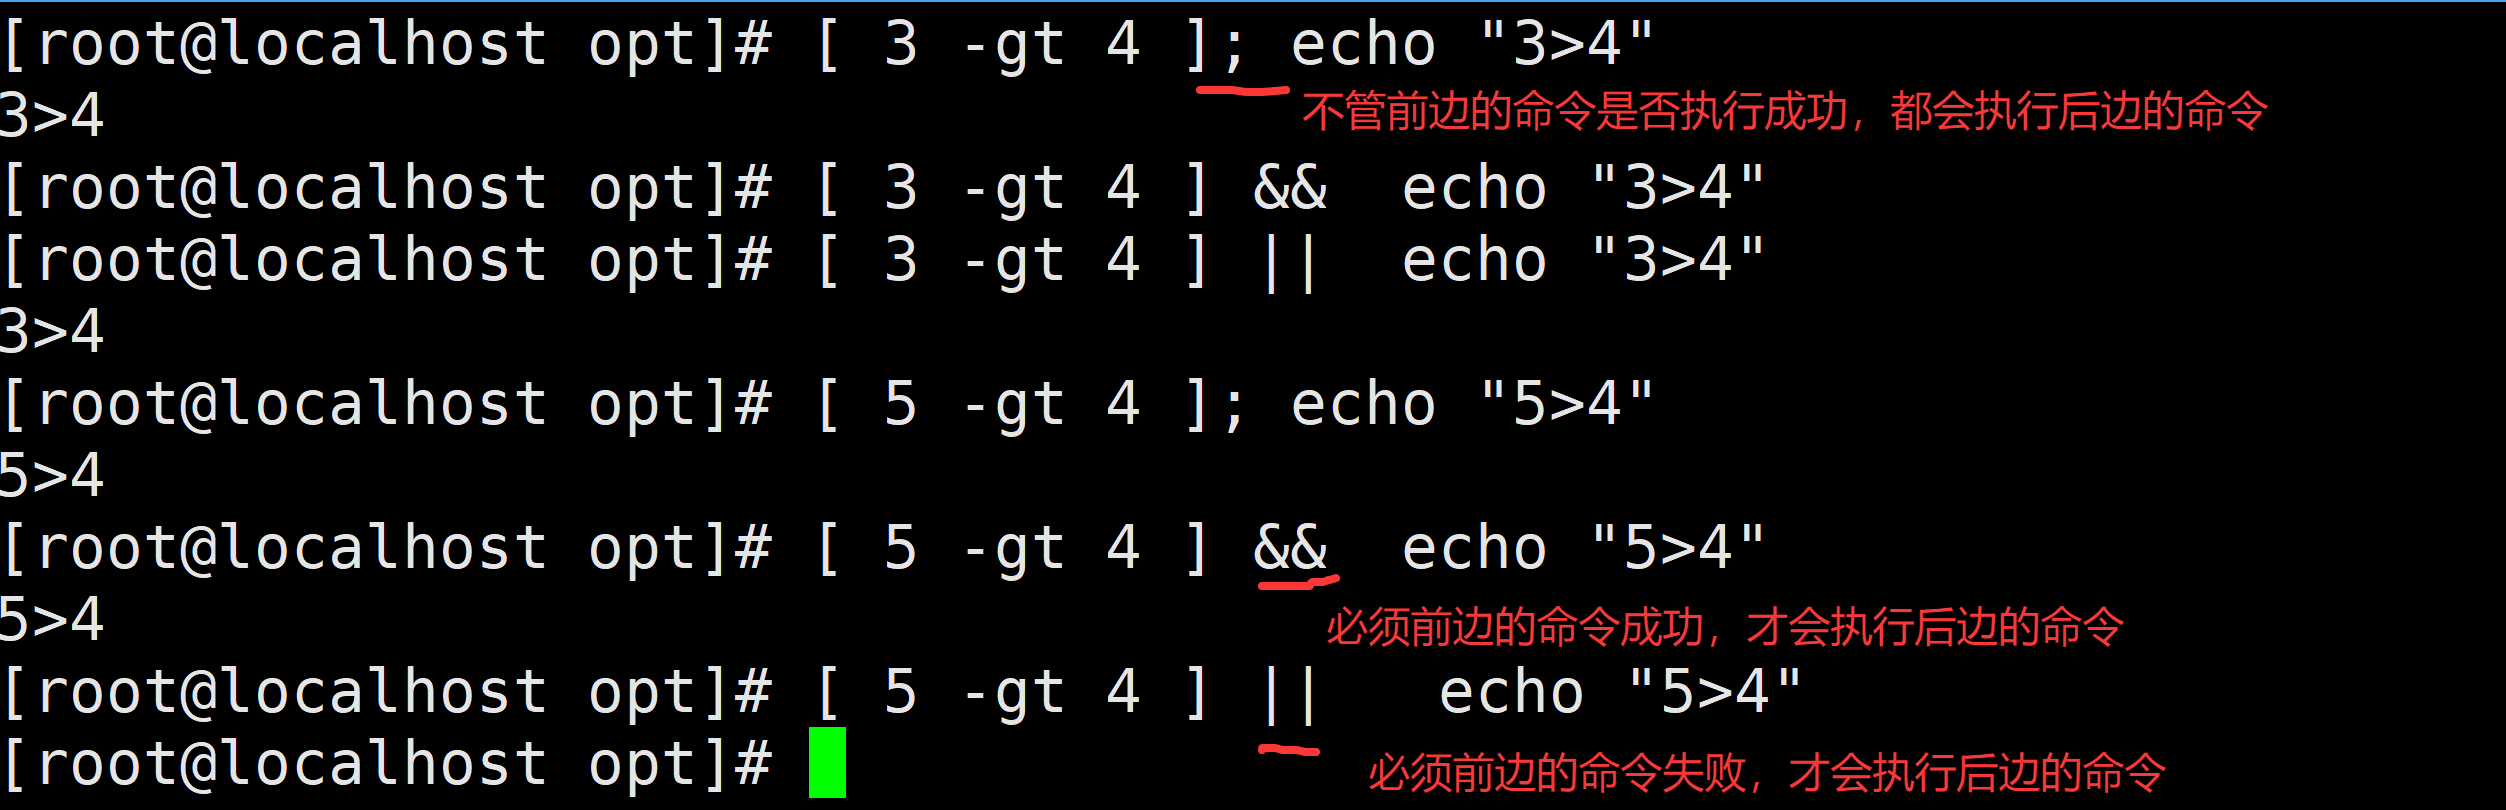
    file

    file

    []与[[]]的区别

    [ 1 -eq 0 -a 1 -ne 0 ];echo $?
    [ 1 -eq 0 && 1 -ne 0 ];echo $?
    [[ 1 -eq 0 && 1 -ne 0 ]];echo $?
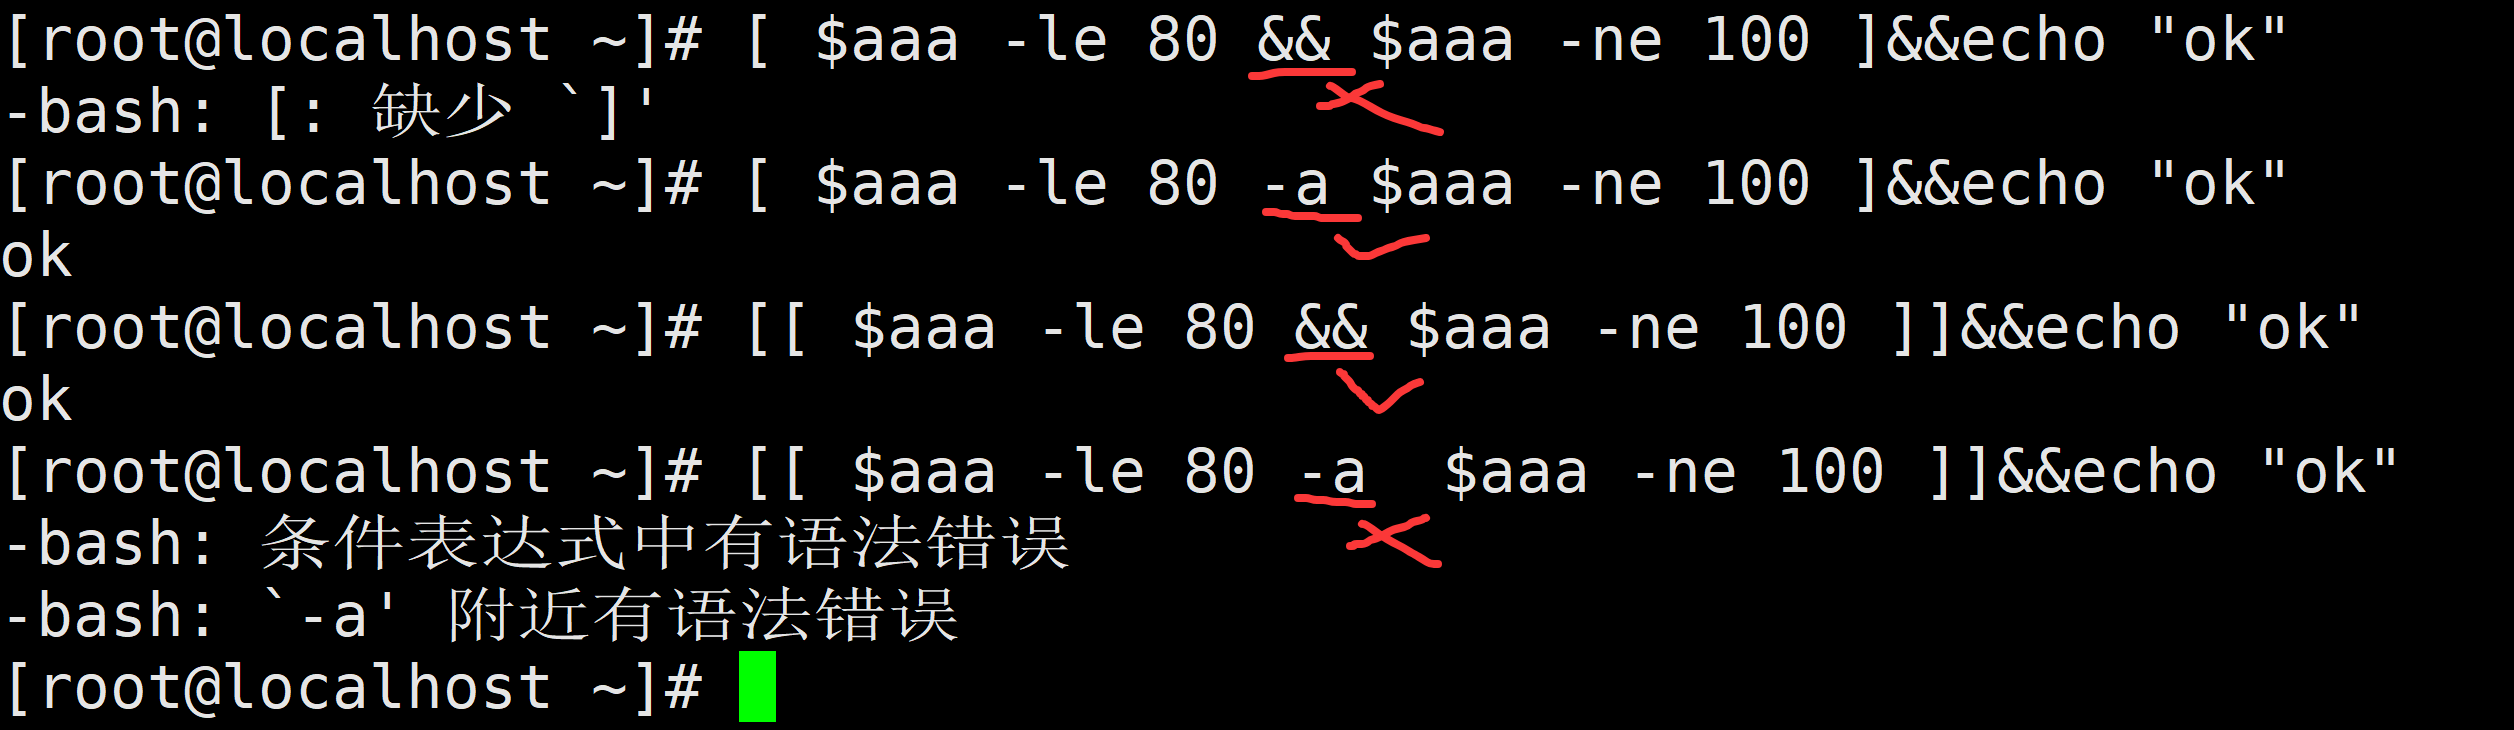
    file

    file

    6.4 课堂练习

    需求1:比较1和0的大小,如果为真,则显示1大于0

    file

    需求2:比较1和0的大小,如果为真,则显示1大于0,如果为假,则显示1小于0

    file

    需求3:定义一个变量score=81,判断score大于80,小于100,则显示优秀
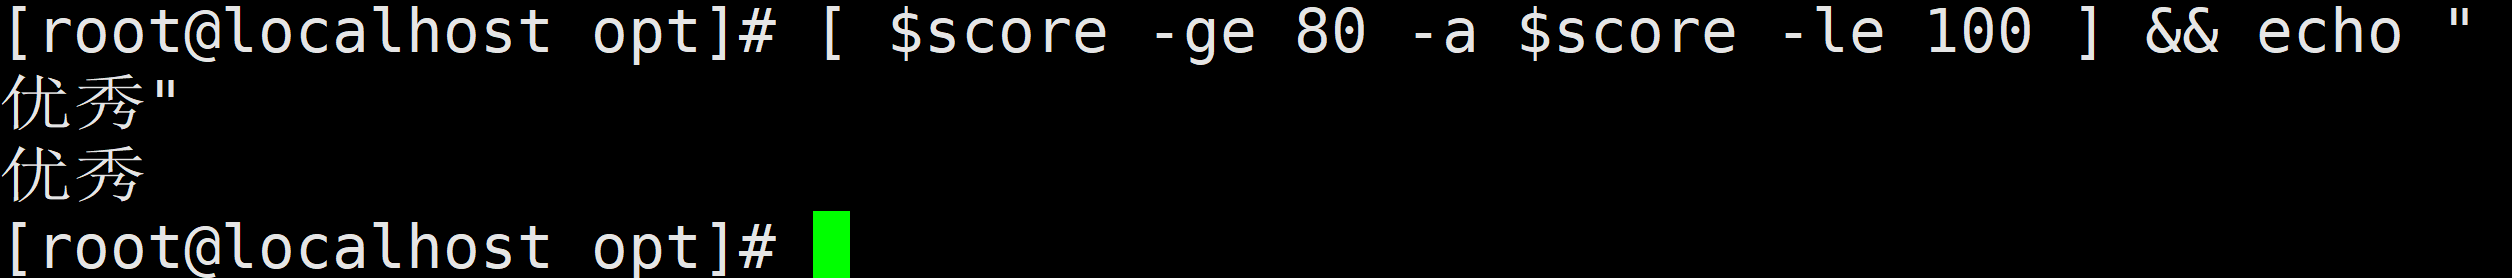
    file

    需求4:定义一个变量uid=0,如果uid等于0,则显示为root用户,否则,则显示非root用户
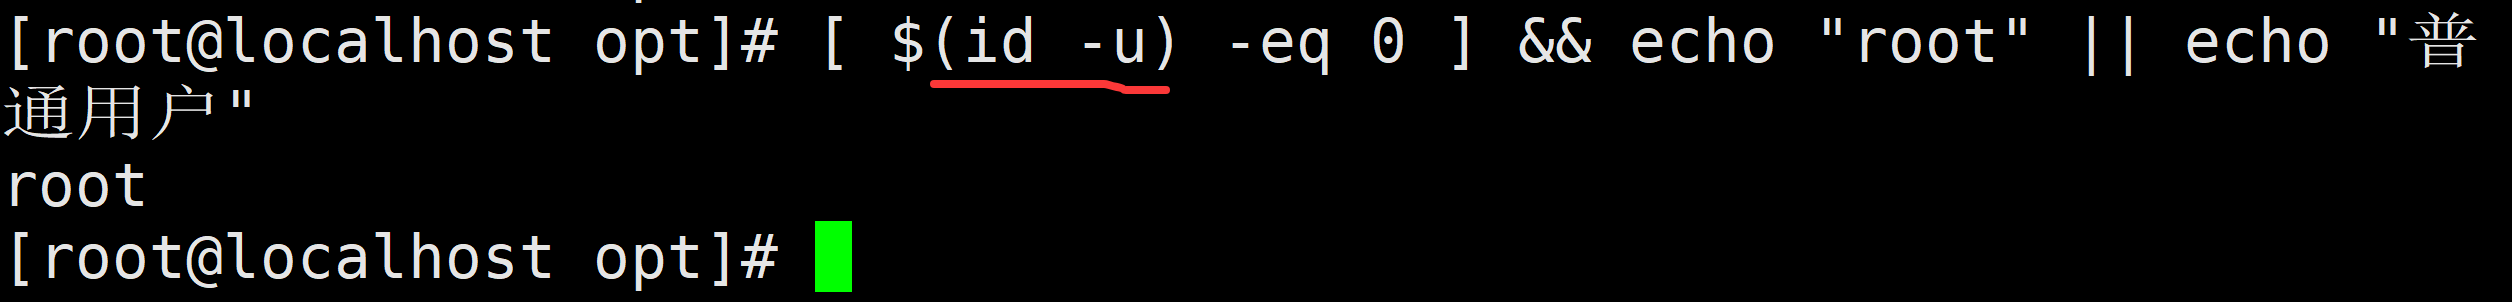
    file

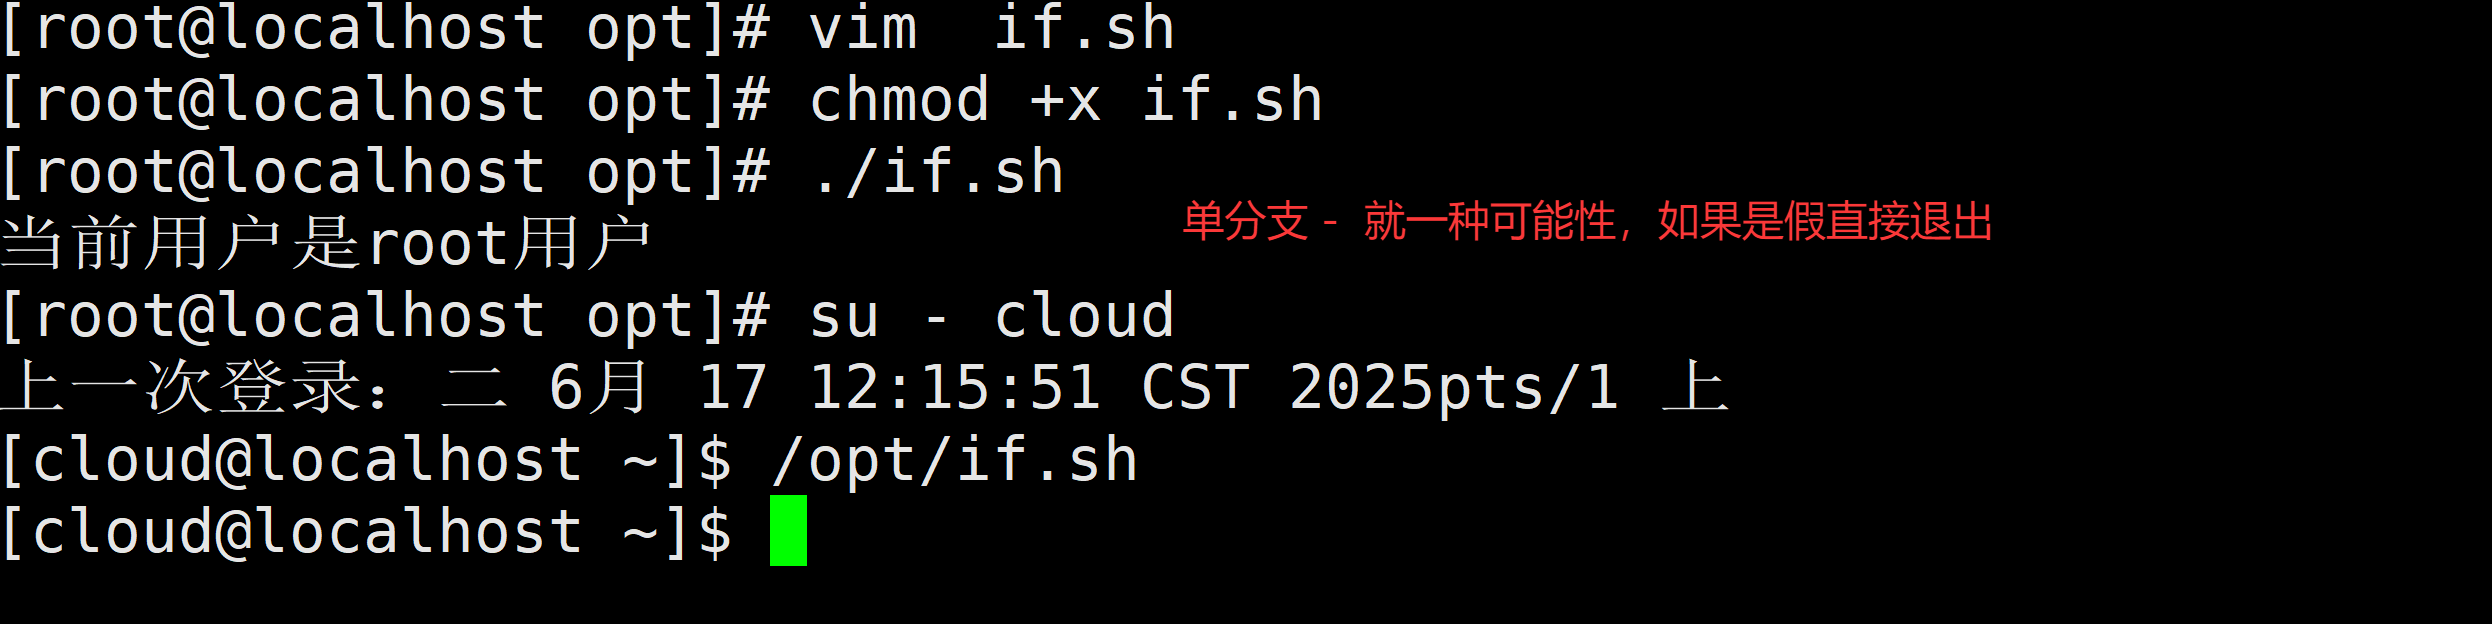
    需求5:判断当前用户是否为root用户

    file

    7.流程控制(if else)

    7.1 概述

    1)流程控制

    在一个程序执行的过程中,各条语句的执行顺序对程序的结果是有直接影响的。所以,我们必须清楚每条语句的执行流程。而且,很多时候要通过控制语句的执行顺序来实现我们想要的功能

    2)分支

    分支,读音fēn zhī,汉语词语,意思为从总体或一个系统中分出的部分。通俗的说就是可以有不同的选项可供选择

    3)举例

    如:今天下雨我就不去上班了。 有两个选择(上班或者不上班 取决的条件为:是否下雨)

    如:中了500万我就立马辞职。有两个选择(辞职或者不辞职 取决的条件为:是否中500万)

    7.2 语法

    1)单分支

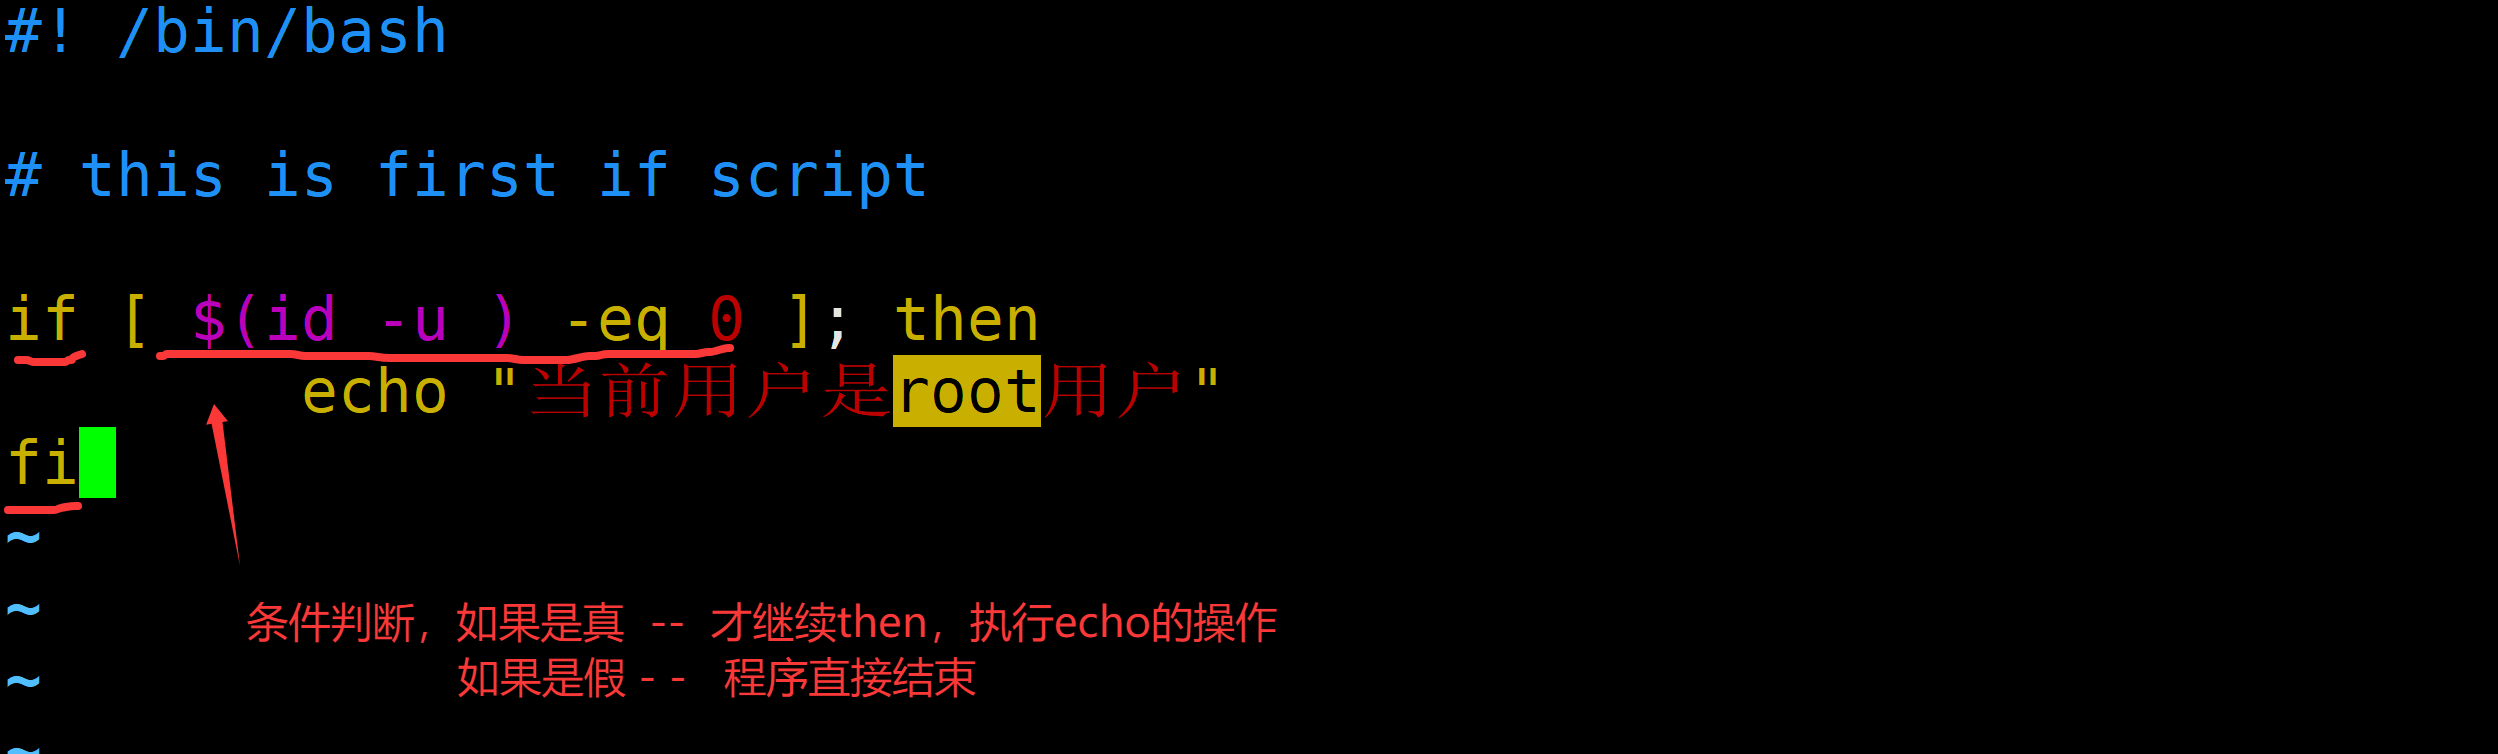
    if [ condition ];then               
            command                               
            command
    fi

    以上相当于逻辑运算中的

    [ 条件 ] && command
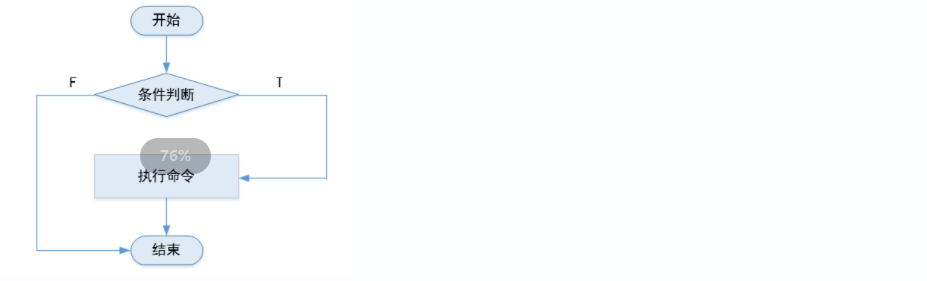
    file

    file

    file

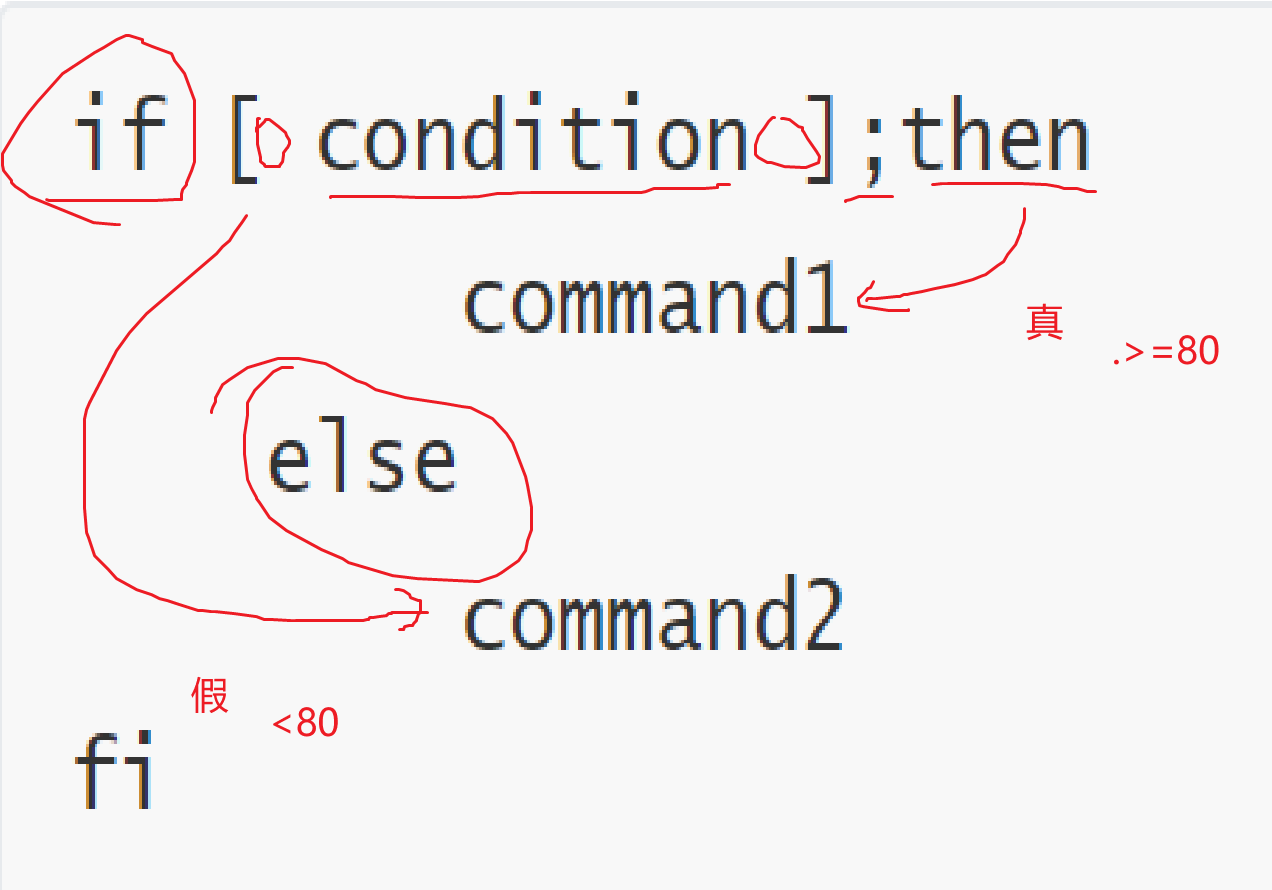
    2)双分支

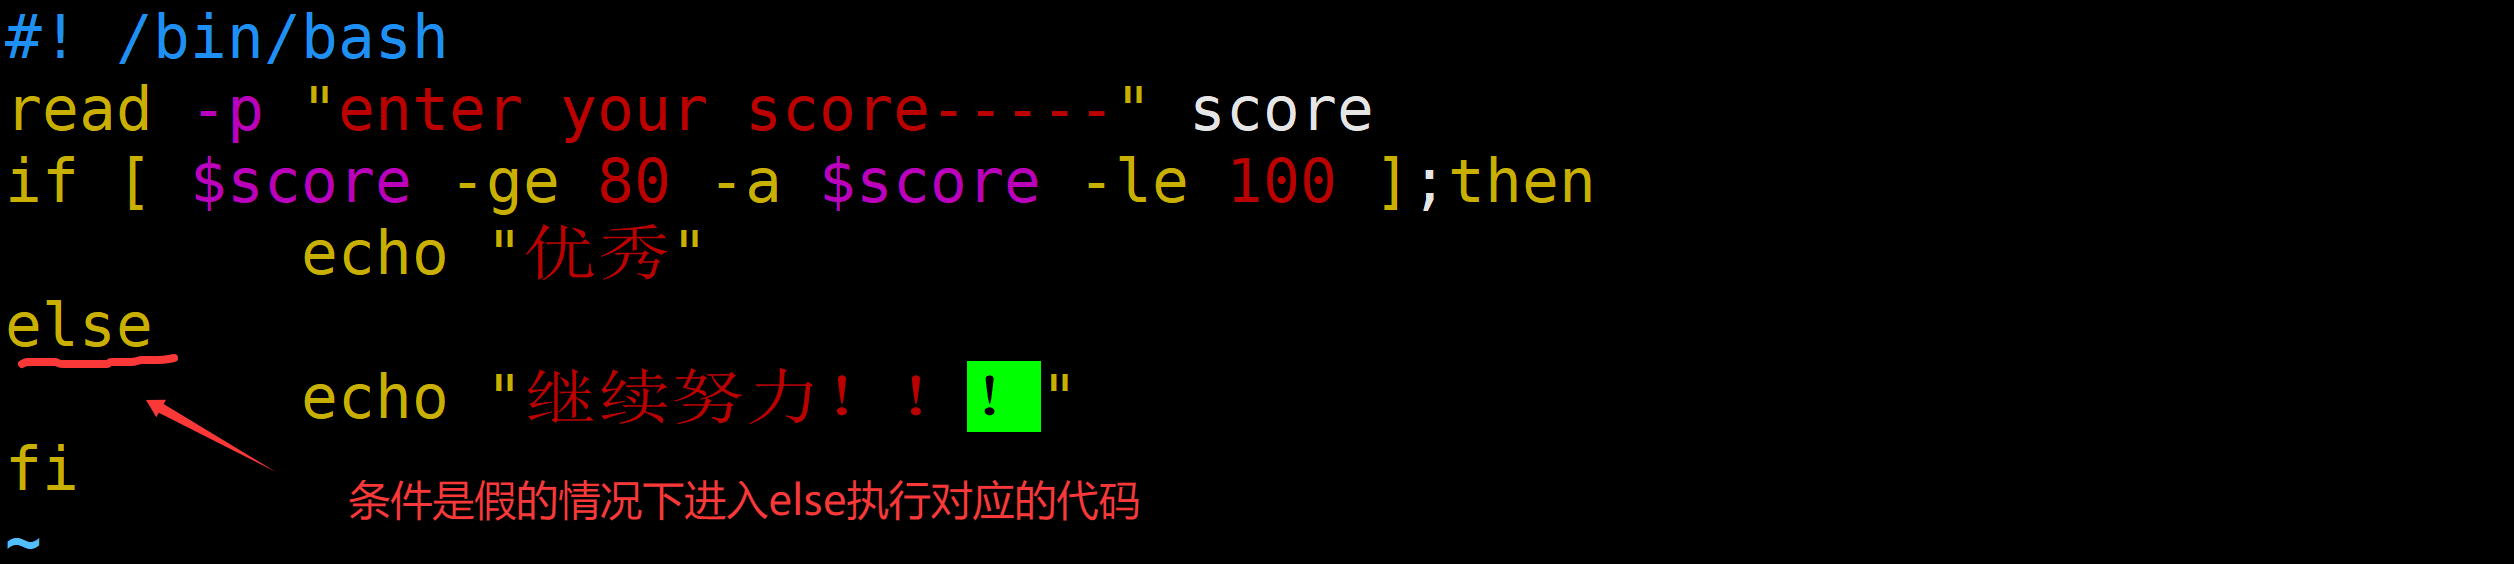
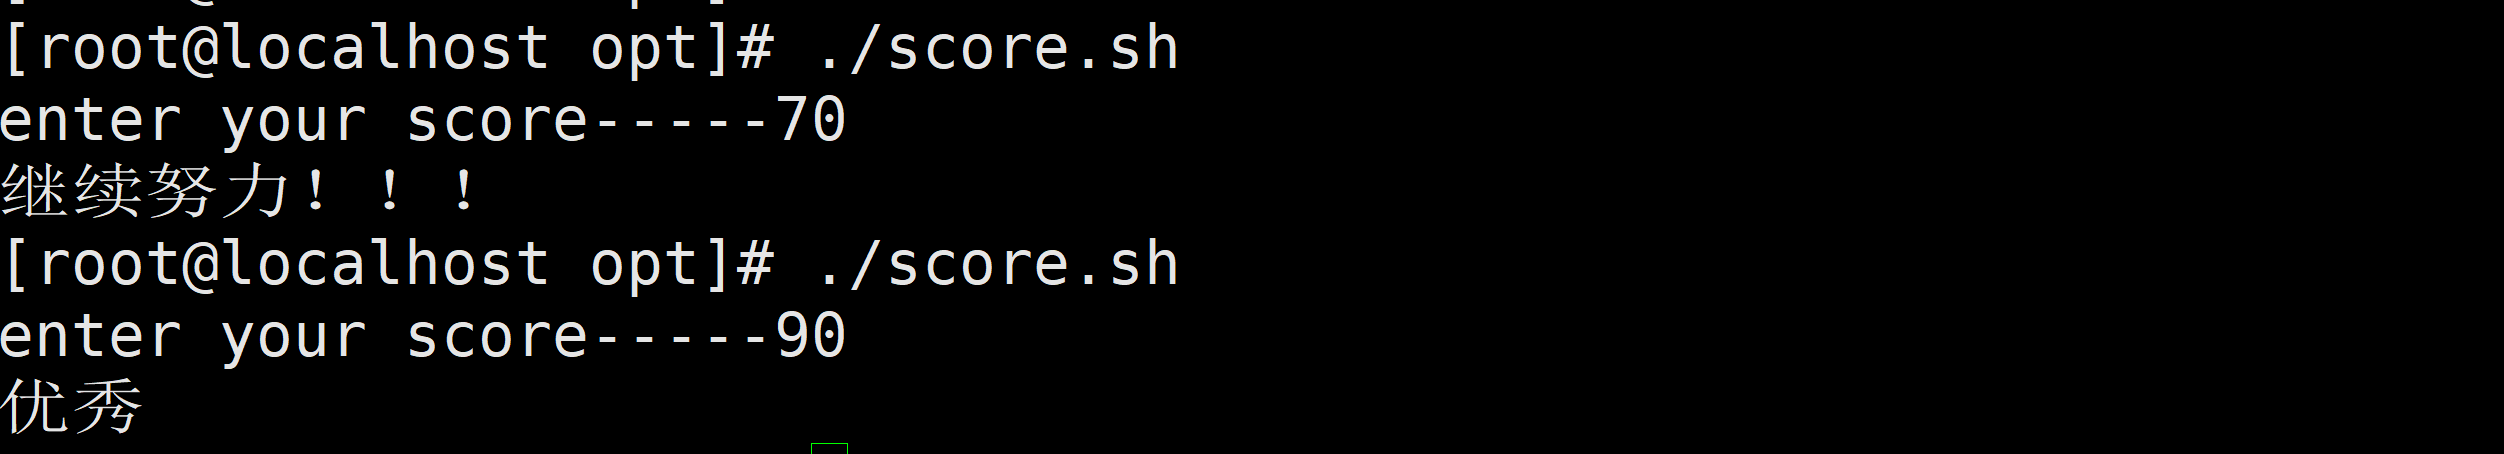
    if [ condition ];then
            command1
        else
            command2
    fi

    以上相当于逻辑运算中的

    [ 条件 ] && command1 || command2
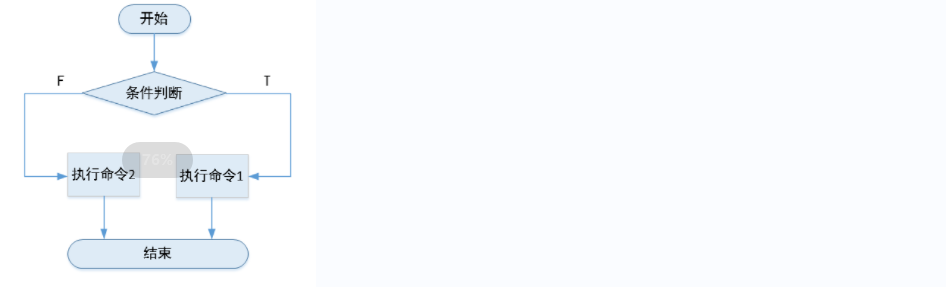
    file

    file

    file

    file

    3)多分支

    if [ condition1 ];then
            command1  结束
        elif [ condition2 ];then
            command2  结束
        elif [ condition3 ];then
            command3  结束    
        else
            command4
    fi
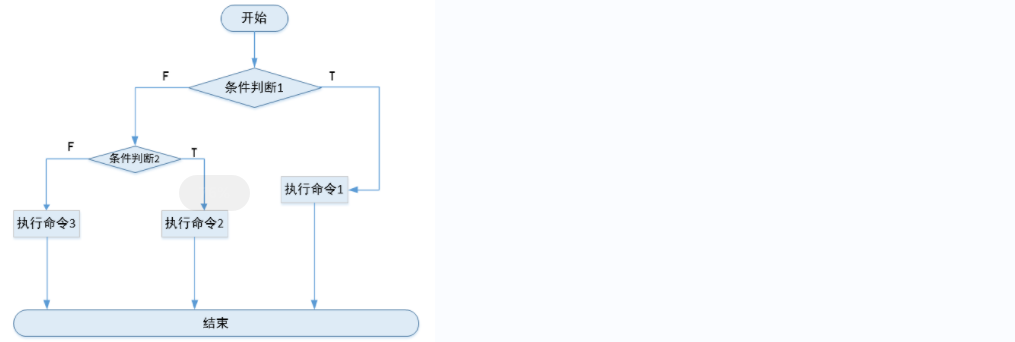
    file

    4)分支嵌套

    if [ condition1 ];then
            command1        
            if [ condition2 ];then
                command2
            fi
        else
            if [ condition3 ];then
                command3
            elif [ condition4 ];then
                command4
            else
                command5
            fi
    fi
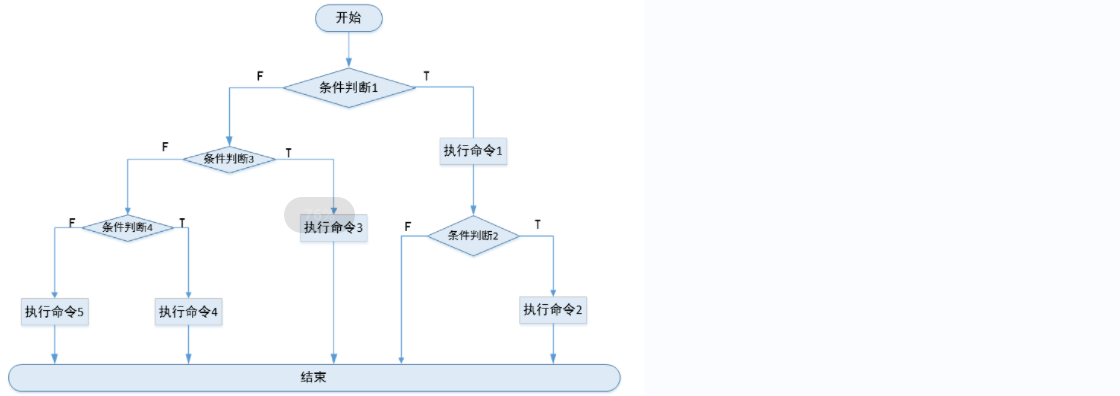
    file

    8.for语句

    1.1 概述

    循环:事物周而复始地运动和变化。就是重复做相同的事情。

    注意:相同的事情(可以是一模一样的事情,也可以是性质相同的事情)

    比如:

    连续输出10次“我爱你” —— 一模一样的事情

    连续输出0-9 10个整数 —— 性质相同的事情

    代码示例:

    #!/bin/bash
    # 要求打印5遍我喜欢你
    echo "我喜欢你"
    echo "我喜欢你"
    echo "我喜欢你"
    echo "我喜欢你"
    echo "我喜欢你"

    使用循环之后:

    #!/bin/bash
    # 要求打印5遍我喜欢你
    for i in {1..5}
        do
            echo "我喜欢你"
        done
    1.2 列表循环

    1)语法结构

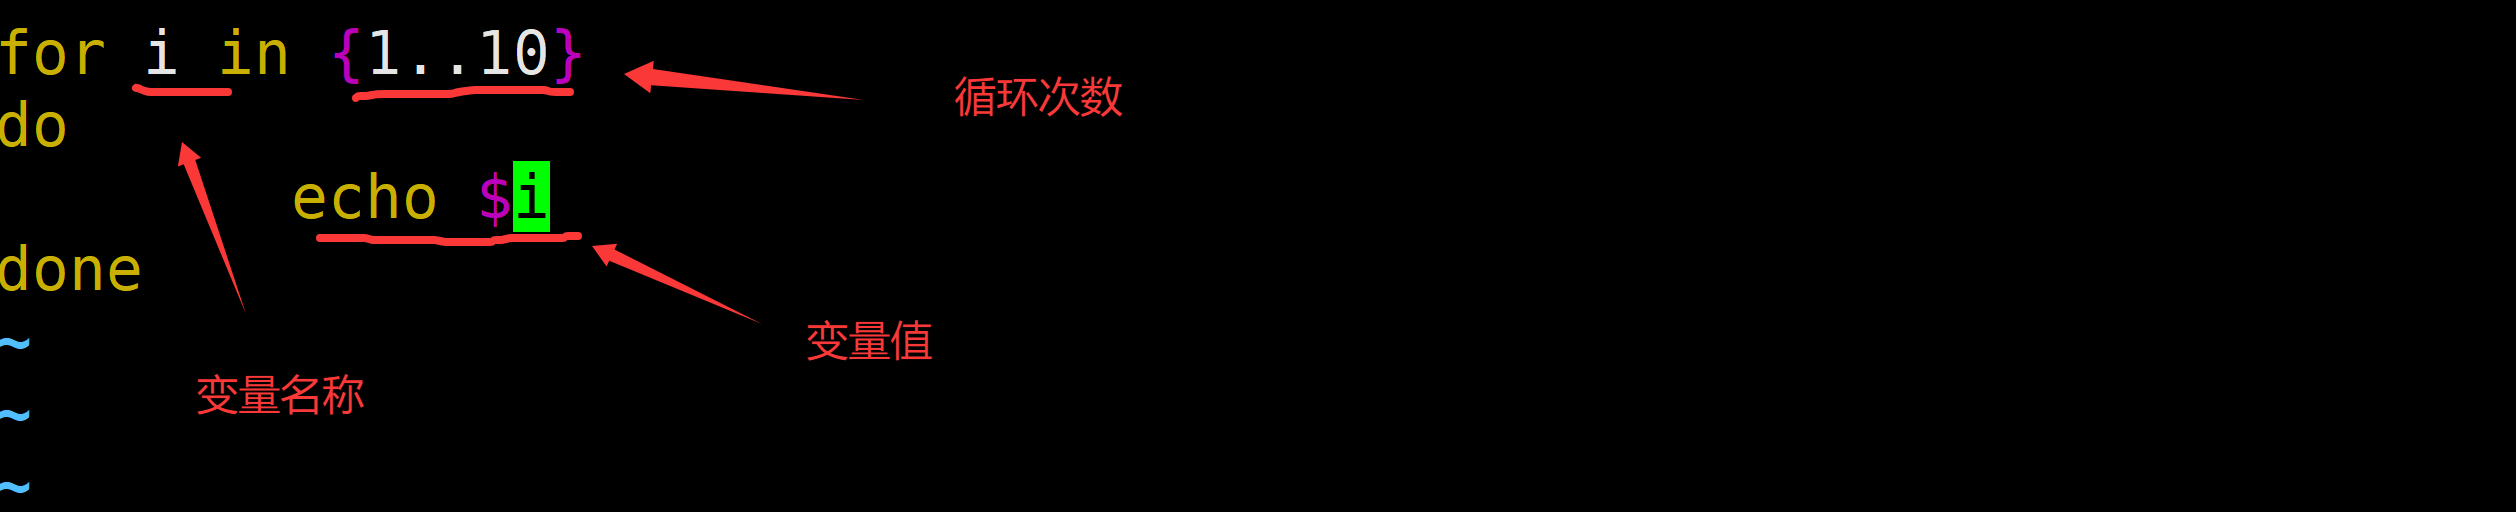
    列表for循环:用于将一组命令执行已知的次数,下面给出了for循环语句的基本格式:

    for variable in {list}
         do
              command 
              command
              …
         done
    或者
    for variable in a b c
         do
             command
             command
         done

    variable:是一个变量,可以用任意名字来表示,通常情况下我们都使用字母i

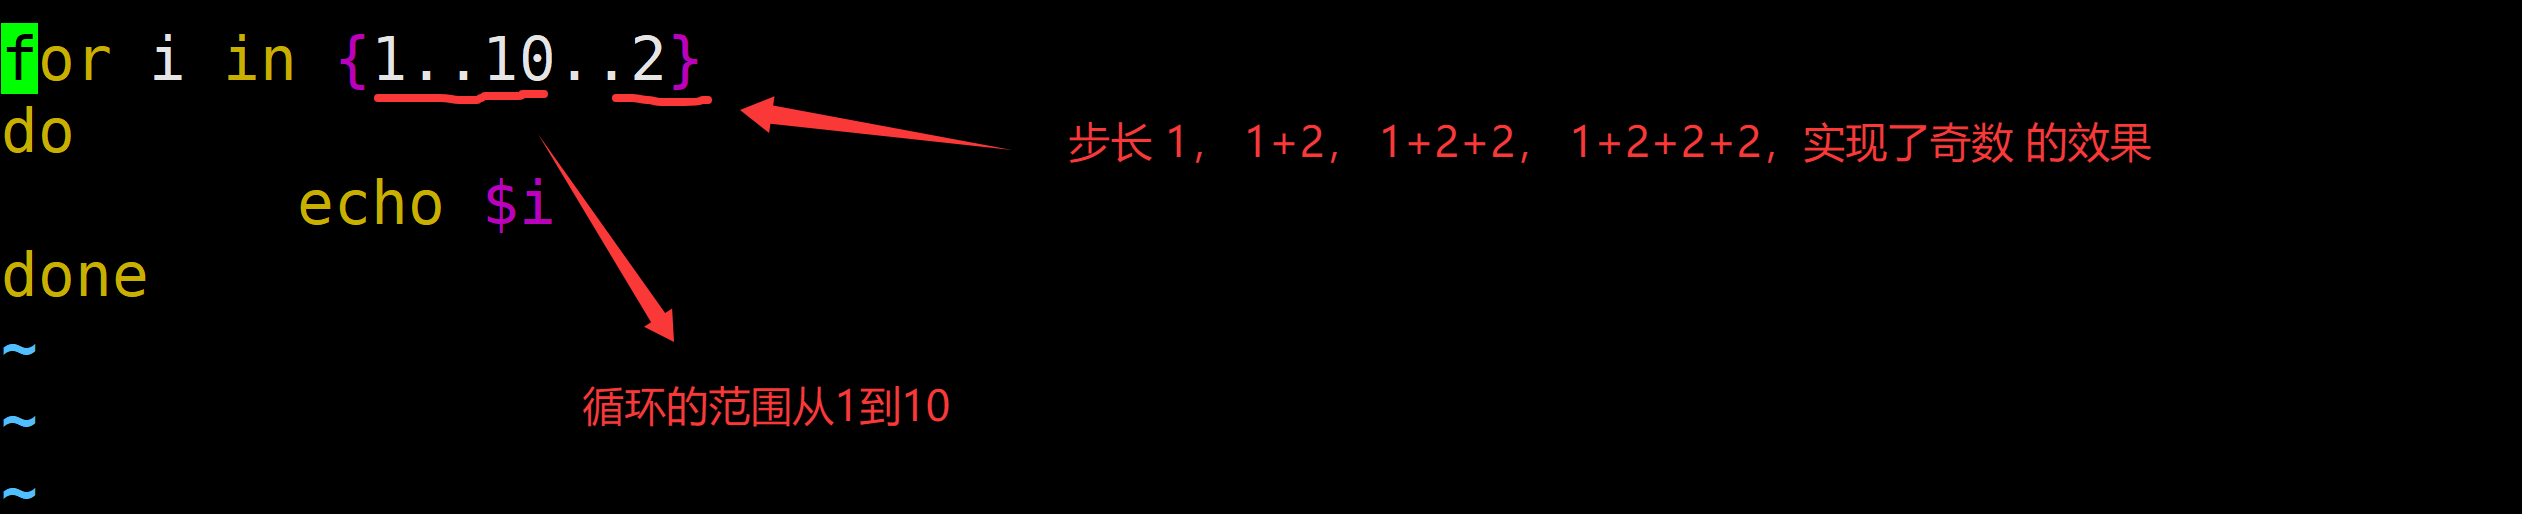
    1..10..2 : 2表示步长,就是指i每次变化的值
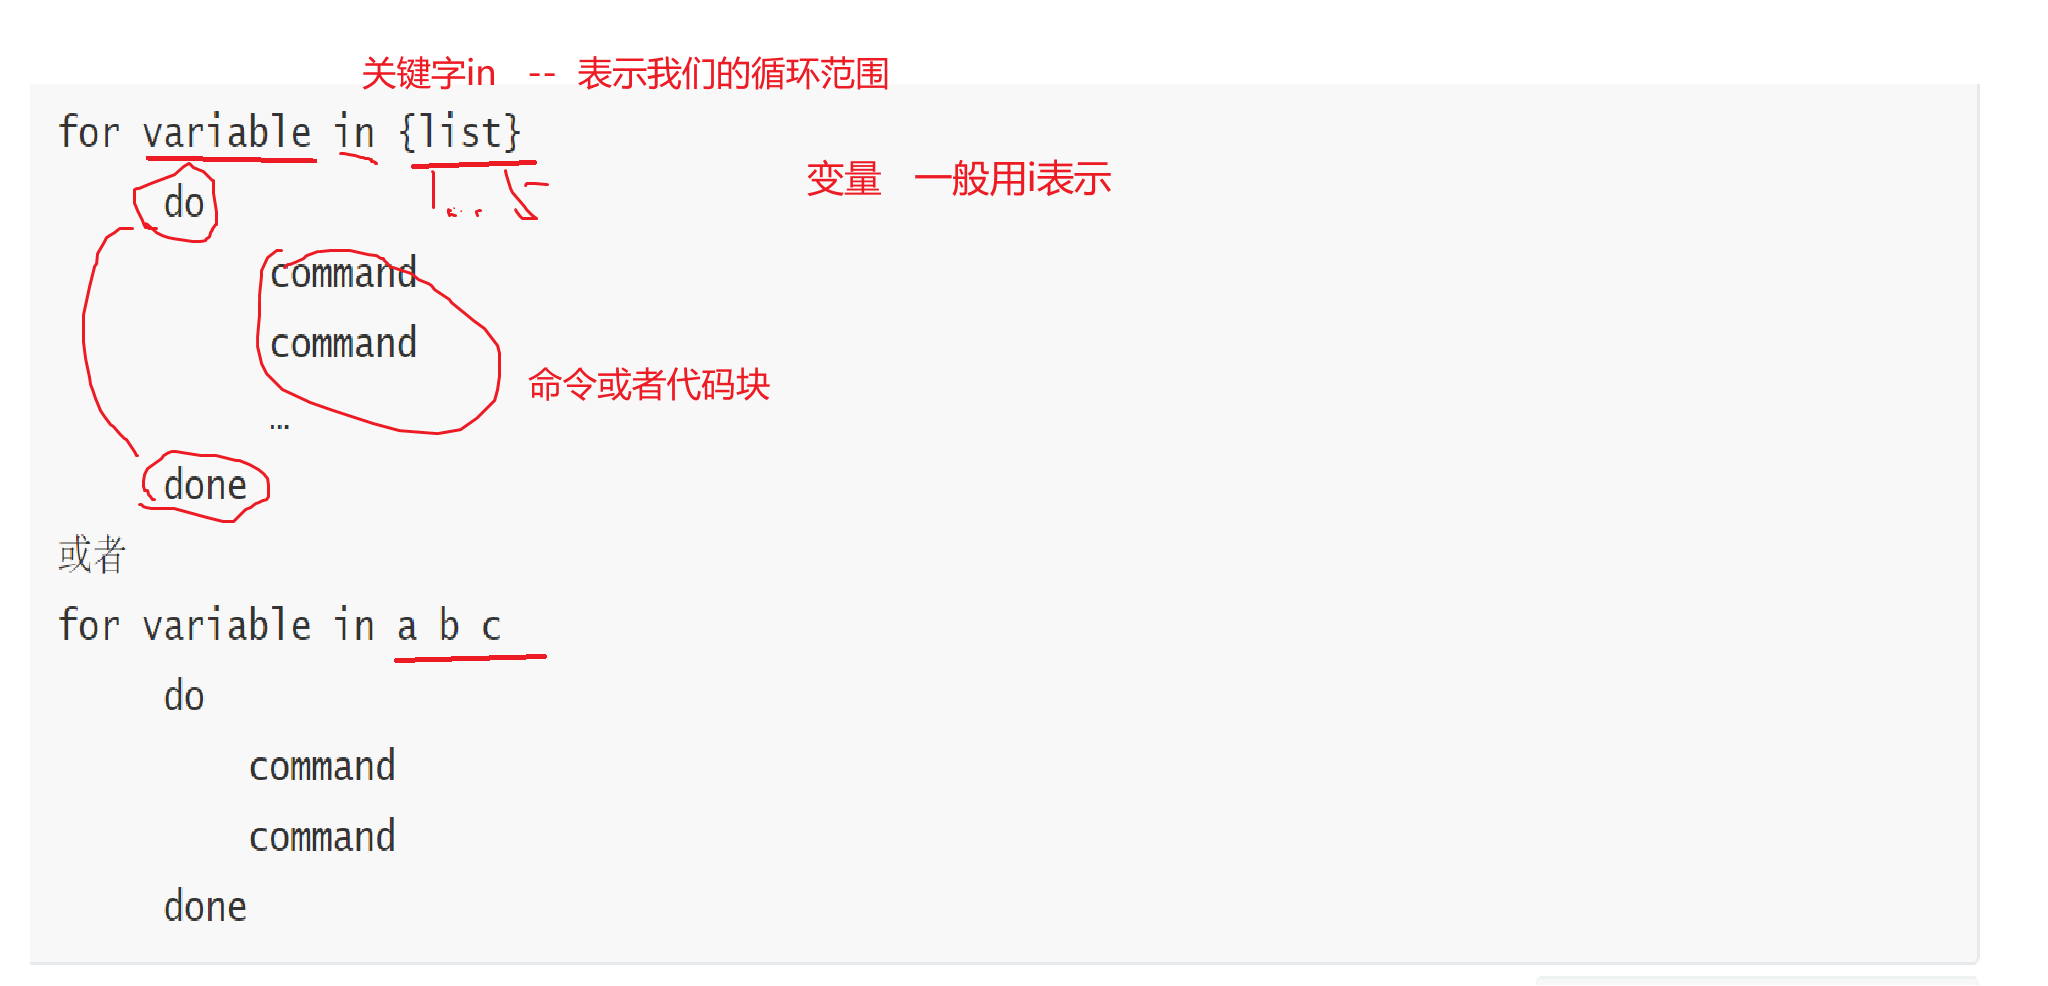
    file

    2)示例说明

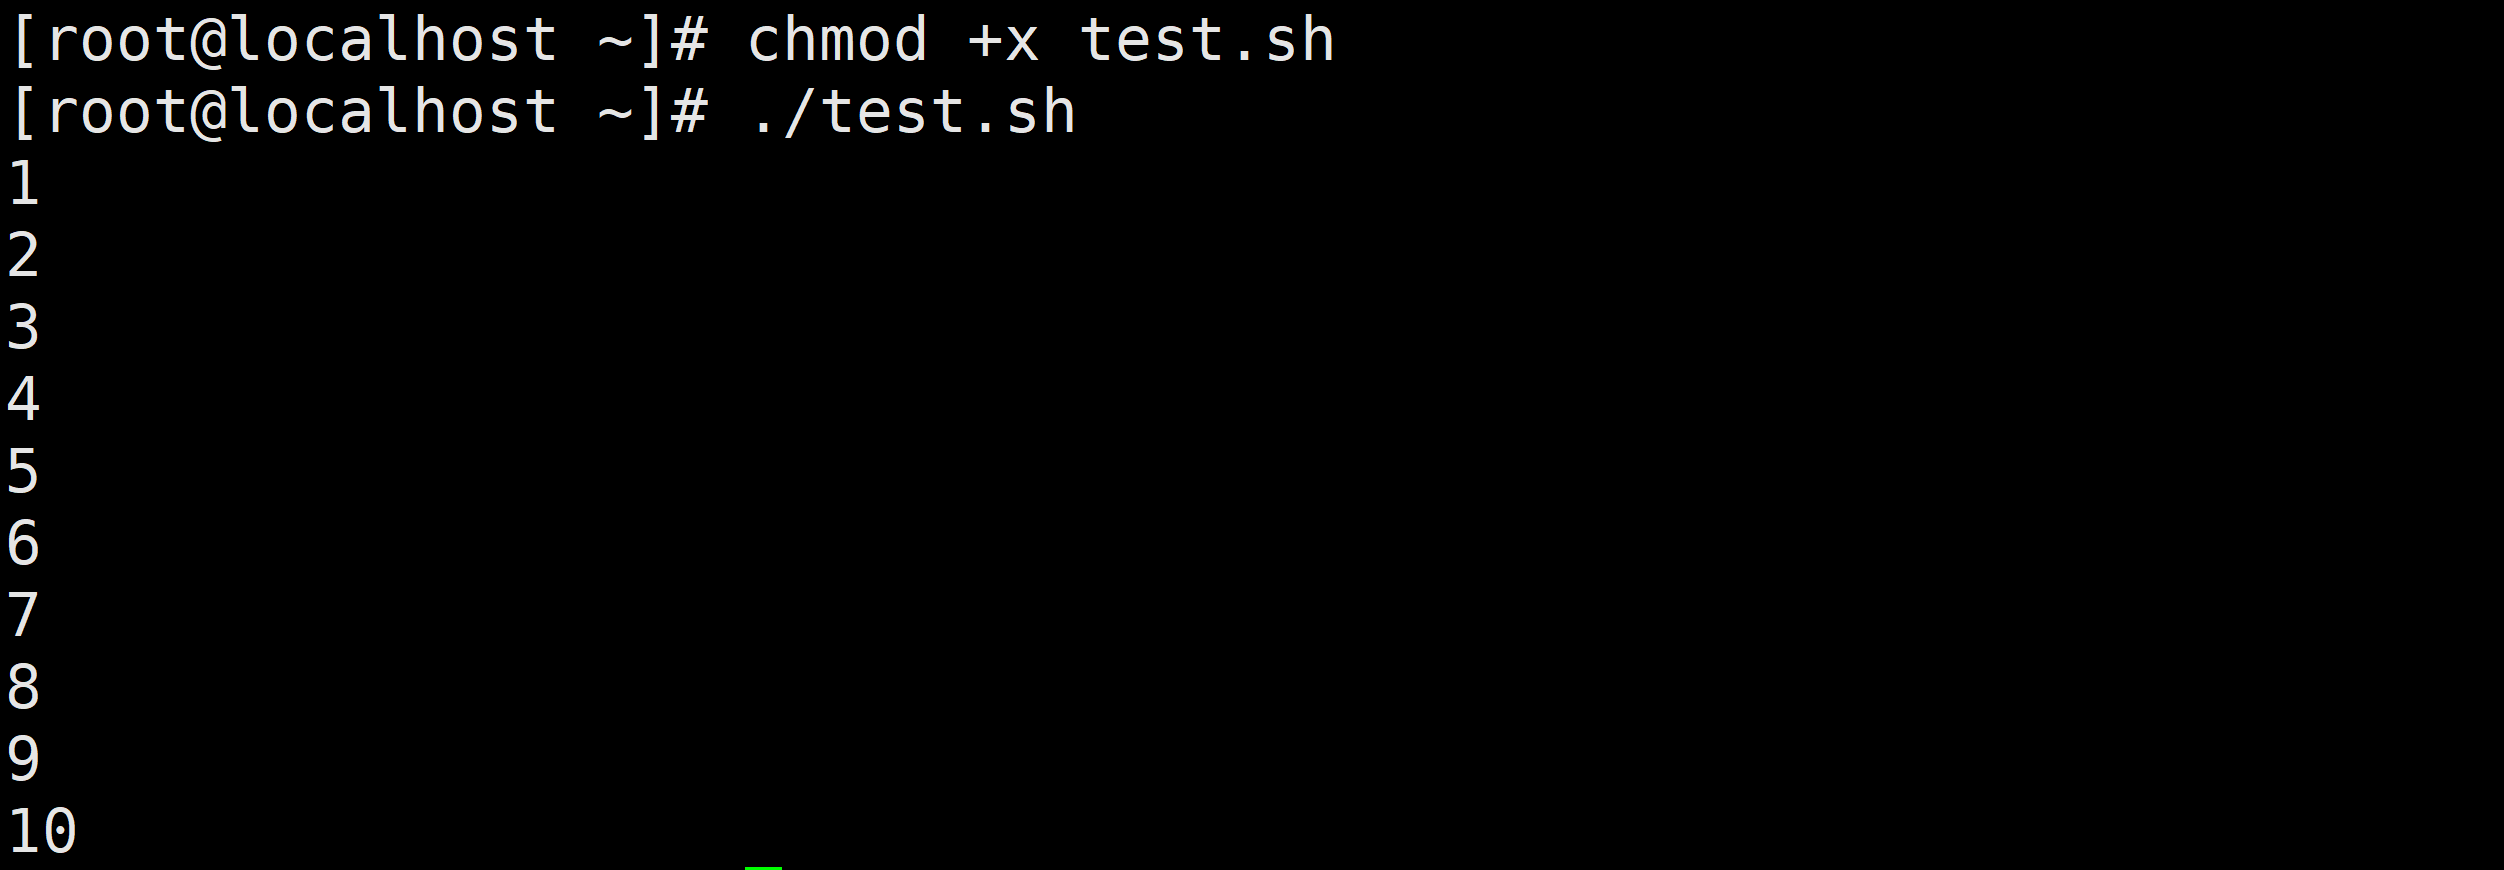
    需求1:输出1-10之间的数字

    file

    file

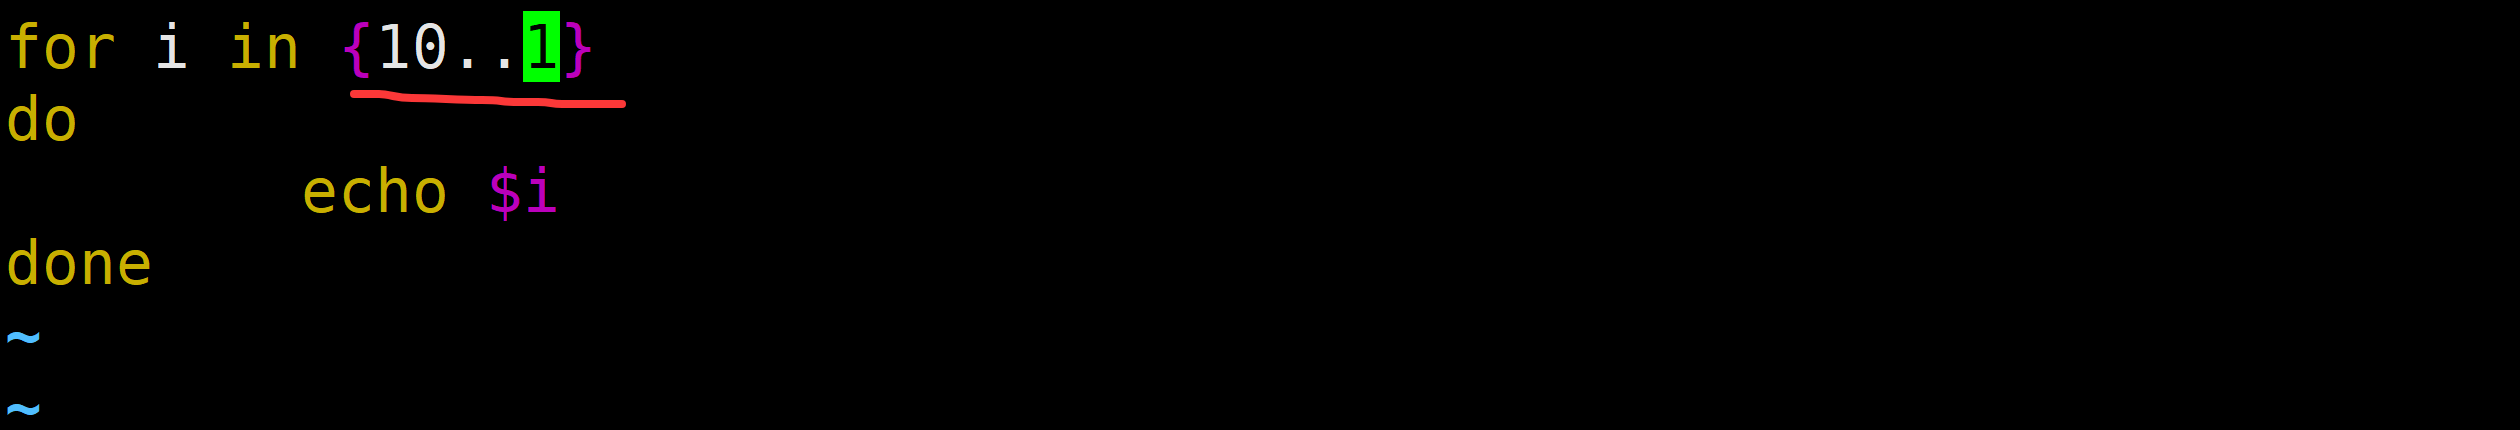
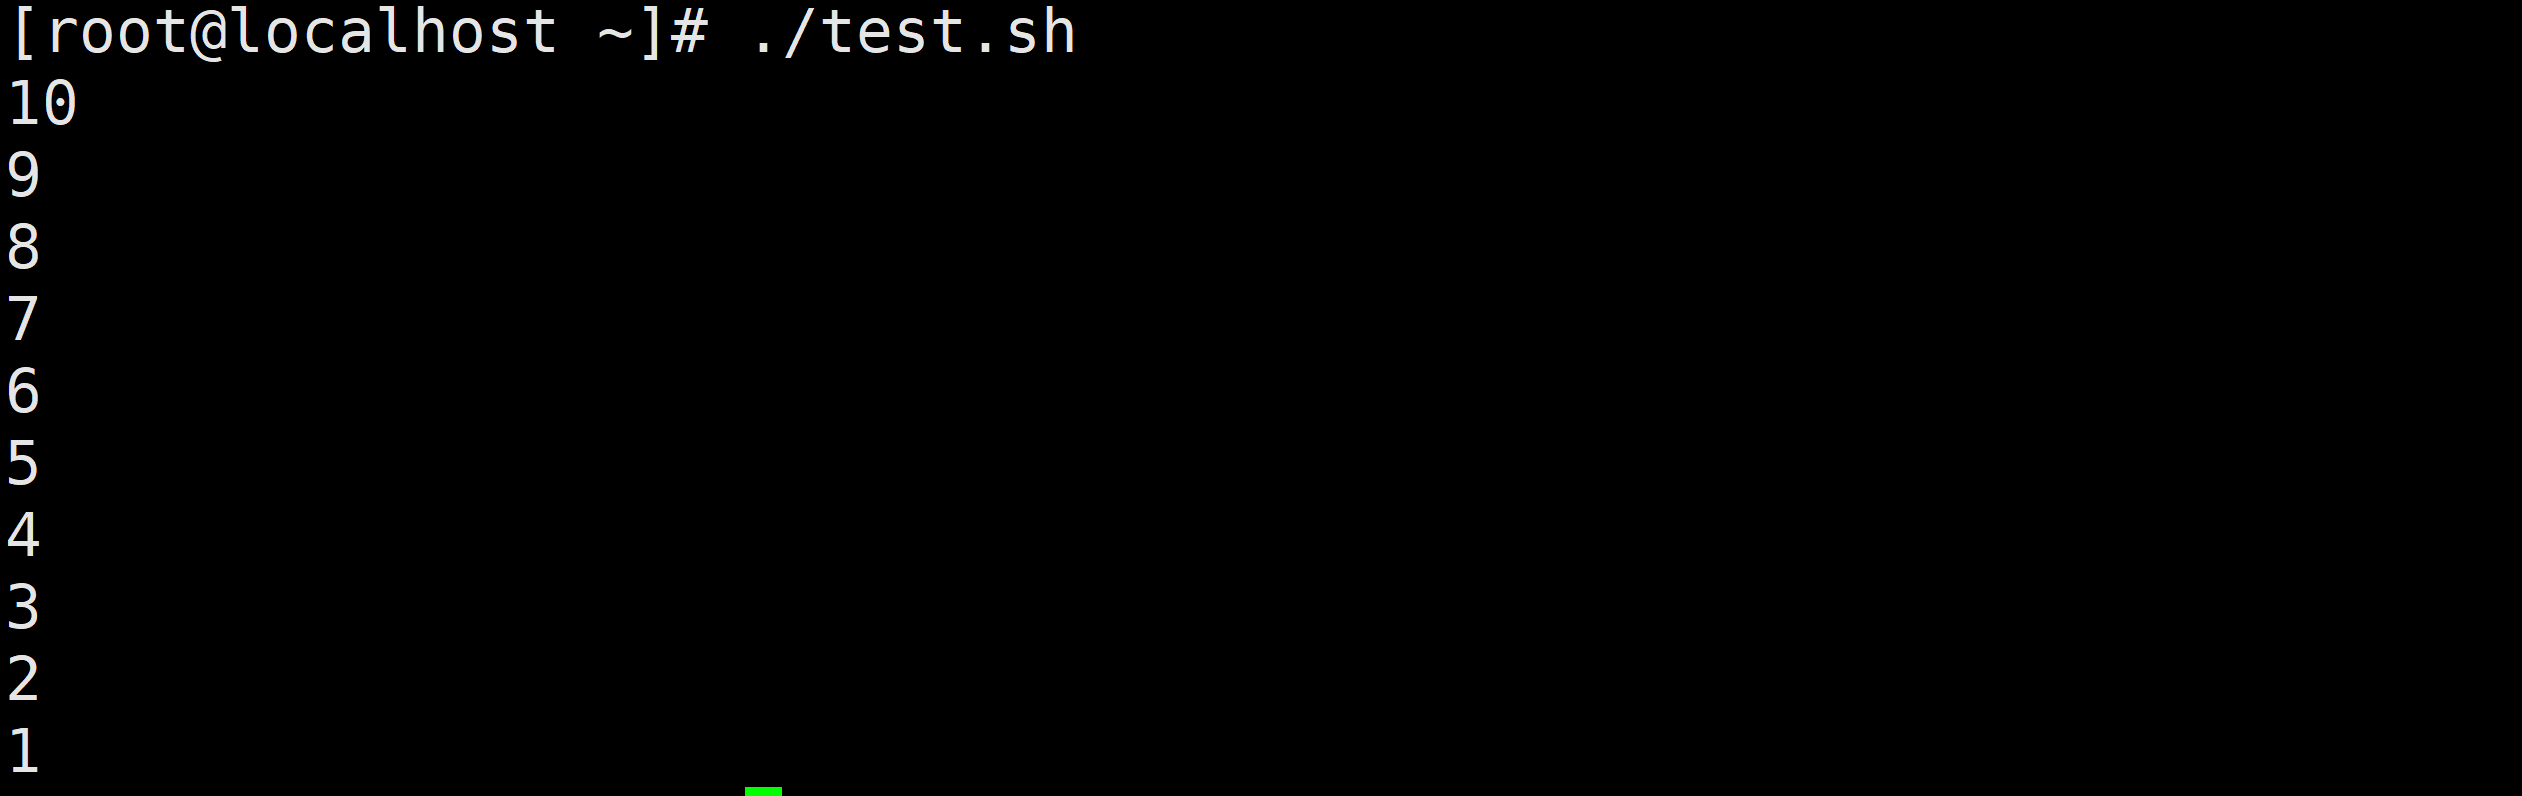
    需求2:输出10-1之间的数字

    file

    file

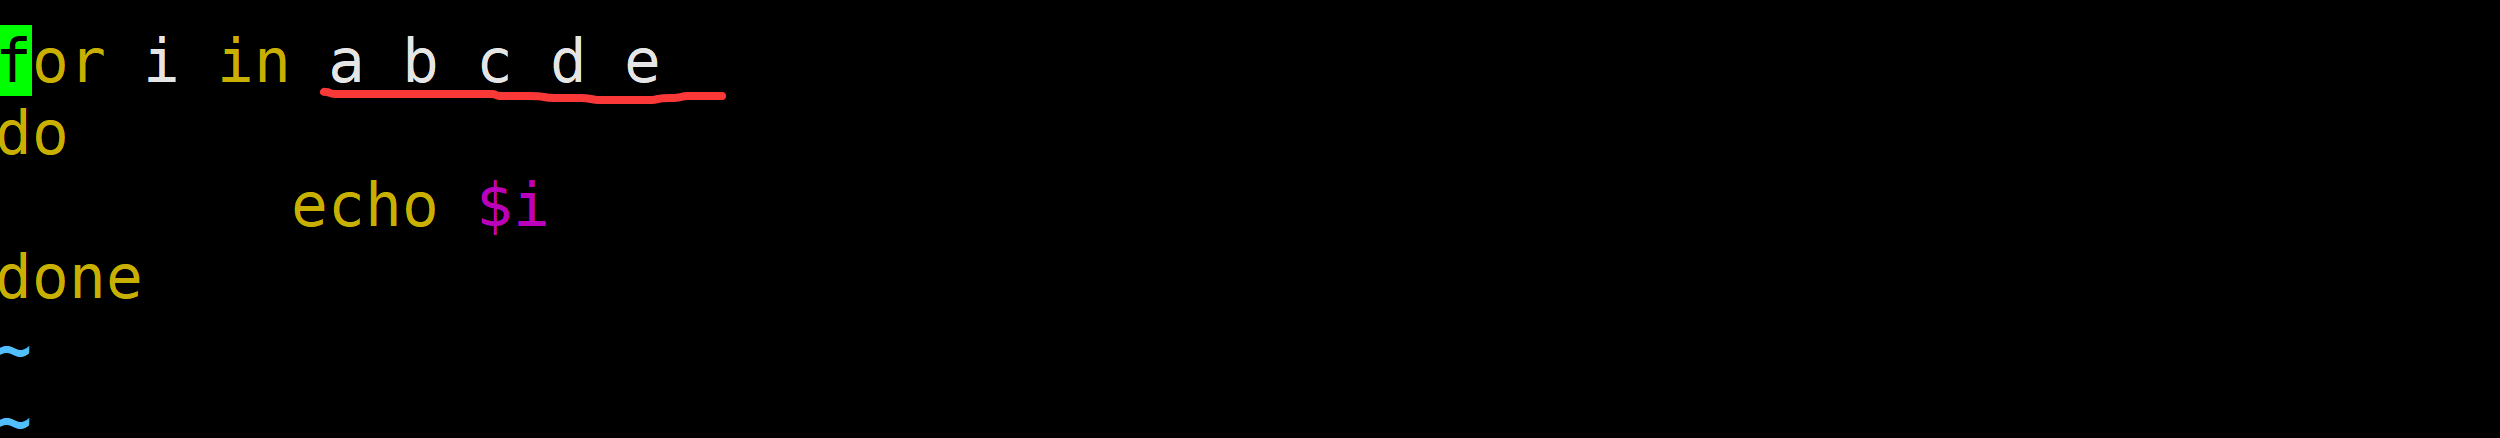
    需求3:输出a,b,d,e几个字母

    file

    file

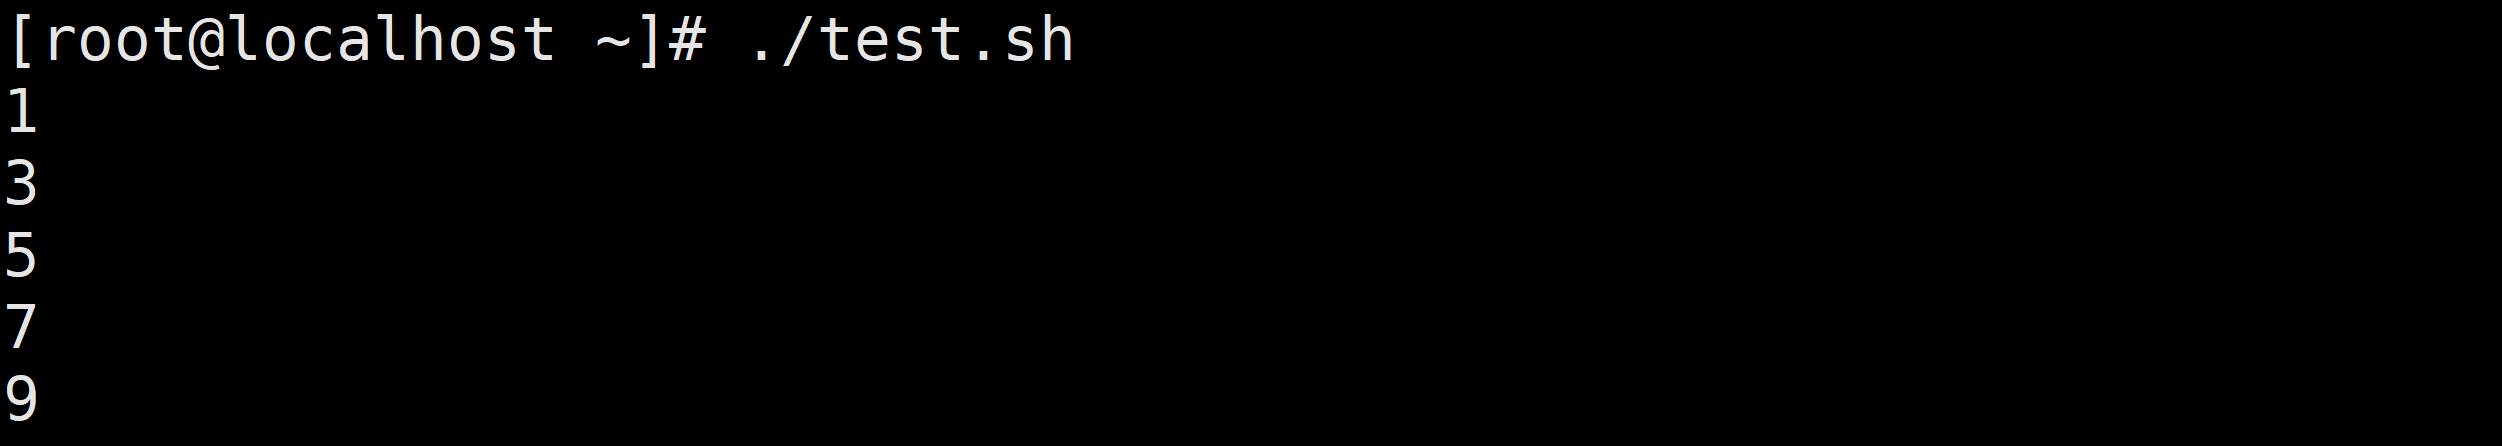
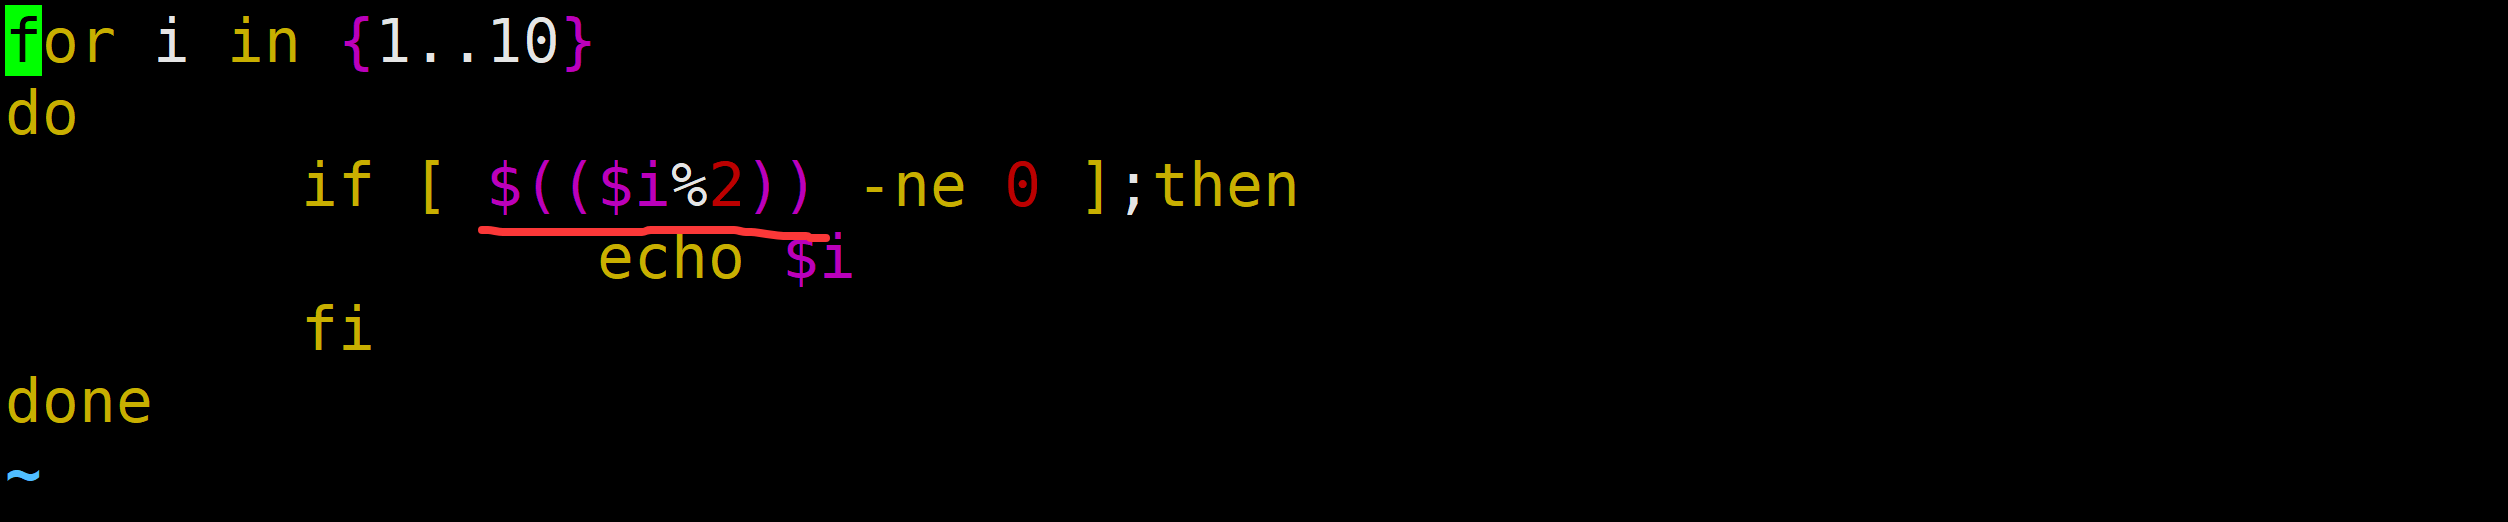
    需求4:输出1-10之间的奇数

    file

    file

    file

    1.3 非列表循环

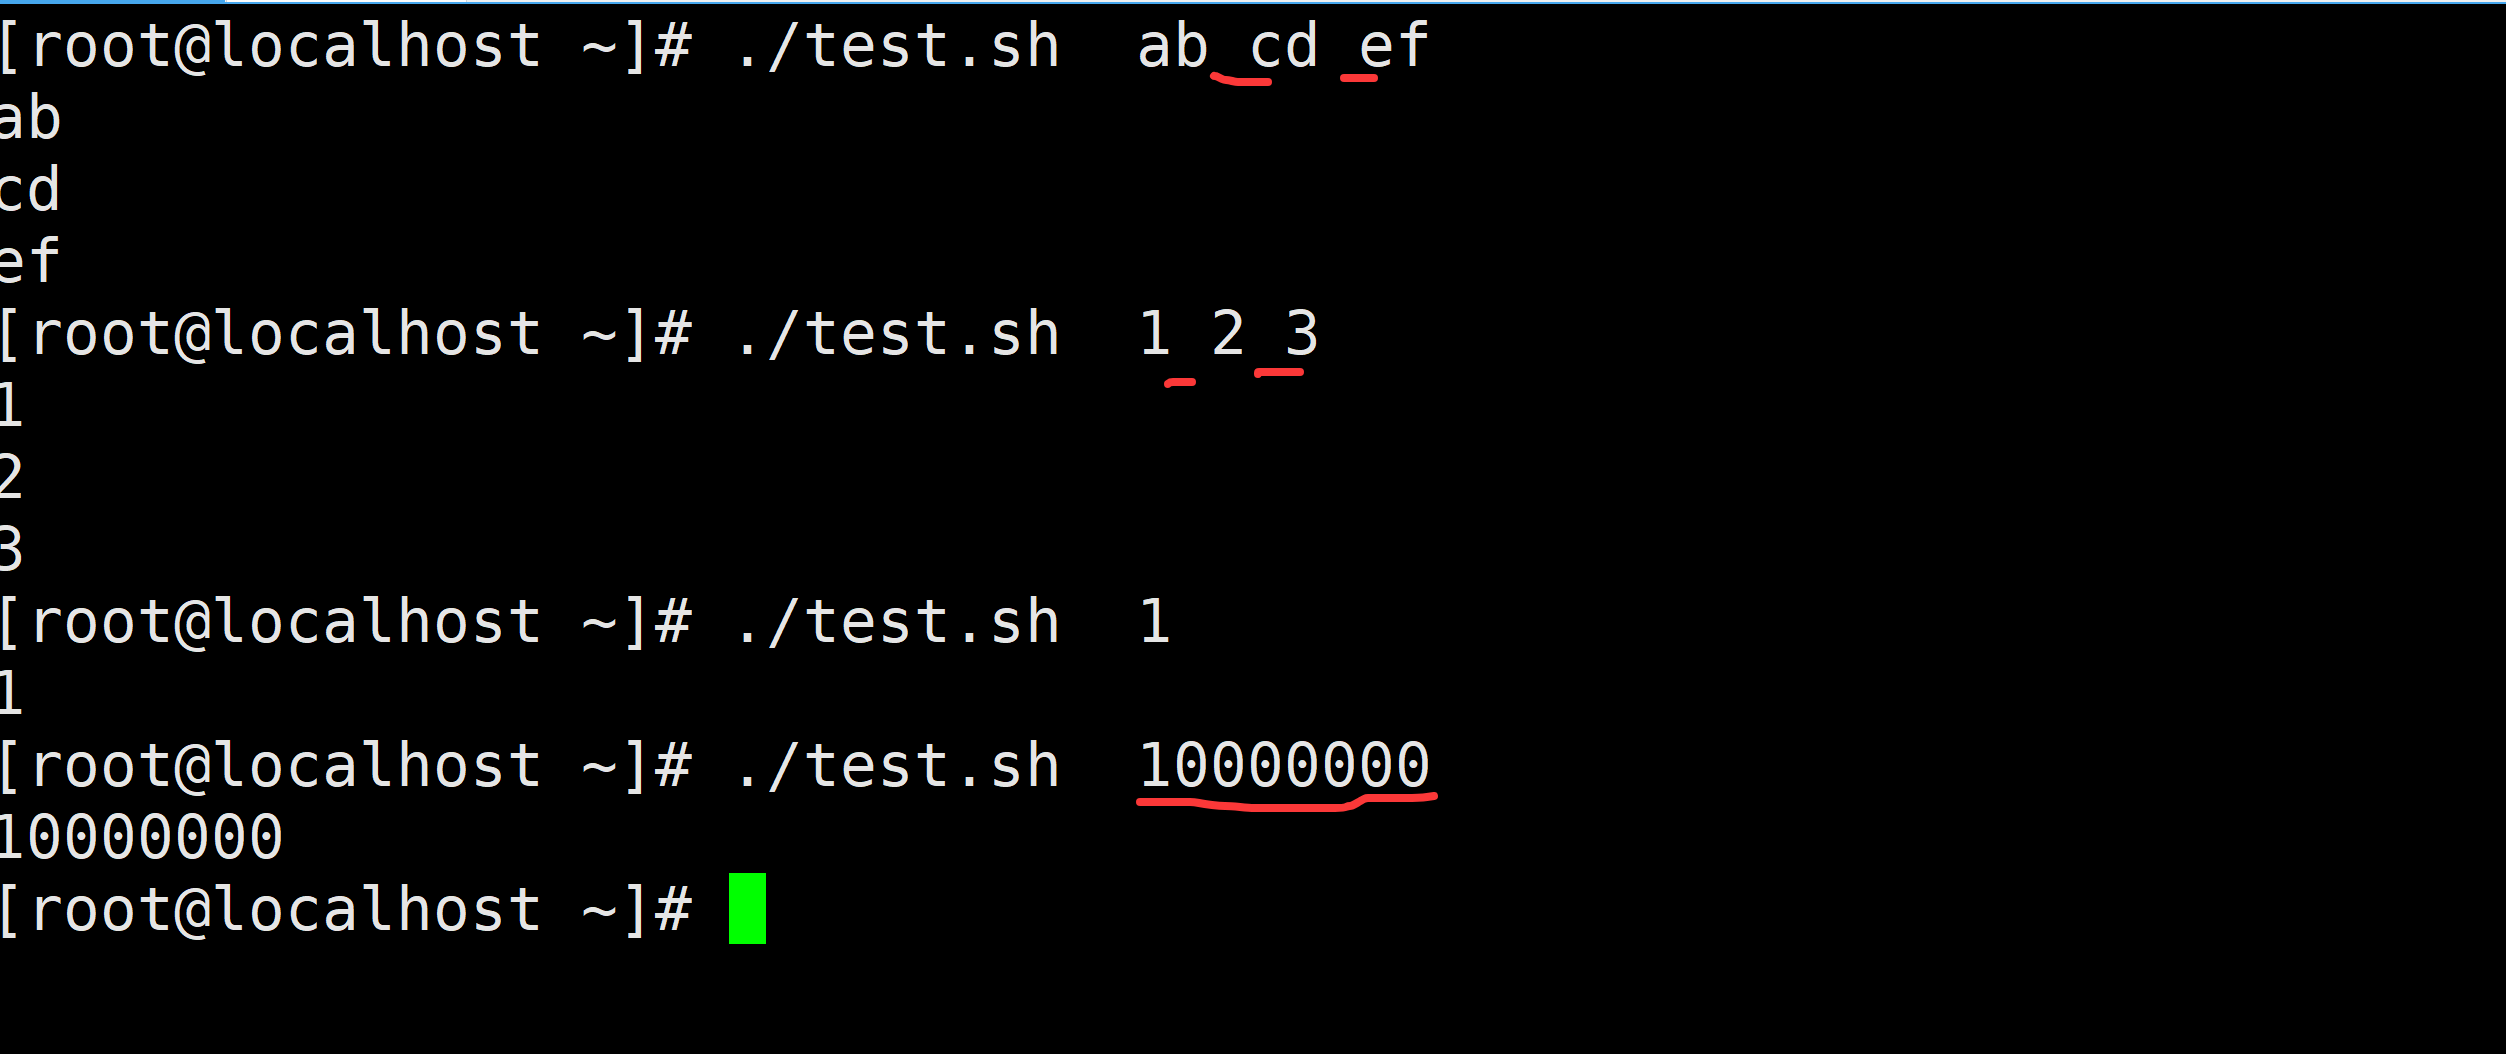
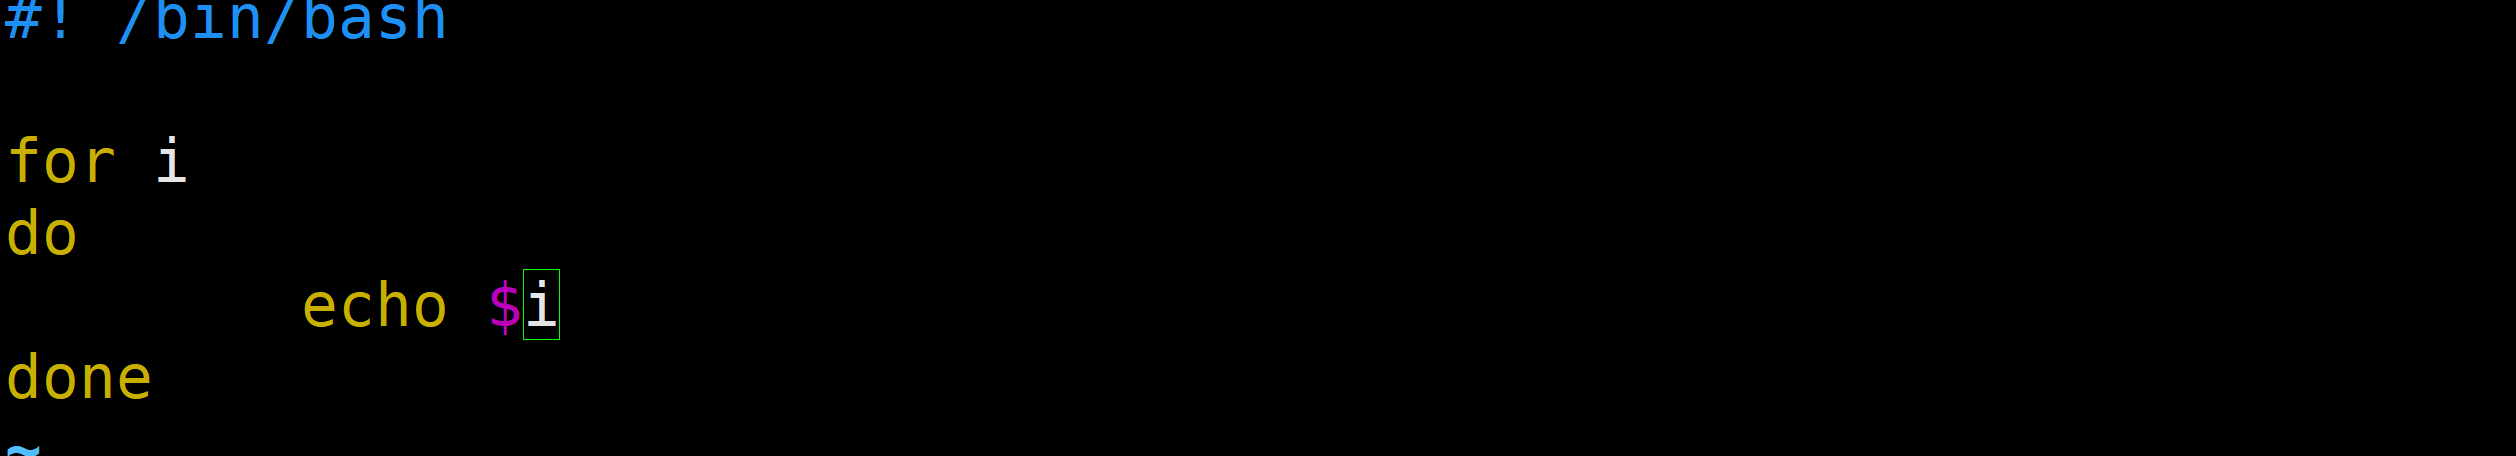
    不带列表的for循环执行时由用户指定参数和参数的个数,下面给出了不带列表的for循环的基本格式:1.sh 1 2 3

    for variable
        do
            command 
            command
            …
       done

    需求1:输出a,b,c,d几个字母
    file

    file

    1.4 类C循环

    类C风格的循环就是参照C语言的风格

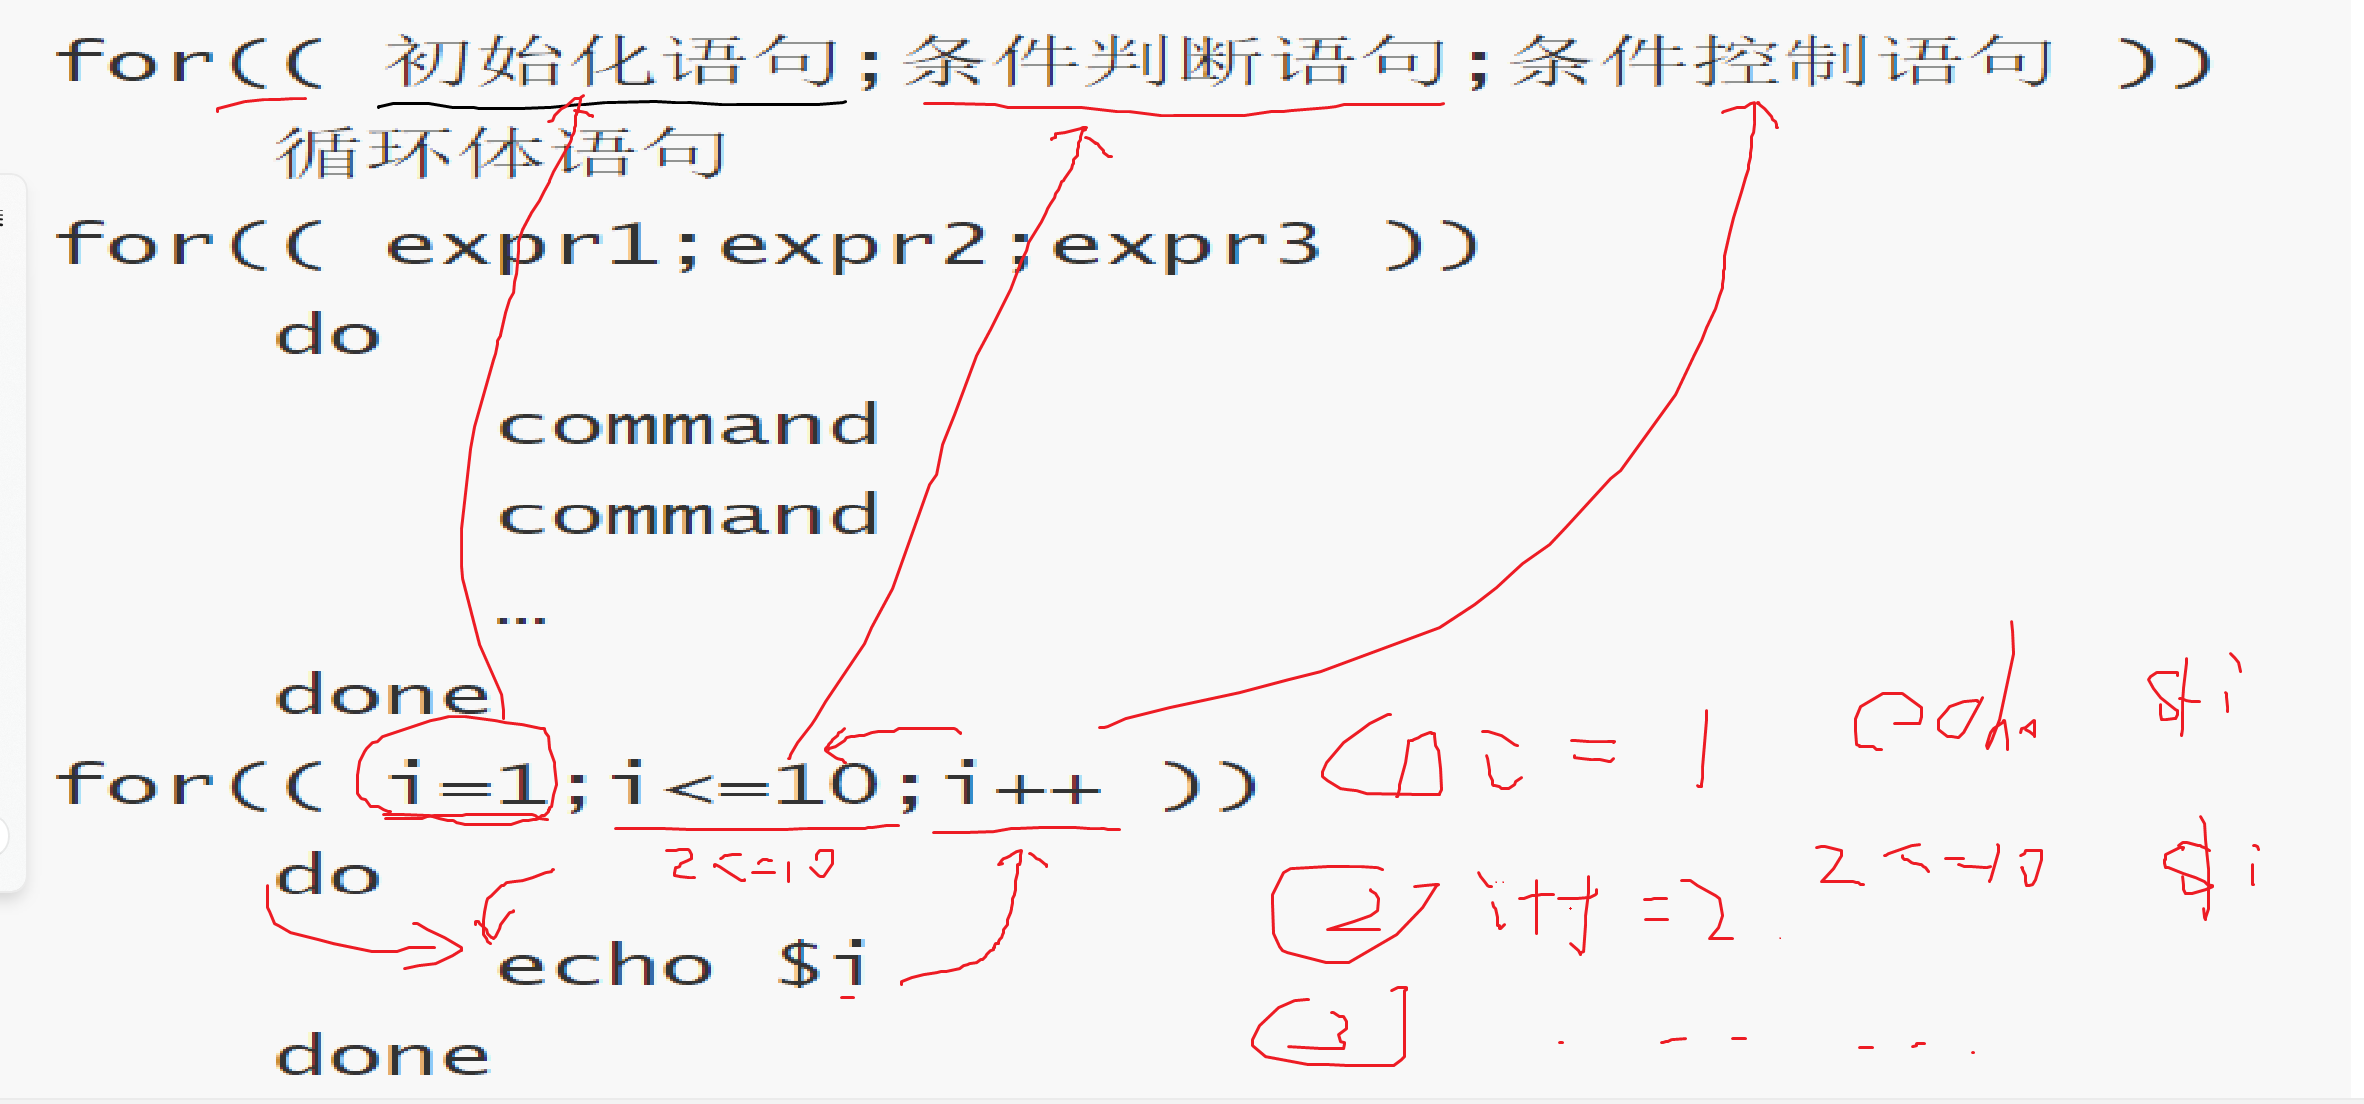
    for(( 初始化语句;条件判断语句;条件控制语句 ))
        循环体语句
    for(( expr1;expr2;expr3 ))
        do
            command
            command
            …
        done
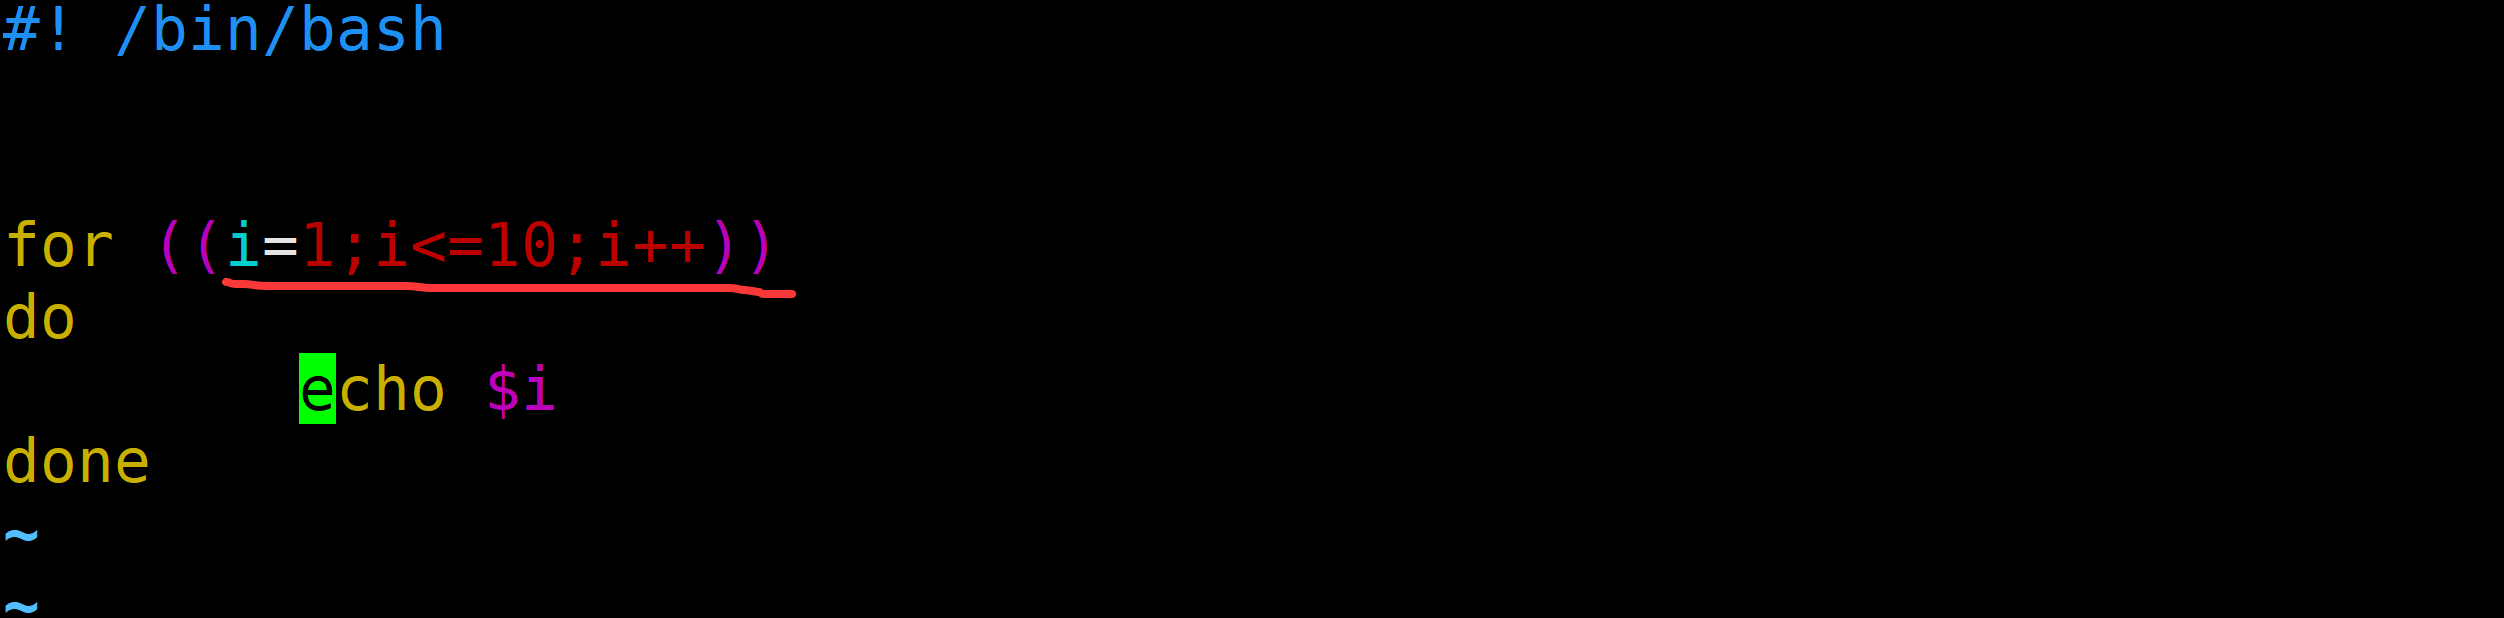
    for(( i=1;i<=10;i++ ))
        do
            echo $i
        done
    执行流程:
    ①执行初始化语句
    ②执行条件判断语句,看其结果是true还是false
    ​             如果是false,循环结束
    ​             如果是true,继续执行
    ③执行循环体语句
    ④执行条件控制语句
    ⑤回到②继续
    file

    需求:输出1-10之间的数字

    file

    1.5 课堂案例

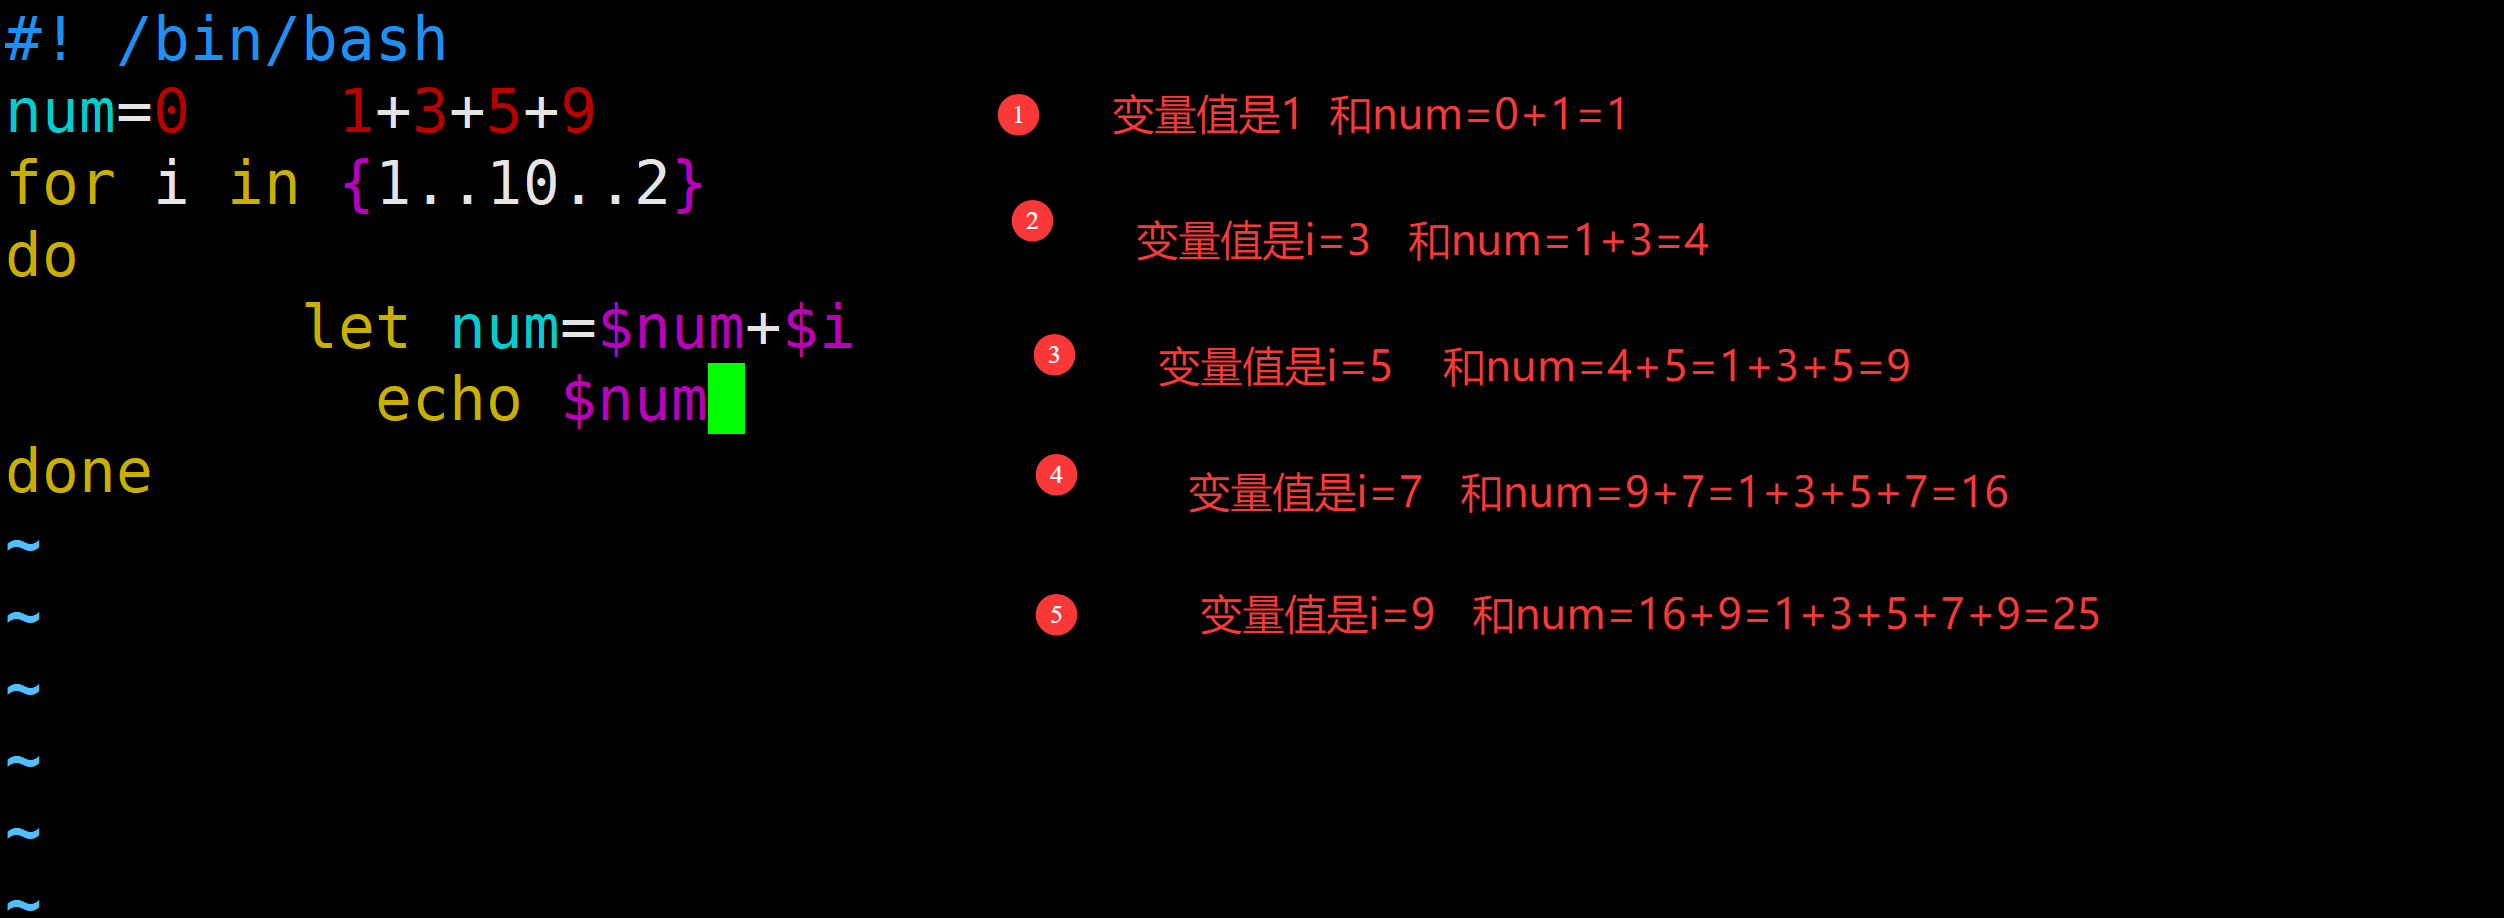
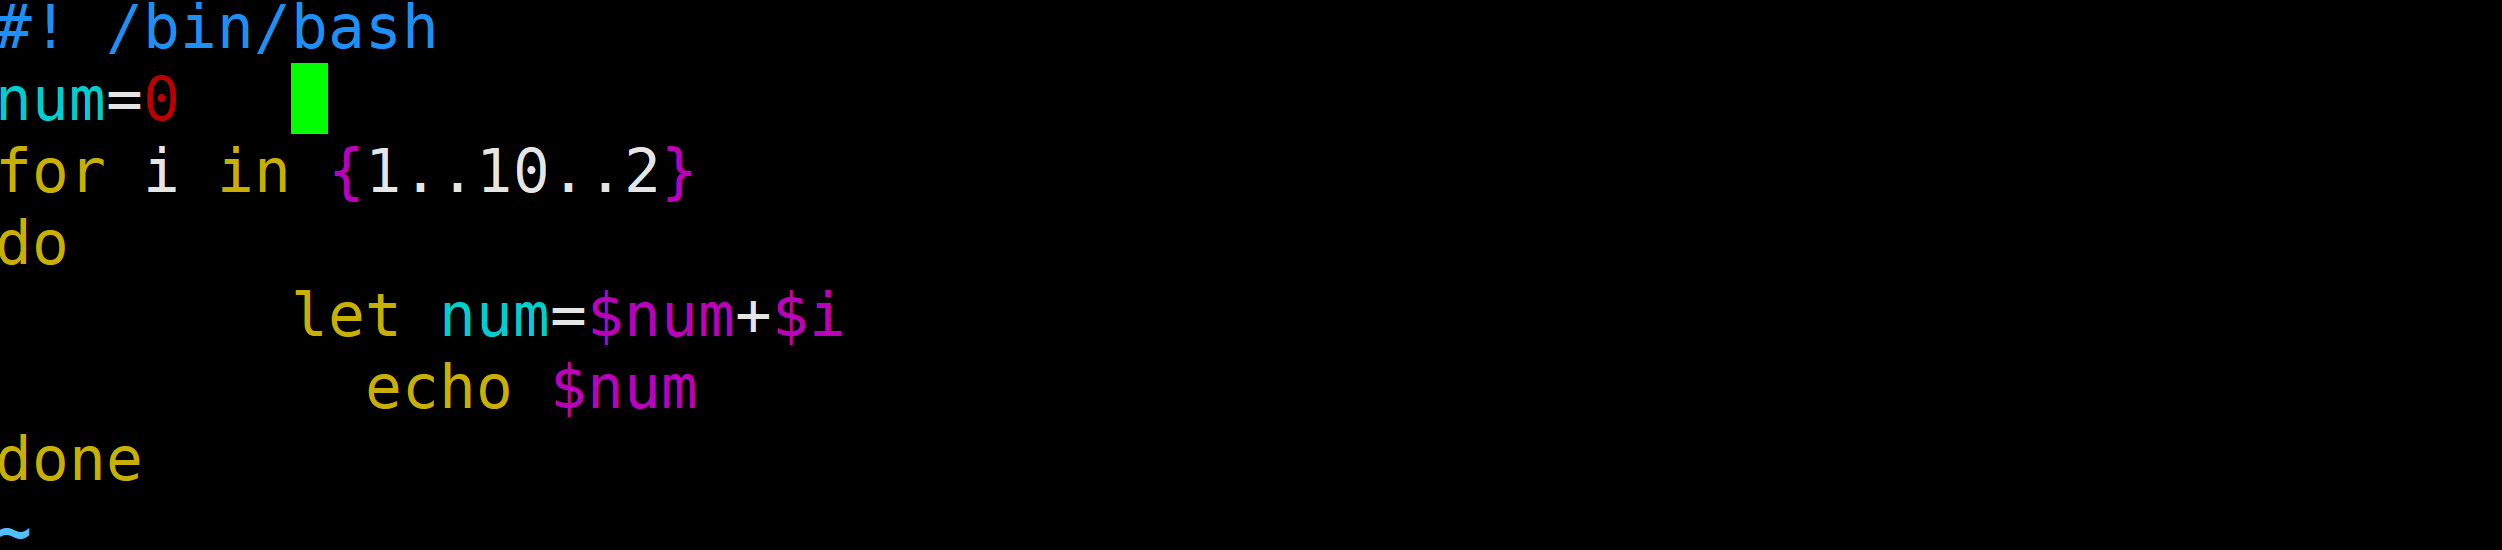
    需求1:计算1到10的奇数之和(重点)

    file

    file

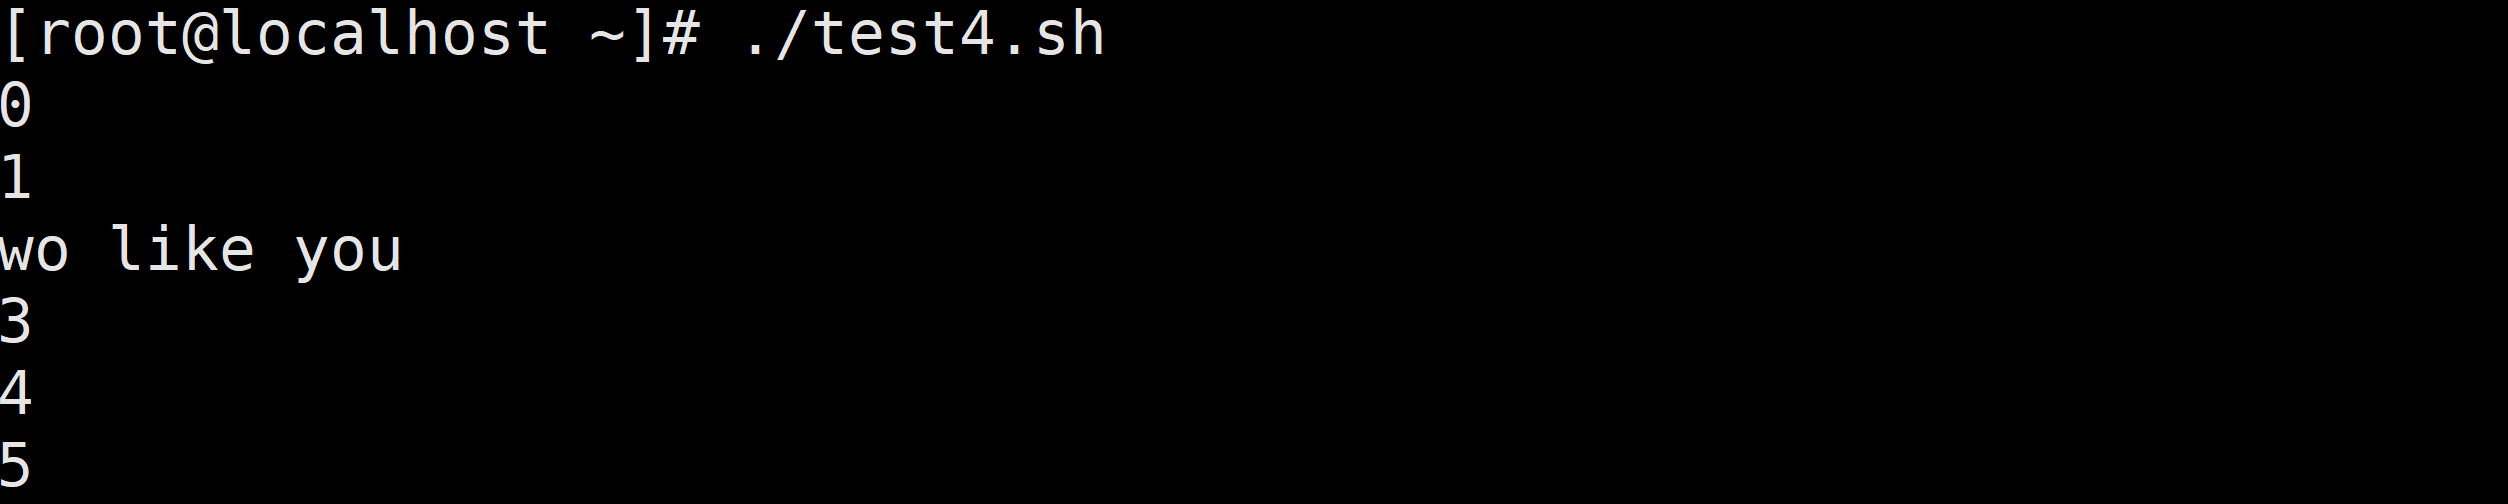
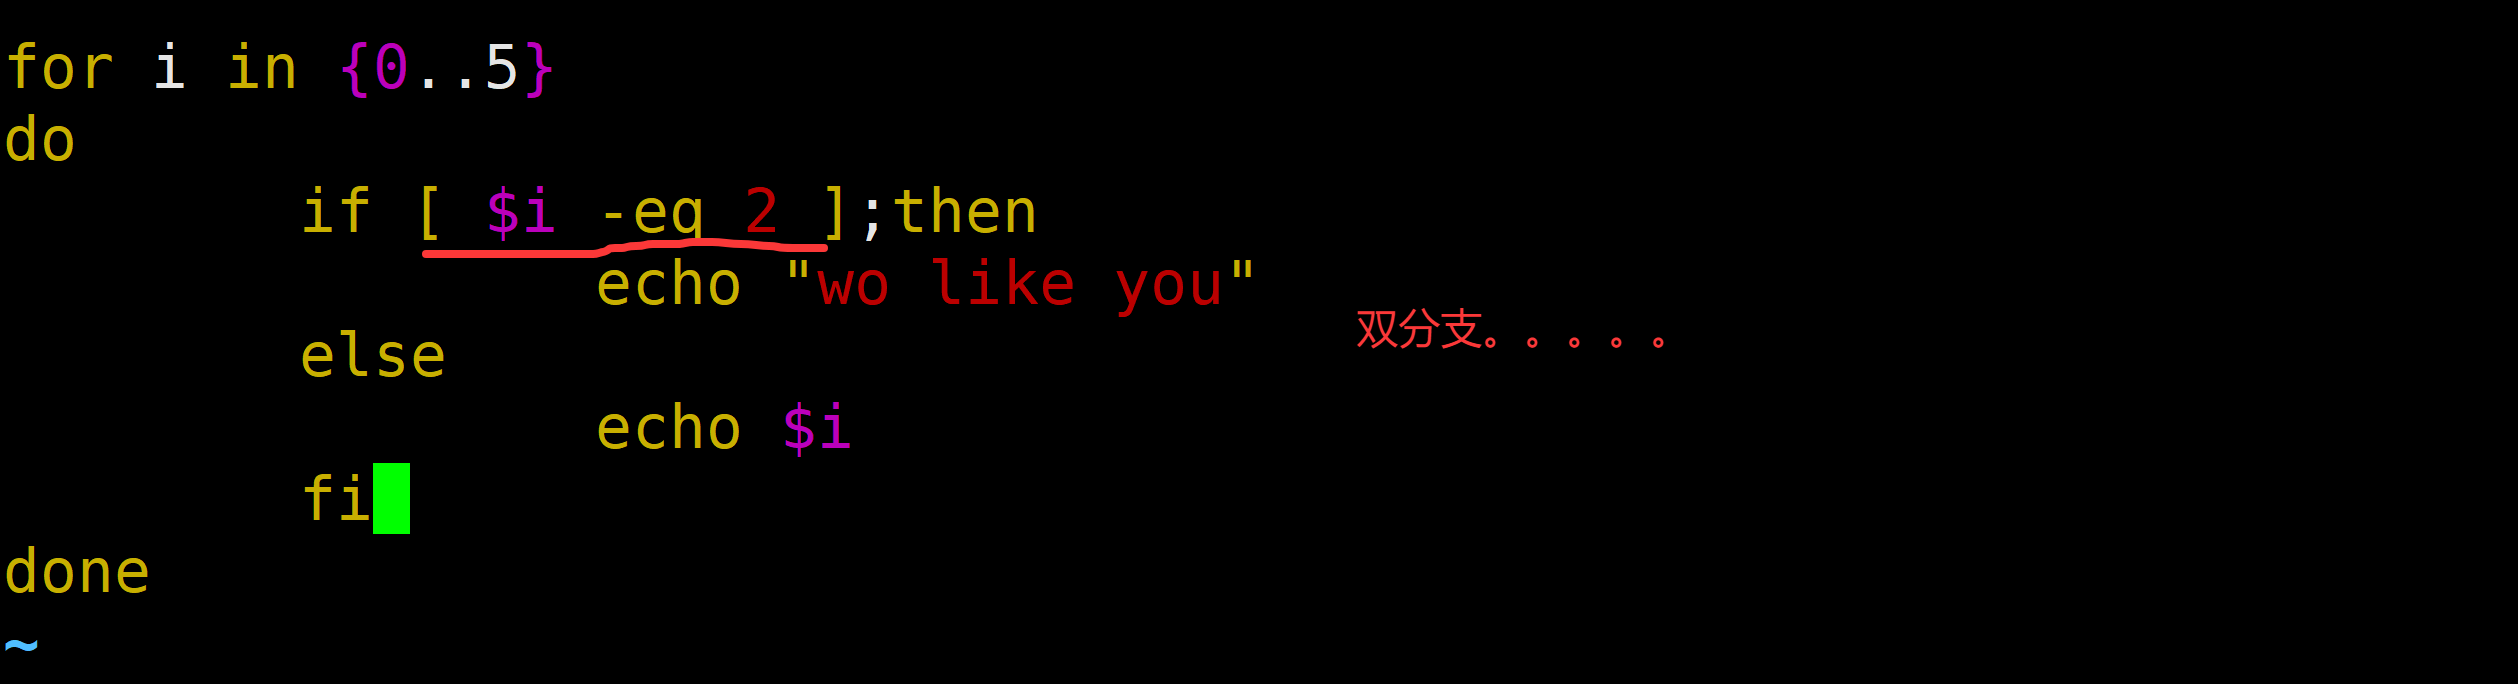
    需求2:输出0-5之间的数字,遇到2的时候,输出“我喜欢你”(就不打印2了)(重点)
    file

    file

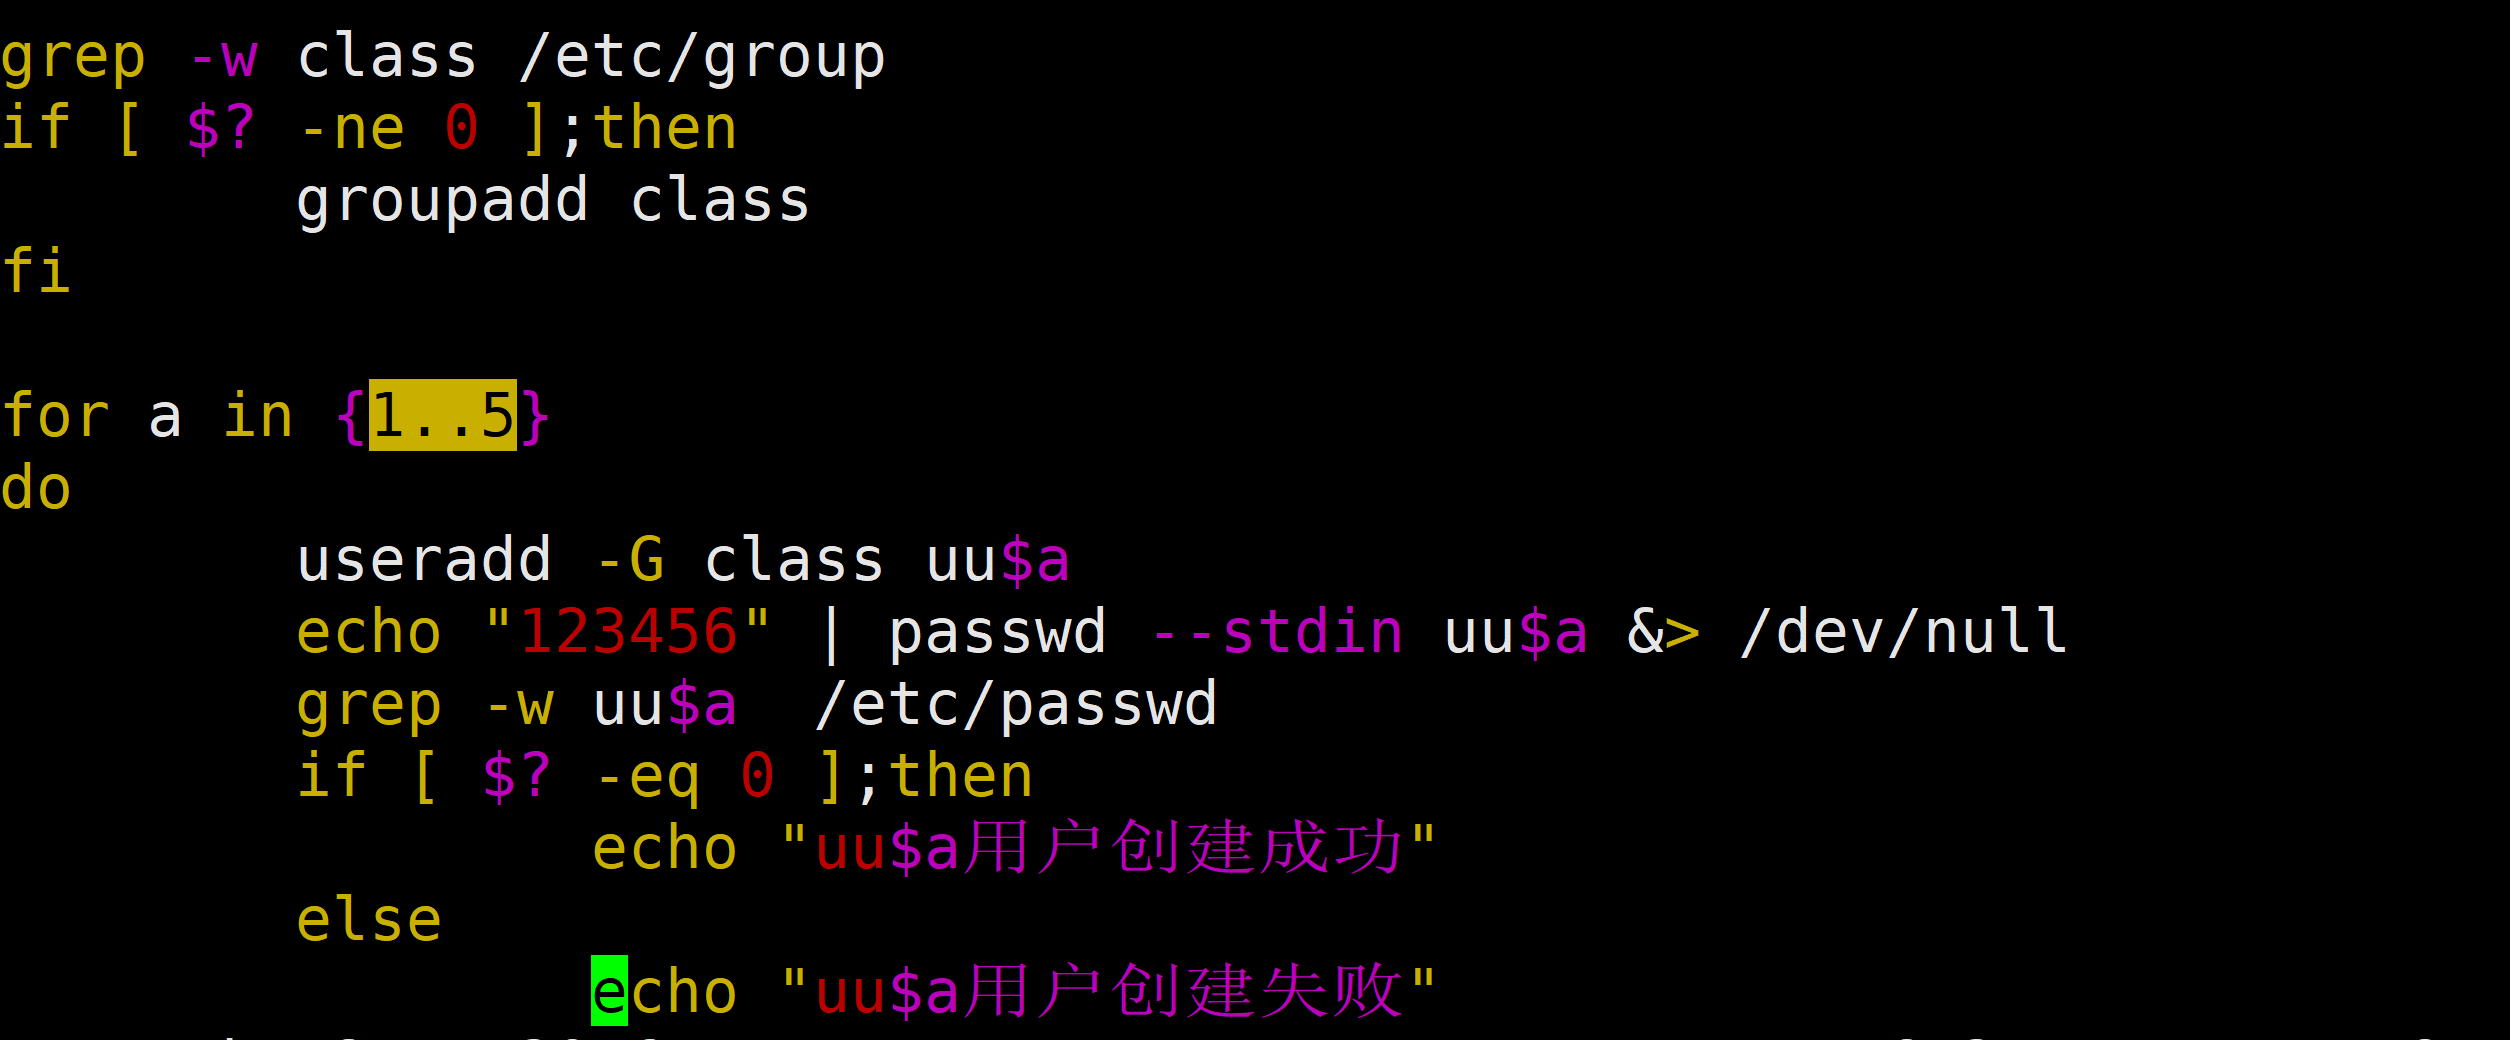
    需求3:批量加5个新用户,以u1到u5命名,并统一加一个新组,组名为class,统一改密码为123

    useradd -G class

    echo "123" > passwd --stdin

    file

    需求4:批量新建5个用户stu1~stu5,要求这几个用户的家目录都在/rhome.提示:需要判断该目录是否存在
    file

    需求5:写一个脚本,局域网内,把能ping通的IP和不能ping通的IP分类,并保存到两个文本文件里,这是一个局域网内机器检查通讯的一个思路(需要测试的IP缩小一下范围,只要测试10个IP即可),显示脚本运行的时间(执行脚本前加上time)

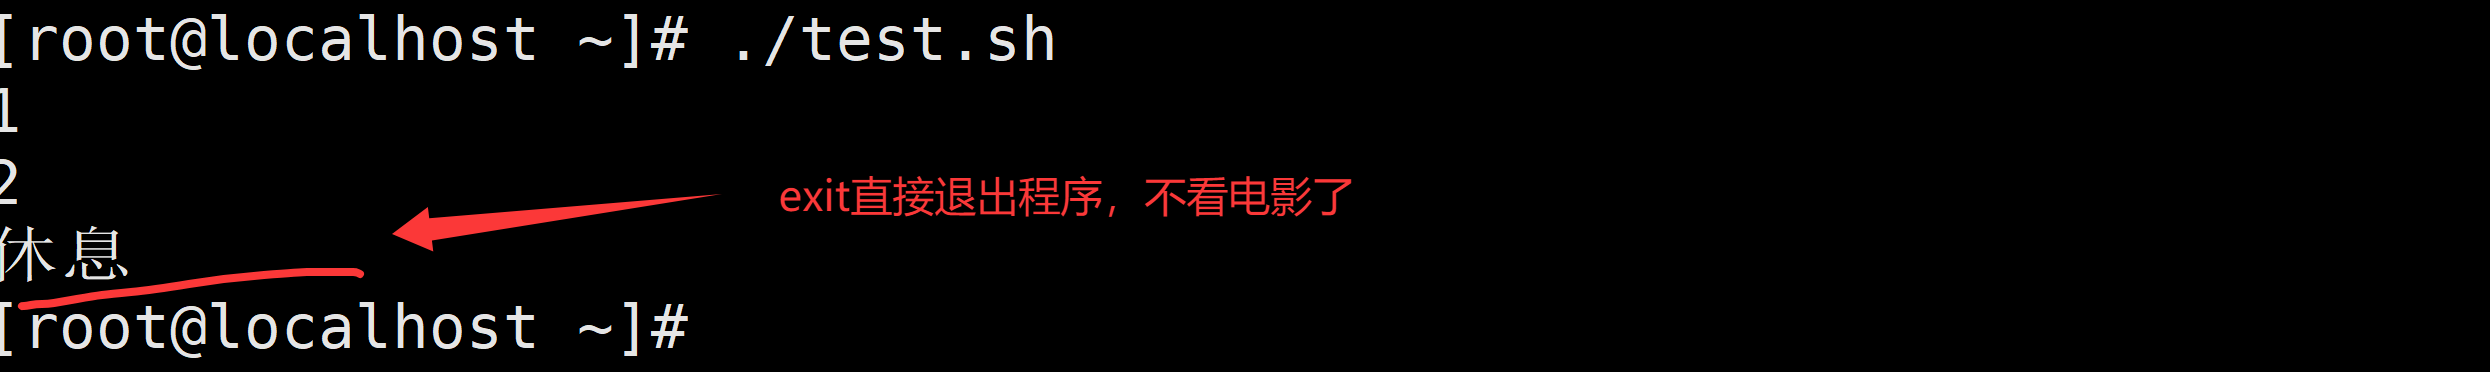
    9.循环控制(continue,break,exit)

    循环体: do….done之间的内容

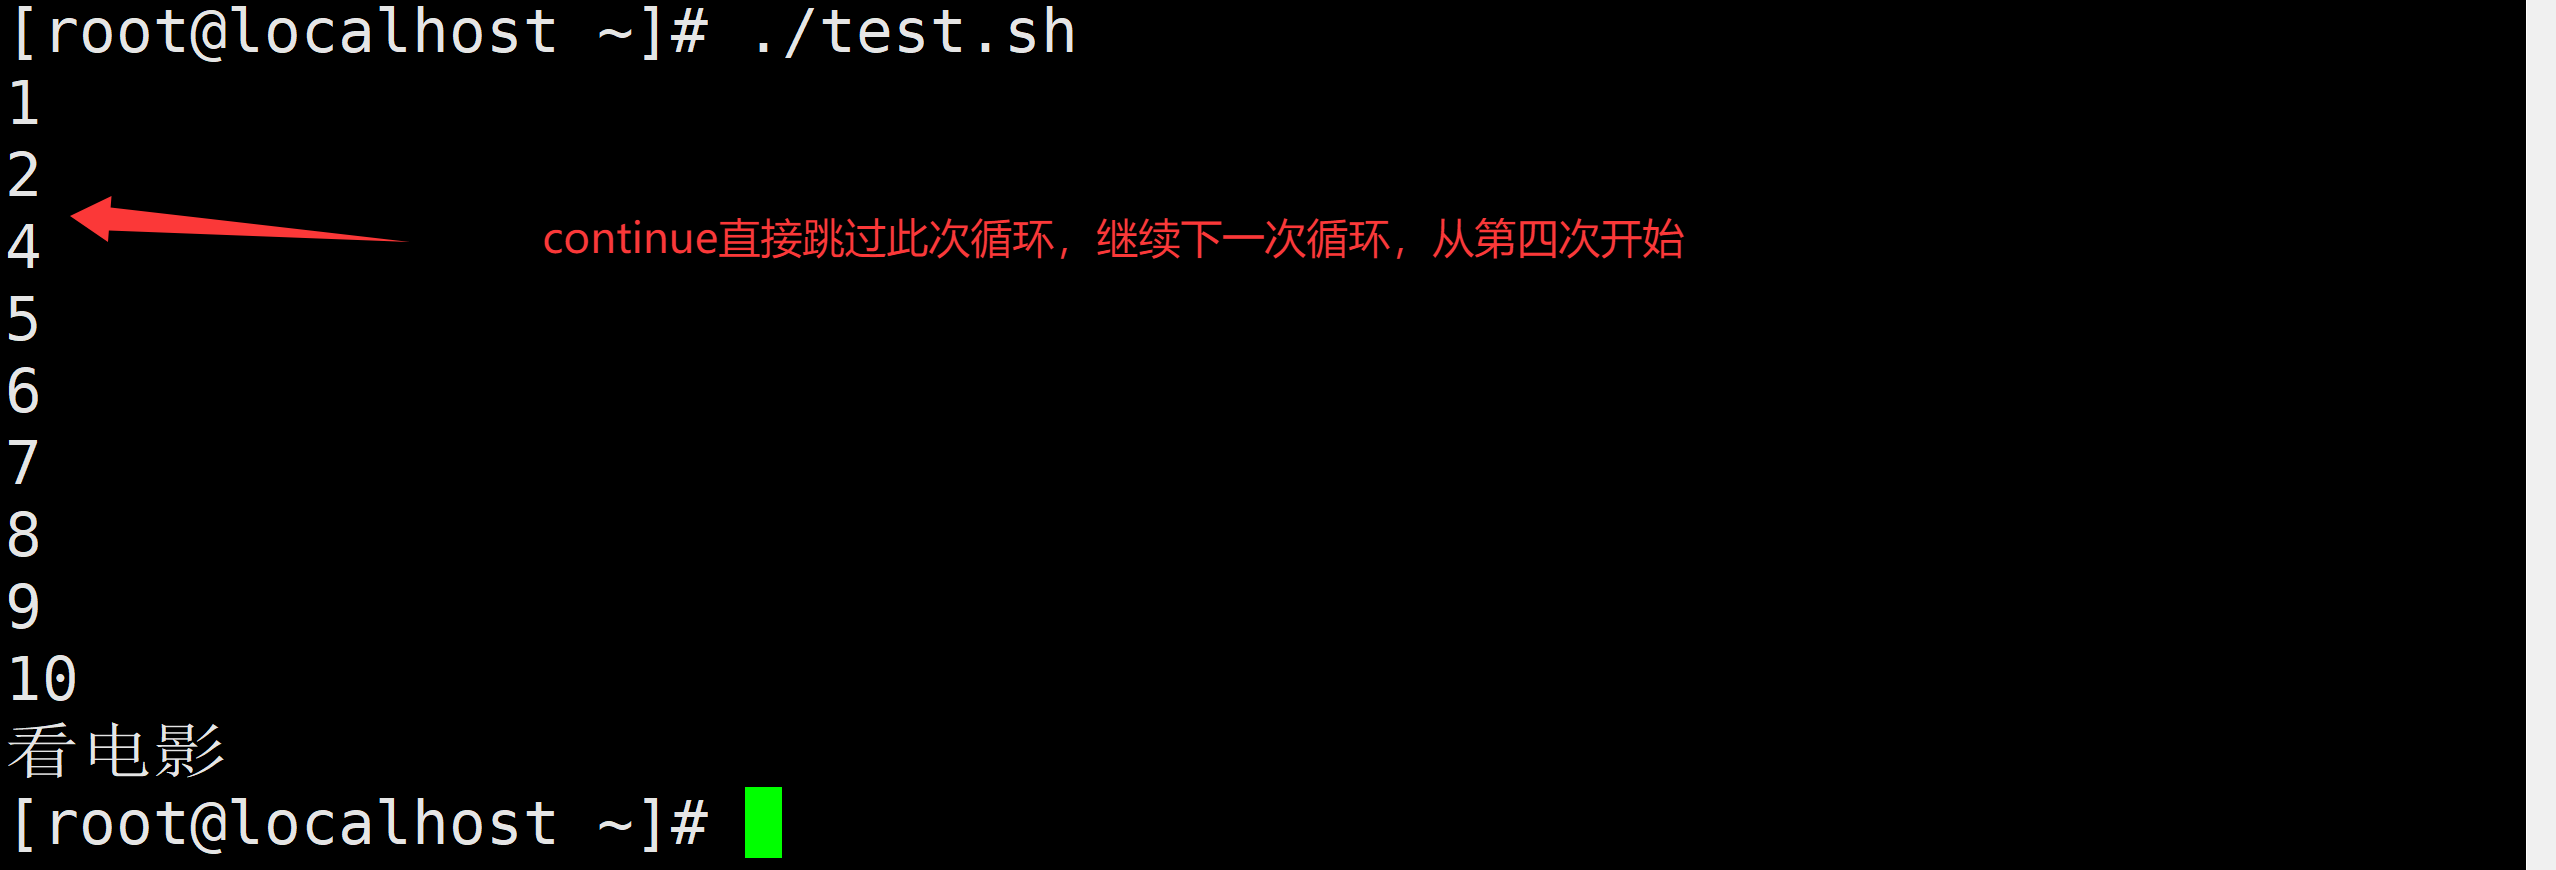
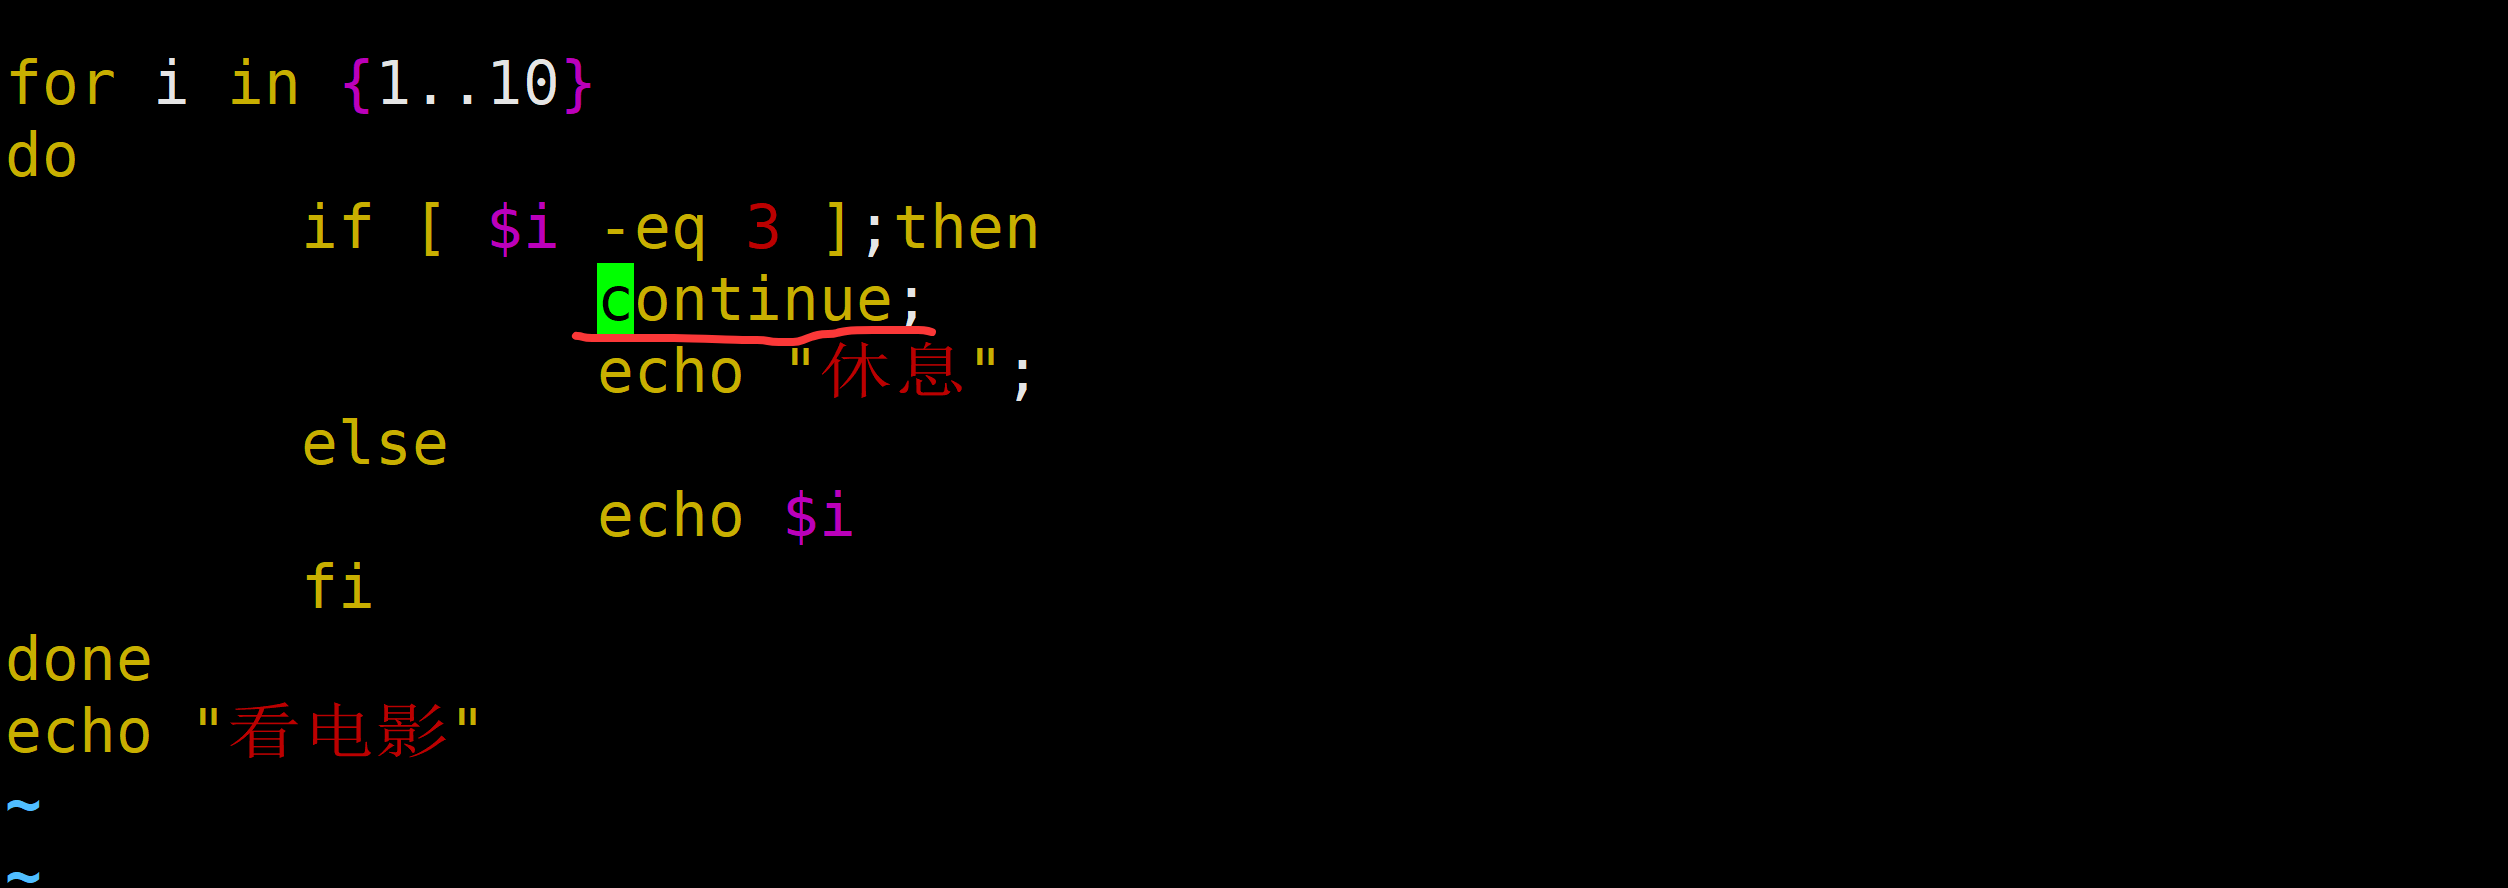
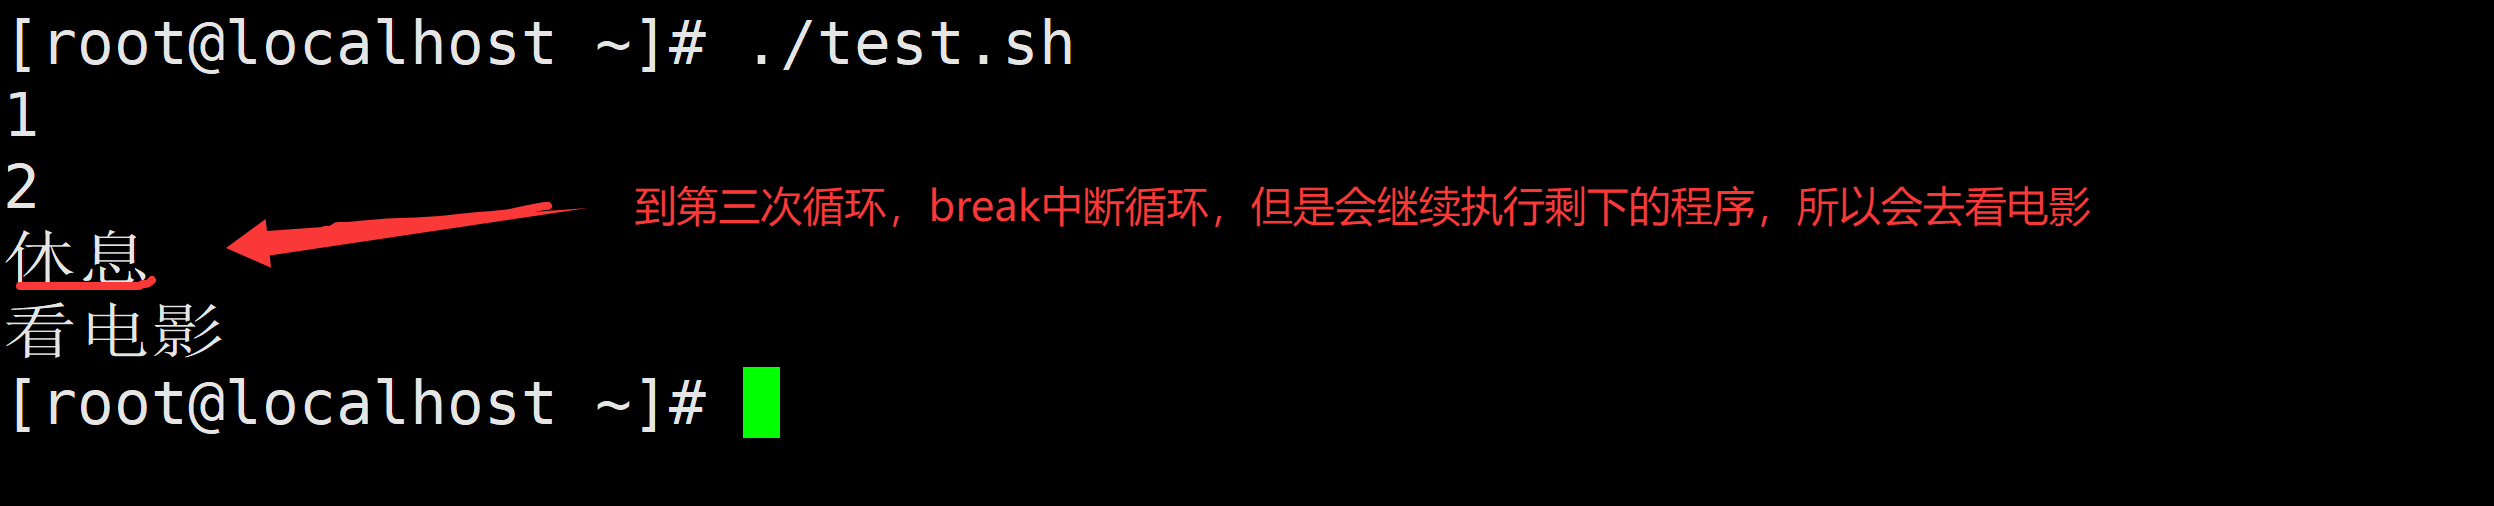
    • continue:继续;表示循环体内下面的代码不执行,重新开始下一次循环,跳过本次循环(本次循环体里面的代码不会执行)
    • break:打断;马上停止执行本次循环,执行循环体后面的代码,退出循环,循环结束
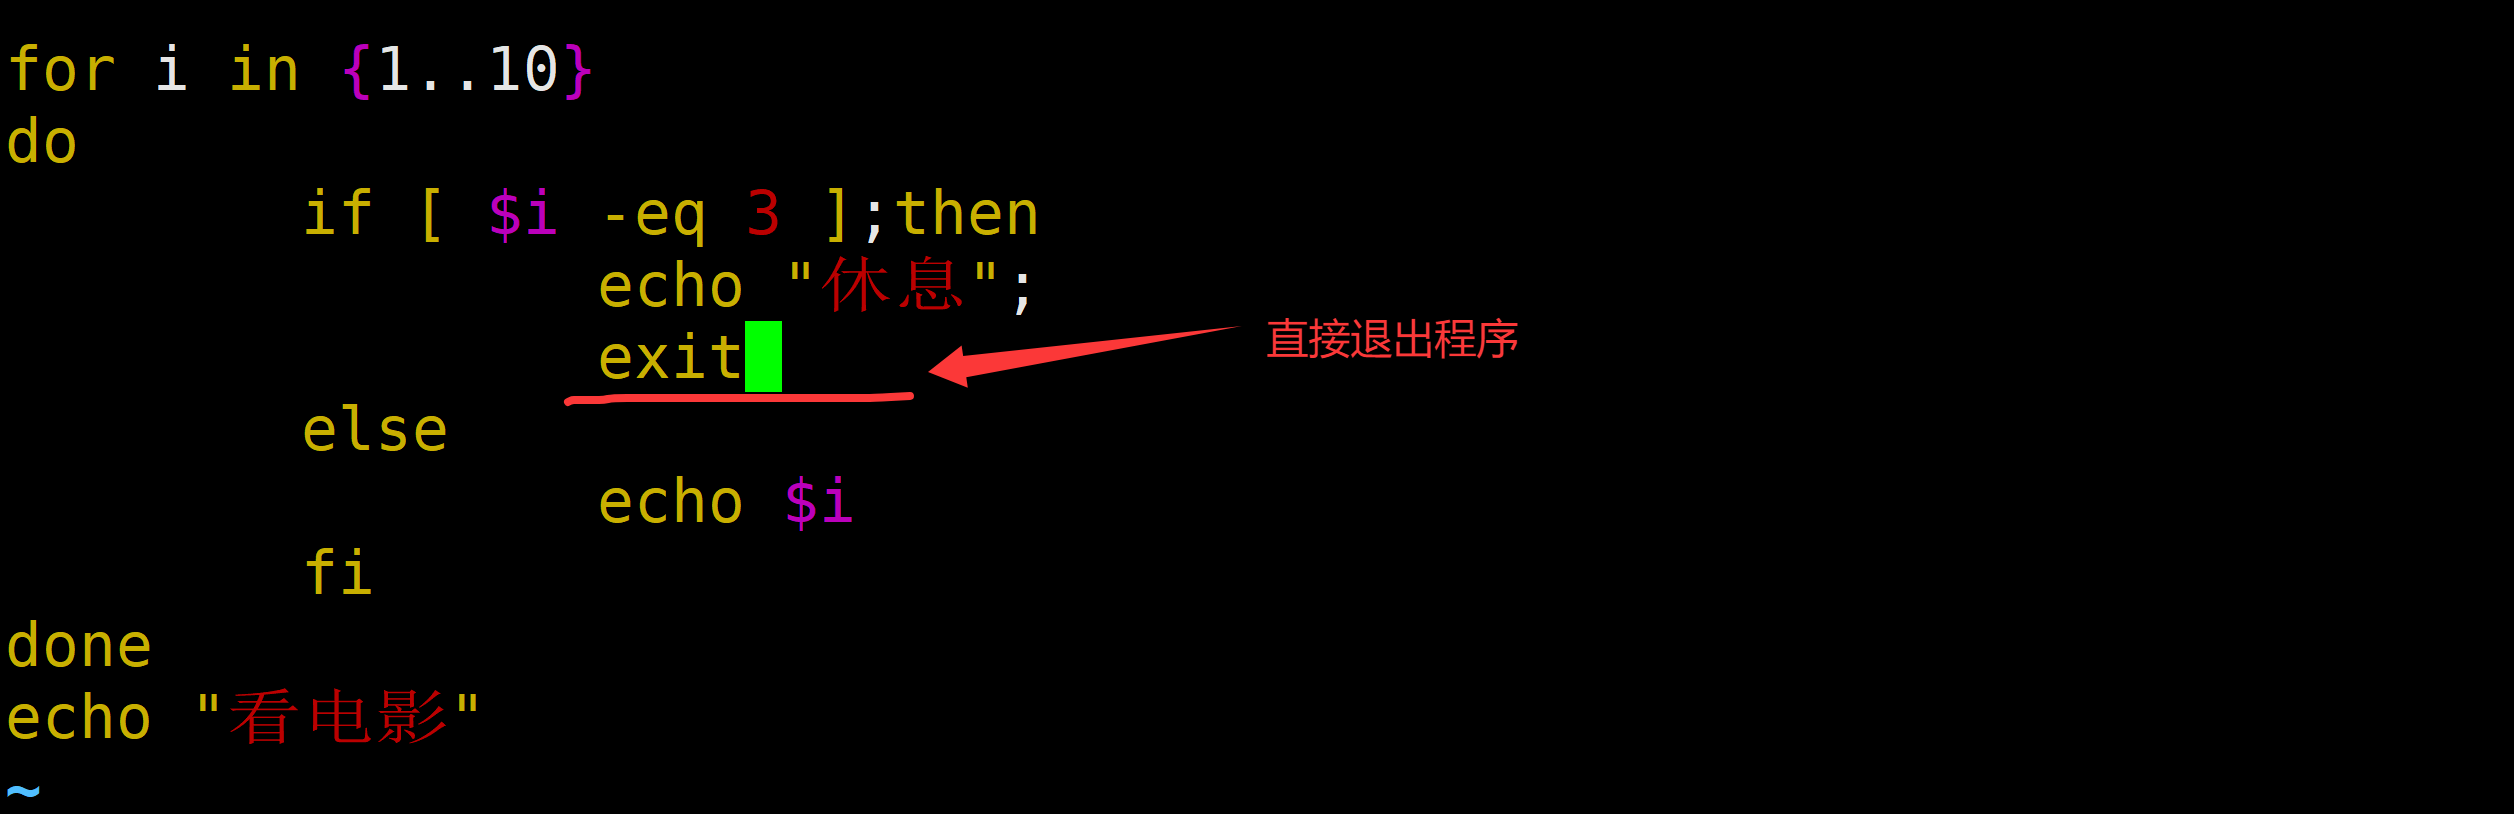
    • exit:表示直接跳出程序

    正常状态:

    file

    file

    需求:输出1-5之间的数字,遇到2的倍数的时候不打印,直接跳过

    #!/bin/bash
    
    for i in {1..5}
        do
            let temp=$i%2
            if [ $temp -eq 0 ];then
                    continue
                else
                    echo $i
            fi
        done
    echo "哈哈,程序终于执行完了"

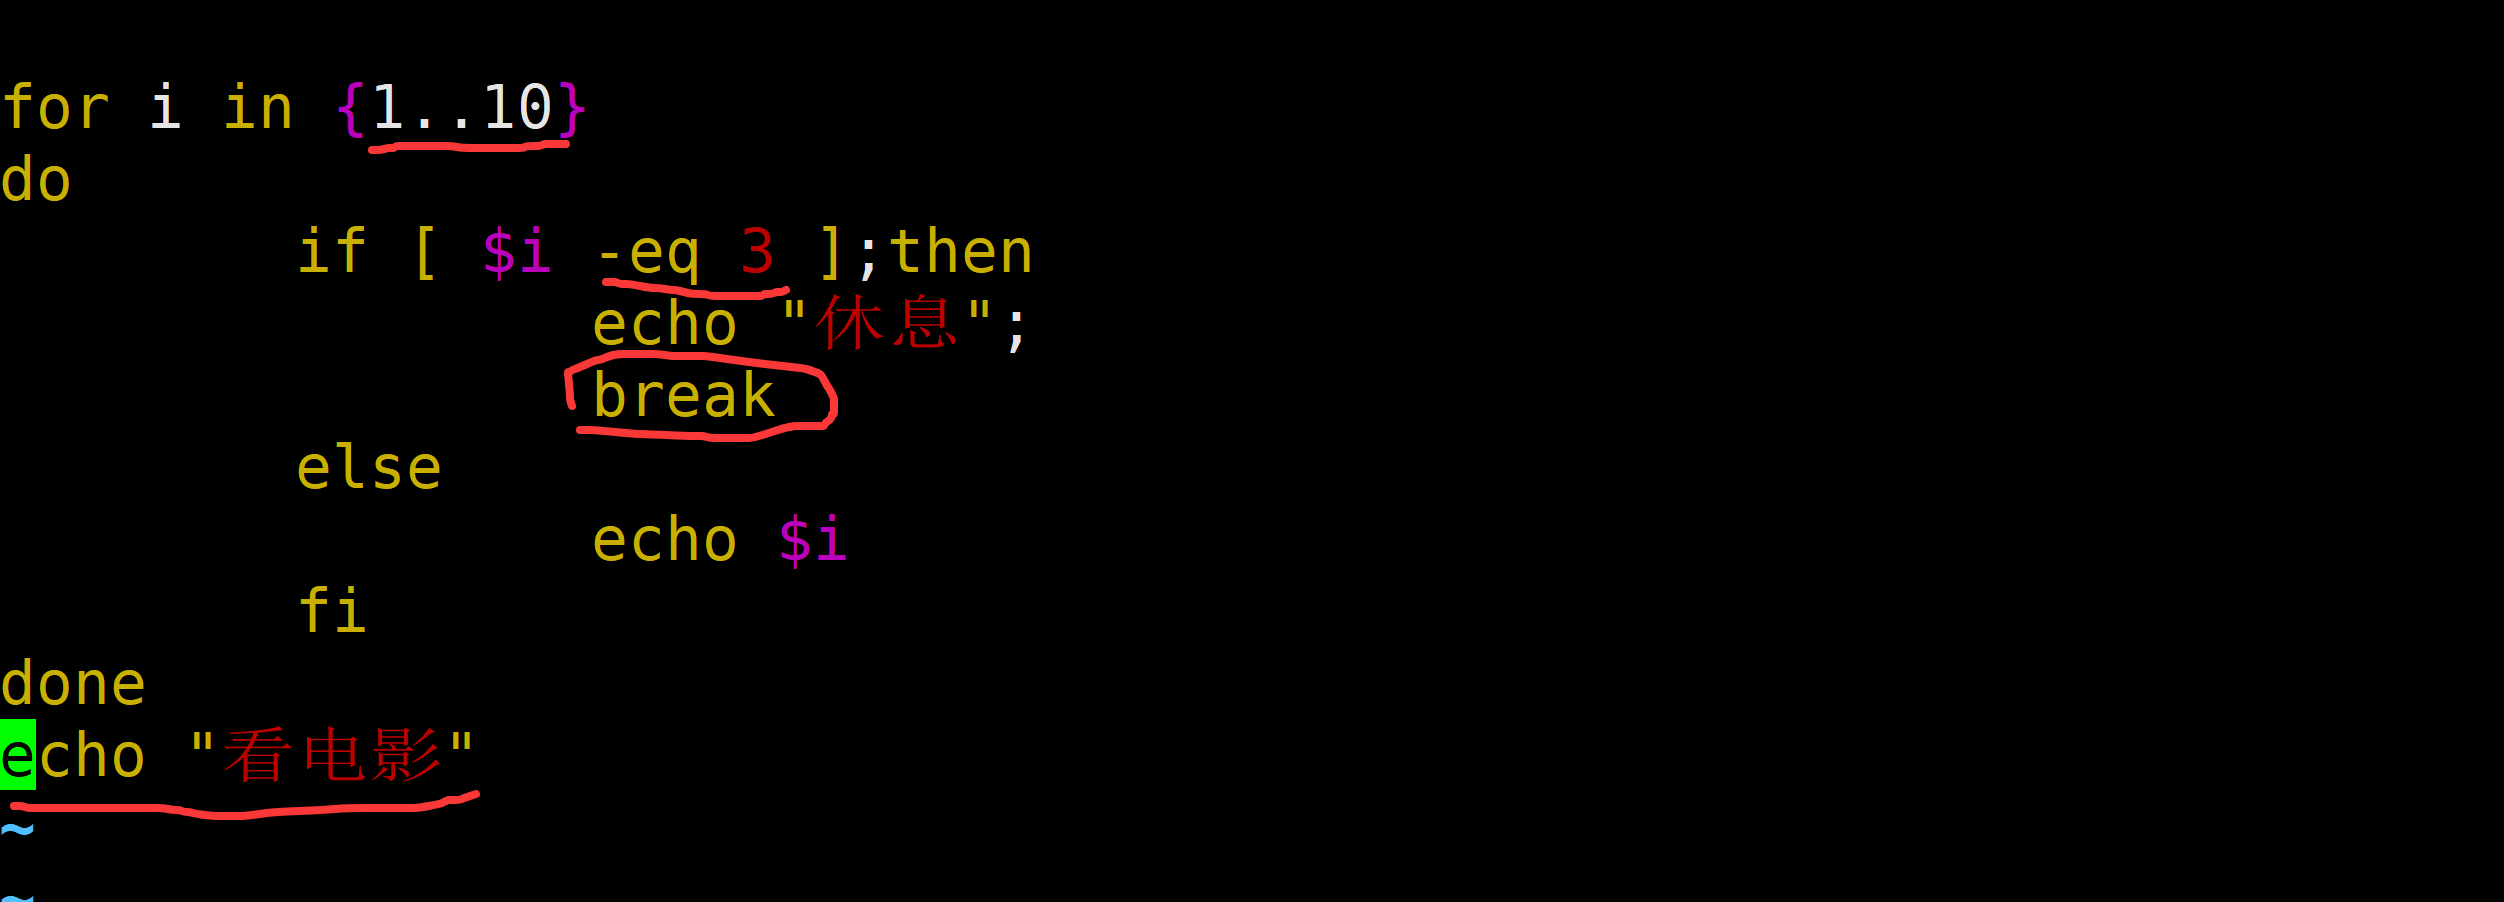
    需求:输出1-5之间的数字,遇到3的倍数的时候,直接结束循环

    #!/bin/bash
    for i in {1..5}
        do
            let temp=$i%3
            if [ $temp -eq 0 ];then
                    break
                else
                    echo $i
            fi
        done
    echo "哈哈,程序终于执行完了"
    file

    file

    需求:输出1-5之间的数字,遇到4的倍数的时候,直接退出程序

    #!/bin/bash
    for i in {1..5}
        do
            let temp=$i%3
            if [ $temp -eq 0 ];then
                    exit
                else
                    echo $i
            fi
        done
    echo "哈哈,程序终于执行完了"
    file

    file

    课堂练习:

    需求:输出0-5之间的数字,遇到2的倍数的时候不打印,直接跳过
    需求:输出0-5之间的数字,遇到3的倍数的时候,直接结束循环
    需求:输出0-5之间的数字,遇到4的倍数的时候,直接退出程序

    小结

    - for循环语法结构
    - for循环可以结合条件判断和流程控制语句
      - do ......done  循环体
      - 循环体里可以是命令集合,再加上条件判断以及流程控制
    - 控制循环语句
      - continue  继续,跳过本次循环,继续下一次循环
      - break   打断,跳出循环,执行循环体外的代码
      - exit       退出,直接退出程序

    10.cut命令

    1)概述

    cut 命令用于从文件或标准输入中提取指定字段或字符位置的数据。它可以根据字段的分隔符将每行数据分割成多个字段,并选择需要提取的字段进行输出。cut 命令是一个简单而实用的工具,常用于处理文本文件中的数据。

    2)语法

    cut [选项]... [文件]...
    -c:    以字符为单位进行分割
    -d:    自定义分隔符,默认为制表符
    -f:    与-d一起使用,指定显示哪个区域
    # cut -d: -f1 1.txt                         以:冒号分割,截取第1列内容
    # cut -d: -f1,6,7 1.txt                     以:冒号分割,截取第1,6,7列内容
    # cut -c4 1.txt                             截取文件中每行第4个字符
    # cut -c1-4 1.txt                             截取文件中每行的1-4个字符
    # cut -c4-10 1.txt                             截取文件中每行的4-10个字符
    # cut -c5- 1.txt                             从第5个字符开始截取后面所有字符                   

    3)使用

    需求:使用cut工具获取passwd文件中,只显示名称与UID,显示前五行
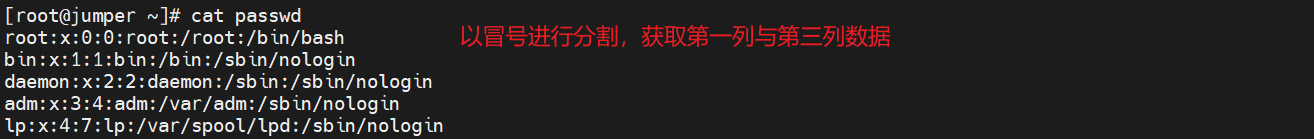
    file

    cd
    cp /etc/passwd ./
    cut -d: -f1,3 passwd | head -5
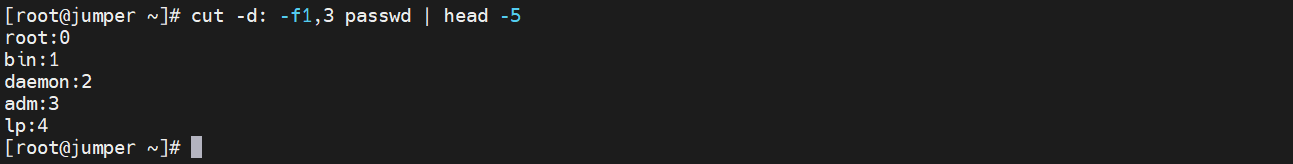
    file

    11.while循环

    11.1 语法结构

    特点:条件为真就进入循环;条件为假就退出循环

    while 条件表达式
        do
            command...
        done

    示例

    i=1
    while [ $i -le 5 ]
    do
        echo $i
        let i++
    done

    11.2课堂案例

    需求1:使用while循环打印1-10之间的数字
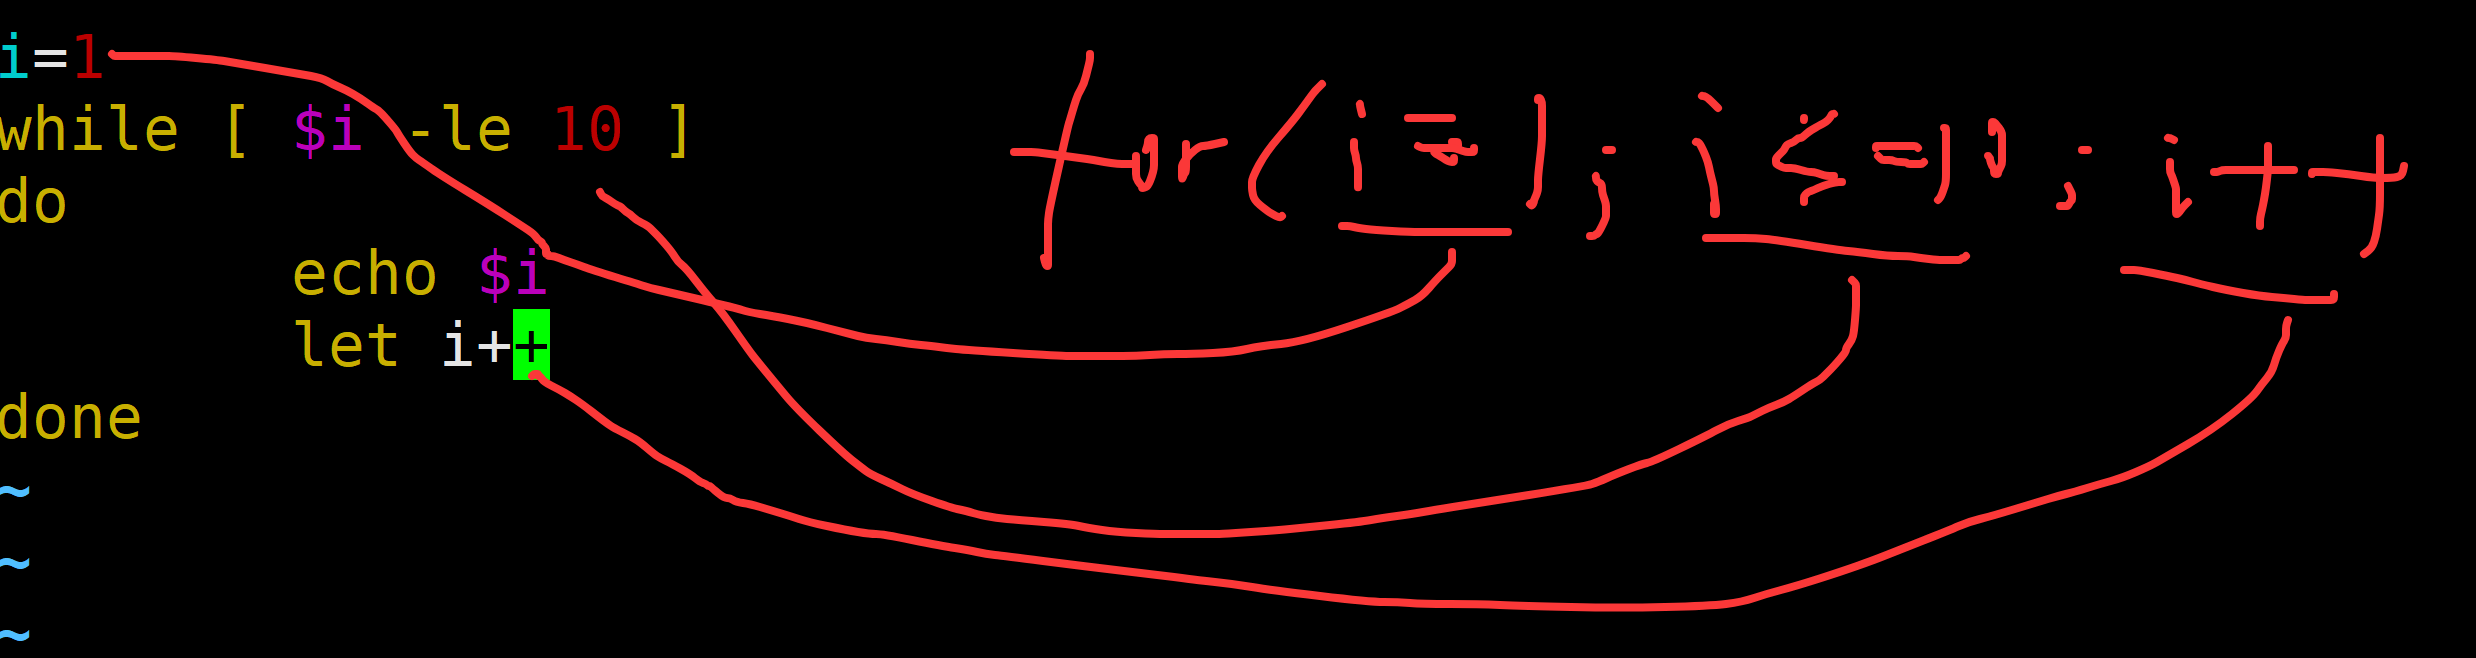
    file

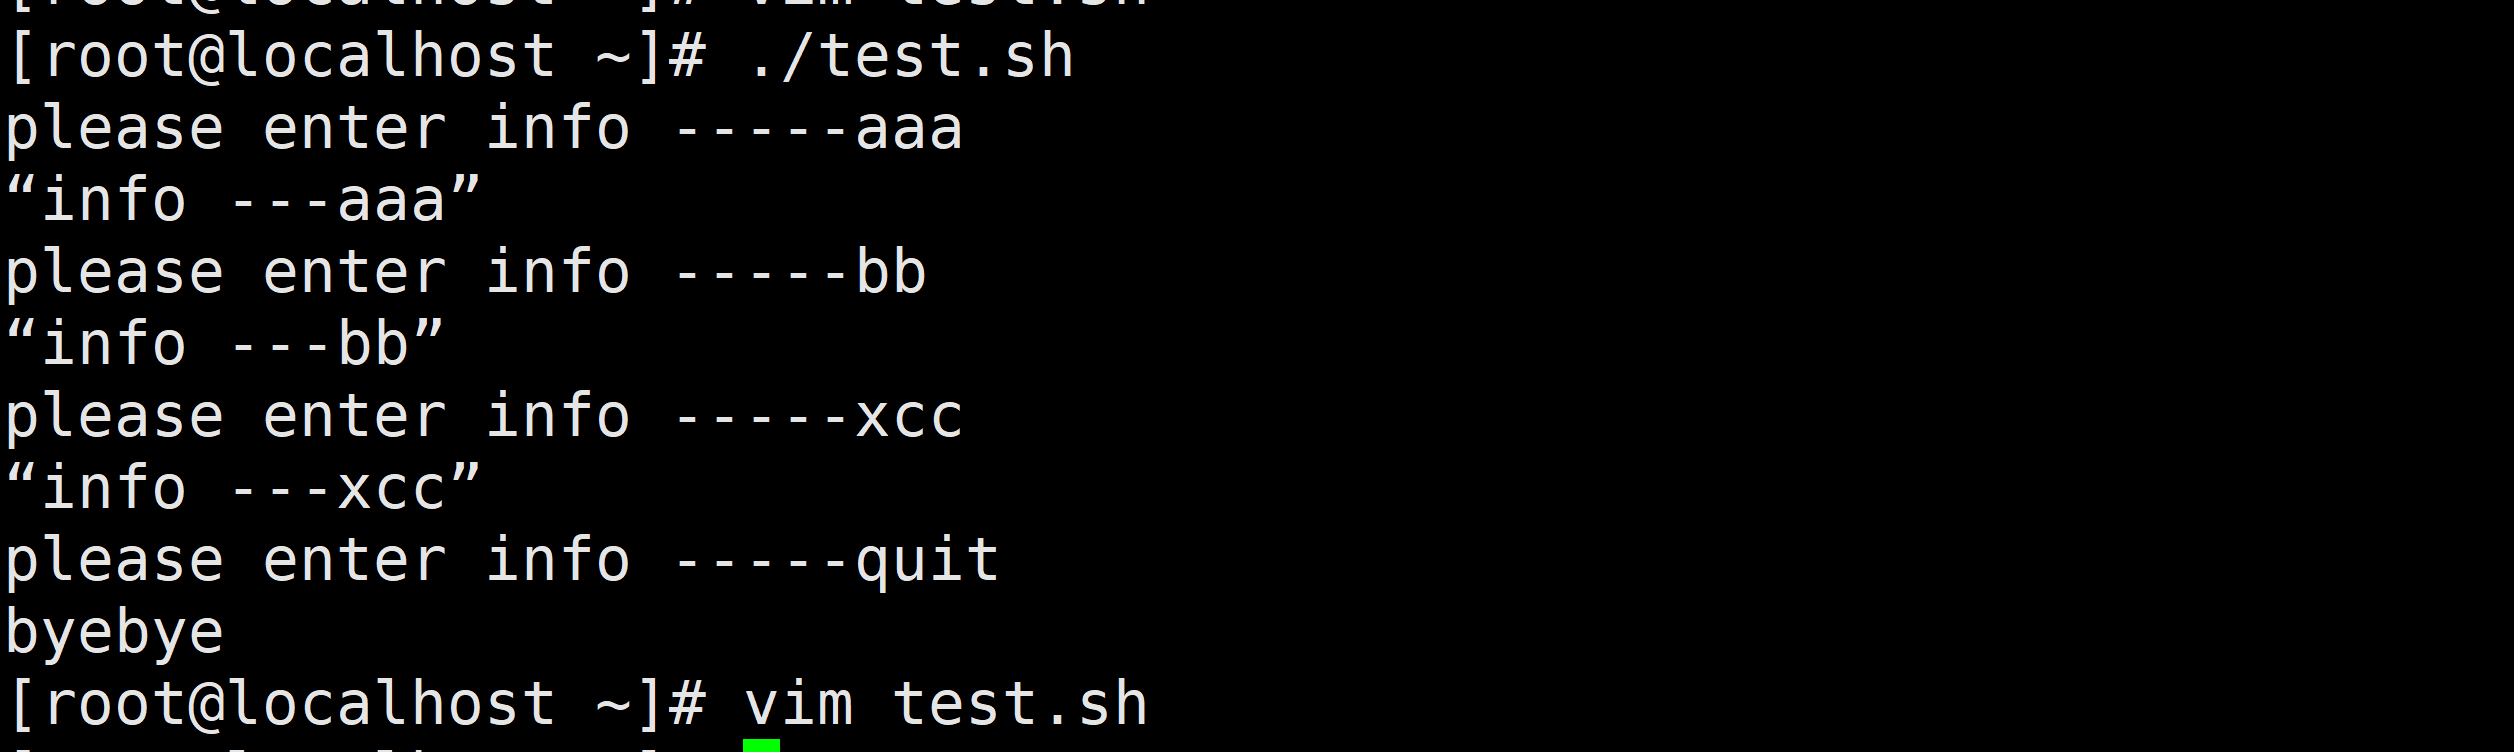
    需求2:获取用户输入的字符,用户输入什么,就打印什么,直到用户输入的是quit,则退出程序
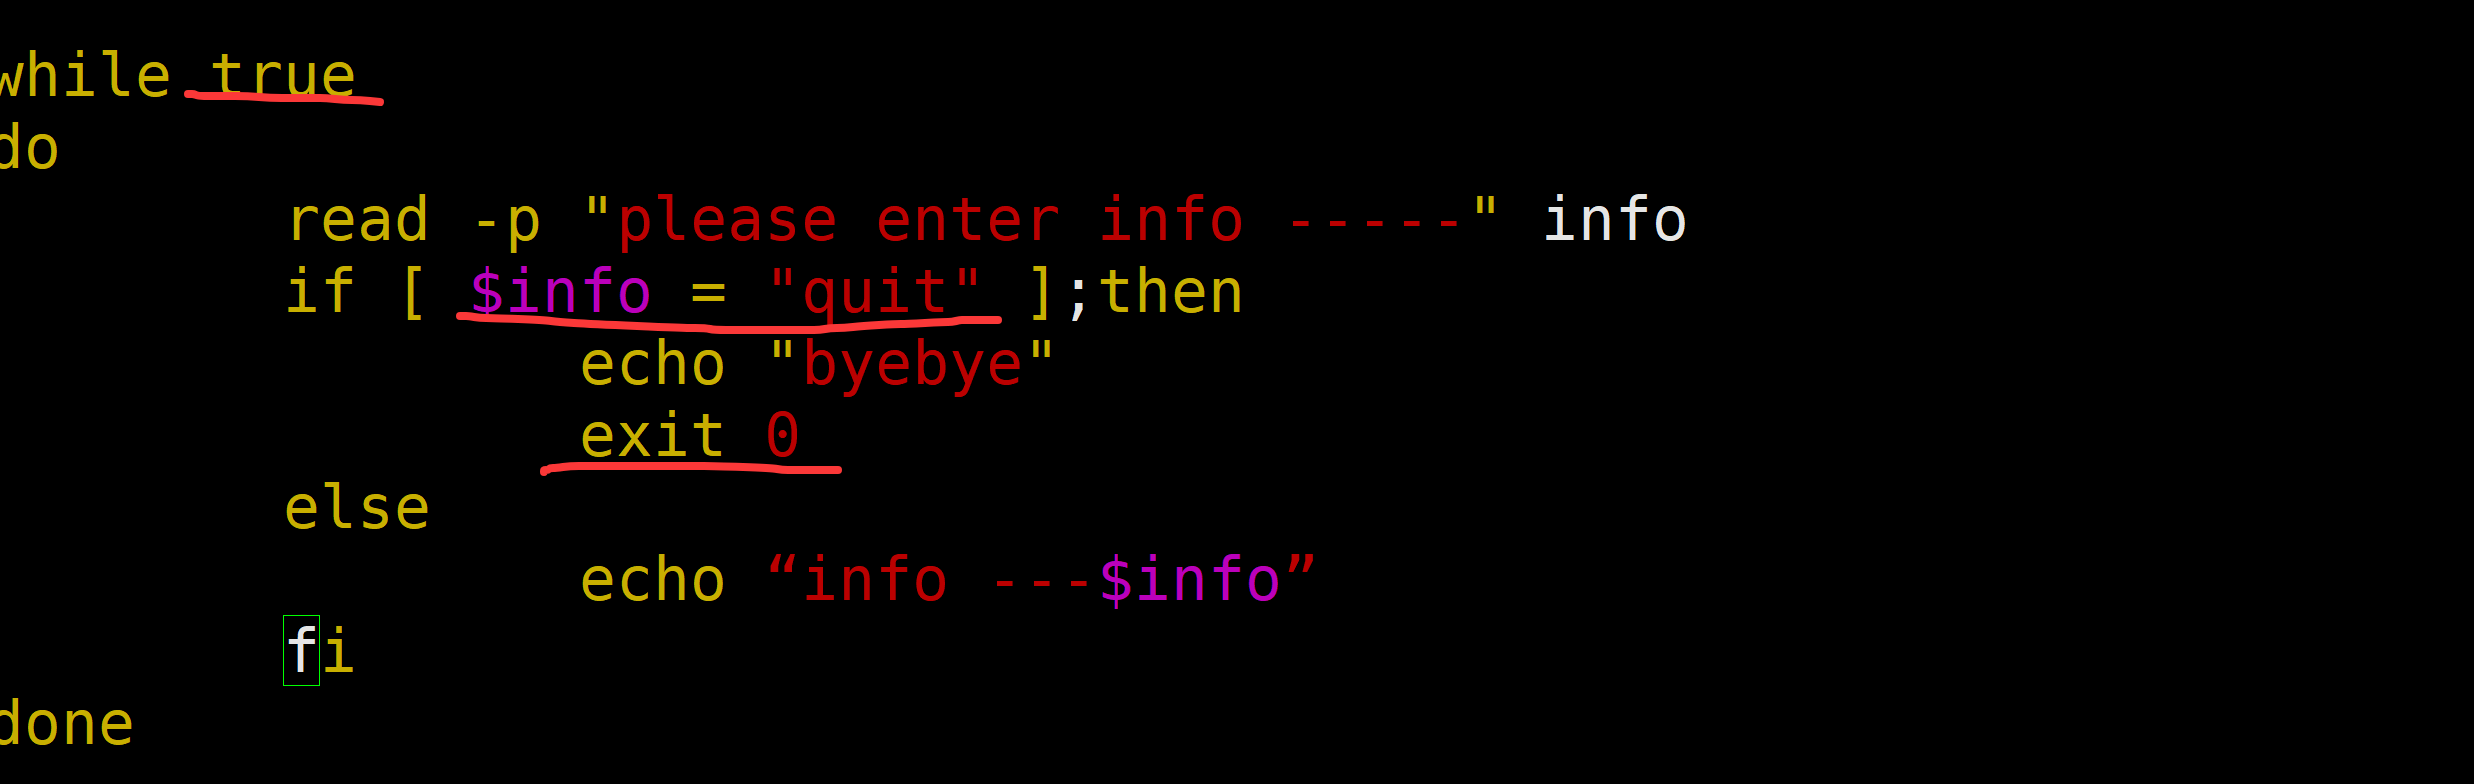
    file

    运行结果:

    file

    #!/bin/bash
    i=1
    while [ $i -le 10 ]
    do
        echo $i
        let i++
    done
    
    #!/bin/bash
    i=10
    while [ $i -ge 1 ]
    do
        echo $i
        let i--
    done
    
    #!/bin/bash
    i=1
    while [ $i -le 10 ]
    do
        if [ $[ $i%2 ] -eq 0 ];then
            let i++
            continue
        fi
        echo $i
        let i++
    done
    
    #!/bin/bash
    i=1
    while [ $i -le 10 ]
    do
        echi $i
        let i++
    done
    
    需求2:获取用户输入的字符,用户输入什么,就打印什么,直到用户输入的是quit,则退出程序
    #! /bin/bash
    echo “输入内容,直到quit退出-----”
    while true 
    do
            read info
            if [ $info = "quit" ];then
                    echo "byebye"
                    exit 0
            else
                    echo $info
            fi
    done
    
    在 Shell 脚本中,exit 0 是一个用于终止脚本执行并返回状态码的命令。
     0 是返回给父进程的状态码,表示脚本成功执行(约定俗成的 “成功” 状态)。

    需求2:写一个30秒同步一次时间,向同步服务器cn.ntp.org.cn同步时间,如果同步失败,则进行邮件报警,每次失败都报警;同步成功,也进行邮件通知,但是成功100次才通知一次。

    ntpdate cn.ntp.org.cn 同步时间操作

    echo “邮件内容” | mail -s “邮件主题” root@server

    #!/bin/bash
    # 定义一个计数器,用于统计时间同步成功的次数
    count=0
    # 时间同步时间是一直需要进行的,所以需要写一个死循环,每次同步时间间隔30秒,休眠30秒即可
    while [ 1 -eq 1 ]
    do
        # 同步时间操作
        ntpdate cn.ntp.org.cn
        if [ $? -eq 0 ];then
                # 同步成功,count的次数要加1
                let $count++
                # 同步成功还要看是否达到100次,或者100的倍数次
                if [ $[ $count%3 ] -eq 0 ];then
                    # 发送邮件
                    echo "$(date "+%Y-%m-%d-%H:%M:%S")同步成功100次,发送邮件操作" | mail -s "时间同步" root@server
                fi
            else
                echo "$(date "+%Y-%m-%d-%H:%M:%S")同步失败,发送邮件操作" | mail -s "时间同步" root@server
        fi
    done

    while循环的特殊用法

    abc.txt
    aaa 1
    bbb 2
    ccc 3
    ddd 3
    
    #/bin/bash
    while read a b
    do
        echo $a:$b
    done < abc.txt

    需求3:统计系统中有多少个管理员用户,多少个系统用户,多少个普通用户

    • tr(translate 的缩写)是 Linux 系统中用于字符转换、替换或删除的强大命令。它通过标准输入读取数据,对字符进行逐字符处理,并将结果输出到标准输出。
      • cut -d: -f1,3 /etc/passwd | tr ':' ' ' > temp
    #!/bin/bash
    
    root_count=0
    sys_count=0
    other_count=0
    
    # 1. 读取/etc/passwd文件 用户名 用户ID
    cut -d: -f1,3 /etc/passwd | tr ':' ' ' > temp
    tr(translate 的缩写)是 Linux 系统中用于字符转换、替换或删除的强大命令。它通过标准输入读取数据,对字符进行逐字符处理,并将结果输出到标准输出。
    
    # 2. 循环判断用户的ID,以判断用户的类型
    while read name uid
    do
        # 3. 使用计数器来统计不通类型用户的数量
        if [ $uid -eq 0 ];then
            let root_count++
        elif [ $uid -ge 1 -a $uid -le 999 ];then
            let sys_count++
        else
            let other_count++
        fi    
    done < temp
    
    echo "管理员用户的数量为:$root_count"
    echo "系统用户的数量为:$sys_count"
    echo "普通用户的数量为:$other_count"
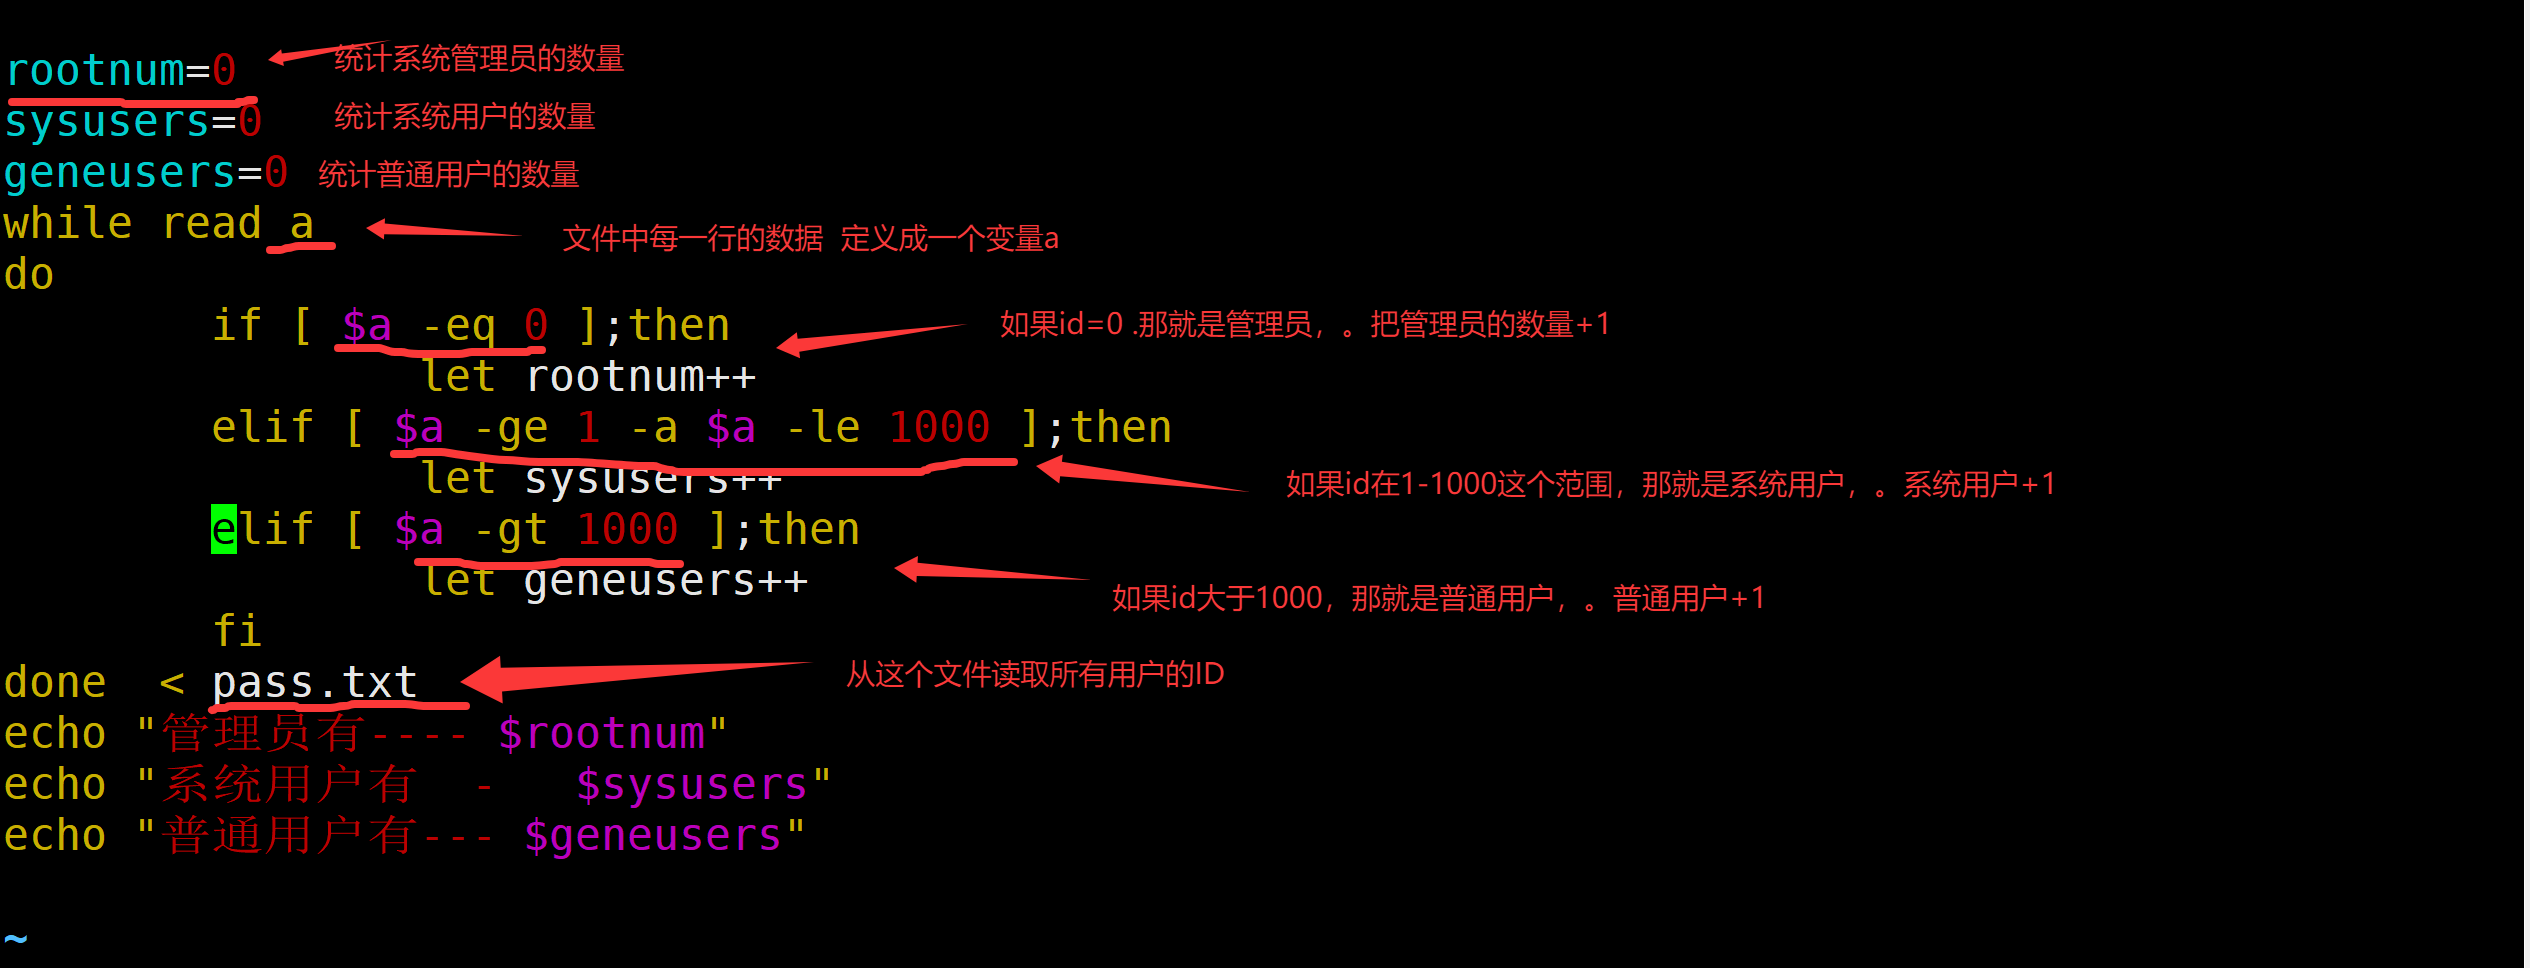
    file

    12.随机数()$RANDOM

    12.1 概述

    随机数就是使用一个命令或者工具随机生成一个数字,带有一些不确定性

    bash默认有一个$RANDOM的变量,通过这个变量可以产生随机数,随机数生成的范围默认是0~32767。

    12.2 语法结构

    产生0~1之间的随机数
    echo $[$RANDOM%2]
    
    产生0~9内的随机数
    echo $[$RANDOM%10]
    
    产生50-100之内的随机数
    echo $[$RANDOM%51+50]
    
    产生三位数的随机数
    echo $[$RANDOM%900+100] 
    
    产生5-10之间的随机
    echo $[$RANDOM%6+5]

    12.3 课堂案例

    需求1:猜数字游戏;生成一个1-10之间的随机数,然后使用交互式的方式由用户输入一个数字,猜对了就提示win,猜错了就提示loss
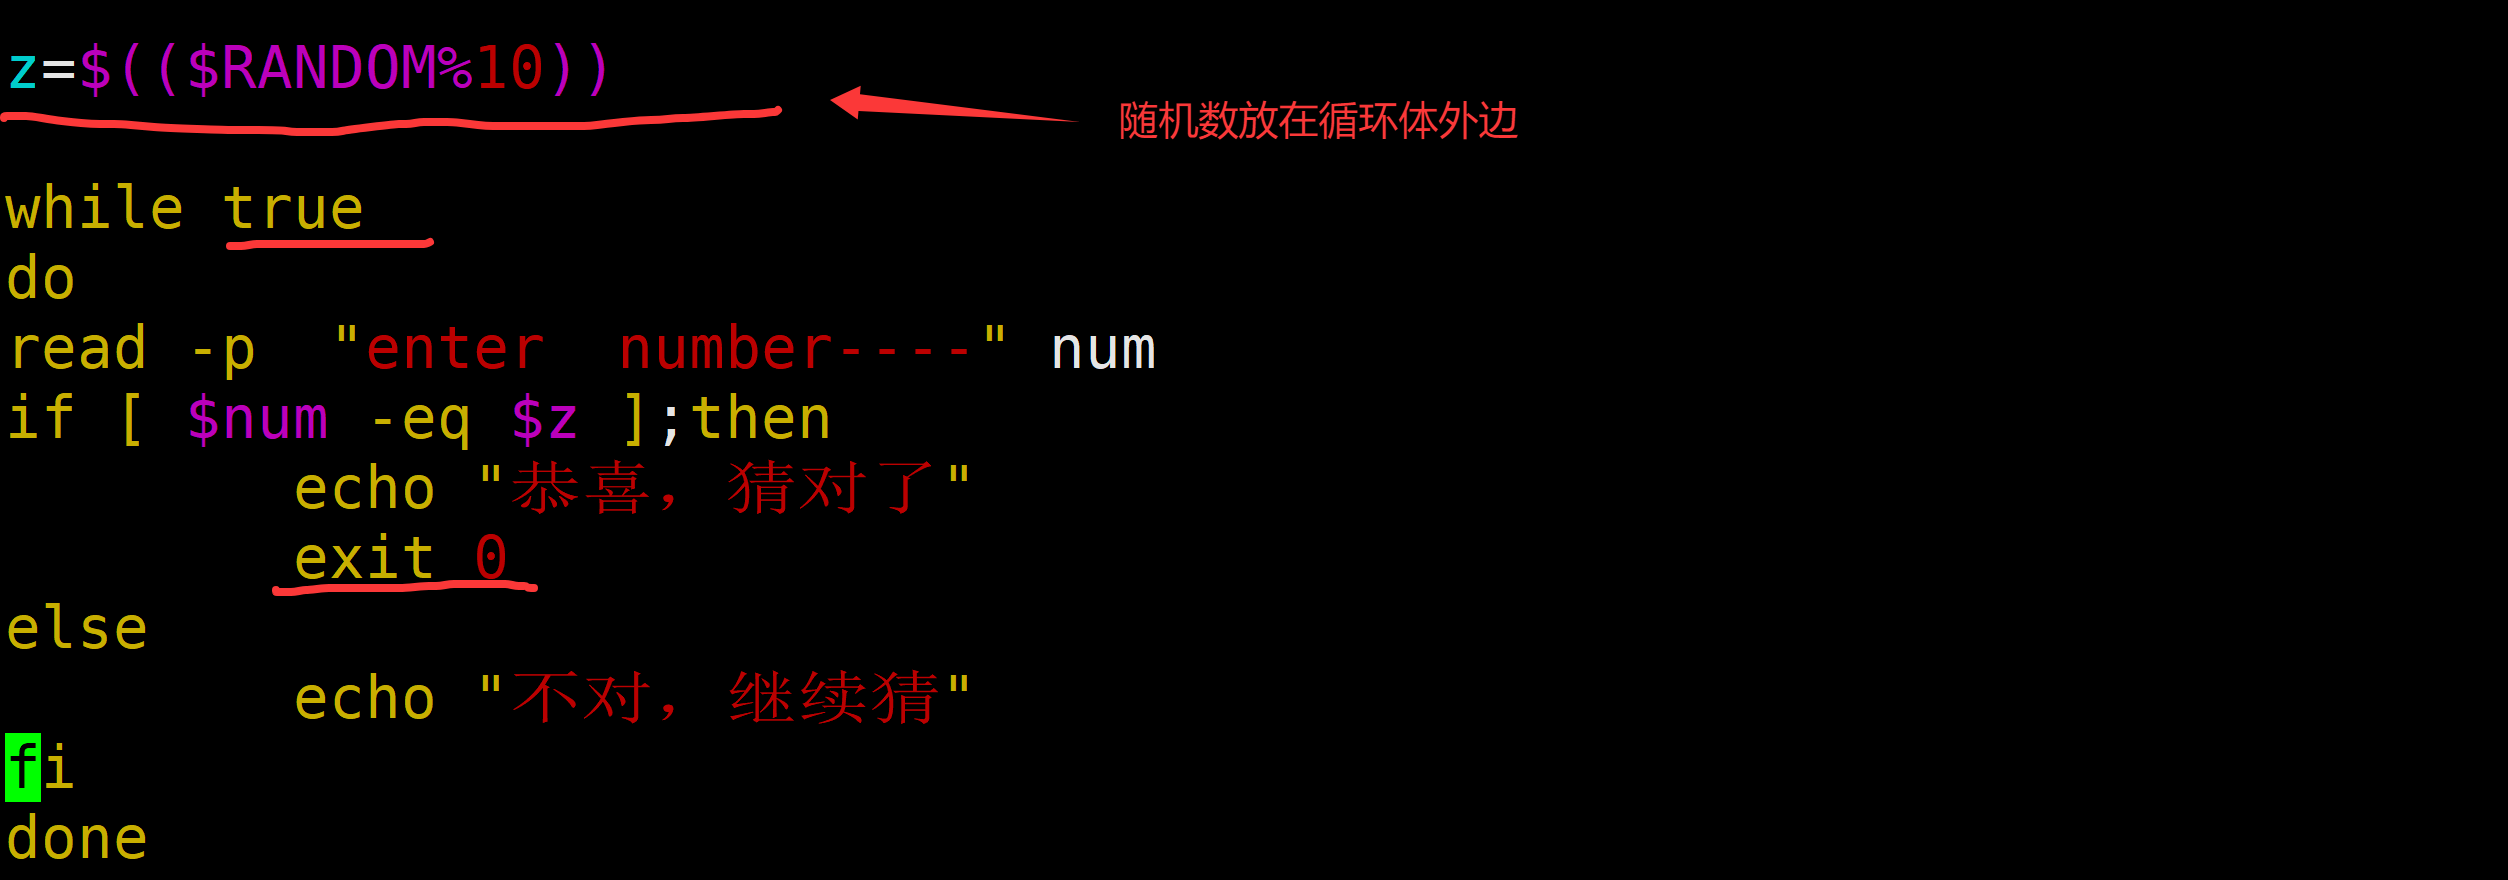
    file

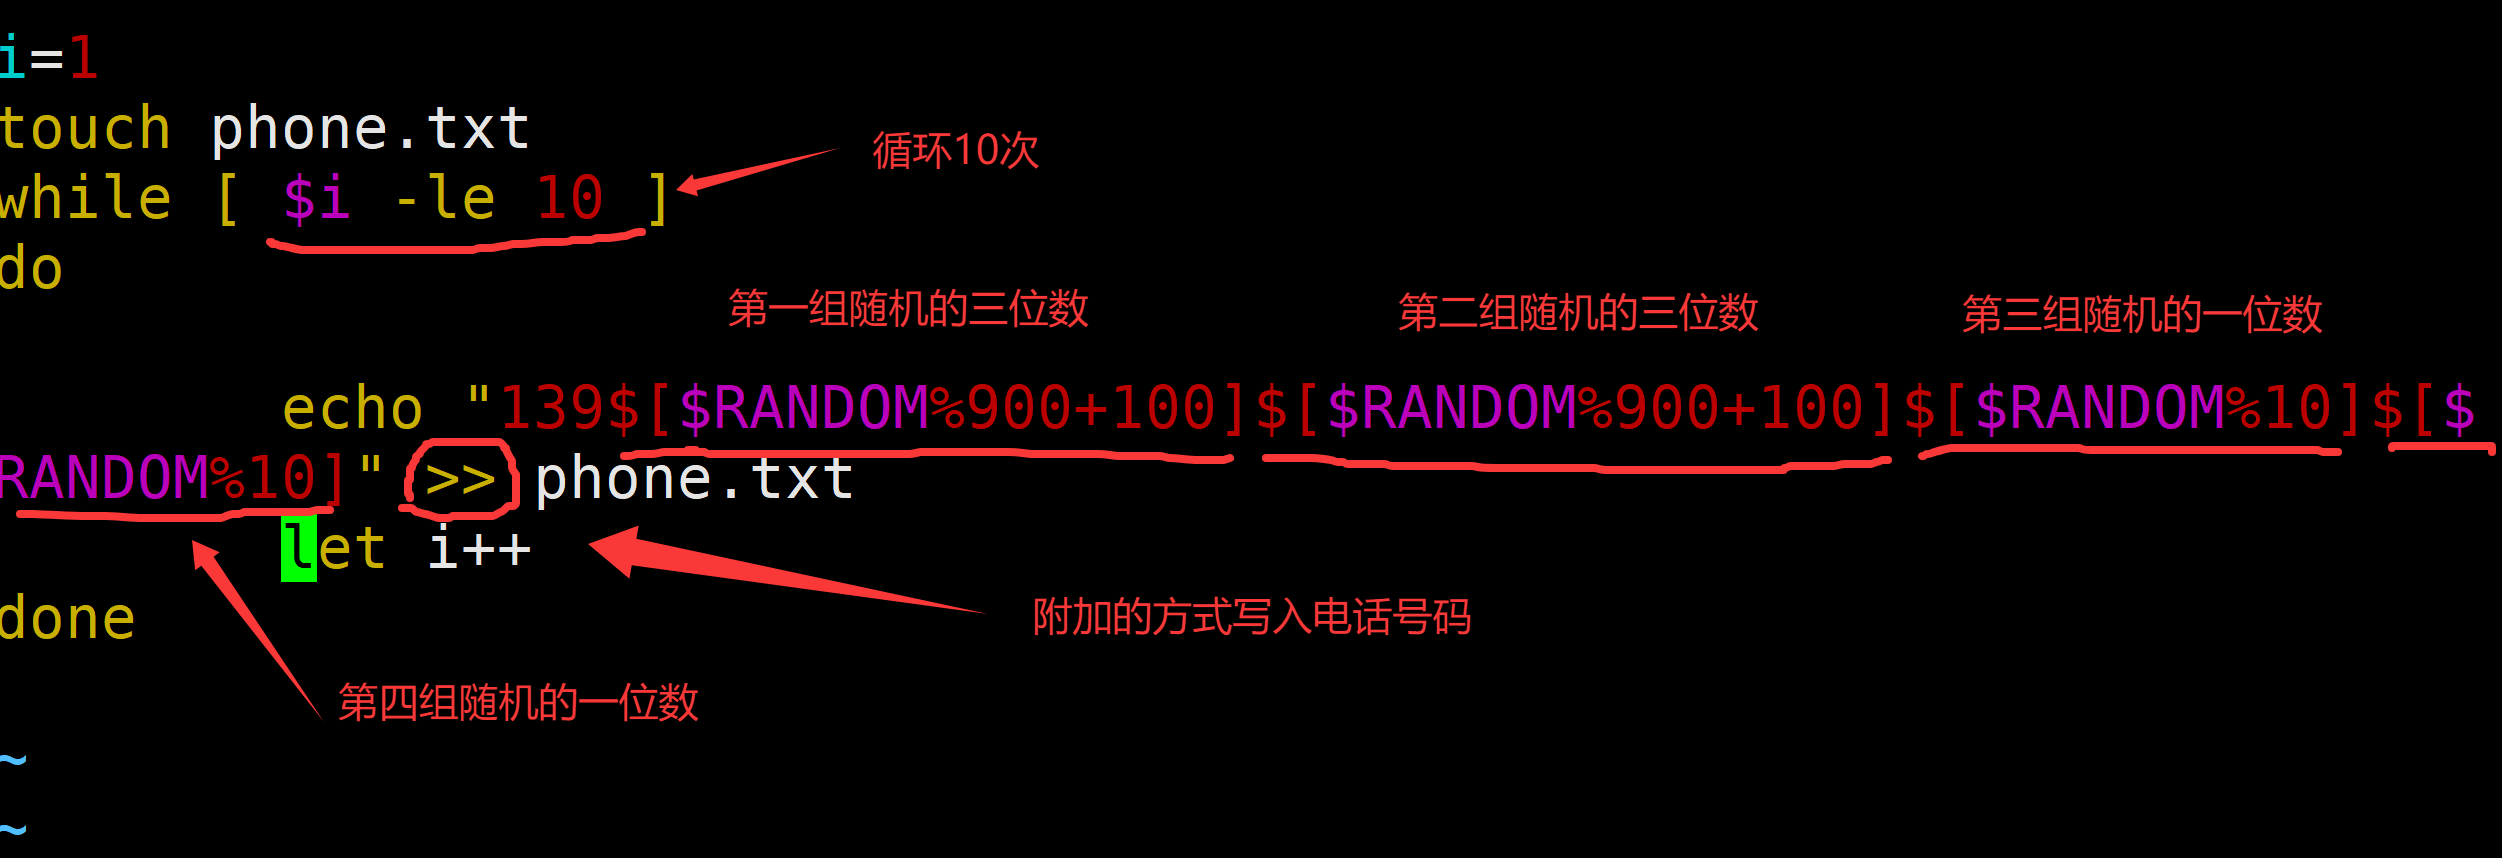
    需求2:写一个脚本,产生一个phone_num.txt文件,随机产生以139开头的手机号10个,每个一行
    file

    需求3:写一个脚本,产生一个phone_num.txt文件,随机产生以139开头的手机号100个,每个一行,还要求生成的手机号码不能重复

    13.case语法

    13.1 概述

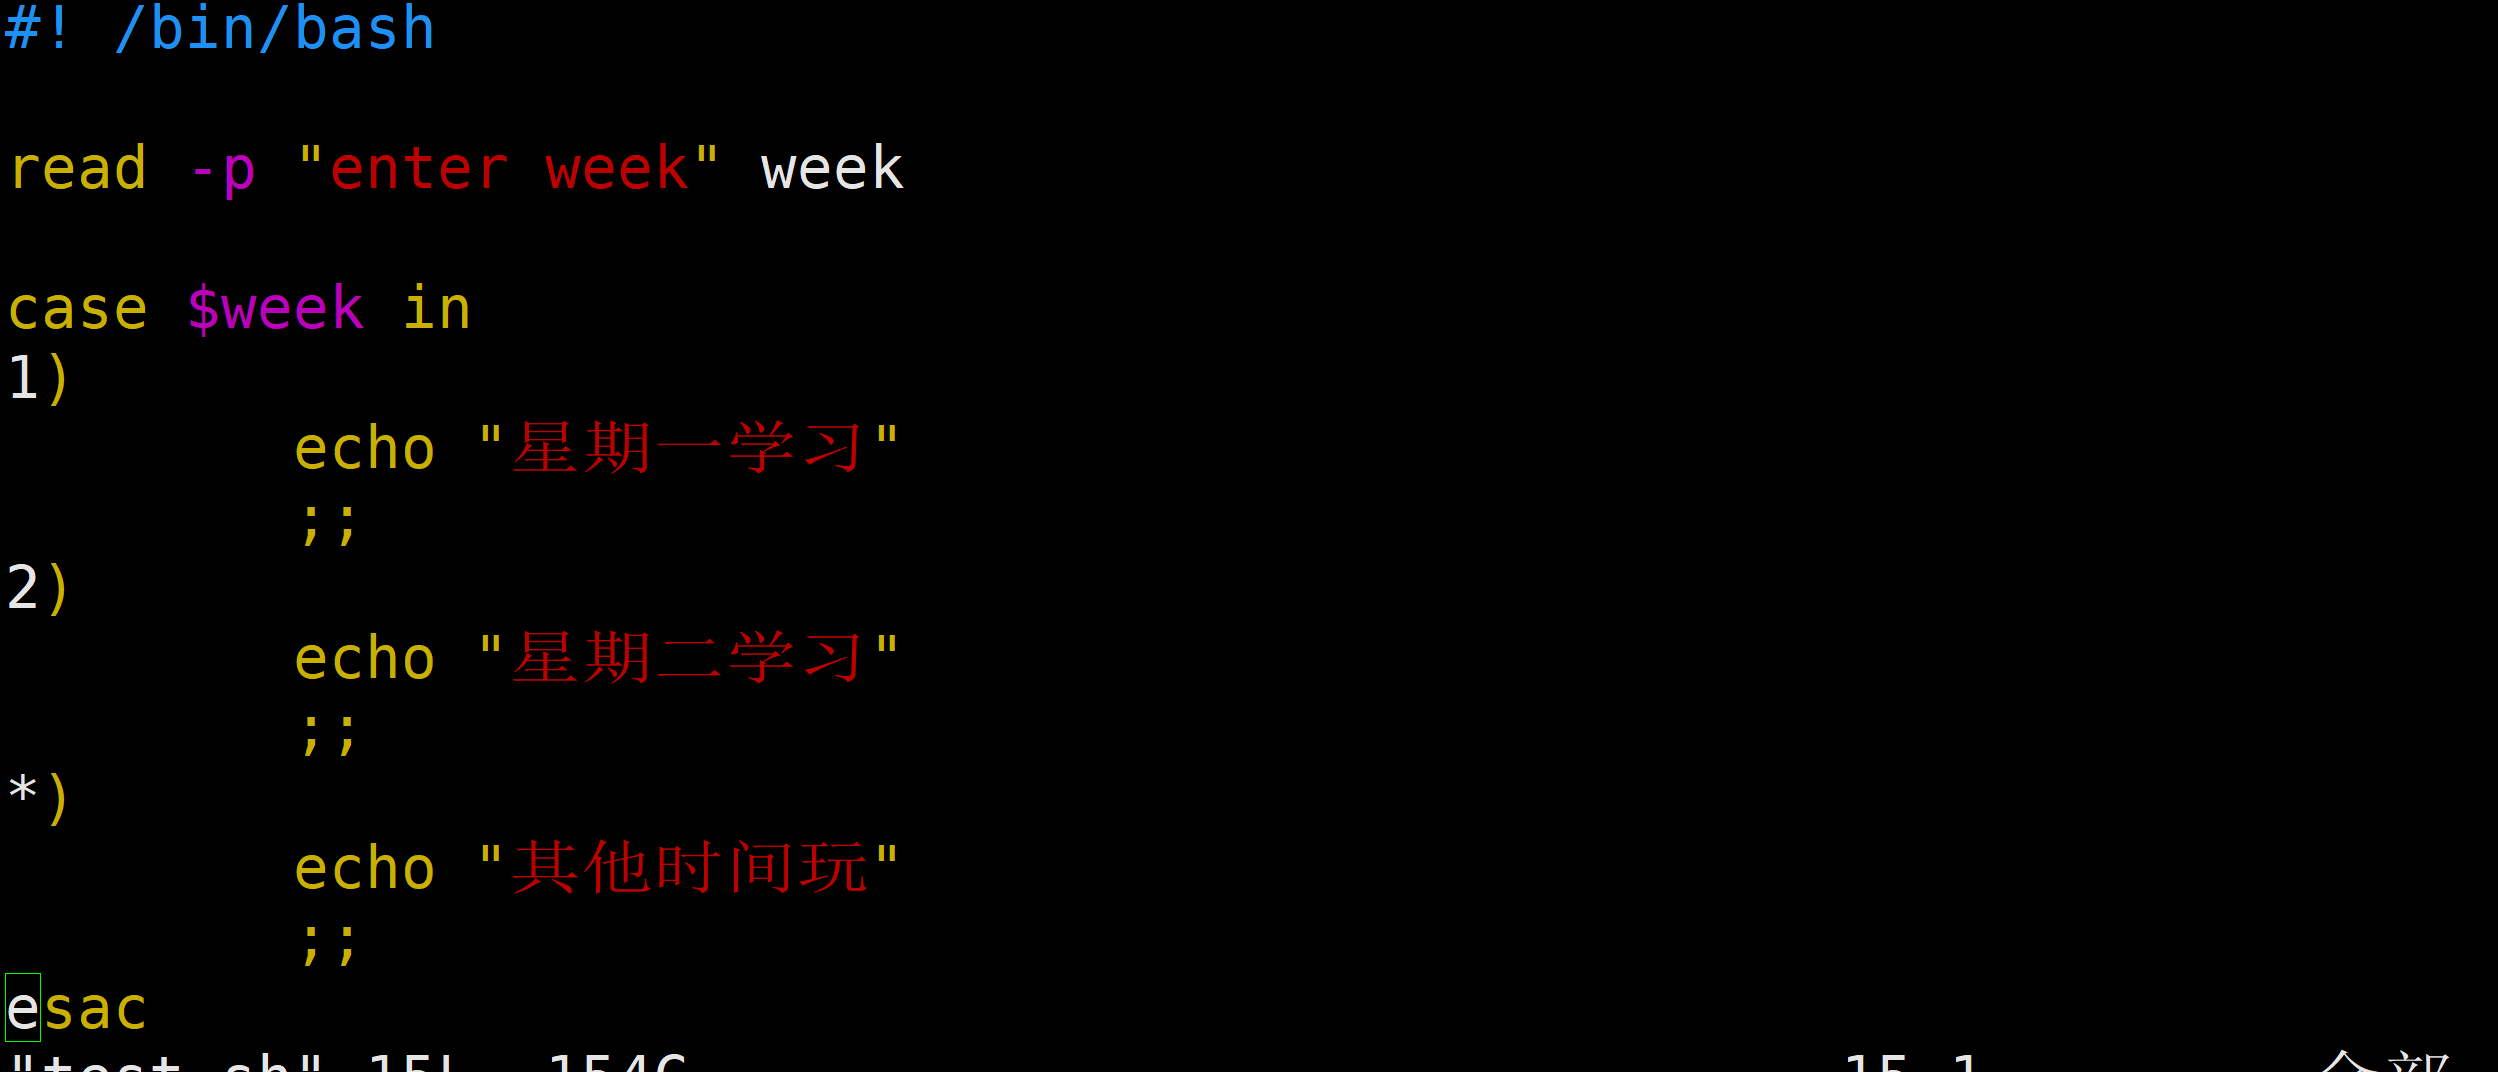
    case语法是对if的补充,使用 case 语句改写 if 多分支可以使脚本结构更加清晰、层次分明。针对变量的不同取 值,执行不同的命令序列。一般常用与菜单选项中,比如我们使用fdisk进行磁盘分区的时候,输入m是查看帮助,输入n是新建分区,输入w是保存分区,输入p是显示分区列表等

    case语句为多选择语句。可以用case语句匹配一个值与一个模式,如果匹配成功,执行相匹配的命令
    file

    13.2 语法

    case var in                         # 定义变量;var代表是变量名
    pattern 1)                          # 模式1;用 | 分割多个模式,相当于or,所谓模式就一个具体的值
        command1                        # 需要执行的语句
        ;;                              # 两个分号代表命令结束
    pattern 2)
        command2
        ;;
    pattern 3)
        command3
        ;;
              *)                          # default,不满足以上模式,默认执行*)下面的语句
        command4
        ;;
    esac                                # esac表示case语句结束

    需求:使用case模拟一个多分支的场景(1 —- 单身 2 —- 喜欢 3 —- 分手 4 —- 试一试 5-8 结婚 9 —- 退出)

    #!/bin/bash
    read -p "请输入一个1-9之间的数字:" num
    echo "num的值为:$num"
    case $num in
    1)
        echo "单身"
        ;;
    2)
        echo "喜欢"
        ;;
    3) 
        echo "分手"
        ;;
    4)
        echo "试一试"
        ;;
    5|6|7|8)
        echo "结婚"
        ;;
    9)
        echo "bye"
        ;;
    *)    
        echo "不要瞎搞"
        ;;
    esac
    echo "程序结束了"
    #!/bin/bash
    while true
    do
        read -p "请输入一个1-9之间的数字:" num
        case $num in
        1)
            echo "单身"
            ;;
        2)
            echo "喜欢"
            ;;
        3) 
            echo "分手"
            ;;
        4)
            echo "试一试"
            ;;
        5|6|7|8)
            echo "结婚"
            ;;
        9)
            echo "bye"
            exit
            ;;
        *)    
            echo "不要瞎搞"
            ;;
        esac
    done

    13.3 课堂案例

    需求1:按键类型识别

    需求2:当给程序传入start、stop、reload三个不同参数时分别执行相应命令

    需求3:模拟一个多任务维护界面。当执行程序时先显示总菜单,然后进行选择后做相应维护监控操作

    14.函数

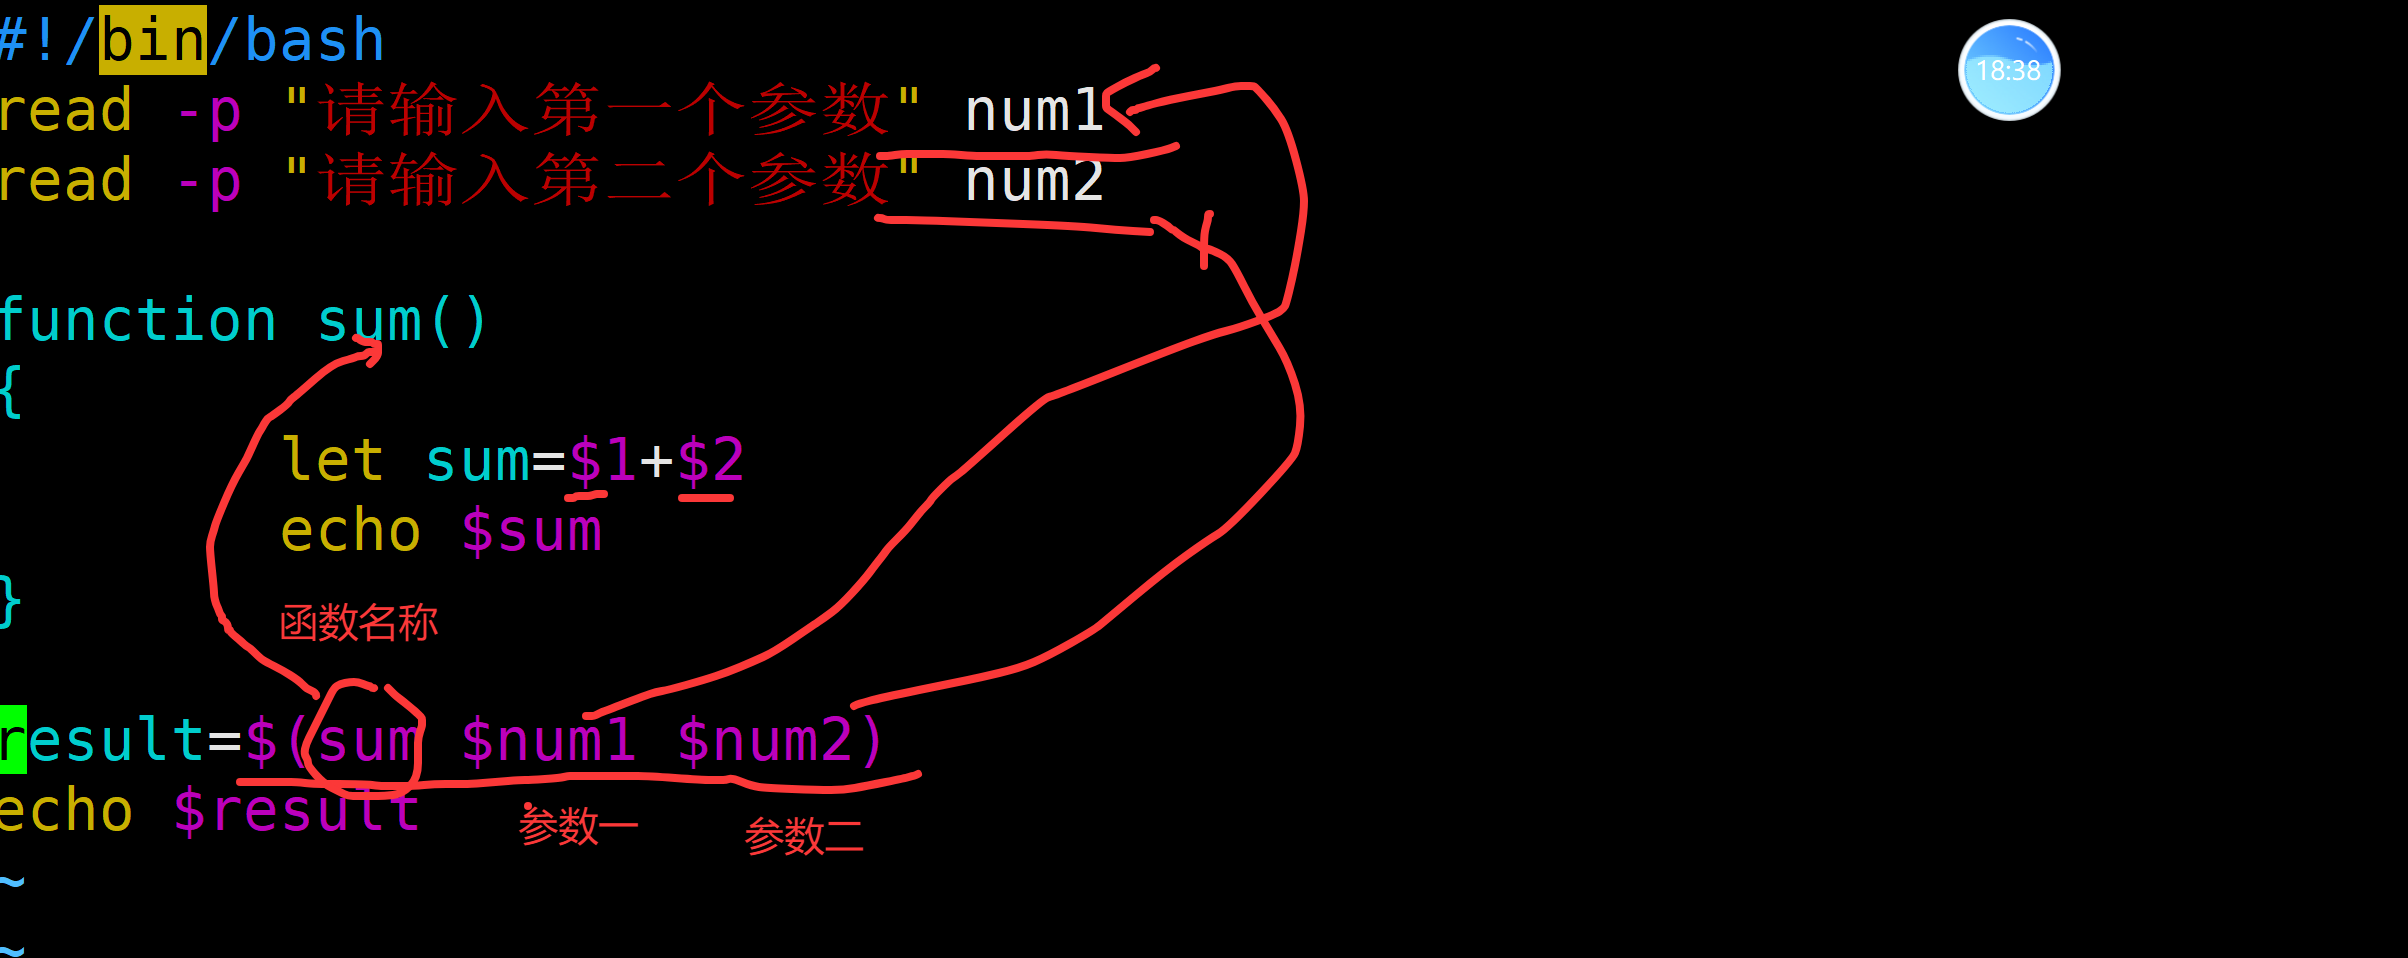
    1.1 概述

    shell中允许将一组命令集合或语句形成一段可用代码,这些代码块称为shell函数。给这段代码起个名字称为函数名,后续可以直接调用该段代码的功能

    Shell 函数的本质是一段可以重复使用的脚本代码,这段代码被提前编写好了,放在了指定的位置,使用时直接调取即可

    函数的特点:

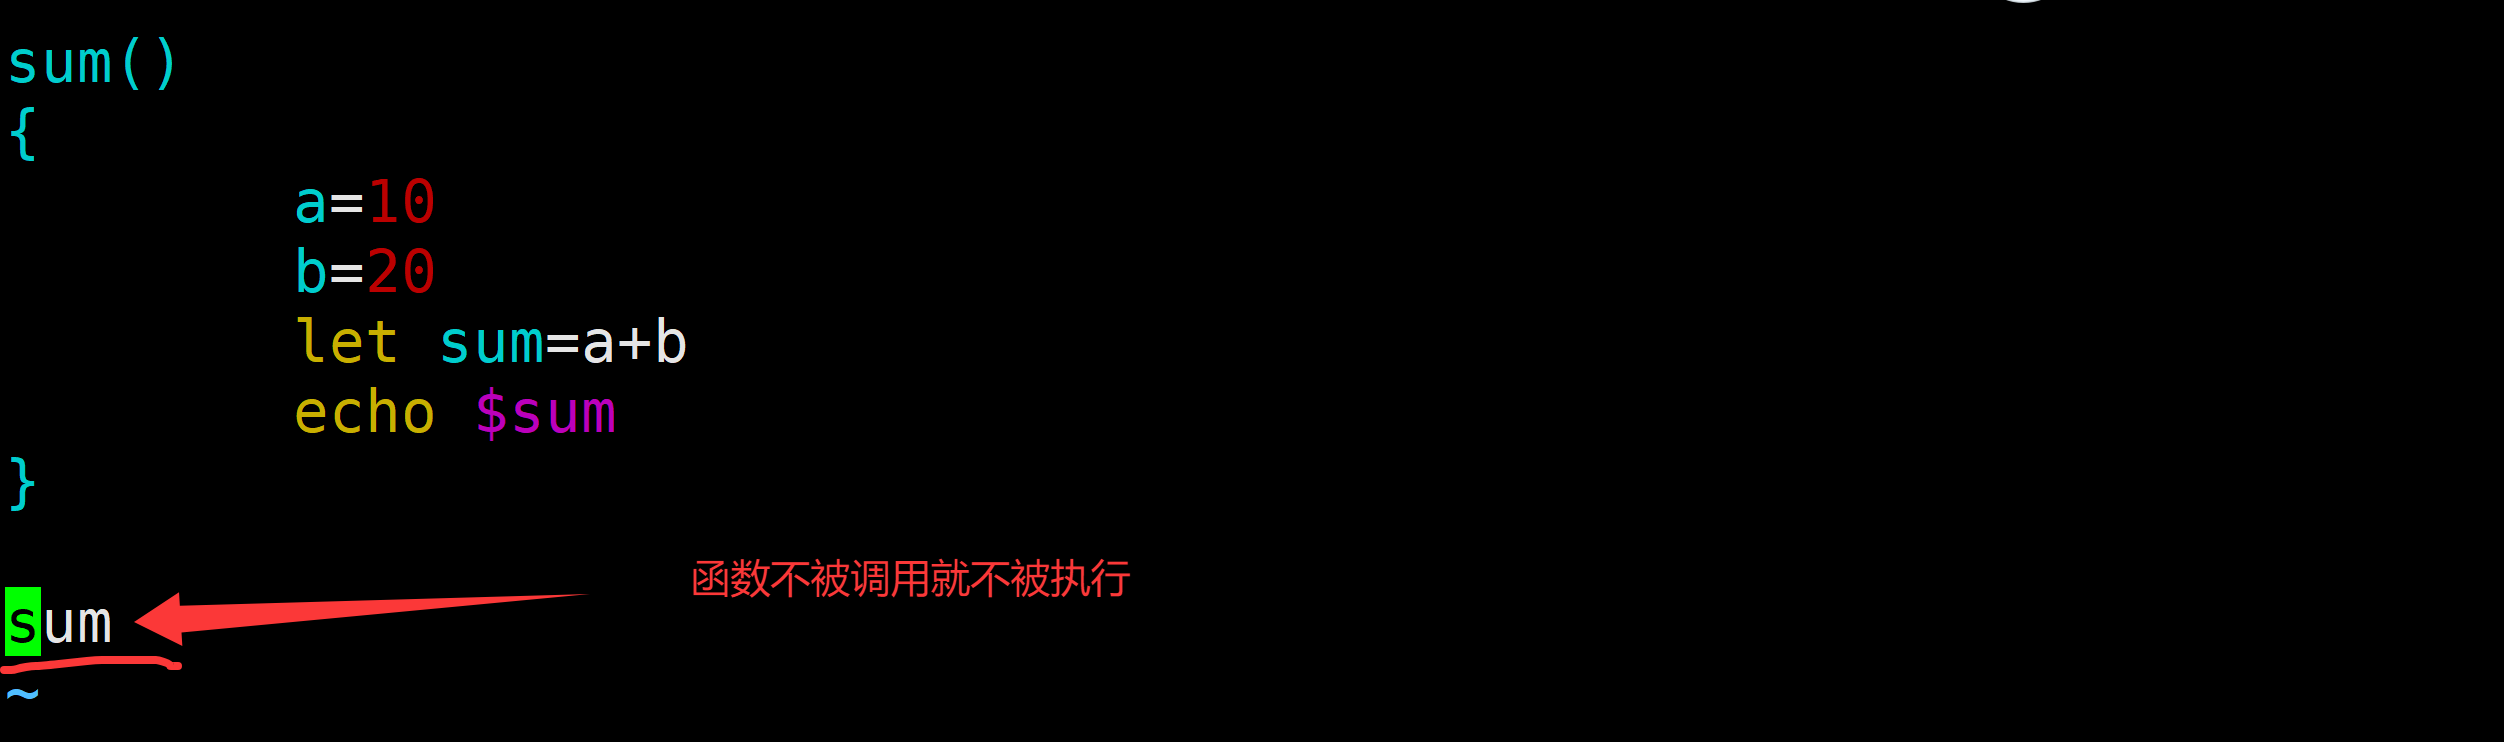
    • 函数不被调用不会被执行
    • return表示退出函数并返回一个退出值,脚本中可以用$?变量显示该值,如果没有return。默认取决于函数中执行的最后一条命令的退出状态码
    • 退出状态码必须是0~255,超出时值将为除以256取余。如果大于255的返回值,可以通过echo 返回
    • 用 $? 来获取函数的 return值,用 $(函数名) 来获取函数的 echo值

    1.2 函数的定义

    语法格式一:

    函数名()
    {
      函数体(一堆命令的集合,来实现某个功能)   
    }

    语法格式二:

    function 函数名()
    {
       函数体(一堆命令的集合,来实现某个功能)  
    }
    file

    file

    需求1:使用语法格式二定义个函数,用于计算两个数的和

    #!/bin/bash
    function sum()
    {
        a=5
        b=4
        return $[$a+$b]
    }
    sum
    echo "使用函数sum计算两个数的和: $?"

    file

    #!/bin/bash
    function sum()
    {
        a=251
        b=5
        return $[$a+$b]
    }
    sum
    echo "使用函数sum计算两个数的和: $?"

    file

    #!/bin/bash
    function sum()
    {
        a=251
        b=5
        echo $[$a+$b]
    }
    ss=$(sum)
    echo "使用函数sum计算两个数的和: $ss"

    file

    需求2:使用语法格式二定义个函数,用于比较两个数的大小,两个数由参数传递进去

    #!/bin/bash
    function get_max()
    {
        if [ $# -lt 2 ];then
            echo "参数错误"
            return
        fi
        if [ $1 -eq $2 ];then
                echo "相等"
            elif [ $1 -gt $2 ];then
                echo "大于"
            else
                echo "小于"
        fi
    }
    result=$(get_max 1 2)
    echo "使用函数get_max的结果为: $result"

    file

    1.3 函数的调用

    1)shell脚本内部调用

    在之前的案例中,使用的都是脚本内调用的方式,这样的方式,存在的问题,就是这个函数只能在这个shell脚本中使用,其它脚本就不能使用了

    #!/bin/bash
    function sum()
    {
        a=5
        b=4
        return $[$a+$b]
    }
    sum
    echo "使用函数sum计算两个数的和: $?"

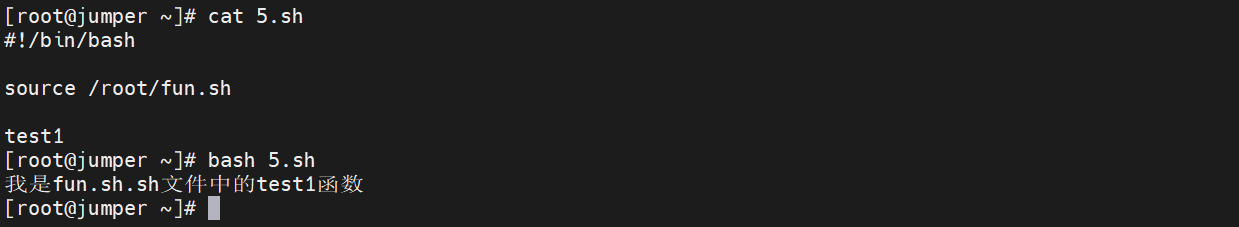
    2)终端调用

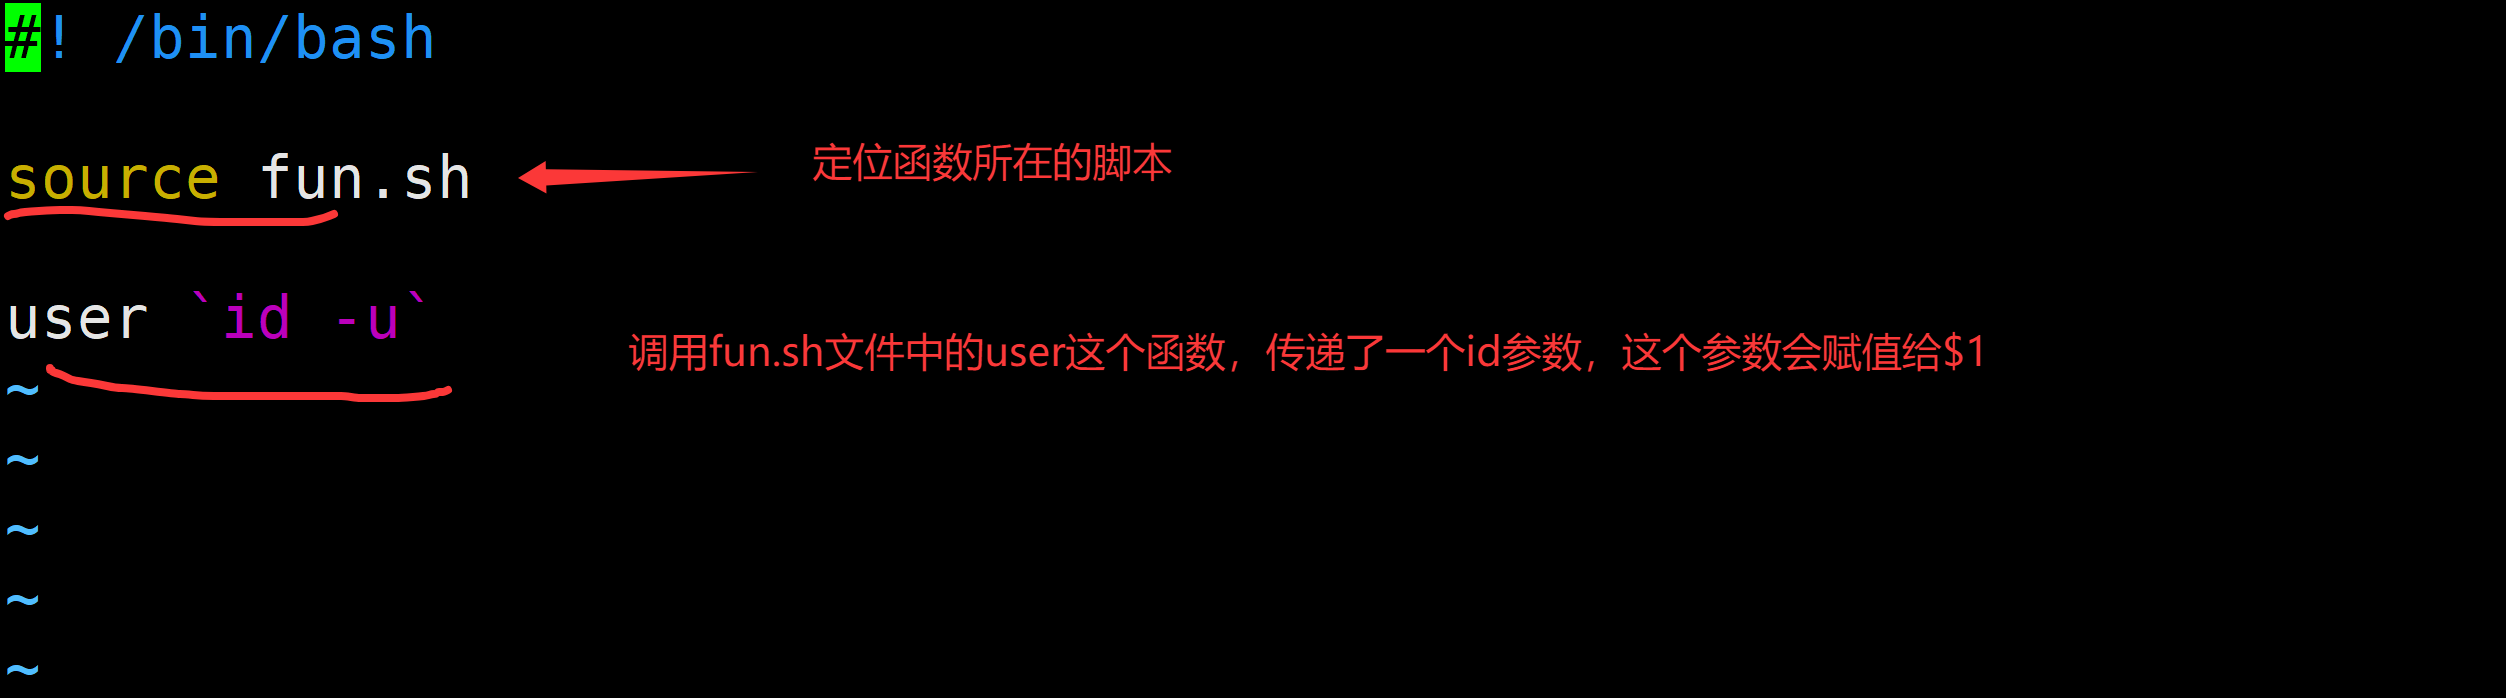
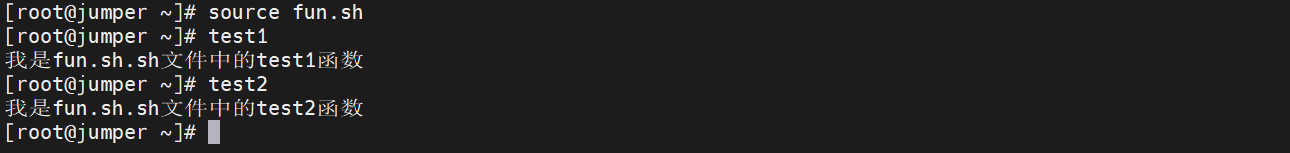
    通过source引入脚本文件使用

    定义一个脚本函数:fun.sh

    #!/bin/bash
    test1()
    {
      echo "我是fun.sh.sh文件中的test1函数"
    }
    test2()
    {
      echo "我是fun.sh.sh文件中的test2函数"
    }
    file

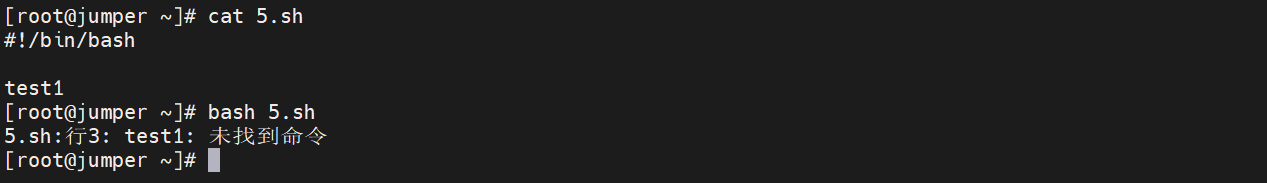
    定义一个需要执行的脚本:5.sh

    #!/bin/bash
    source /root/fun.sh
    test1
    file

    file

    file

    file

    3)全局调用

    全局调用就是将函数定义到全局文件中,如:~/.bashrc 或者 /etc/bashrc

    需求:在/etc/bashrc定义一个函数,在脚本中调用使用

    注意:需要将以下脚本添加到/etc/bashrc文件中。然后使用source /etc/bashrc重新读取文件

    function test3()
    {
        echo "在/etc/bashrc定义的test3函数"
    }

    定义一个需要执行的脚本:6.sh

    :wq#!/bin/bash
    source /etc/bashrc
    test3

    1.4 课堂案例

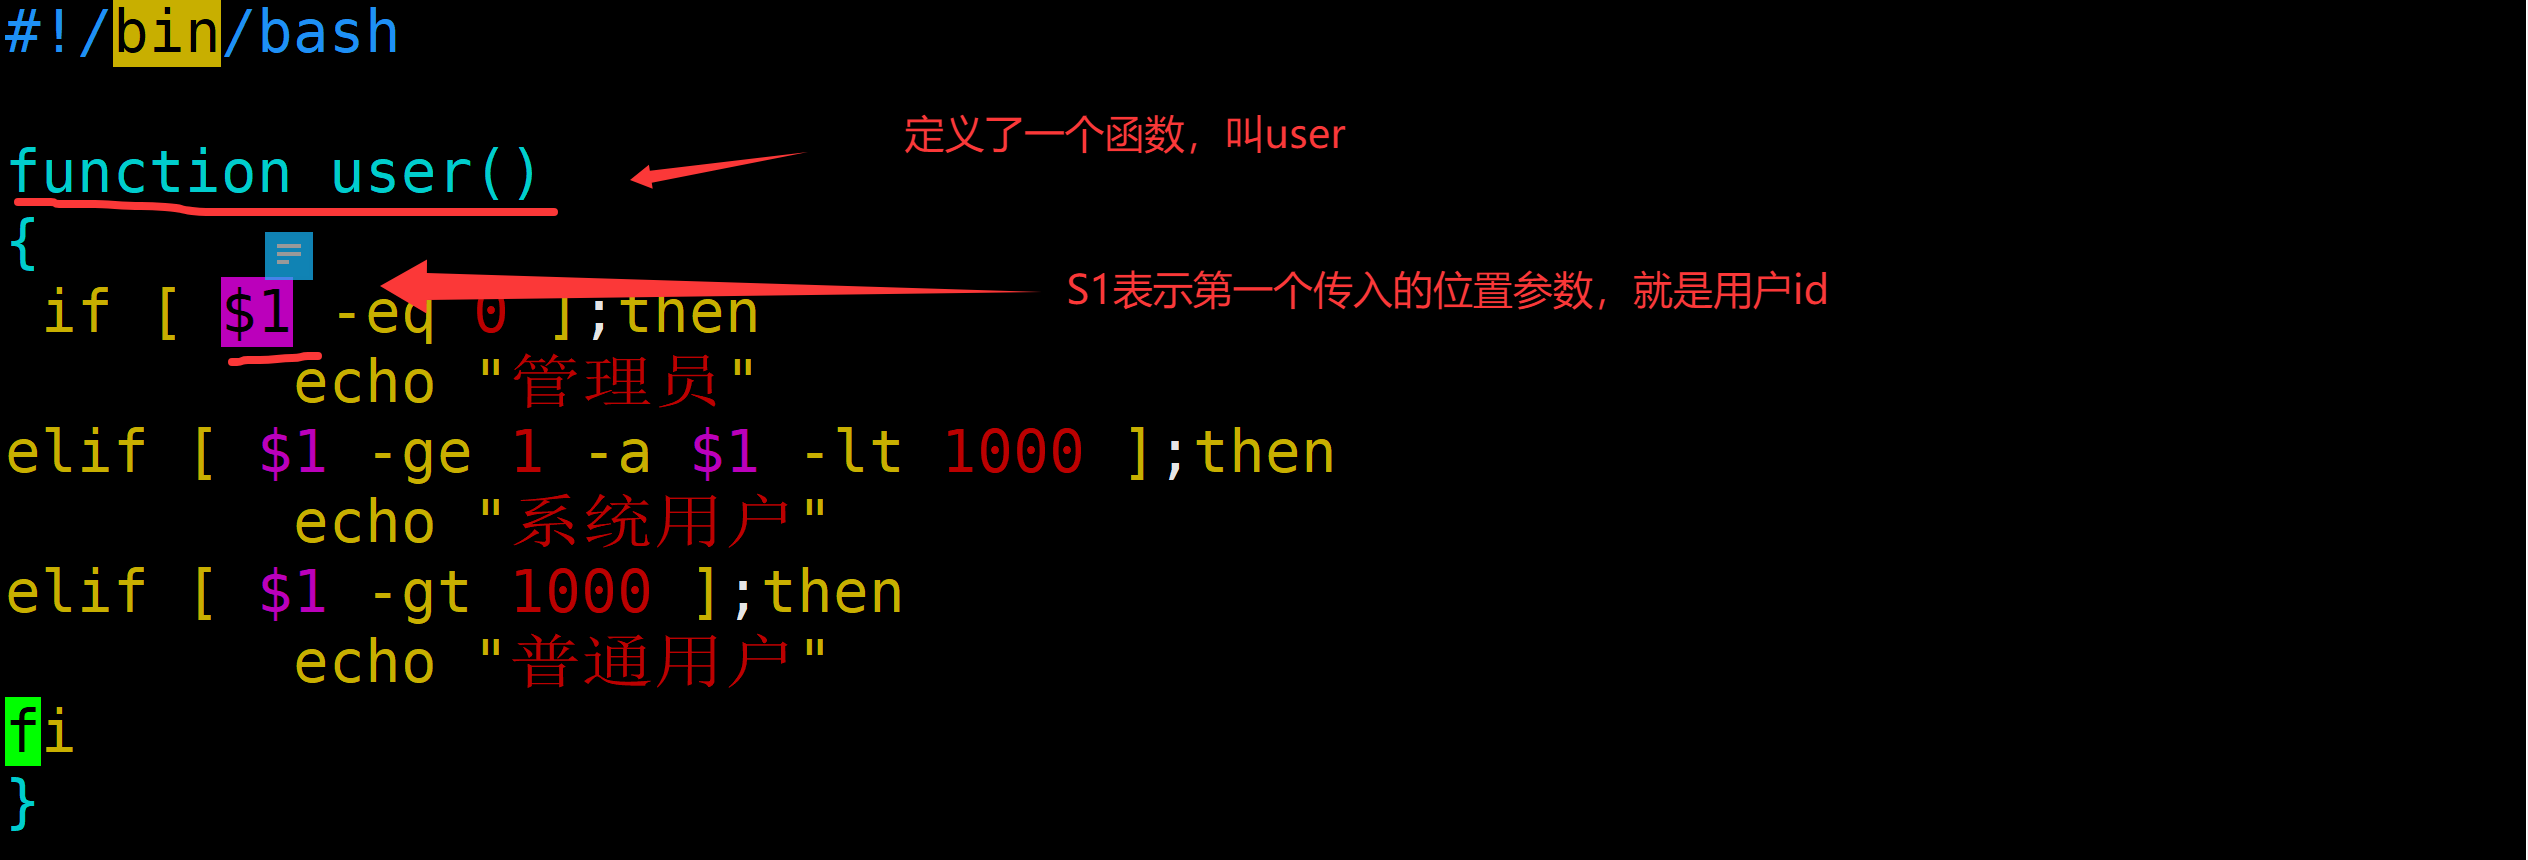
    需求:使用函数的方式判断一个url是否正常

    #!/bin/bash
    
    # 如果可以ping通,返回该地址可用,如果ping不同,返回该地址不可用
    function check_url(){
        # 获取参数,判断该地址是否可以ping通
        ping -c1 $1 &> /dev/null
        if [ $? -eq 0 ];then
                echo "$1:地址可用"
            else
                echo "$1:地址不可用"
        fi
    }
    
    # 交互式输入一个数据
    read -p "请输入一个url地址:" url
    
    # 调用函数,并且将url传递给函数
    result=$(check_url $url)
    
    # 打印结果
    echo $result

    15.正则表达式

    15.1 概述

    在Linux系统中,Shell正则表达式是一种强大的文本处理工具,它允许用户通过模式匹配来检索和操作文本。正则表达式由普通字符和元字符组成,其中元字符具有特殊意义,用于规定其前导字符在目标对象中的出现模式。在Linux中,常用的正则表达式引擎有两种:基础正则表达式(BRE)和扩展正则表达式(ERE)。

    Shell正则表达式是一种强大的文本处理工具,它允许用户通过模式匹配来检索和操作文本,在Linux系统中广泛用于文本分析和处理任务

    15.2 语法

    1)名词解释

    元字符:指那些在正则表达式中具有特殊意义的专用字符,如:点(.) 星(*) 问号(?)等

    前导字符:即位于元字符前面的字符

    2)语法概述

    (1).                    任意单个字符,除了换行符 
    (2)*                    前导字符出现0次或连续多次  ab*能匹配“a”,“ab”以及“abb”,但是不匹配“cb”
    (3).*                   任意长度的字符  ab.*  ab123 abbb abab
    (4)^                    行的开头
    (5)$                    行的结尾
    (6)^$                   空行
    (7)[]                   匹配指定字符组内的任一单个字符   [abc]
    (8)[^]                  匹配不在指定字符组内的任一字符     [^abc]
    (9)^[]                  匹配以指定字符组内的任一字符开头   ^[abc]
    (10)^[^]                匹配不以指定字符组内的任一字符开头  ^[^abc] 
    (11)\<                  取单词的头
    (12)\>                  取单词的尾
    (13)\<\>                精确匹配符号     grep -w 'xxx'
    (14)\{n\}               匹配前导字符连续出现n次    go\{2\}   google  gooogle
    (15)\{n,\}              匹配前导字符至少出现n次    go\{2,\}  google  gooogle
    (16)\{n,m\}             匹配前导字符出现n次与m次之间 
    (17) \(strings\)         保存被匹配的字符

    15.3 课堂案例

    前提,创建一个abc.txt文件,往文件中添加如下数据:

    ggle
    gogle
    google
    gooogle
    goooooogle
    gooooooogle
    taobao.com
    taotaobaobao.com
    aaab
    abc
    ac
    bc
    abbc
    abab
    
    jingdong.com
    dingdingdongdong.com
    192.168.217.129
    192.168.217.1
    192.168.217
    Adfjd8789JHfdsdf/
    a87fdjfkdLKJK
    7kdjfd989KJK;
    bSKJjkksdjf878.
    cidufKJHJ6576,
    
    heihei
    hello world
    helloworld yourself
    heihellow hello

    需求1:请描述以下命令得到的结果是:grep go* grep goo* grep ab.* grep ab*

    grep go* :         包含g字符的含,其中o字符和已出现0次或者多次(o为前导字符)
    grep goo* :        包含go字符的含,其中第二个o字符和已出现0次或者多次(第二个o为前导字符)
    grep ab.* :        包含ab字符的含
    grep ab* :         包含a字符的含,其中b字符和已出现0次或者多次(b为前导字符)

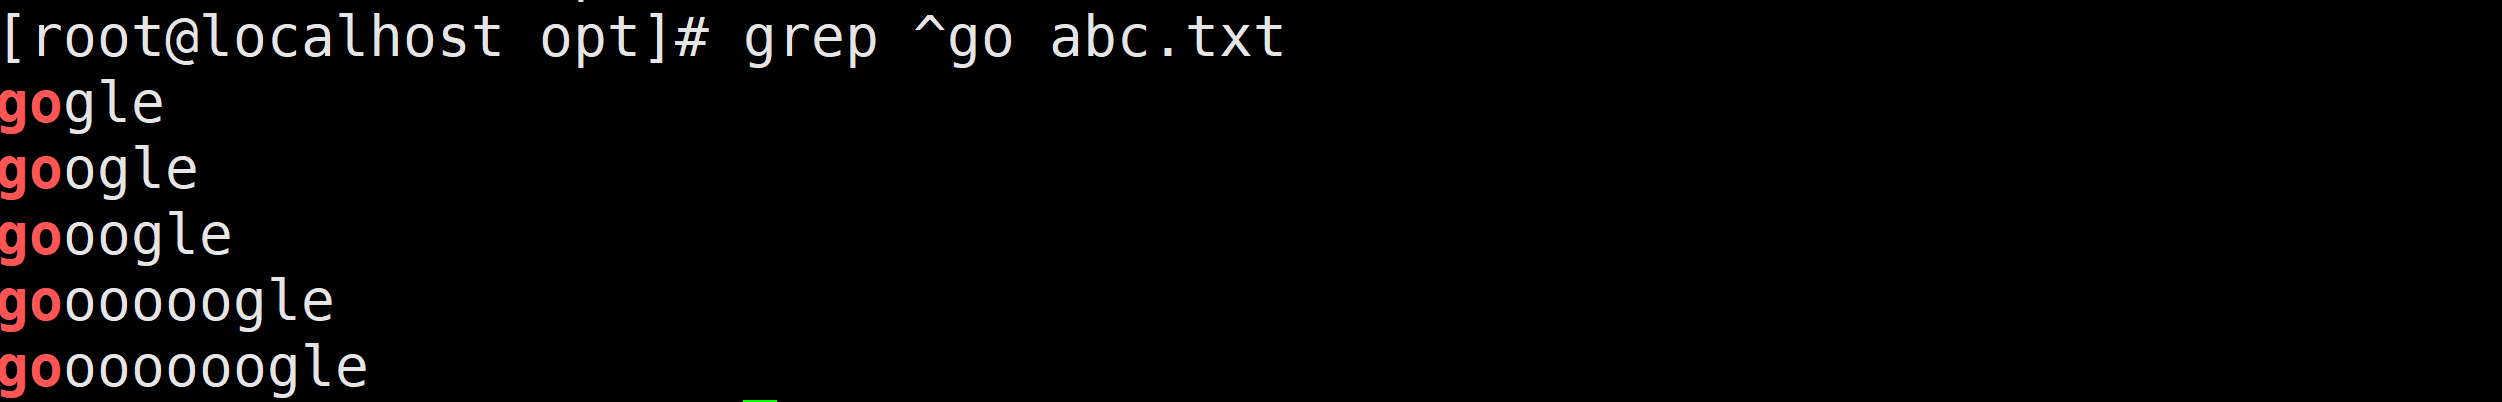
    需求2:请找出以go开头的行

    grep ^go abc.txt
    file

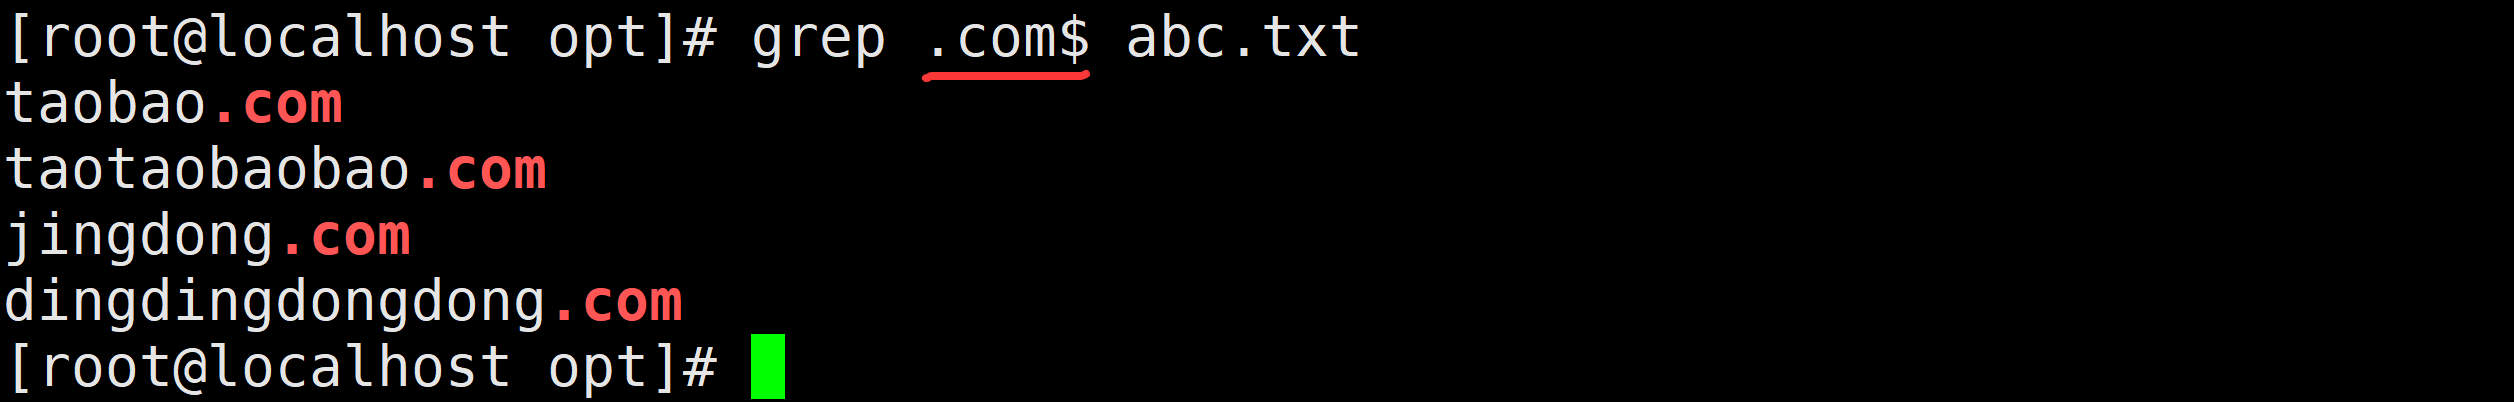
    需求3:请找出以.com结尾的行

    grep .com$ abc.txt

    file

    需求4:请找出文件中哪些行是空行,并显示行号

    grep -n ^$ abc.txt
    cat -n abc.txt

    file

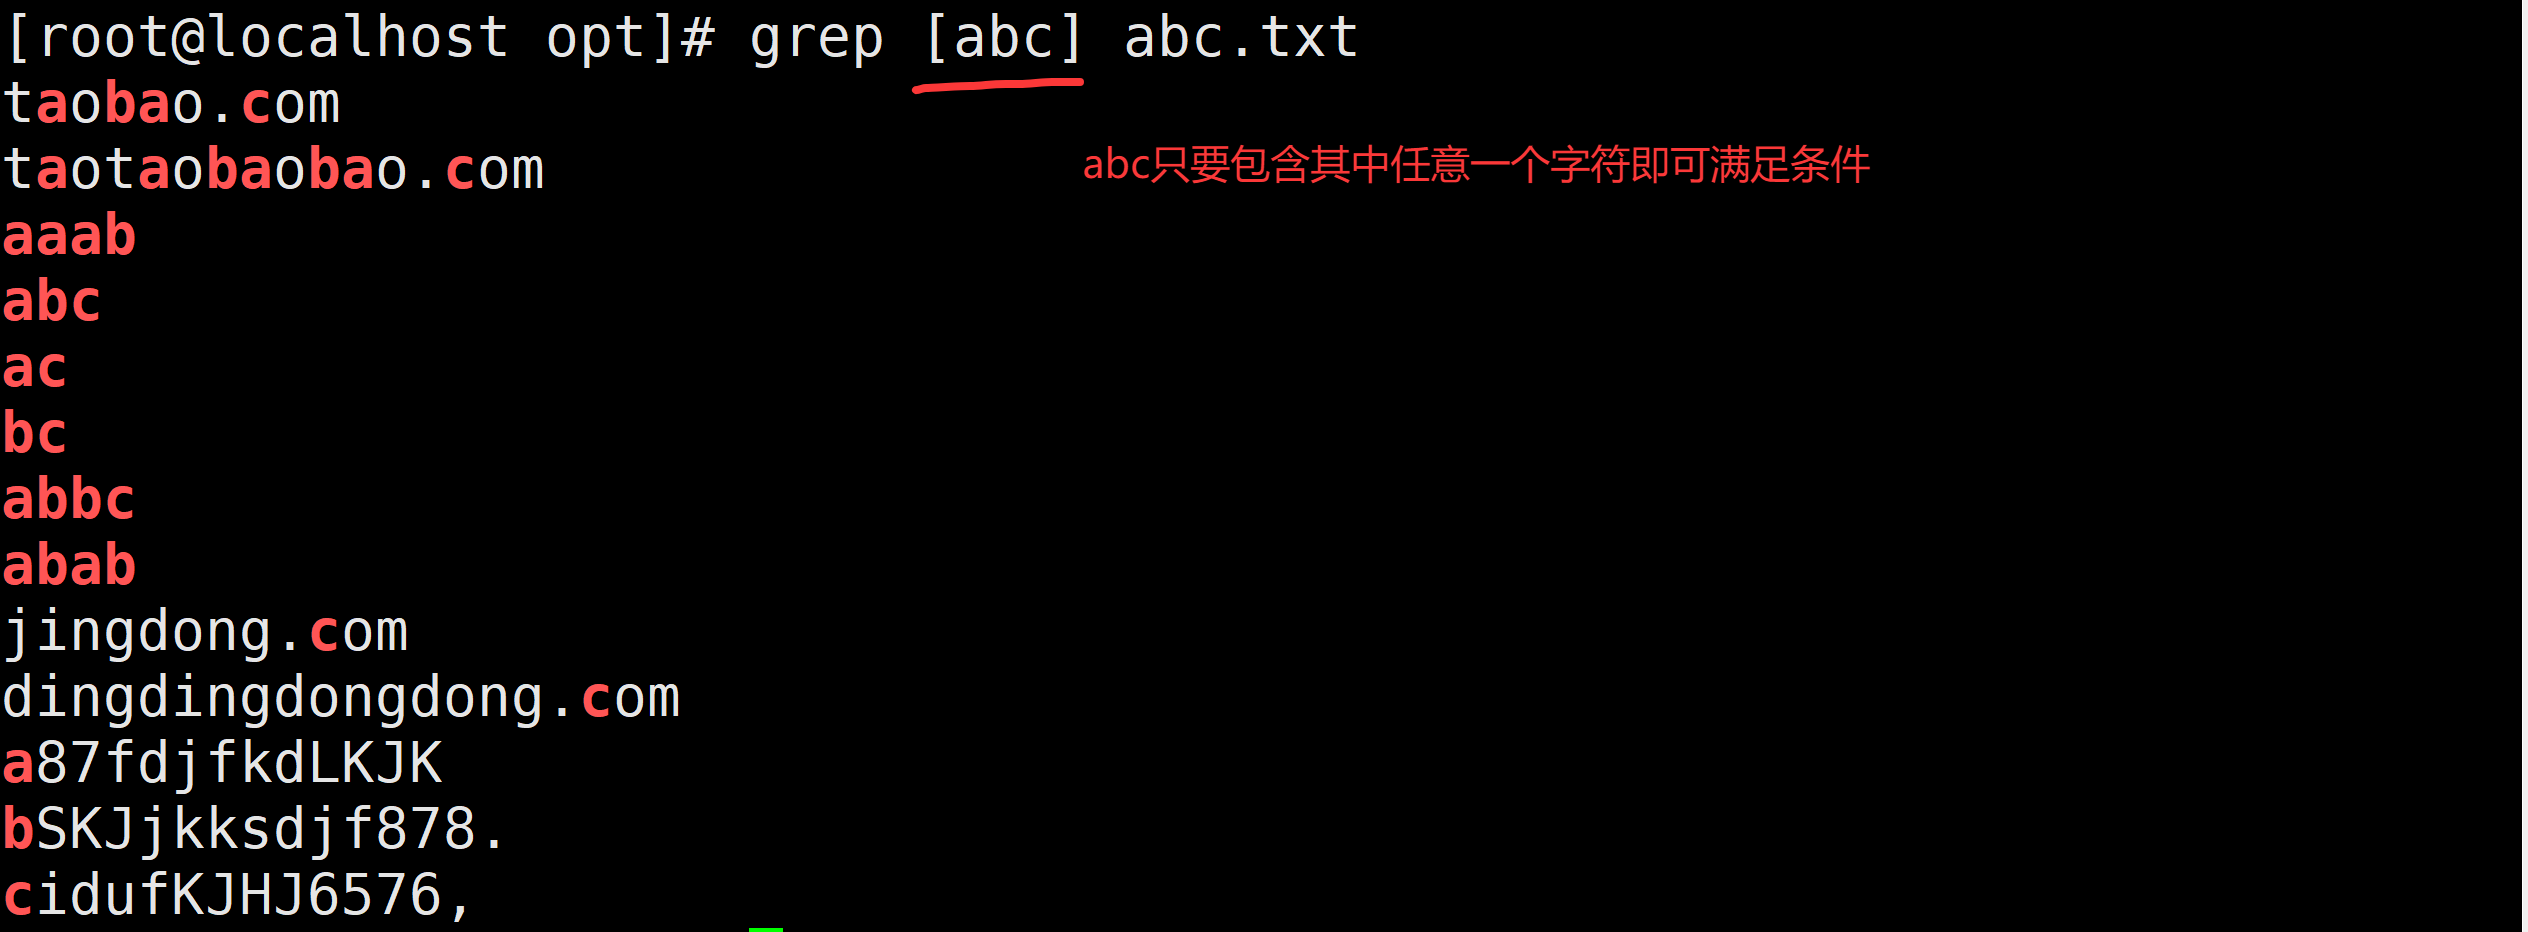
    需求5:请找出文件中包含abc中任意一个字符的行

    grep [abc] abc.txt
    file

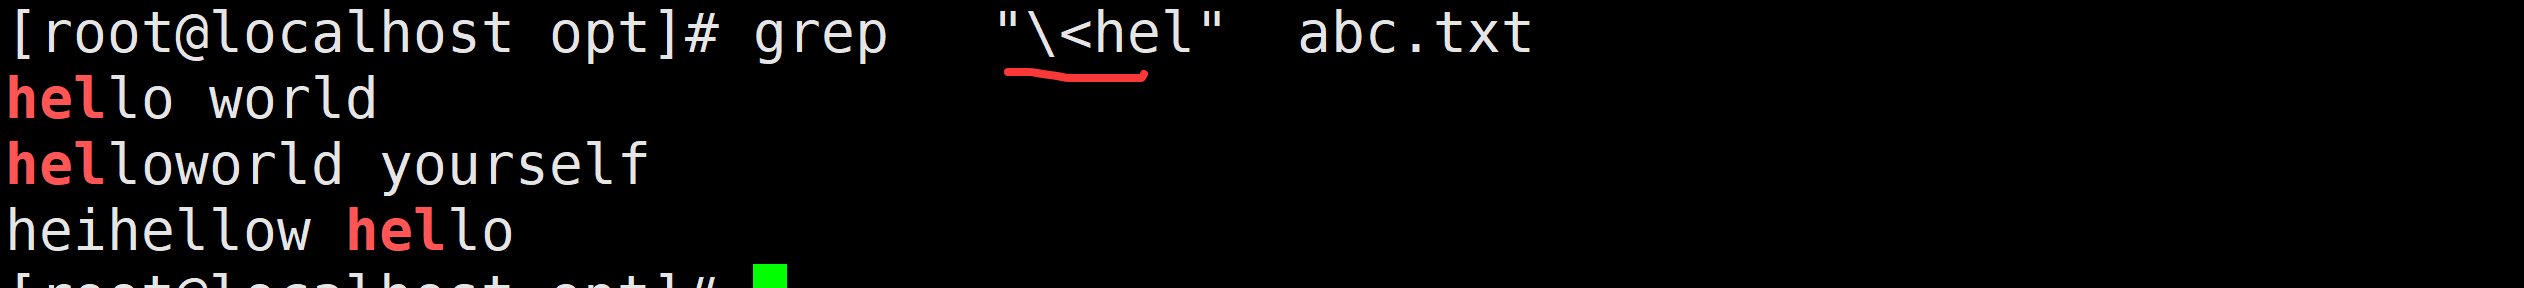
    需求6:请找出以hel开头的单词

    grep "\<hel" abc.txt
    file

    需求7:请找出以hei结尾的单词

    grep "hei\>" abc.txt

    file

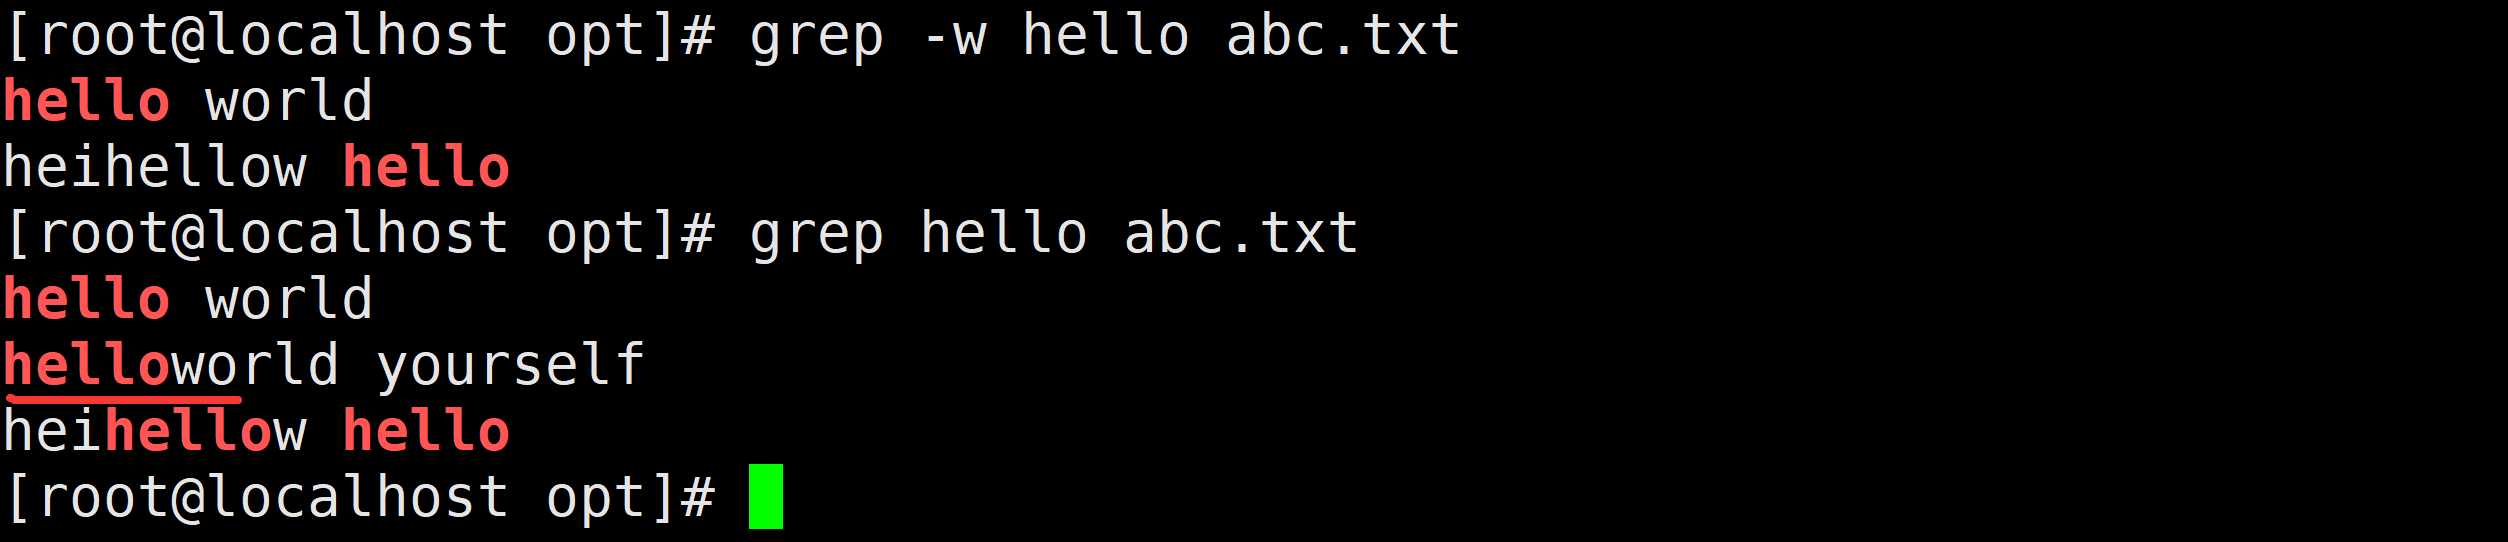
    需求8:精确查找包含hello单词的行

    grep "\<hello\>" abc.txt
    grep -w hello abc.txt
    file

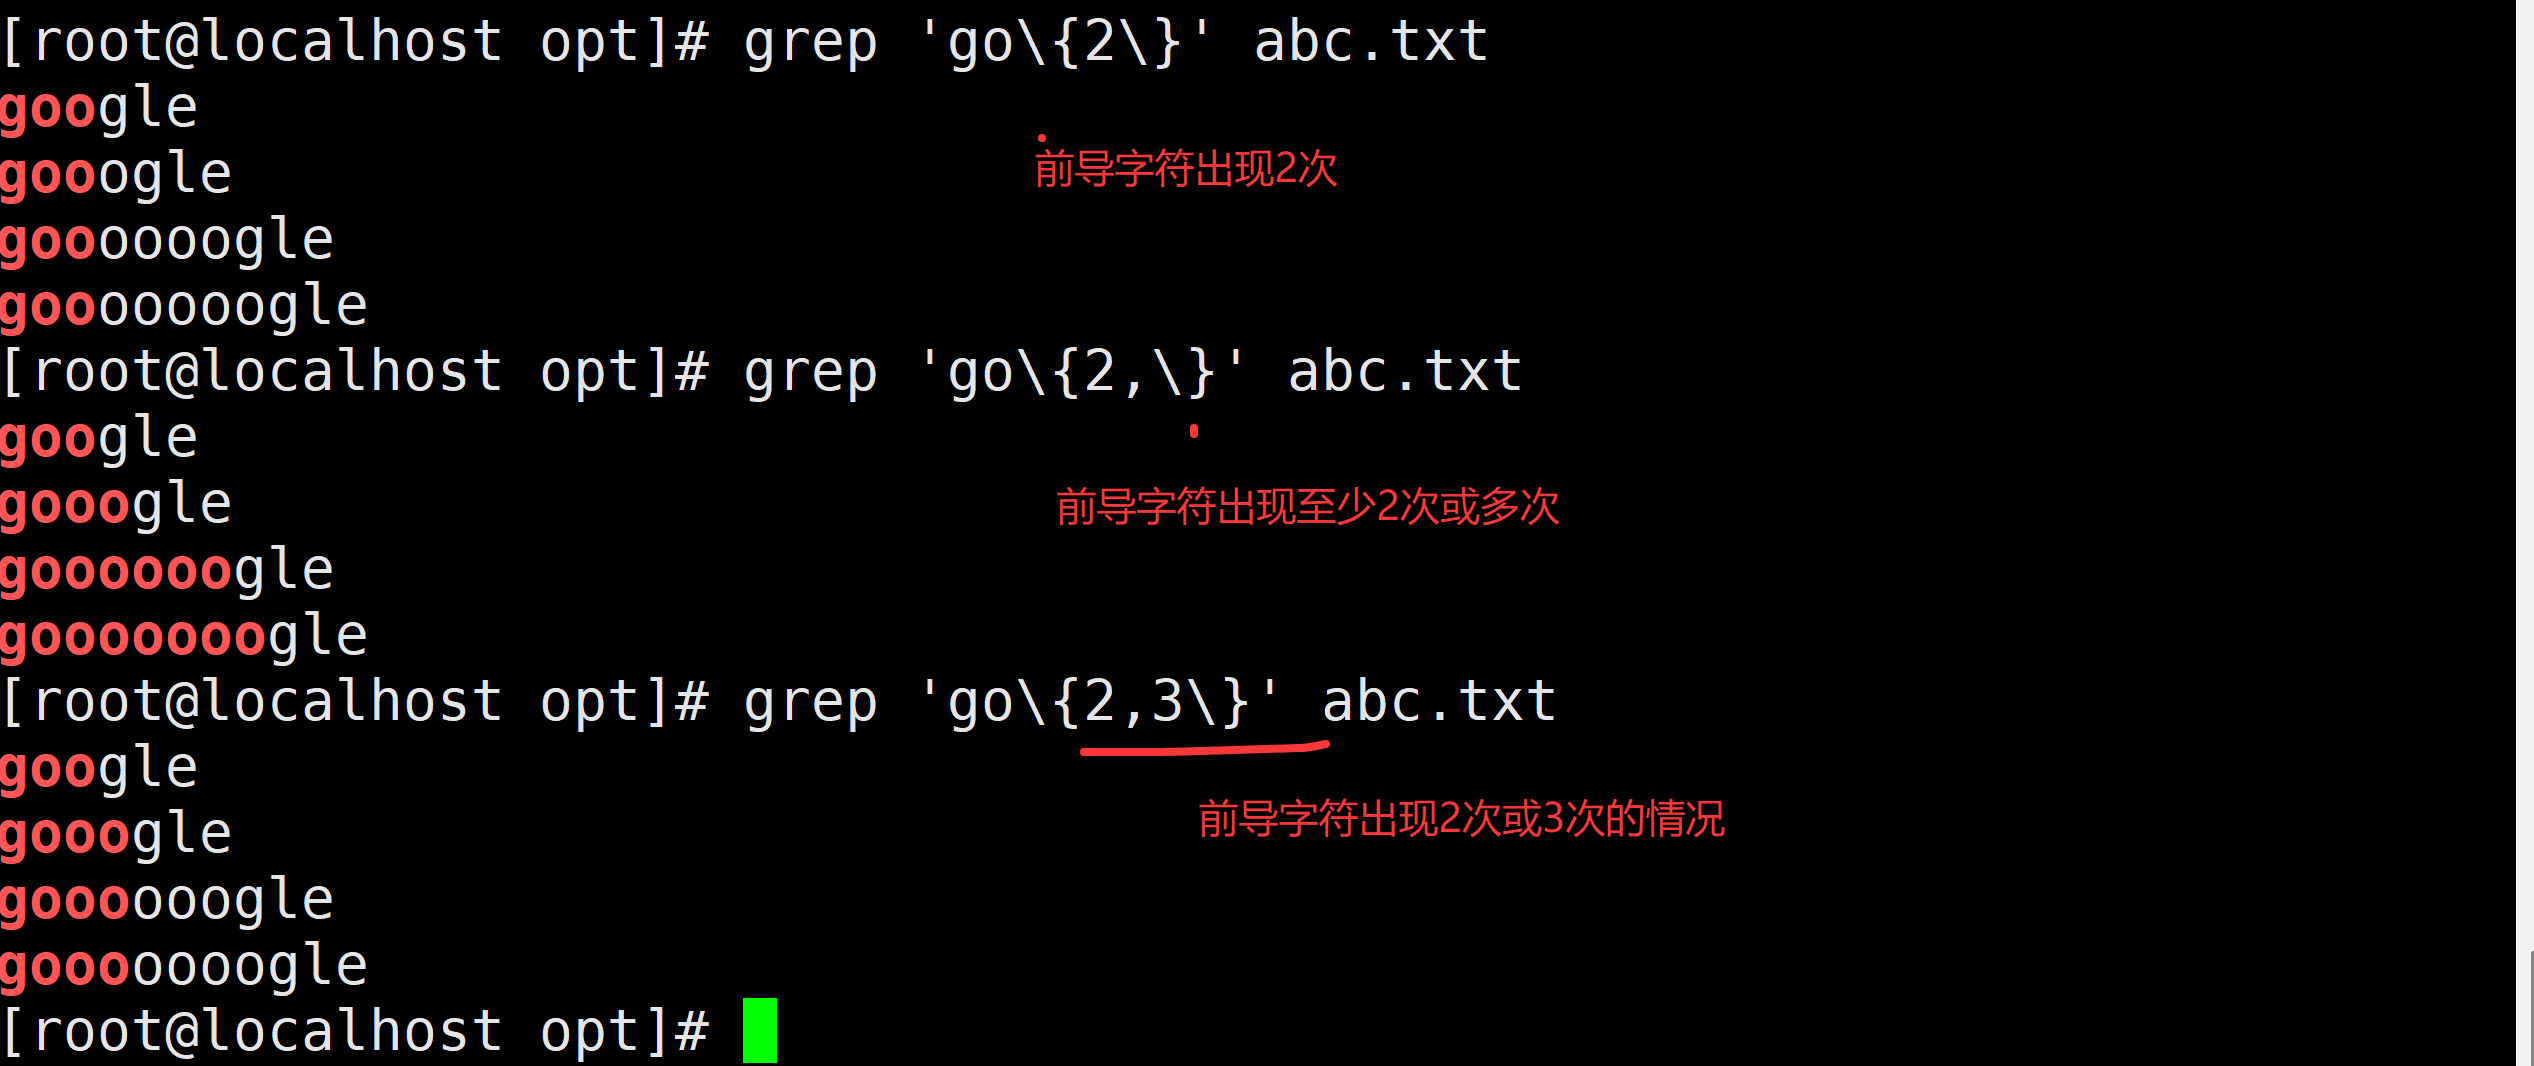
    需求9:请描述以下命令得到的结果是:grep go*\{2\} grep go*\{2,\} grep go*\{2,3\}

    grep 'go\{2\}' :               前导字符o出现两次
    grep 'go\{2,\}' :              前导字符o出现两次以上
    grep 'go\{2,3\}' :             前导字符o出现两次或者3次
    file

    需求10:将192.168.217.129替换成192.168.217.130

    vim abc.txt
    
    :%s/192.168.217.129/192.168.217.130/g
    或者
    :%s#192.168.217.129#192.168.217.130#g
    %  -- 表示对所有行进行操作(若省略则仅对当前行生效)
    s:替换(substitute)命令。
    192.168.217.129 -  旧内容
    192.168.217.130 -  新内容
    g --   全局替换,会替换这一行出现的所有匹配的字符,不加的话只替换第一个
    vim abc.txt
    
    :%s#\(192.168.217\).129#\1.130#g

    需求11:将helloworld yourself 换成hellolilei myself

    vim abc.txt
    
    :%s#\(hello\)world your\(self\)#\1lilei my\2#g
    需求1:请描述以下命令得到的结果是:`grep go*` `grep goo*` `grep ab.*` `grep ab*`
    需求2:请找出以`go`开头的行
    需求3:请找出以`.com`结尾的行
    需求4:请找出文件中哪些行是空行,并显示行号
    需求5:请找出文件中包含`abc`中任意一个字符的行
    需求6:请找出以`hel`开头的单词
    需求7:请找出以`hei`结尾的单词
    需求8:精确查找包含`hello`单词的行
    需求9:请描述以下命令得到的结果是:`grep go*\{2\}` `grep go*\{2,\}` `grep go*\{2,3\}` 
    需求10:将192.168.217.129替换成192.168.217.130
    需求11:将helloworld yourself 换成hellolilei myself
    Perl内置正则:
    \d      匹配数字  [0-9]
    \w      匹配字母数字下划线[a-zA-Z0-9_]
    \s      匹配空格、制表符、换页符[\t\r\n]
    备注:普通正则中可以使用:[0-9] [a-z] [A-Z] [a-zA-Z] [a-Z]
    备注:使用Perl内置正则,需要添加选项-P

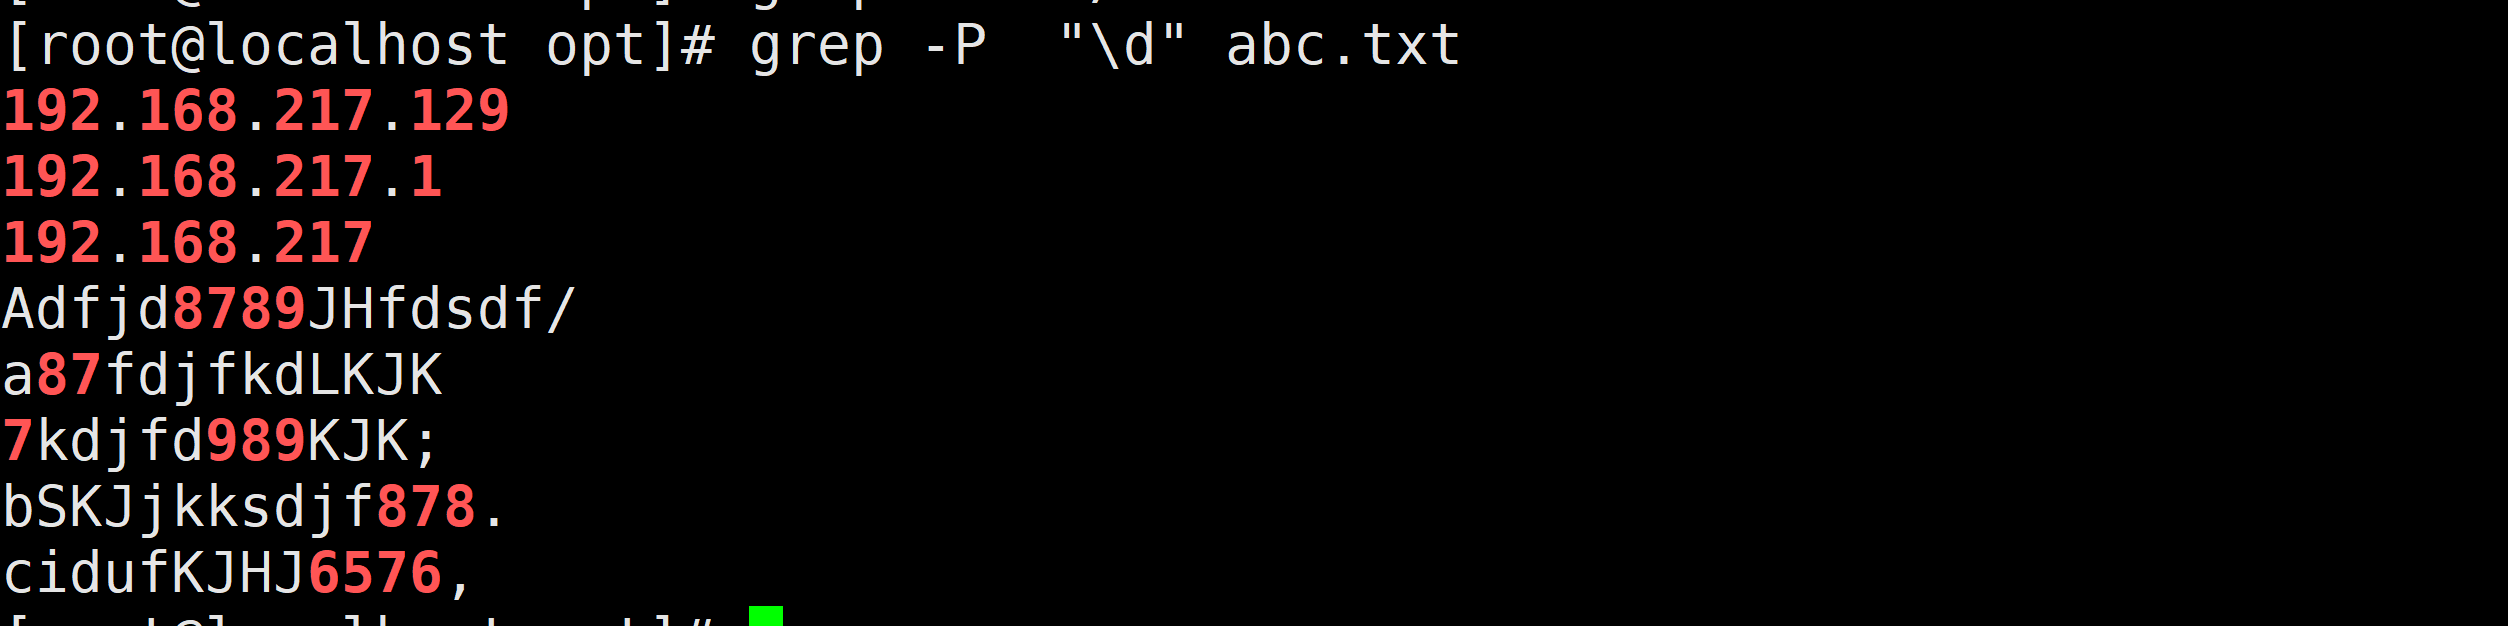
    需求1:找出包含数字的行

    grep [0-9] abc.txt
    grep -P "\d" abc.txt
    file

    需求2:找出包含ip的行

    grep "[0-9]\{3\}\.[0-9]\{3\}\.[0-9]\{3\}\.[0-9]\{1,3\}" abc.txt
    grep -P "\d\{3\}.\d\{3\}.\d\{3\}.\d\{1,3\}" abc.txt
    grep -P "\d"\{3\}\."\d"\{3\}\."\d"\{3\}\."\d"\{1,3\} abc.txt
    需求1:找出包含数字的行
    需求2:找出包含ip的行
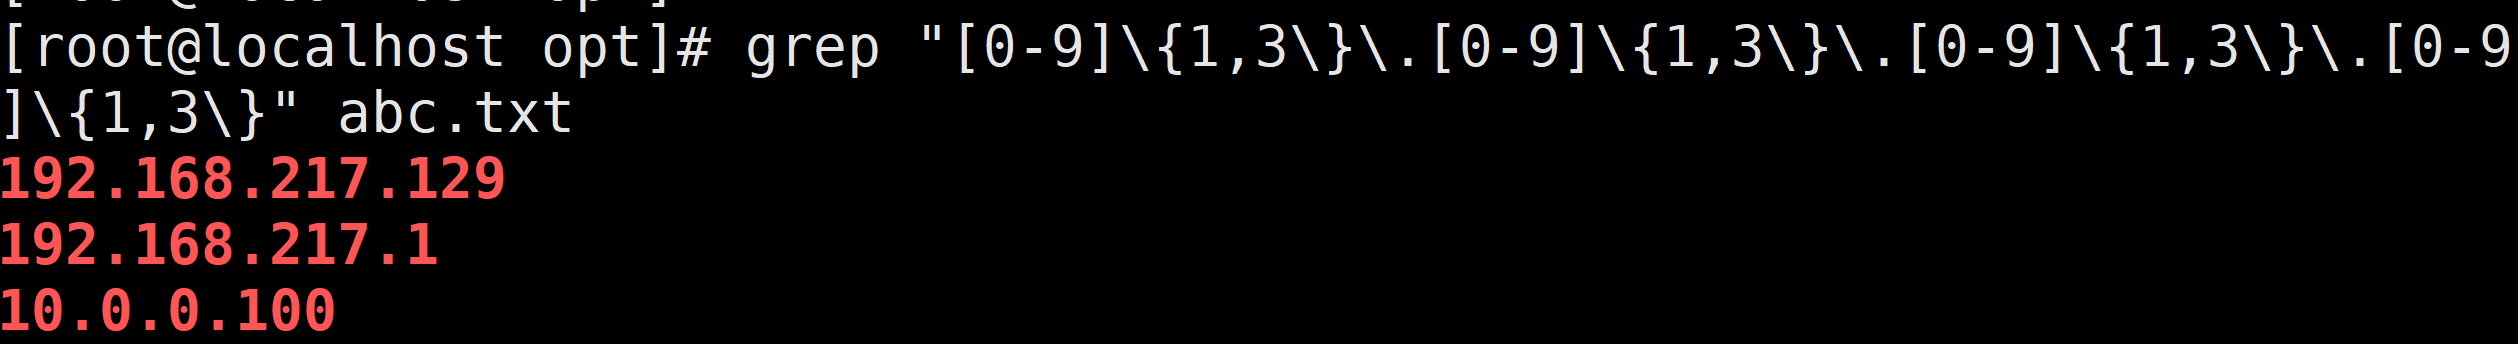
    file

    扩展类的正则表达式 grep -E 或则 egrep

    扩展正则表达式元字符
    +            匹配一个或多个前导字符        bo+    boo bo
    ?            匹配零个或一个前导字符        bo?    b bo
    
    a|b            匹配a或b  [ab]
    ()            组字符       hello myself yourself     (my|your)self
    
    {n}            前导字符重复n次             \{n\}
    {n,}        前导字符重复至少n次              \{n,\}
    {n,m}        前导字符重复n到m次             \{n,m\}

    需求:找出包含ip的行

    grep -E "[0-9]{3}\.[0-9]{3}\.[0-9]{3}\.[0-9]{1,3}" abc.txt
    grep -E "([0-9]{3}\.){3}[0-9]{1,3}" abc.txt
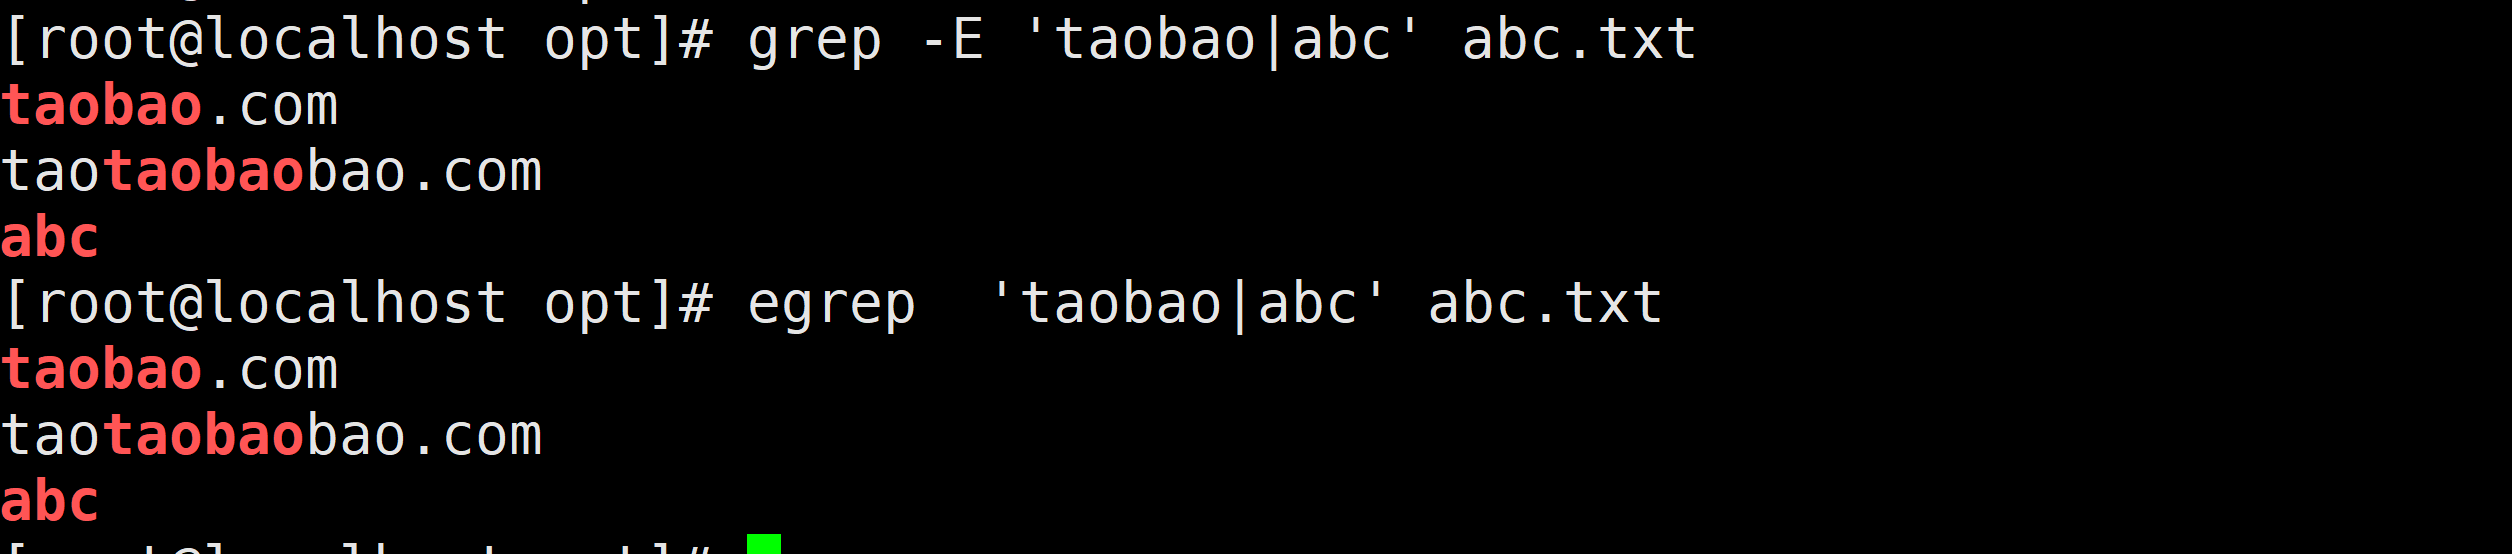
    file

    15.4 课堂练习

    Aieur45869Root0000
    9h847RkjfkIIIhello
    rootHllow88000dfjj
    8ikuioerhfhupliooking
    hello world
    192.168.0.254
    welcome to uplooking.
    abcderfkdjfkdtest
    rlllA899kdfkdfj
    iiiA848890ldkfjdkfj
    abc
    12345678908374
    123456@qq.com
    123456@163.com
    abcdefg@woniu.com23ed
    1、查找不以大写字母开头的行
    grep  -v ^[A-Z] www.txt
    grep  ^[^A-Z] www.txt
    2、查找有数字的行
    grep [0-9] www.txt
    3、查找一个数字和一个字母连起来的
    grep '[0-9][a-zA-Z]\+\|[a-zA-Z][0-9]\+'
    4、查找不以r开头的行
    grep -v ^r www.txt
    5、查找以数字开头的
    grep ^[0-9]  www.txt
    6、查找以大写字母开头的
    grep ^[A-Z] 
    7、查找以小写字母开头的 
    grep ^[a-z] 
    8、查找以点结束的
    grep [.]$
    9、去掉空行
    grep -v ^$
    egrep -v '^$|^#' /etc/ssh/sshd_config
    10、查找完全匹配abc的行
    grep -w abc  www.txt
    11、查找A后有三个数字的行
    grep 'A[0-9]\{3\}' www.txt
    12、统计root在/etc/passwd里出现了几次
    grep -o root /etc/passwd | wc -l
    13、用正则表达式找出IP地址

    16.shell三剑客

    shell三剑客是grep、sed和awk三个工具的简称,因功能强大,使用方便且使用频率高,因此被戏称为三剑客,熟练使用这三个工具可以极大地提升运维效率

    命令 特点 使用场景
    grep 擅长查找过滤 快速查找过滤
    sed 擅长取行和替换 需要快速进行替换/修改文件内容
    awk 擅长取列、统计计算 文件取列、数据切片、对比/比较和统计

    17.shell三剑客之一grep

    3.1 概述

    grep是文本查找或搜索工具,用于查找内容包含指定的范本样式的文本。它会一行一行循环匹配,匹配到相应的值时会先输出,然后换行继续匹配再换行直到所有的内容都匹配完

    3.2 语法

    命令:grep
    作用:行过滤
    语法:grep [选项] 文件名称
    选项参数:
    -i: 不区分大小写    ---------                                            
    -v: 查找不包含指定内容的行,反向选择 ---------
    -w: 按单词搜索 ---------
    -o: 打印匹配关键字
    -c: 统计匹配到的次数
    -f:从文件每一行获取匹配模式
    -n: 显示行号 -----------
    -r: 逐层遍历目录查找
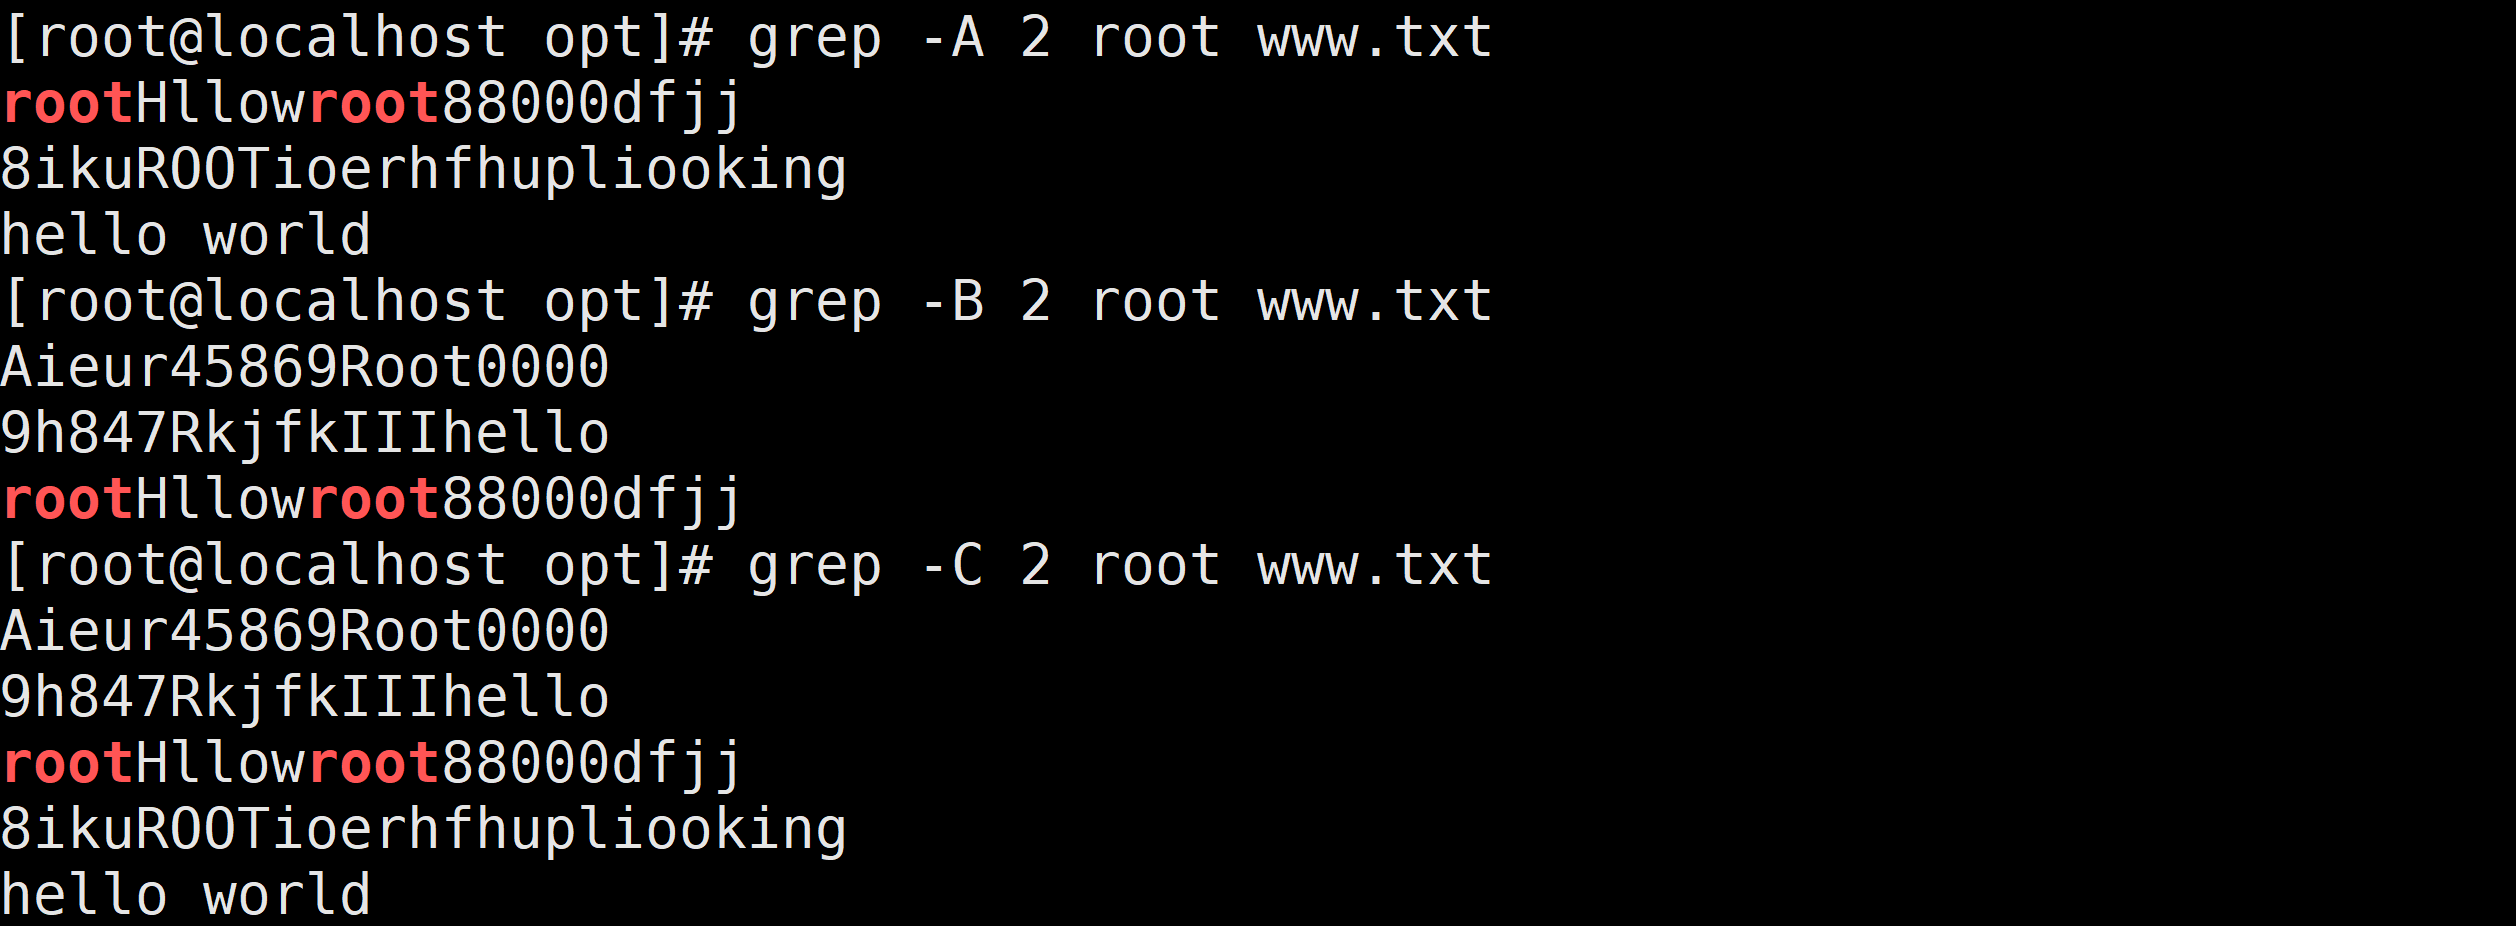
    -A: 显示匹配行及后面多少行    
    -B: 显示匹配行及前面多少行
    -C: 显示匹配行前后多少行
    -l:只列出匹配的文件名
    -L:列出不匹配的文件名
    -e: 使用正则匹配 --------
    -E:使用扩展正则匹配 ----------
    ^key:以关键字开头
    key$:以关键字结尾
    ^$:匹配空行

    -i选项
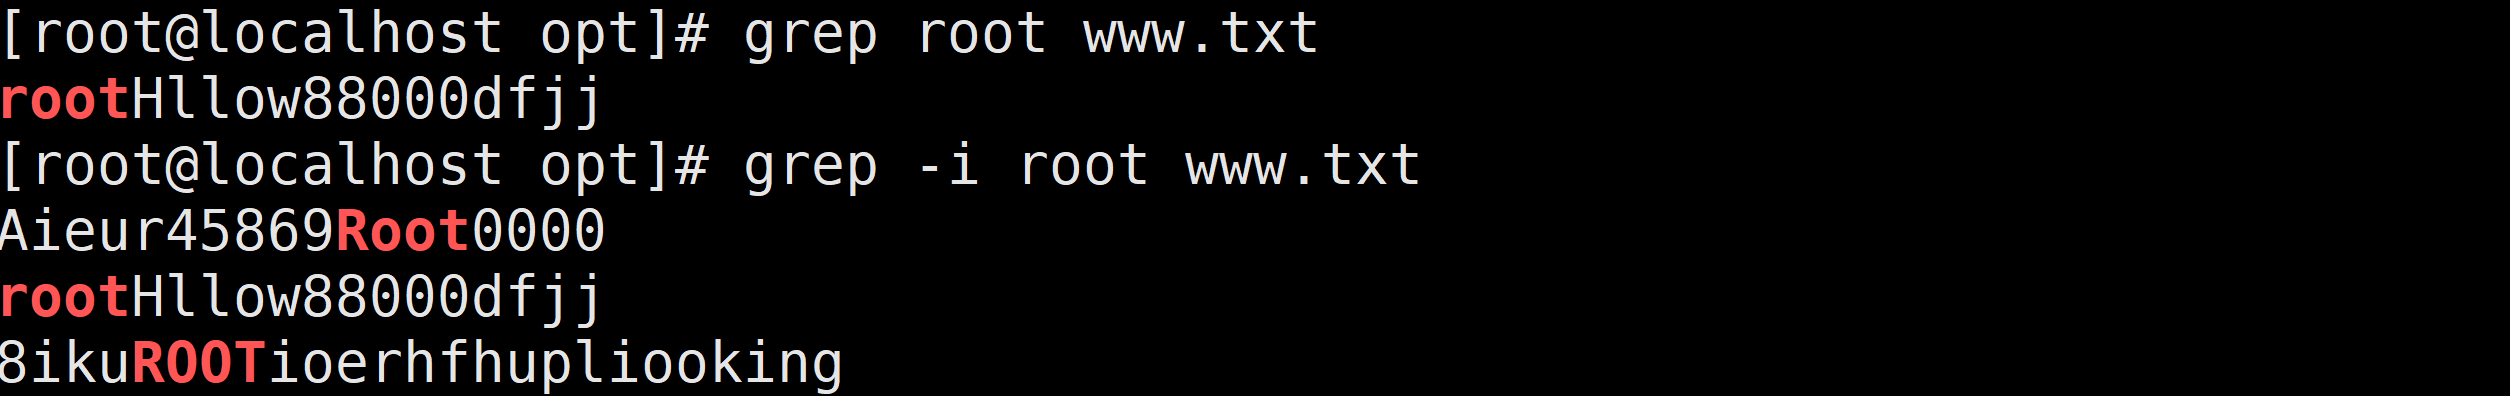
    file

    file

    3.3 课堂案例

    示例:
    # grep -i root passwd                          忽略大小写匹配包含root的行
    # grep -w ftp passwd                           精确匹配ftp单词
    # grep -w woniu passwd                         精确匹配woniu单词
    # grep -wo ftp passwd                          打印匹配到的关键字ftp
    # grep -n root passwd                          打印匹配到root关键字的行号
    # grep -ni root passwd                         忽略大小写匹配统计包含关键字root的行
    # grep -nic root passwd                        忽略大小写匹配统计包含关键字root的行数
    # grep -i ^root passwd                         忽略大小写匹配以root开头的行
    # grep bash$ passwd                            匹配以bash结尾的行
    # grep -n ^$ passwd                            匹配空行并打印行号
    # grep ^# /etc/vsftpd/vsftpd.conf              匹配以#号开头的行
    # grep -v ^# /etc/vsftpd/vsftpd.conf           匹配不以#号开头的行
    # grep -A 5 mail passwd                        匹配包含mail关键字及其后5行
    # grep -B 5 mail passwd                        匹配包含mail关键字及其前5行
    # grep -C 5 mail passwd                        匹配包含mail关键字及其前后5行

    前提:创建a.txt及b.txt文件

    touch a.txt
    touch b.txt
    echo woniu >> a.txt
    echo woniuxy >> a.txt
    echo abc >> a.txt
    echo woniu >> b.txt
    echo hello >> b.txt

    需求1:查找a.txt及b.txt文件中相同的内容woniu

    grep -win "woniu" a.txt b.txt

    需求2:查找a.txt及b.txt文件中相同的行

    grep -nw -f a.txt b.txt
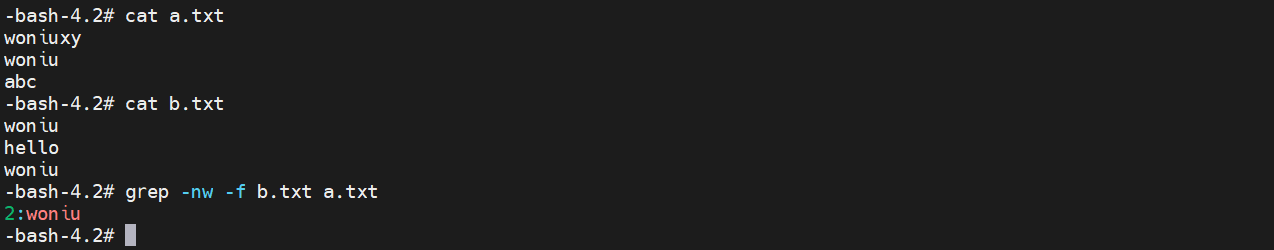
    file

    需求3:查找a.txt及b.txt文件中不相同的行

    grep -nwv -f a.txt b.txt
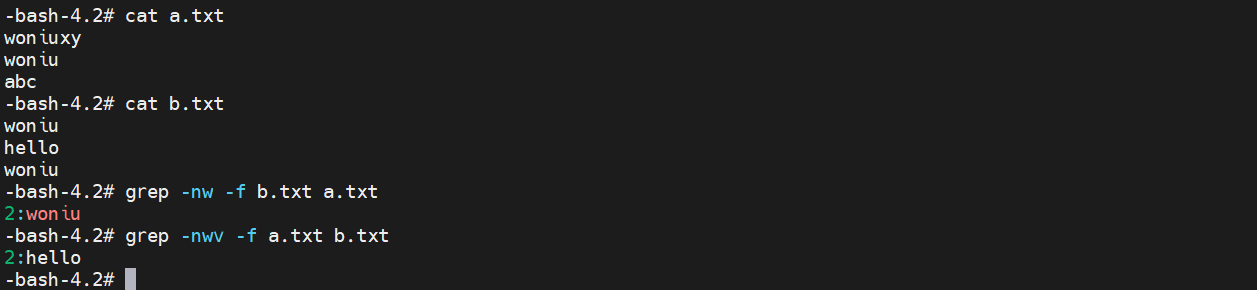
    file

    18.shell三剑客之一sed

    18.1 概述

    sed 是一种流编辑器,它一次处理一行内容。处理时,把当前处理的行存储在临时缓冲区中,称为“模式空间”(patternspace ),接着用sed 命令处理缓冲区中的内容,处理完成后,把缓冲区的内容送往屏幕。然后读入下行,执行下一个循环。如果没有使诸如‘D’ 的特殊命令,那会在两个循环之间清空模式空间,但不会清空保留空间。这样不断重复,直到文件末尾。文件内容并没有改变,除非你使用重定向存储输出或-i功能:主要用来自动编辑一个或多个文件, 简化对文件的反复操作
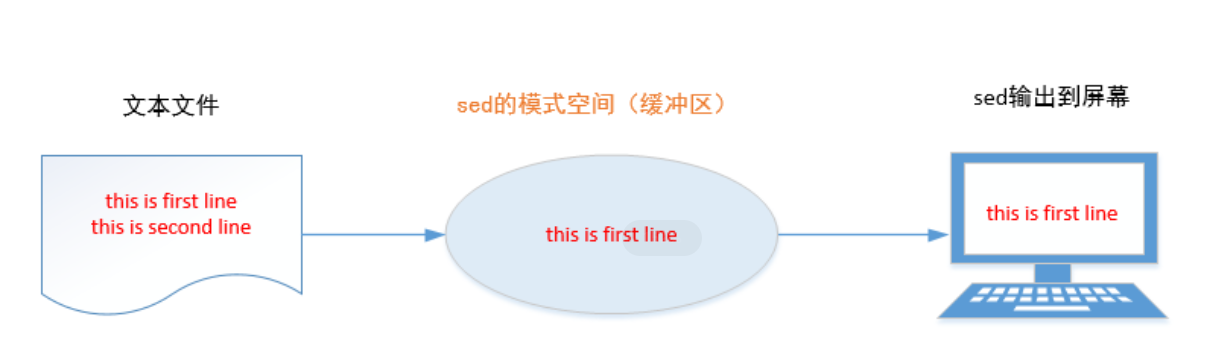
    file

    • 首先sed把当前正在处理的行保存在一个临时缓存区中(称为模式空间),然后处理临时缓冲区中的行,完成后把该行发送到屏幕上
    • sed把每一行都存在临时缓冲区中,对这个副本进行编辑,所以不会修改原文件
    • sed主要用来自动编辑一个或多个文件;简化对文件的反复操作;编写转换程序等

    18.2 语法

    sed常见的语法格式有两种,一种叫命令行模式,另一种叫脚本模式

    命令:sed
    作用:文件编辑
    语法:sed [选项]  'sed的命令|地址定位' 文件名称
    选项参数:
    -e:进行多项编辑,即对输入行应用多条sed命令时使用
    -n:取消默认的输出
    -f:指定sed脚本的文件名
    -r:使用扩展正则表达式
    -i:inplace,原地编辑(修改源文件) 注意:使用-i选项是,不能使用-n及p命令
    常用命令:
    p:打印行数据
    d:删除行数据
    i\:在当前行之前插入文本。多行时除最后一行外,每行末尾需用"\"续行
    a\:在当前行后添加一行或多行。多行时除最后一行外,每行末尾需用“\”续行
    c\:用此符号后的新文本替换当前行中的文本。多行时除最后一行外,每行末尾需用"\"续行  整行替换
    r:从文件中读取输入行
    w:将所选的行写入文件
    !:对所选行以外的所有行应用命令,放到行数之后
    s:用一个字符串替换另一个
    g:在行内进行全局替换
    &:保存查找串以便在替换串中引用   \(string\)
    =:打印行号

    注意:sed使用的正则表达式是括在斜杠线”/正则表达式/“之间的模式

    sed和正则的综合运用

    1、正则表达式必须以”/“前后规范间隔
    例如:sed '/root/d' file
    例如:sed '/^root/d' file
    
    2、如果匹配的是扩展正则表达式,需要使用-r选来扩展sed
    grep -E
    sed -r
    + ? () {n,m} | \d
    注意:         
    在正则表达式中如果出现特殊字符(^$.*/[]),需要以前导 "\" 号做转义
    eg:sed '/\$foo/p' file
    
    3、逗号分隔符
    例如:sed '5,7d' file                      删除5到7行
    例如:sed '/root/,/ftp/d' file    
    删除第一个匹配字符串"root"到第一个匹配字符串"ftp"的所有行本行不找 循环执行
    
    4、组合方式
    例如:sed '1,/foo/d' file                    删除第一行到第一个匹配字符串"foo"的所有行
    例如:sed '/foo/,+4d' file                    删除从匹配字符串”foo“开始到其后四行为止的行
    例如:sed '/foo/,~3d' file                    删除从匹配字符串”foo“开始删除到3的倍数行(文件中)
    例如:sed '1~5d' file                        从第一行开始删每五行删除一行
    例如:sed -nr '/foo|bar/p' file            显示配置字符串"foo"或"bar"的行
    例如:sed -n '/foo/,/bar/p' file            显示匹配从foo到bar的行
    例如:sed '1~2d'  file                        删除奇数行
    例如:sed '0-2d'   file                    删除偶数行 sed '1~2!d'  file
    
    5、特殊情况
    例如:sed '$d' file                        删除最后一行
    例如:sed '1d' file                        删除第一行
    
    6、其他:
    sed 's/.//' a.txt                          删除每一行中的第一个字符
    sed 's/.//2' a.txt                          删除每一行中的第二个字符
    sed 's/.//N' a.txt                          从文件中第N行开始,删除每行中第N个字符(N>2)
    sed 's/.$//' a.txt                          删除每一行中的最后一个字符

    前提:创建一个文件abc.txt,在文件中添加如下数据:

    root:x:0:0:root:/root:/bin/bash
    bin:x:1:1:bin:/bin:/sbin/nologin
    daemon:x:2:2:daemon:/sbin:/sbin/nologin
    adm:x:3:4:adm root:/var/adm:/sbin/nologin
    lp:x:4:7:lp:/var/spool/lpd:/sbin/nologin
    
    298374837483
    
    192.168.217.129
    10.1.1.1
    
    disable=YES

    需求1:使用p命令打印abc.txt中的所有内容

    sed 'p' abc.txt

    需求2:使用-n选项,p命令打印abc.txt中的所有内容

    sed -n 'p' abc.txt

    需求3:打印第1行内容

    sed -n '1p' abc.txt

    需求4:打印第1行到第5行内容

    sed -n '1,5p' abc.txt

    需求5:打印最后1行内容

    sed -n '$p' abc.txt

    需求6:删除第1行内容

    sed -n '1d' abc.txt
    sed '1d' abc.txt

    需求7:删除最后1行内容

    sed '$d' abc.txt

    需求8:删除第1行到第3行内容

    sed '1,3d' abc.txt

    需求9:在第1行的后面添加hello

    sed '1ahello' abc.txt

    需求10:在第5行的前面添加world

    sed '5iworld' abc.txt

    需求11:将第1行的内容替换为hello world

    sed '1chello world' abc.txt

    需求12:将/etc/hosts文件中的内容添加到第3行之后

    sed '3r /etc/hosts' abc.txt

    需求13:将abc.txt文件中的第1行到第3行写入到文件a.txt中

    sed '1,3w a.txt' abc.txt

    需求14:将abc.txt中包含root字符的行写入到文件a.txt中

    sed '/root/w a.txt' abc.txt

    需求15:将包含abc.txt中包含数字的行写入到文件a.txt中

    sed '/[0-9]/w a.txt' abc.txt

    需求16:将abc.txt中的第一个root替换为ROOT

    sed 's/root/ROOT/' abc.txt

    需求17:将abc.txt中的所有root替换为ROOT

    sed 's/root/ROOT/g' abc.txt

    需求18:将abc.txt中的所有/sbin/nologin 替换为 /bin/bash

    sed 's#/sbin/nologin#/bin/bash#g' abc.txt

    需求19:将abc.txt中的空行替换掉

    sed '/^$/d' abc.txt

    需求20:将abc.txt中的第1行到第3行注释掉

    sed '1,3s/^/#/' abc.txt

    需求21:注释掉以root开头或者以lp开头的行

    sed -r 's/^root|^lp/#&/' abc.txt

    需求22:打印以bash结尾的行的行号

    sed -n '/bash$/=' abc.txt

    需求23:打印以以root开头或者lp开头的行,并且打印行号

    sed -n -r '/^root|^lp/=' abc.txt

    需求24:在abc.txt文件中的第5行的前面插入“hello world”;在abc.txt文件的第3行下面插入“哈哈哈哈”

    sed -e '5ihello world' -e '3a哈哈哈哈' abc.txt

    需求25:将abc.txt中的所有root替换为ROOT,修改源文件

    sed -i 's/root/ROOT/g' abc.txt

    需求26:将abc.txt中的disable=YES替换为disable=NO,修改源文件

    sed -i 's/disable=YES/disable=NO/' abc.txt

    18.3 课堂案例

    需求1:过滤vsftpd.conf文件中以#开头的行和空行

    grep -Ev "^#|^$" /etc/vsftpd/vsftpd.conf
    sed -r '/^#|^$/d' /etc/vsftpd/vsftpd.conf

    需求2:过滤ifconfig ens33命令结果中的IP

    ifconfig ens33 | sed -nr '/[0-9]{1,3}\.[0-9]{1,3}\.[0-9]{1,3}\.[0-9]{1,3}/p' | sed -r 's/[a-z]|[A-Z]//g'
    
    ifconfig ens33 | sed -nr '/[0-9]{1,3}\.[0-9]{1,3}\.[0-9]{1,3}\.[0-9]{1,3}/p' | sed -r 's/[a-z]|[A-Z]//g' | sed 's/ /\n/g' | sed '/^$/d'

    18.4 课堂练习

    前提:将/etc/passwd文件中的前面20行复制到本地目录中a.txt文件中

    sed  '1,20w a.txt' /etc/passwd

    需求1:将a.txt任意数字替换成空

    sed  's/[0-9]/ /g' a.txt

    需求2:去a.txt掉文件1-5行中的数字、冒号、斜杠

    sed -r '1,5s/[0-9]|:|\///g' a.txt | head -5

    需求3:匹配root关键字替换成hello woniu,并保存到test.txt文件中

    sed -e 's/root/hello woniu/g' -e 'w test.txt' abc.txt

    需求4:删除vsftpd.conf配置文件里所有注释的行及空行(不要直接修改原文件)

    sed -r '/^#|^$/d' /etc/vsftpd/vsftpd.conf

    需求5:使用sed命令截取自己的ip地址

    需求6:使用sed命令一次性截取ip地址、广播地址、子网掩码

    需求7:注释掉文件的2-3行和匹配到以root开头或者以ftp开头的行

    sed '2,3s/^/#/' a.txt | sed -r 's/^root|^ftp/#&/'

    19.shell三剑客之一awk

    1、awk基础

    1.1 概述

    awk是一种编程语言,主要用于在linux/unix下对文本和数据进行处理,是linux/unix下的一个工具。数据可以来自标准输入、一个或多个文件,或其它命令的输出。

    awk的处理文本和数据的方式:逐行扫描文件,默认从第一行到最后一行,寻找匹配的特定模式的行,并在这些行上进行你想要的操作。

    awk分别代表其作者姓氏的第一个字母。因为它的作者是三个人,分别是Alfred Aho、Brian Kernighan、Peter Weinberger。

    gawk是awk的GNU版本,它提供了Bell实验室和GNU的一些扩展。

    下面介绍的awk是以GNU的gawk为例的,在linux系统中已把awk链接到gawk,所以下面全部以awk进行介绍。
    file

    1.2 使用方式

    命令:awk
    作用:文本和数据进行处理
    语法:awk [选项]  'commands' 文件名称
    选项参数:
    -F:定义字段分割符号,默认的分隔符是空格
    -v:定义变量并赋值

    命名部分(commands)

    正则表达式,地址定位
    示例:
    '/root/{awk语句}'                            sed中: '/root/p'
    'NR==1,NR==5{awk语句}'                    sed中: '1,5p'
    '/^root/,/^ftp/{awk语句}'                  sed中:'/^root/,/^ftp/p'
    
    {awk语句1;awk语句2;...}
    示例:
    '{print $0;print $1}'                    sed中:'p'
    'NR==5{print $0}'                        sed中:'5p'
    注:awk命令语句间用分号间隔
    
    BEGIN...END....
    示例:
    'BEGIN{awk语句};{处理中};END{awk语句}'
    'BEGIN{awk语句};{处理中}'
    '{处理中};END{awk语句}'

    引用shell变量需用双引号引起

    1.3 工作原理

    awk -F: '{print $1,$3}' /etc/passwd
    1. awk使用一行作为输入,并将这一行赋给内部变量$0,每一行也可称为一个记录,以换行符(RS)结束

    2. 每行被间隔符:(默认为空格或制表符)分解成字段(或域),每个字段存储在已编号的变量中,从$1开始

      问:awk如何知道用空格来分隔字段的呢?

      答:因为有一个内部变量FS来确定字段分隔符。初始时,FS赋为空格

      制表符(Tab)是一种特殊字符,ASCII 码为 9(十六进制 0x09),通常写作 \t。作用是在在文本中创建水平对齐的列,类似表格的效果。可变宽度(默认 8 个字符位置),自动对齐到下一个制表位(Tab stop)
      显示制表符 :  cat   -T
      [root@localhost ~]# cat -T sss.txt 
      a^Ib^Ic
      e^If^Ig
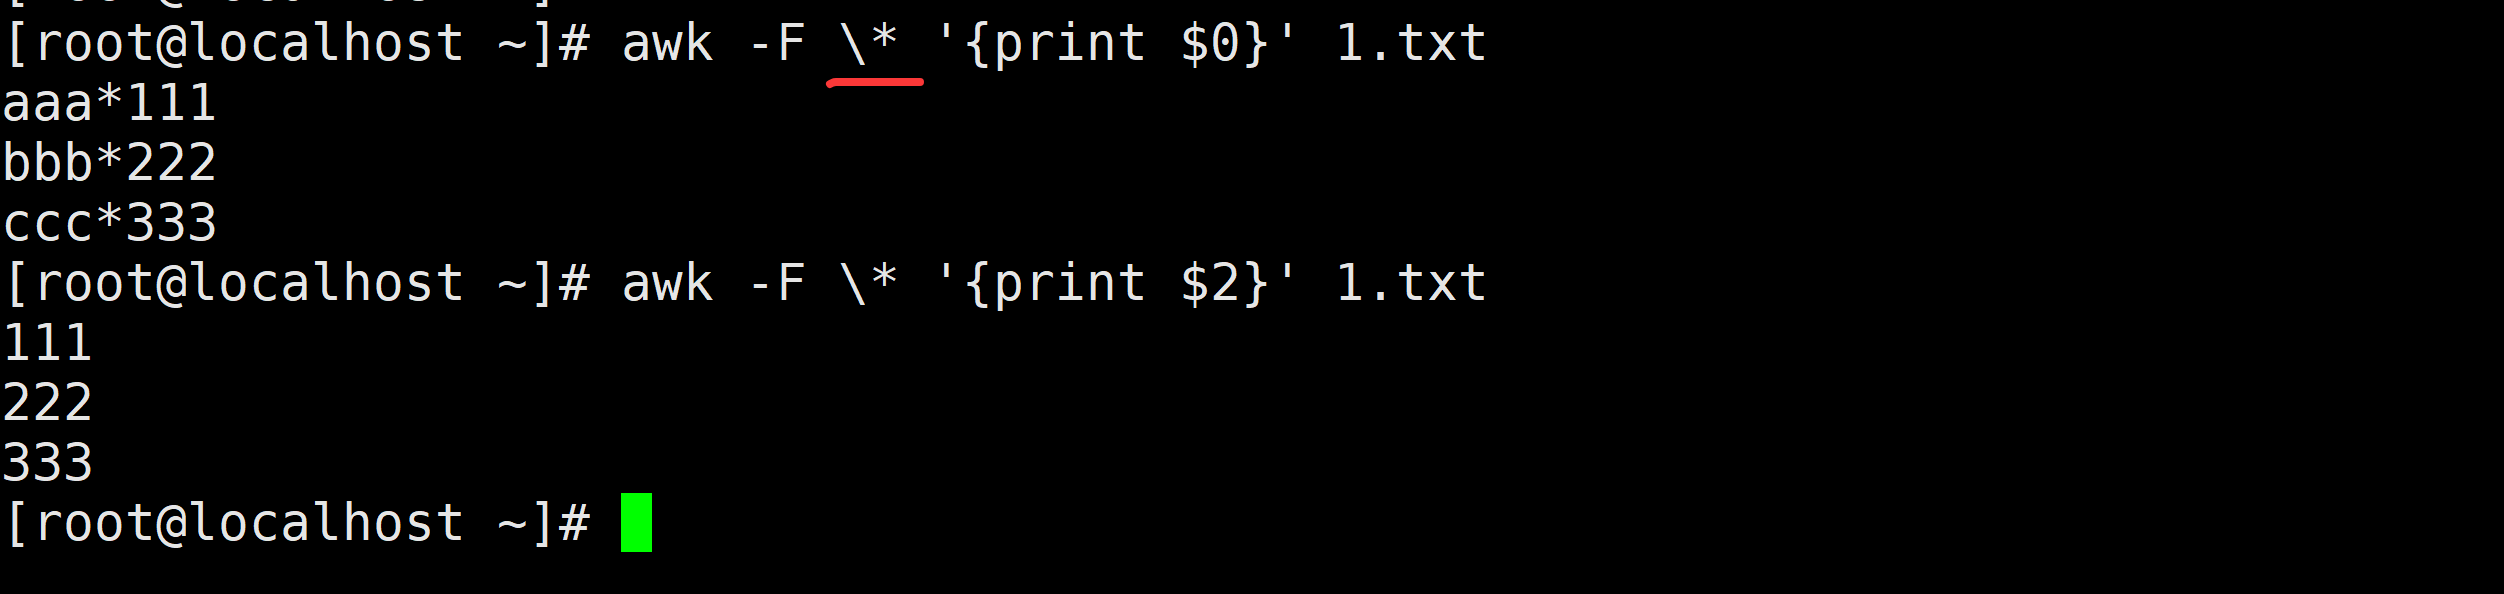
    3. awk使用print函数打印字段,打印出来的字段会以空格分隔,因为\$1,\$3之间有一个逗号。逗号比较特殊,它映射为另一个内部变量,称为输出字段分隔符OFS,OFS默认为空格

    4. awk处理完一行后,将从文件中获取另一行,并将其存储在$0中,覆盖原来的内容,然后将新的字符串分隔成字段并进行处理。该过程将持续到所有行处理完毕

    2、awk内置变量

    2.1 内部变量

    变量 变量说明 备注
    $0 当前处理行的所有记录
    \$1,\$2,\$3…\$n 文件中每行以间隔符号分割的不同字段 awk -F: ‘{print \$1,\$3}’
    NF 当前记录的字段数(列数) awk -F: ‘{print NF}’
    $NF 最后一列 $(NF-1)表示倒数第二列
    FNR/NR 行号
    FS 定义间隔符 ‘BEGIN{FS=”:”};{print \$1,$3}’
    OFS 定义输出字段分隔符,默认空格 ‘BEGIN{OFS=”\t”};print \$1,$3}’
    RS 输入记录分割符,默认换行 ‘BEGIN{RS=”\t”};{print $0}’
    ORS 输出记录分割符,默认换行 ‘BEGIN{ORS=”\n\n”};{print \$1,$3}’
    FILENAME 当前输入的文件名

    格式化输出:

    %s 字符类型 strings
    %d 数值类型
    示例:%-20s

    -表示左对齐,默认是右对齐

    printf默认不会在行尾自动换行,加\n

    20表示20个字符

    完整示例:

    awk -F: ‘{printf “%-20s %-20s %-20s\n”, $1,$2,$3}’ abc.txt
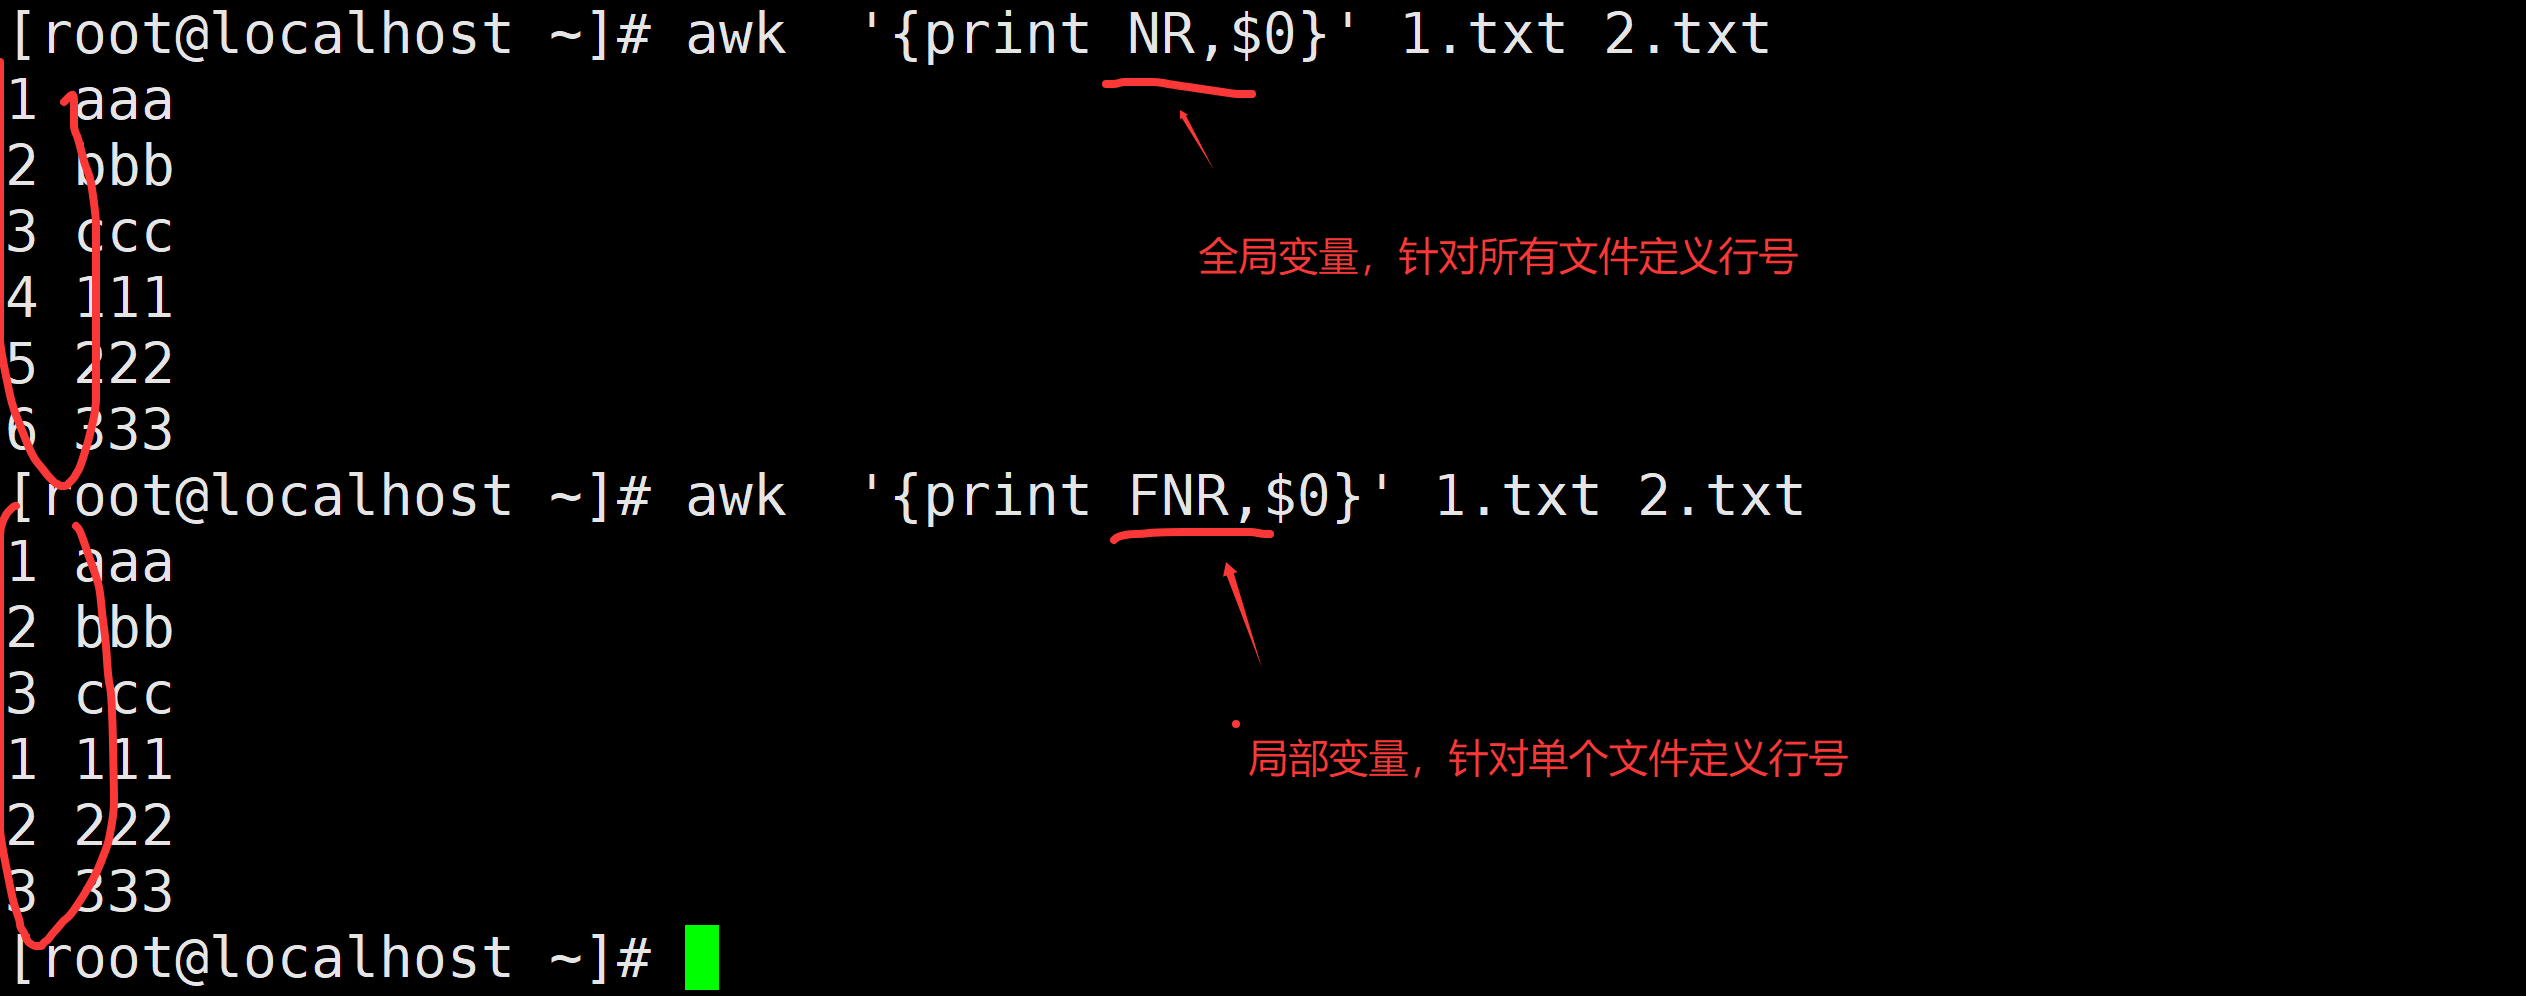
    file

    file

    2.2 课堂案例

    前提:在家目录中创建文件abc.txt,在文件中添加如下数据:

    root:x:0:0:root:/root:/bin/bash
    bin:x:1:1:bin:/bin:/sbin/nologin
    daemon:x:2:2:daemon:/sbin:/sbin/nologin
    adm:x:3:4:adm root:/var/adm:/sbin/nologin
    root:x:4:7:lp:/var/spool/lpd:/sbin/nologin
    woniuxy@com.cn
    aa@bb@cc@dd@ee

    需求1:以冒号进行分割,获取第一列与倒数第二列,最后一列的数据

    awk -F: '{print $1,$(NF-1),$NF}' abc.txt

    需求2:以冒号进行分割,获取第一列与倒数第二列,最后一列的数据,并显示每一行的总列数

    awk -F: '{print $1,$(NF-1),$NF,NF}' abc.txt

    需求3:打印包含root的行数据

    awk '/root/{print $0}' abc.txt

    需求4:打印包含root的行数据,以冒号进行分割,只显示第一列与第二列

    awk -F: '/root/{print $1,$2}' abc.txt

    需求5:显示第一行到第三行的数据

    awk 'NR==1,NR==3{print $0}' abc.txt

    需求6:显示第一行到第三行中以root开头的数据

    awk 'NR==1,NR==3{print $0}' abc.txt | awk '/^root/{print $0}'

    需求7:定义间隔符为@,打印第一列数据以及第二列数据

    awk -F@ '{print $1,$2}' abc.txt
    awk 'BEGIN{FS="@"};{print $1,$2}' abc.txt

    需求8:定义间隔符为@,定义输出字段分隔符为制表符\t,打印第一列与最后一列数据

    awk 'BEGIN{FS="@";OFS="\t\t"};{print $1,$NF}' abc.txt
    OFS="\t\t":指定输出字段分隔符为两个制表符(增强可读性)。
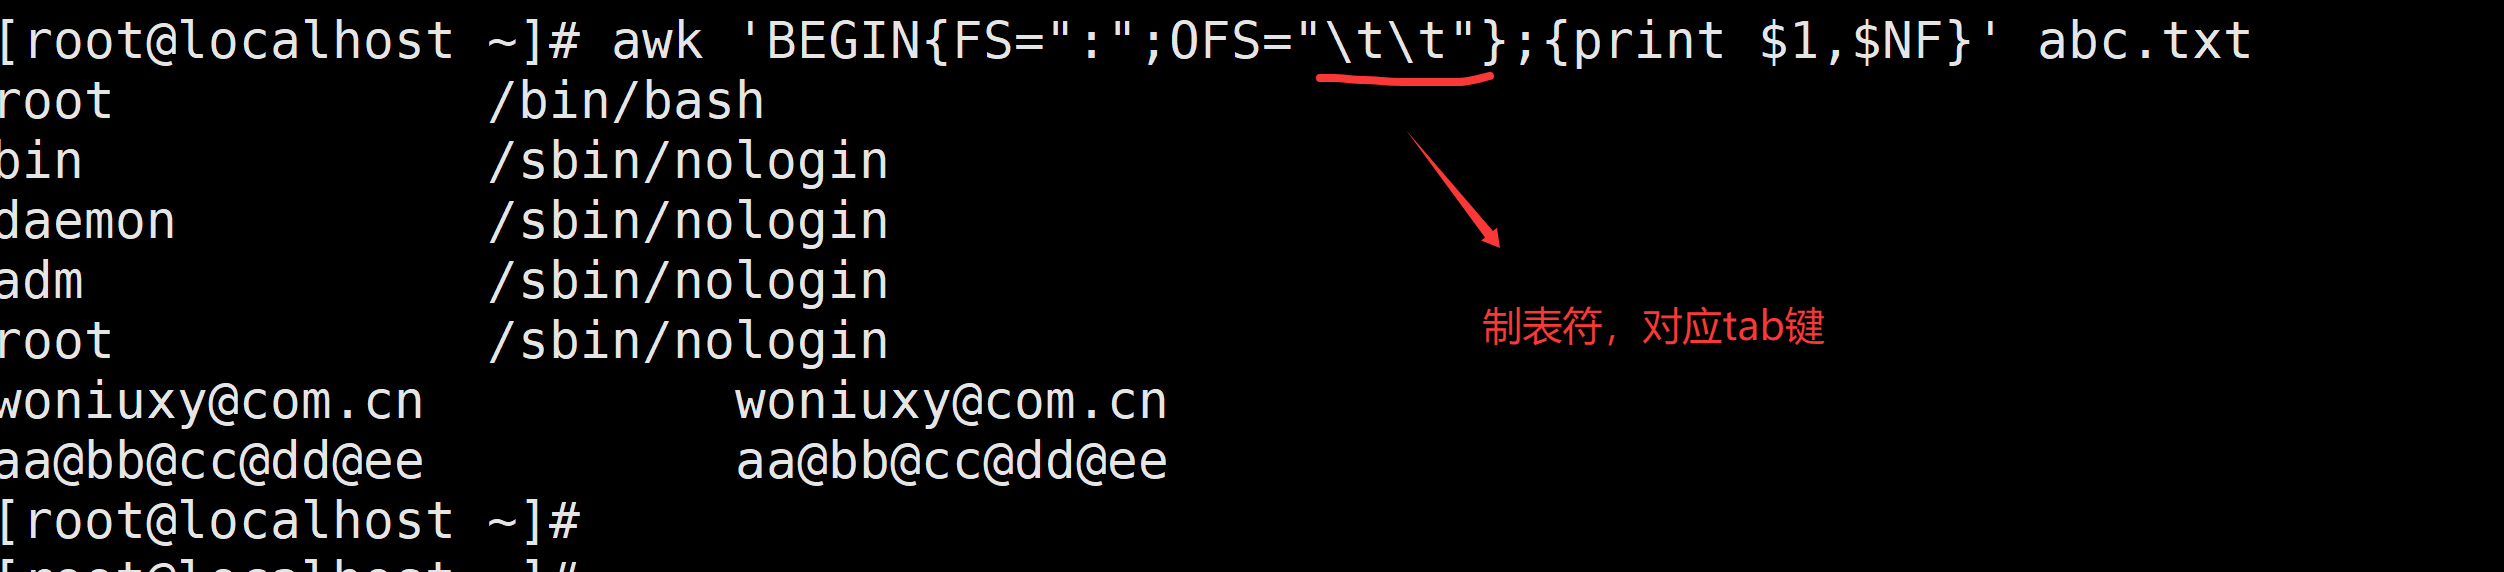
    file

    需求9:以冒号进行分割,打印第一列,第二列,第三列数,格式化输出-左对齐,20个字符
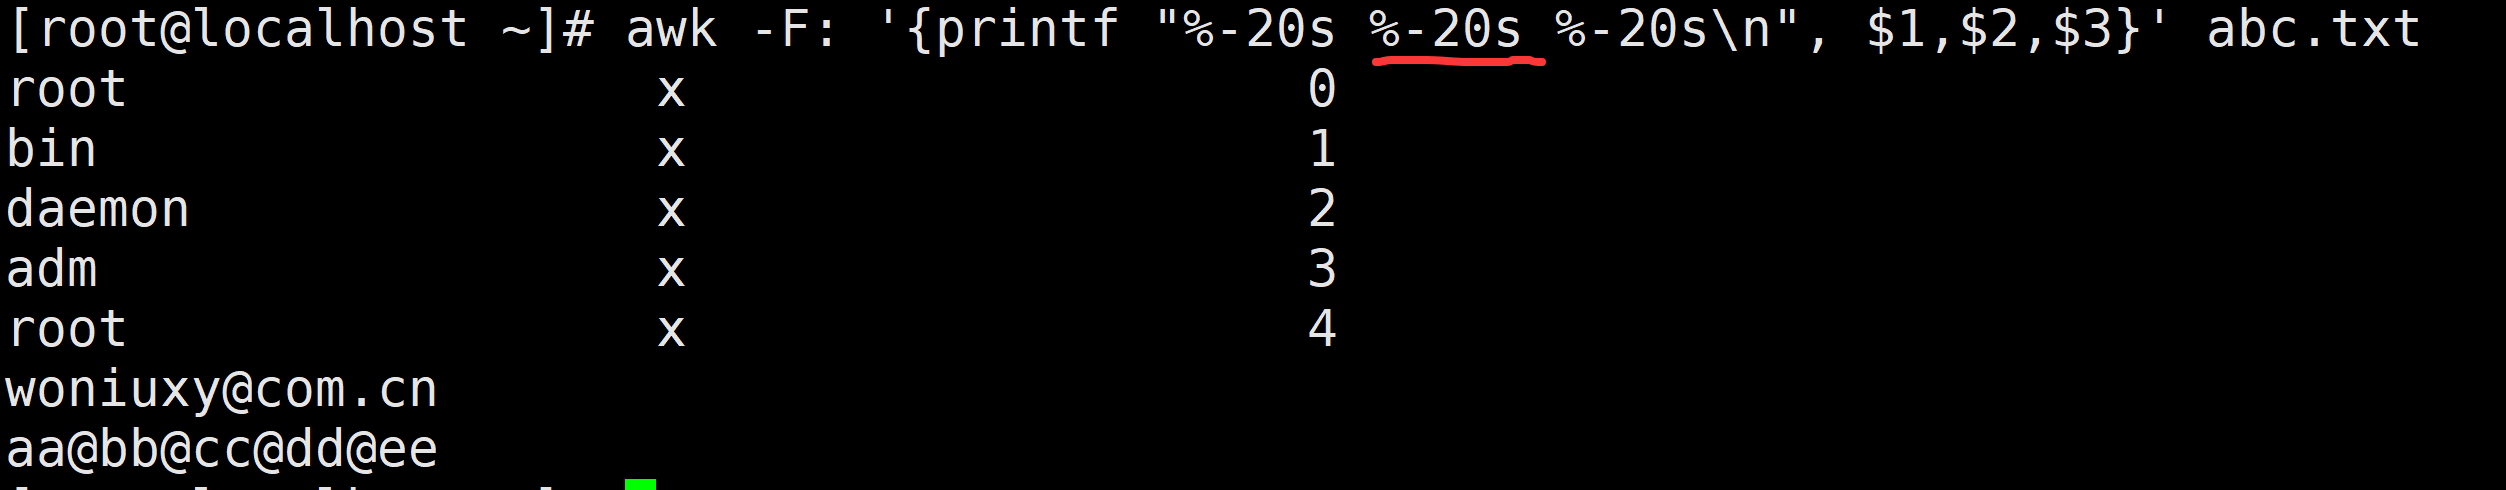
    file

    awk -F: '{printf "%-20s %-20s %-20s\n", $1,$2,$3}' abc.txt
    %s:输出字符串类型字段。
    -:左对齐(默认右对齐)。
    20:字段宽度为 20 个字符,不足则补空格。
    \n:每行末尾添加换行符。

    在 awk 中,print 和 printf 是两种常用的输出命令,它们的主要区别在于格式化控制和输出行为。以下是详细对比和示例:

    特性 print printf
    格式化 自动分隔字段,无法自定义格式 必须使用格式化字符串,完全自定义
    换行符 自动在末尾添加换行符 \n 不自动添加,需手动指定 \n
    参数处理 直接打印所有参数 需要格式化字符串匹配参数数量

    3、begin-end语法

    3.1 语法
    BEGIN{开始处理之前};{处理中};END{处理结束后}
    BEGIN:表示在程序开始前执行
    END:表示所有文件处理完后执行
    3.2 课堂案例

    需求:以下格式打印abc.txt中第一列与最后一列数据

    Login_shell        Login_home
    ************************
    /bin/bash            /root
    /sbin/nologin        /bin
    /sbin/nologin        /sbin
    ************************************
    
    awk -F: 'BEGIN{print "Login_shell\t\tLogin_home\n***************************************************"};{print $1"\t\t"$NF};END{print "***************************************************"}' abc.txt
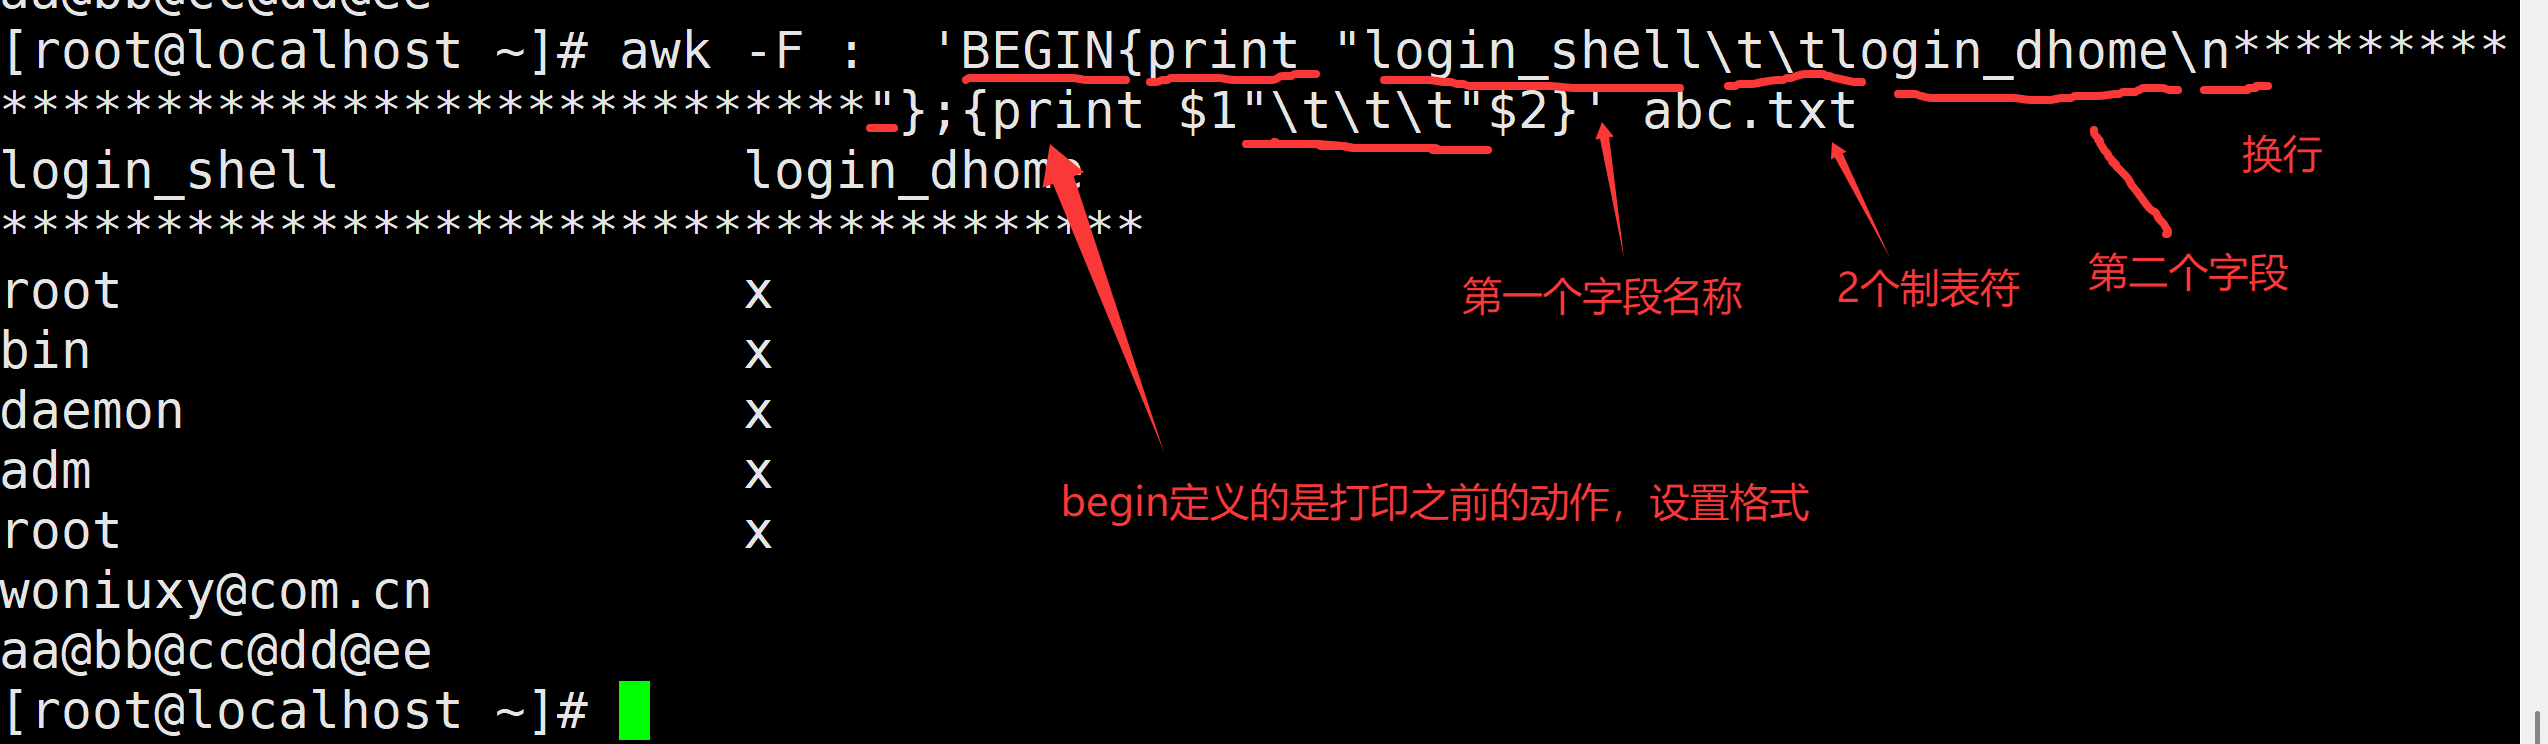
    file

    需求2:以下格式打印abc.txt中第一行到第三行中第一列与最后一列数据

    awk -F: 'BEGIN{print "Login_shell\t\tLogin_home\n***************************************************"};NR==1,NR==3{print $1"\t\t"$NF};END{print "***************************************************"}' abc.txt
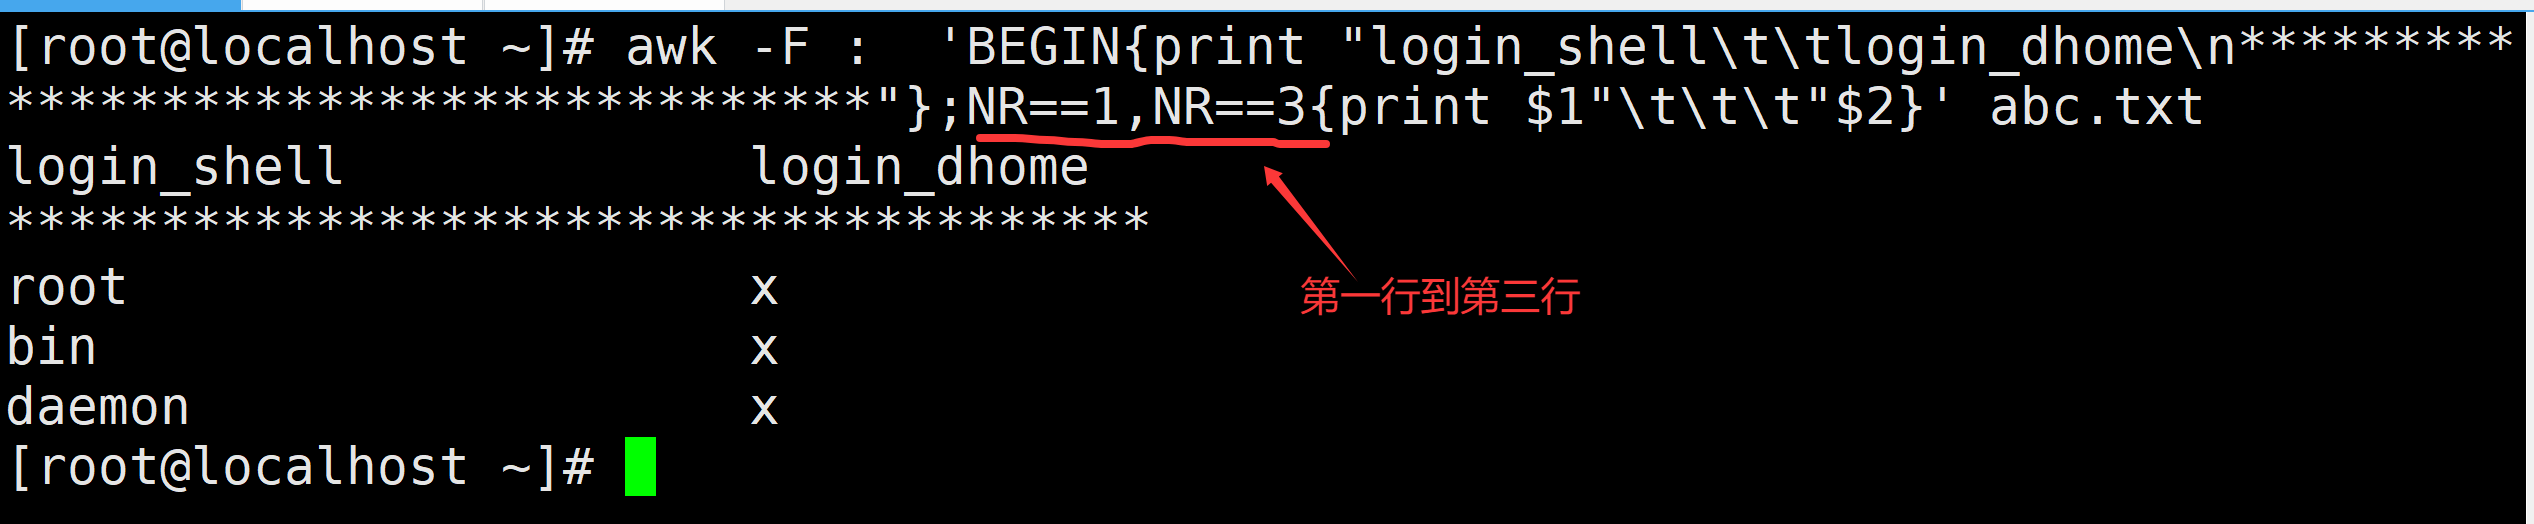
    file

    3.3 课堂练习

    需求:打印/etc/passwd里的用户名、家目录及登录shell,以下格式打印

    u_name      h_dir       shell
    ***************************
    ***************************
    [root@localhost opt]# awk -F: 'BEGIN{print "u_name\t\th_dir\t\tshell\n************************************************"};{print $1"\t\t"$(NF-1)"\t\t"$NF};END{print "***********************************************************"}' abc.txt 
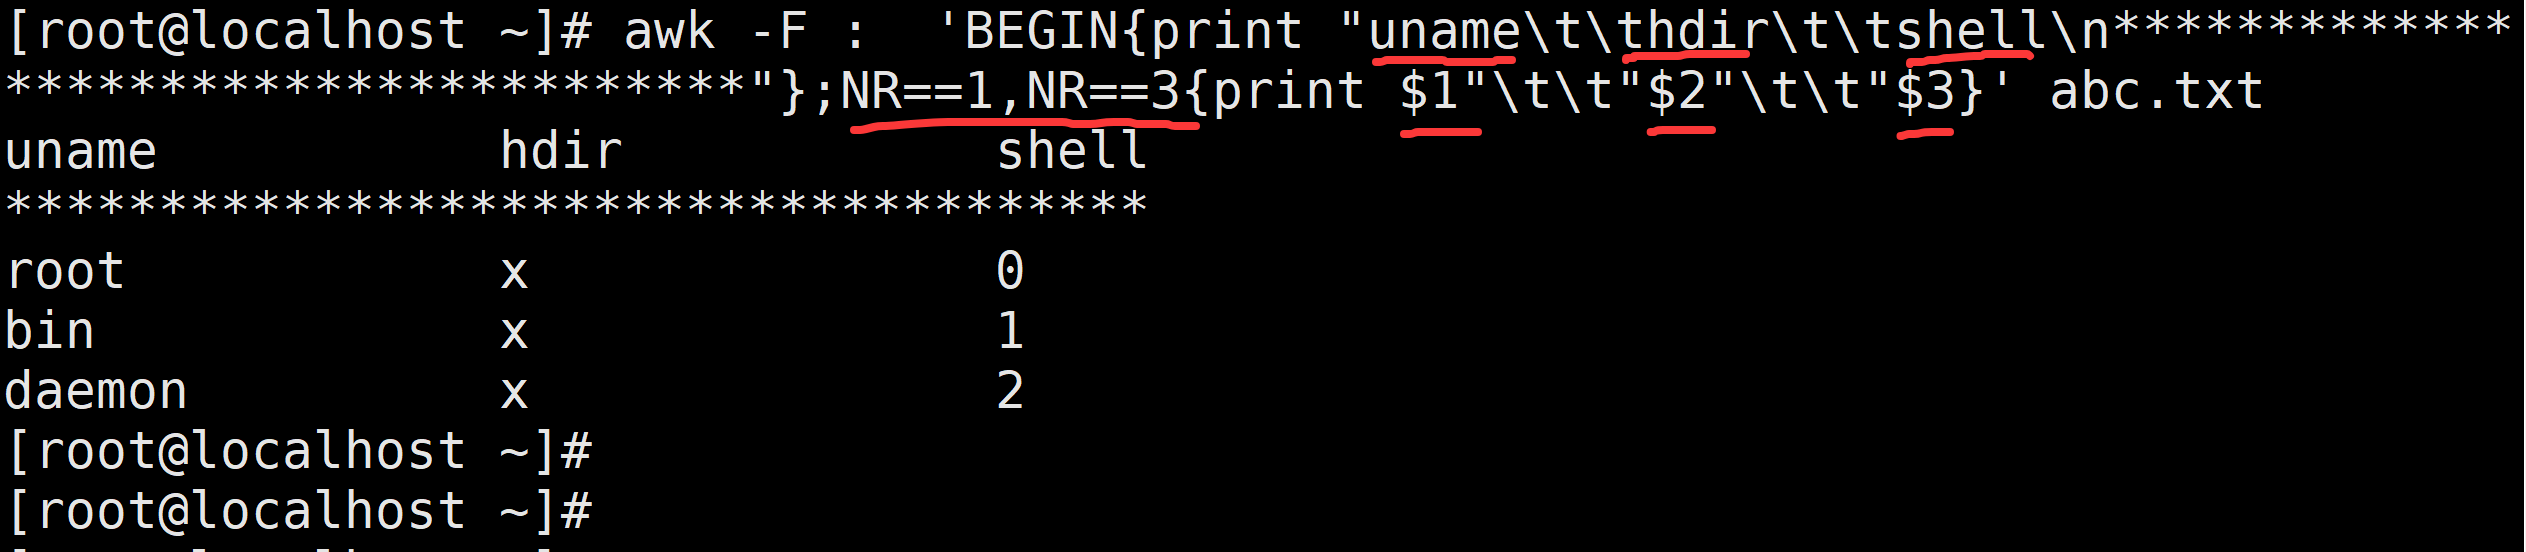
    file

    4、awk结合正则

    运算符 说明
    == 等于
    != 不等于
    > 大于
    < 小于
    >= 大于等于
    <= 小于等于
    ~ 匹配
    !~ 不匹配
    ! 逻辑非
    && 逻辑与
    || 逻辑或

    需求1:从第一行开始匹配到以adm开头行

    awk 'NR==1,/^adm/{print $0}' abc.txt
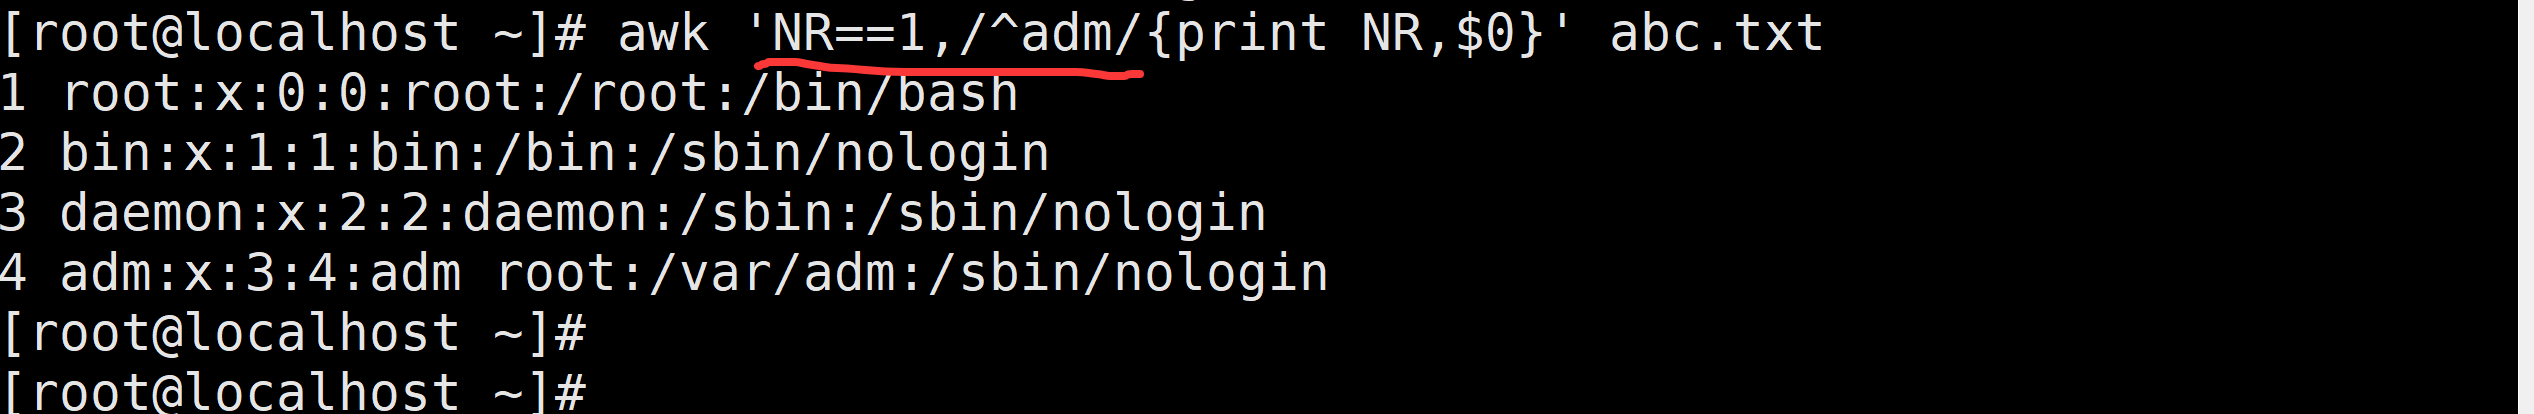
    file

    需求2:打印以root开头的行

    awk '/^root/{print $0}' abc.txt

    file

    需求3:打印以root开头或者以adm开头的行

    awk '/^root/ || /^adm/{print $0}' abc.txt
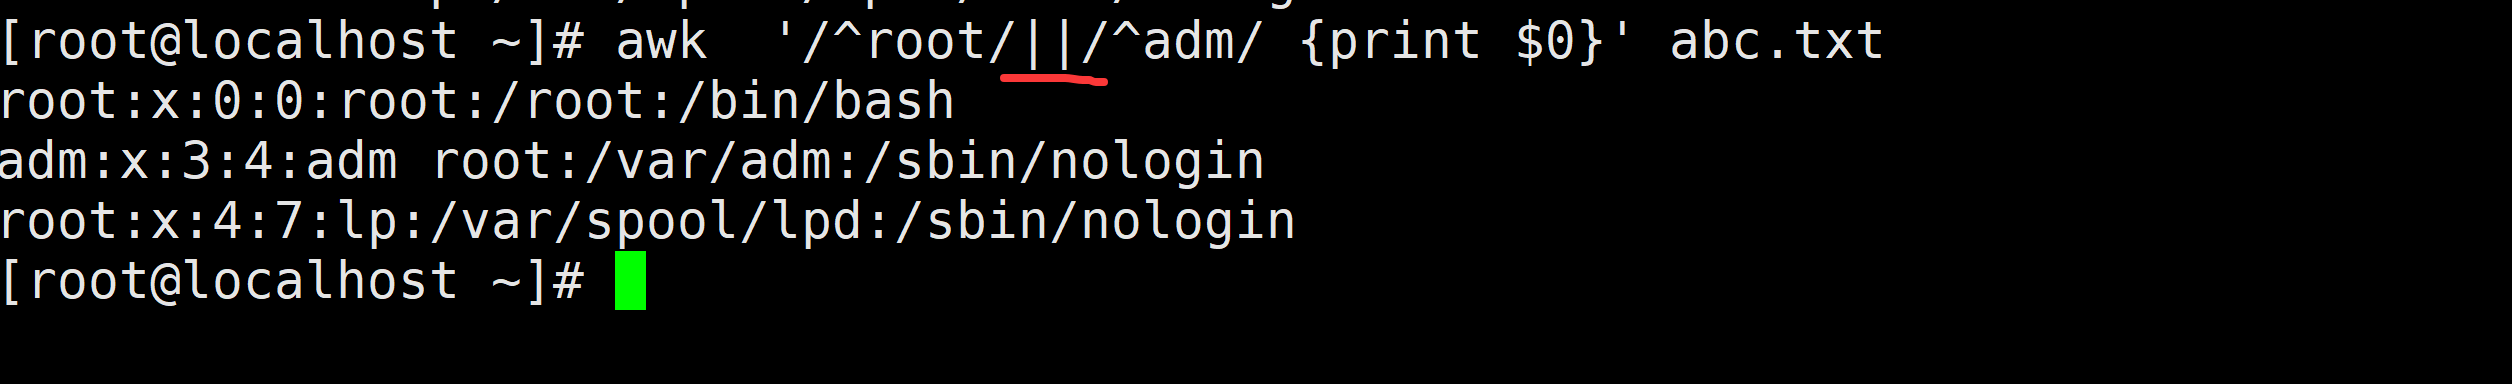
    file

    需求4:打印1-3行中以root开头的内容

    awk 'NR>=1 && NR<=3 && /^root/{print $0}' abc.txt
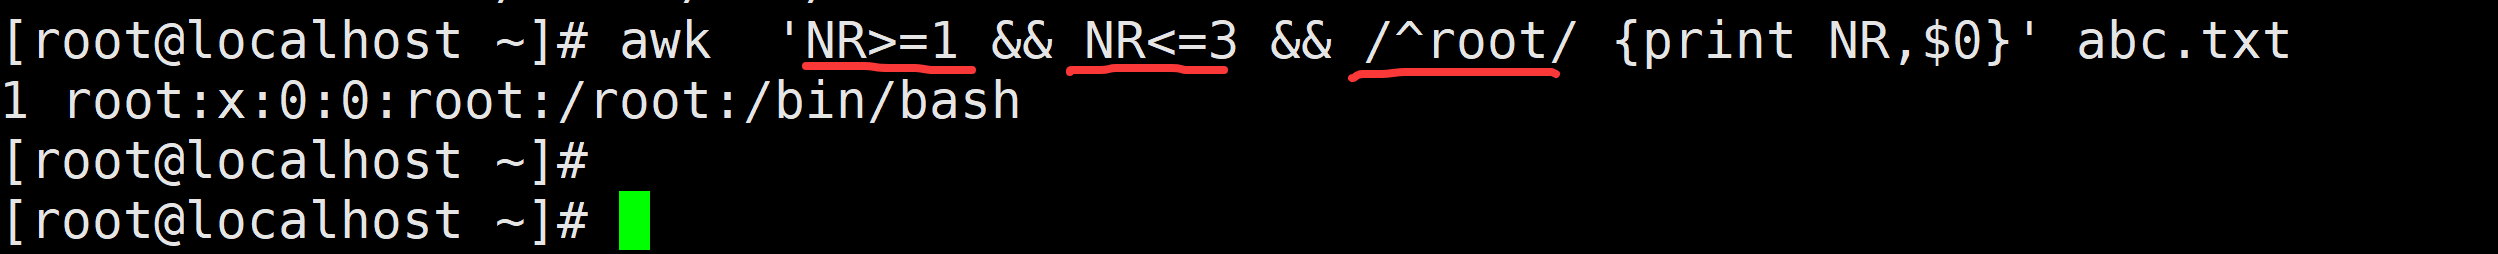
    file

    5、流程控制

    5.1 流程控制语句

    shell中的流程控制语句:

    if [ xxx ];then
    xxx
    fi

    awk中的流程控制语句:

    格式一:
    awk 选项 '正则,地址定位{awk语句}'  文件名
    { if(表达式){语句1;语句2;...}}
    awk -F : '{ if ($4 > 5) print $1, "系统用户" }' /etc/passwd
    
    格式二:
    awk 选项 '正则,地址定位{awk语句}'  文件名
    {if(表达式){语句;语句;...}else{语句;语句;...}}
    awk -F: '{
        if ($4 > 1000) {
            print $4,"---普通用户"
        } else {
            print $4,"---系统用户"
        }
        fi
    }' /etc/passwd
    
    格式三:
    awk 选项 '正则,地址定位{awk语句}'  文件名
    { if(表达式1){语句;语句;...}else if(表达式2){语句;语句;...}else if(表达式3){语句;语句;...}else{语句;语句;...}}
    awk '{ 
        if ($3 == "ERROR" && $5 > 5) {
            print "严重错误: " $0
            count++  # 统计错误次数
        } 
        else if ($3 == "WARNING") {
            print "警告: " $0
        }
    }' log.txt
    
    awk -F: '{
        if ($4 == 0) {
            print $4,"---管理员"
        } 
        else if ($4>=1 && $4<1000){
           print $4,"---系统用户" 
        }
        else {
            print $4,"---普通用户"
        }
        fi
    }' /etc/passwd
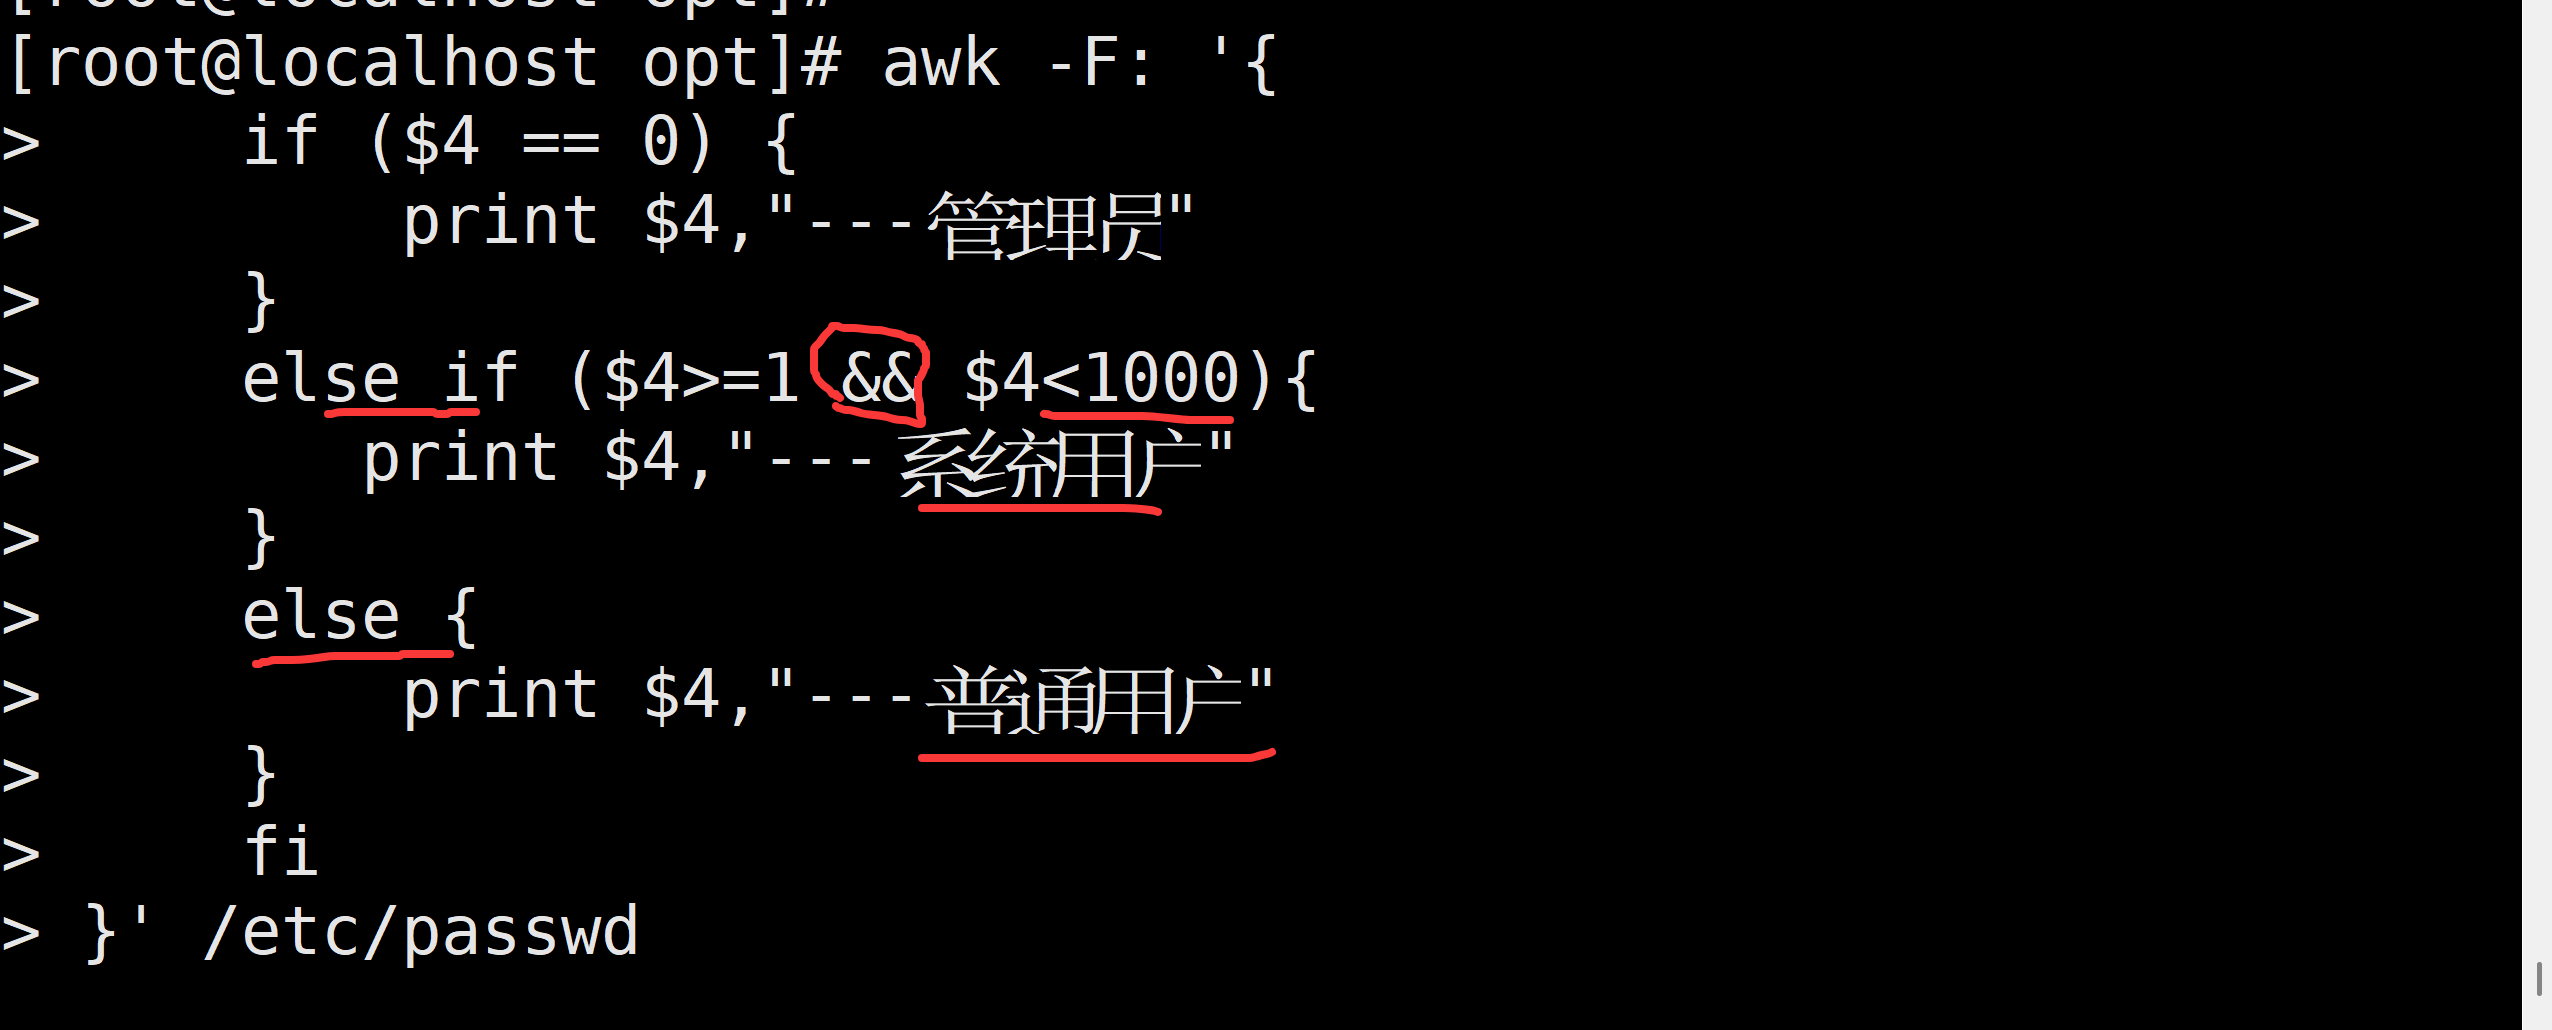
    file

    5.2 循环控制语句
    while:
    # awk 'BEGIN { 
    i=1;
    while(i<=10) 
    {print i;i++}
    }'
    由于 BEGIN 块在处理输入前执行,这个命令可以直接运行,无需指定输入文件
    for:
    # awk 'BEGIN { for(i=1;i<=5;i++) {print i} }'
    5.3 课堂案例

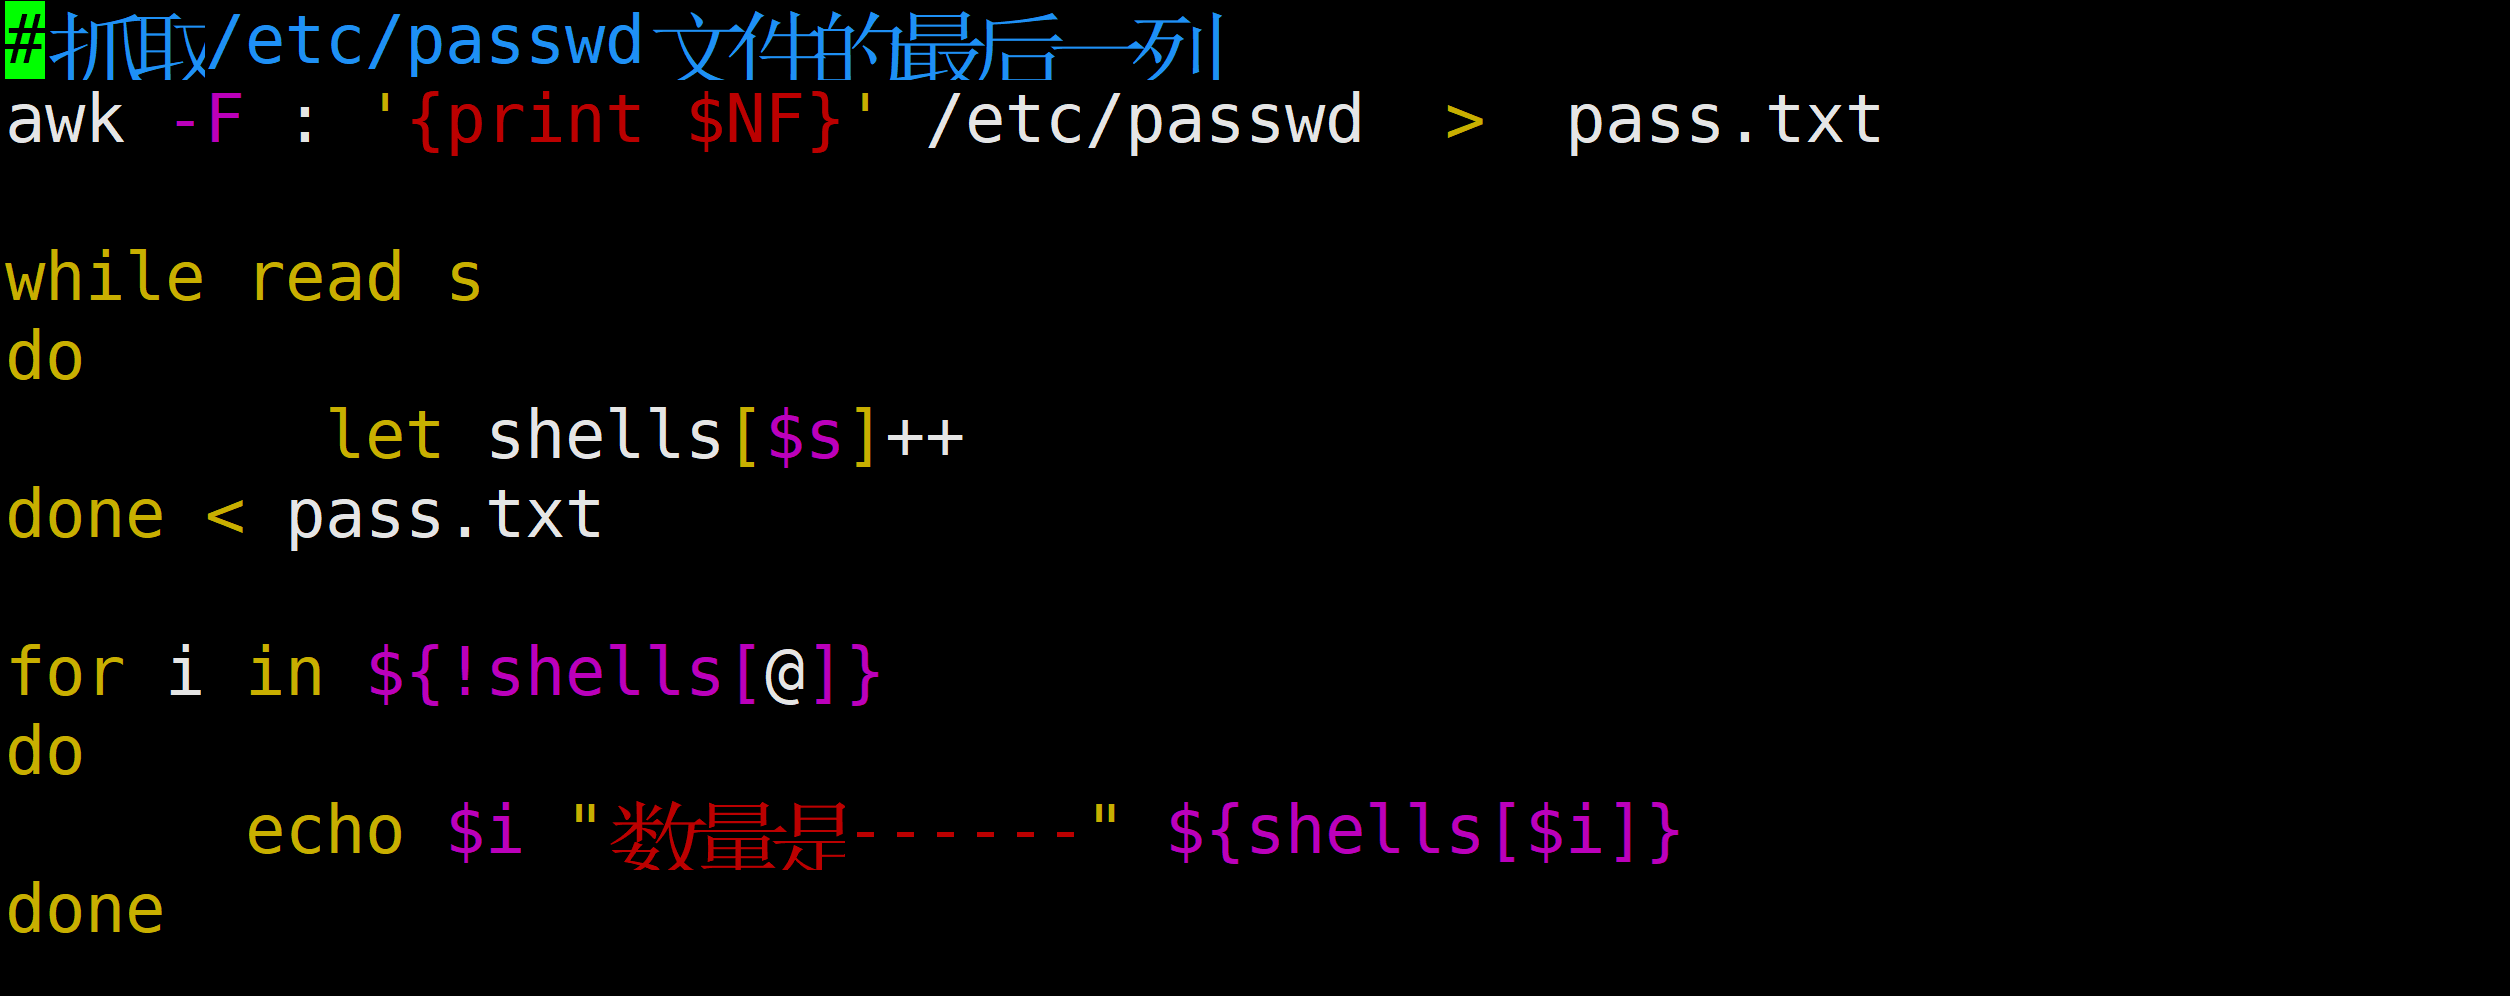
    需求1:统计/etc/passwd 中各种类型shell的数量

    #!/bin/bash
    # 1. 定义个关联数据,用存储shell的类型及其数量
    declare -A shells
    
    # 2. 切割获取最后一行的数据,临时存在到一个文件中tmp.txt
    awk -F : '{print $NF}' /etc/passwd > tmp.txt
    
    # 3. 循环读取tmp.txt文件
    while read s
    do
        # 每读取一行,就是一个shell类型,这个shell类型有可能在数组中,也有可能不存在
        # 如果不存在,在加入到关联数组中,并且出现的次数1
        # 如果存在,则在原来的值的基础上在加1
        let shells[$s]++
    done < tmp.txt
    
    # 4. 遍历数组,将关联数组中的数据读取出来
    for s in "${!shells[@]}"
    do
        echo "$s出现的次数为:${shells[$s]}"
    done
    awk -F: '{ shells[$NF]++ };END{for (i in shells) {print i,shells[i]} }' /etc/passwd
    
    shells[$NF]++:以 shell 名称为索引,对关联数组 shells 进行计数累加。
    awk 的数组可以使用字符串作为索引(如 shells["/bin/bash"]),无需预定义。
    若数组元素不存在,首次引用时会自动初始化为 0(如 shells["/bin/bash"]++)。
    for (i in shells):遍历数组的所有索引(即不同的 shell 名称)
    print i, shells[i]:输出 shell 名称及其对应的用户数量
    file

    20.shell综合

    20.1 防火墙

    #!/bin/bash
    
    # 防火墙相关设置
    systemctl stop firewalld &>/dev/null
    systemctl disable firewalld &>/dev/null
    setenforce 0
    sed -i 's/SELINUX=enforcing/SELINUX=disabled/' /etc/selinux/config
    echo "关闭防火墙成功"

    20.2 主机名

    # 设置主机名
    if [ $# -eq 0 ];then
            hostnamectl set-hostname server.com &>/dev/null
        else
            hostnamectl set-hostname $1 &>/dev/null
    fi
    echo "设置主机名成功"

    20.3 yum源

    # 配置yum源
    # 看网络是否可以ping通
    ping -c1 www.baidu.com &>/dev/null
    if [ ! $? -eq 0 ];then
        echo "网络不通,请先确认网路是否通畅,退出脚本"
        exit
    fi
    # 先通过yum安装wget
    yum install wget -y &>/dev/null
    # 备份之前的镜像源
    cd /etc/yum.repos.d/
    tar -zcvf repo.tar.gz *.repo
    rm -rf *.repo
    # 配置阿里镜像源
    wget -O /etc/yum.repos.d/CentOS-Base.repo https://mirrors.aliyun.com/repo/Centos-7.rep
    yum clean all
    yum makecache
    # 安装扩展镜像源
    yum install epel-release -y
    #!/bin/bash
    # 防火墙相关设置
    systemctl stop firewalld &>/dev/null
    systemctl disable firewalld &>/dev/null
    setenforce 0
    sed -i 's/SELINUX=enforcing/SELINUX=disabled/' /etc/selinux/config
    echo "关闭防火墙成功"
    # 设置主机名
    if [ $# -eq 0 ];then
            hostnamectl set-hostname server.com &>/dev/null
        else
            hostnamectl set-hostname $1 &>/dev/null
    fi
    echo "设置主机名成功"
    # 配置yum源
    # 看网络是否可以ping通
    ping -c1 www.baidu.com &>/dev/null
    if [ ! $? -eq 0 ];then
        echo "网络不通,请先确认网路是否通畅,退出脚本"
        exit
    fi
    # 先通过yum安装wget
    yum install wget -y &>/dev/null
    # 备份之前的镜像源
    cd /etc/yum.repos.d/
    tar -zcvf repo.tar.gz *.repo &>/dev/null
    rm -rf *.repo
    # 配置阿里镜像源
    wget -O /etc/yum.repos.d/CentOS-Base.repo https://mirrors.aliyun.com/repo/Centos-7.repo &>/dev/null
    yum clean all &>/dev/null
    yum makecache &>/dev/null
    # 安装扩展镜像源
    yum install epel-release -y &>/dev/null
    echo "yum源配置成功"

    20.4 安装MySQL

    # 安装MySQL
    # 1. 检查MySQL源码包是否已经上传
    # 2. 检查并创建用户
    # 3. 解压缩软件并进入MySQL目录
    # 4. 源码配置,安装必要的依赖
    # 5. 执行配置选项
    # 6. 编译并安装
    # 7. 更改数据目录权限
    # 8. 初始化数据库
    # 9. 拷贝启动脚本
    # 10. 启动数据库
    # 11. 设置密码
    # 下载MySQL
    wget http://dev.mysql.com/get/Downloads/MYSQL-5.6/mysql-5.6.31.tar.gz
    # 安装MySQL
    # 1. 检查MySQL源码包是否已经上传
    if [ ! -e /root/mysql-5.6.31.tar.gz ];then
        echo "MySQL安装包不存在,请检查是否上传MySQL安装包"
        exit
    fi
    
    # 2. 检查并创建用户
    echo "创建mysql用户"
    cut -d: -f1 /etc/passwd | grep -w mysql
    if [ $? -eq 0 ];then
        echo "mysql用户已存在!"
    else
        useradd -r -s /sbin/nologin mysql
        echo "mysql用户创建成功!"
    fi
    
    # 3. 解压缩软件并进入MySQL目录
    echo "解压mysql源码文件"
    # 解压缩mysql
    tar zxvf ~/mysql-5.6.31.tar.gz                           
    cd ~/mysql-5.6.31
    
    # 4. 源码配置,安装必要的依赖
    echo "正在安装必要的一些依赖....."
    # 提供 C++ 编译环境,MySQL 源码编译需要 C++ 编译器支持
    yum install gcc-c++ -y
    # 生成 Makefile 文件,控制编译过程
    yum install cmake -y
    # cmake 是一个跨平台的构建工具,用于生成编译所需的 Makefile 或项目文件。在编译 MySQL 时,CMake 用于配置编译选项、检查依赖和生成构建系统。
    # 提供终端界面开发库,用于 MySQL 命令行工具(如 mysql、mysqladmin)
    yum -y install ncurses-devel
    # 自动配置软件源代码,生成 configure 脚本
    yum -y install autoconf
    
    # 5. 执行配置选项
    echo "正在配置MySQL....."
    if [ -e ~/mysql-5.6.31/CMakeCache.txt ];then
        rm -rf ~/mysql-5.6.31/CMakeCache.txt
    fi
    cmake . \
    # 指定 MySQL 的安装根目录,所有二进制文件、配置文件都将安装在此目录下
    -DCMAKE_INSTALL_PREFIX=/usr/local/mysql/ \
    # 指定 MySQL 数据库文件(如数据表、索引)的存储目录
    -DMYSQL_DATADIR=/usr/local/mysql/data \
    # 启用 LOAD DATA LOCAL INFILE 功能,允许从客户端本地导入数据
    -DENABLED_LOCAL_INFILE=1 \
    # 启用 InnoDB 存储引擎(MySQL 5.5+ 默认引擎,支持事务、外键)
    -DWITH_INNOBASE_STORAGE_ENGINE=1 \
    # 设置 MySQL 服务监听的 TCP 端口号(默认 3306)
    -DMYSQL_TCP_PORT=3306 \
    # 设置默认字符集为 utf8mb4(支持完整 Unicode,包括 emoji 表情)
    -DDEFAULT_CHARSET=utf8mb4 \
    # 设置默认排序规则为 utf8mb4_general_ci(不区分大小写)
    -DDEFAULT_COLLATION=utf8mb4_general_ci \
    # 安装所有额外字符集支持
    -DWITH_EXTRA_CHARSETS=all \
    # 指定运行 MySQL 服务的系统用户(通常为 mysql)
    -DMYSQL_USER=mysql 
    
    cmake . \
    -DCMAKE_INSTALL_PREFIX=/usr/local/mysql/ \
    -DMYSQL_DATADIR=/usr/local/mysql/data \
    -DENABLED_LOCAL_INFILE=1 \
    -DWITH_INNOBASE_STORAGE_ENGINE=1 \
    -DMYSQL_TCP_PORT=3306 \
    -DDEFAULT_CHARSET=utf8mb4 \
    -DDEFAULT_COLLATION=utf8mb4_general_ci \
    -DWITH_EXTRA_CHARSETS=all \
    -DMYSQL_USER=mysql 
    
    # 6. 编译并安装
    echo "正在编译安装MySQL....."
    make && make install 
    
    # 7. 更改数据目录权限
    chown -R mysql.mysql /usr/local/mysql/
    
    # 8. 初始化数据库
    echo "初始化数据库文件"
    rm -f /etc/my.cnf
    pkill -9 mysqld
    cd /usr/local/mysql/
    ./scripts/mysql_install_db --user=mysql
    
    # 9. 拷贝启动脚本
    echo "拷贝启动脚本"
    if [ ! -e /etc/init.d/mysql ];then
        cp /usr/local/mysql/support-files/mysql.server /etc/init.d/mysql
    fi
    
    # 10. 启动数据库
    echo "启动数据库"
    service mysql start
    
    # 11. 设置密码
    echo "设置密码"
    /usr/local/mysql/bin/mysqladmin -u root password '123456'
    
    # 12. 配置环境变量
    echo "设置环境变量"
    grep "/usr/local/mysql/bin/" /etc/profile
    if [ ! $? -eq 0 ];then
       echo 'export PATH=/usr/local/mysql/bin/:$PATH' >> /etc/profile
       source /etc/profile
    fi

    21.until循环

    1 语法结构

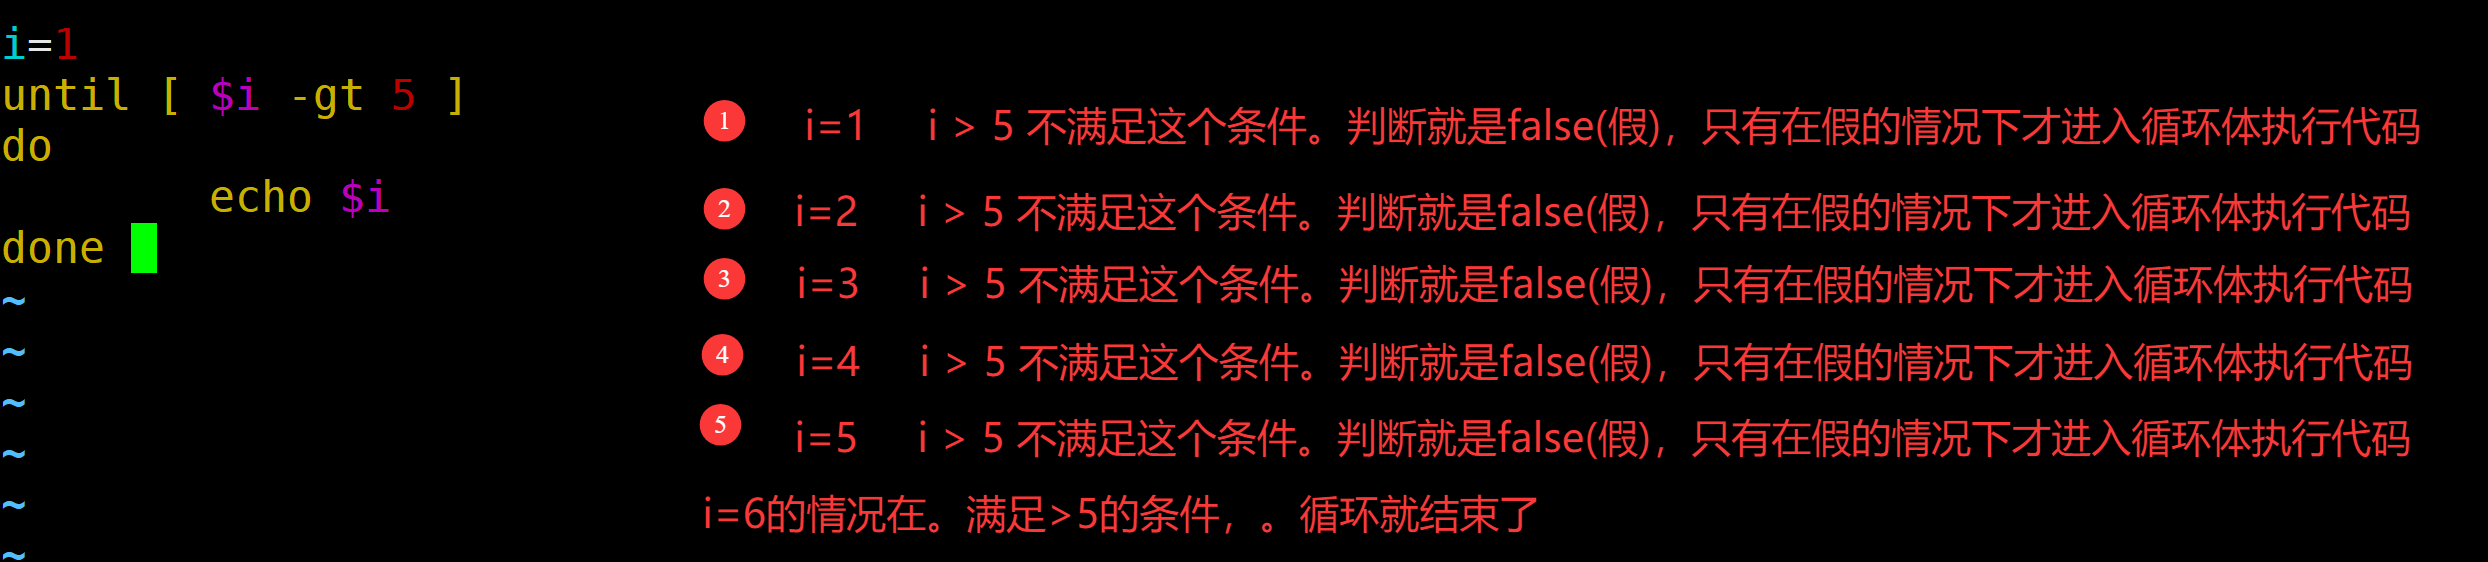
    特点:条件为假就进入循环;条件为真就退出循环

    until 条件表达式   
        do
            command
            command
            ...
        done

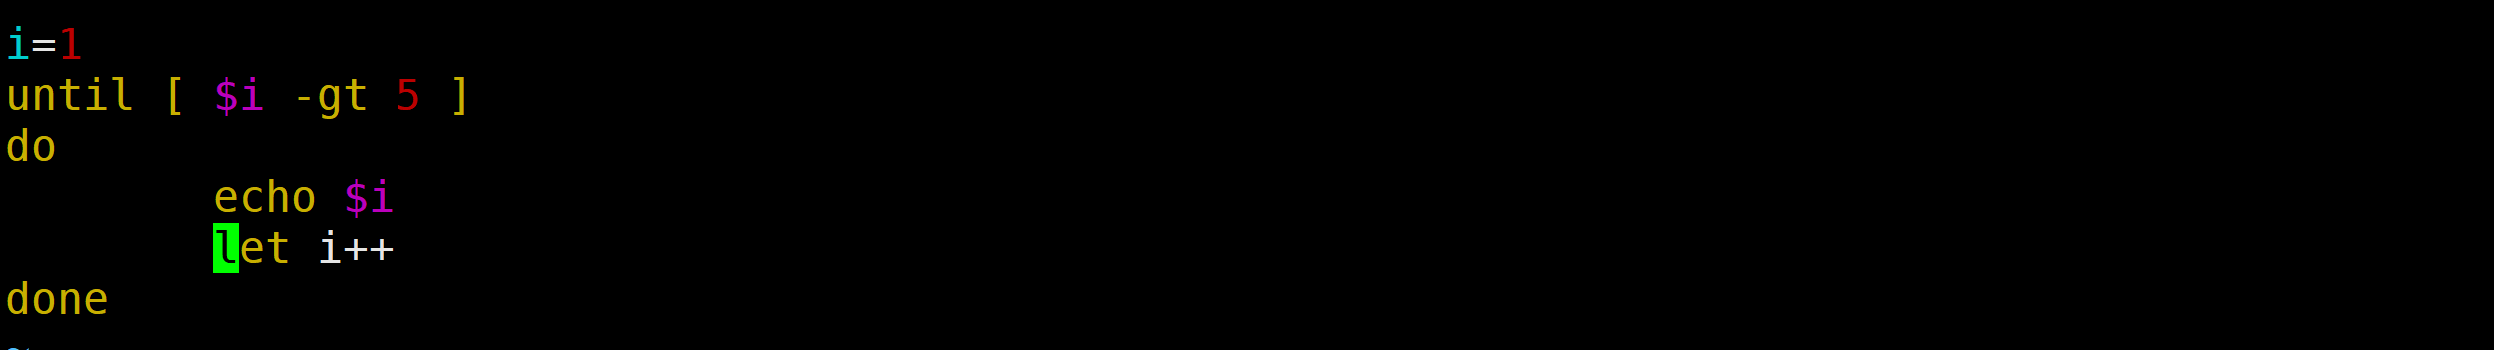
    示例

    i=1
    until [ $i -gt 5 ]
    do
        echo $i
        let i++
    done
    file

    file

    2 课堂案例

    需求:使用until循环打印1-10之间的数字

    #!/bin/bash
    i=1
    until [ $i -gt 10 ]
    do 
        echo $i
        let i++
    done
    计算机网络

    一.计算机网络的概念

    1.1计算机网络定义

    计算机网络是将地理位置分散、具有独立功能的计算机及外部设备,通过通信线路与设备(如路由器、交换机)连接起来,并在网络协议(如TCP/IP)的统一协调下,实现资源共享(如文件、打印机共享)与信息传递(如网页浏览、邮件收发)的系统。

    1.2 计算机网络组成

    • 硬件:包括计算机(如服务器、工作站、笔记本电脑等)、网络设备(如路由器、交换机、调制解调器等)以及传输介质(如双绞线、光纤、无线电波等)。
    • 软件:包含网络操作系统(如 Windows Server、Linux 等)、网络协议(如 TCP/IP、HTTP、FTP 等)和网络应用程序(如浏览器、电子邮件客户端等)。

    1.3 计算机网络分类

    (1)按覆盖范围分类

    • 局域网(LAN,Local Area Network)
      • 定义:通常覆盖范围较小,一般在一个建筑物内(如家庭、学校、办公室等),用于连接计算机和其他设备,实现资源共享和数据通信。
      • 特点:传输速率高(常见的有 10Mbps、100Mbps、1000Mbps 甚至更高)、延迟低、误码率低,网络拓扑结构相对简单,易于管理和维护。
      • 示例:家庭中通过无线路由器连接的多台设备组成的网络;学校机房内计算机通过交换机连接形成的网络。

    • 城域网(MAN,Metropolitan Area Network)
      • 定义:覆盖一个城市的范围,通常由多个局域网互联而成,用于实现城市内不同区域之间的网络通信。
      • 特点:传输速率适中,介于局域网和广域网之间;覆盖范围较大,需要使用一些特殊的通信技术和设备来保证网络的稳定性和可靠性。
      • 示例:城市中的有线电视网络、城市政务网络等。

    • 广域网(WAN,Wide Area Network)
      • 定义:覆盖范围非常大,可以跨越城市、国家甚至全球,通过公共通信网络(如电话网、卫星通信等)将多个局域网和城域网连接起来。
      • 特点:传输速率相对较低,延迟较高,误码率也相对较高;网络拓扑结构复杂,管理和维护难度较大。
      • 示例:互联网就是最大的广域网,它连接了全球数以亿计的计算机和设备。

    (2)按拓扑结构分类

    • 总线型拓扑
      • 定义:所有设备都连接在一条称为总线的公共传输介质上,信息沿着总线进行传输。
      • 特点:结构简单,易于安装和扩展;但可靠性较低,一旦总线出现故障,整个网络将瘫痪;并且随着设备数量的增加,网络性能会下降。
      • 示例:早期的以太网采用的就是总线型拓扑结构。

    • 星型拓扑
      • 定义:以一个中心节点(如交换机或集线器)为核心,其他设备都通过单独的线路连接到中心节点上。
      • 特点:可靠性高,单个设备故障不会影响其他设备的正常通信;易于管理和维护;但中心节点一旦出现故障,整个网络将受到影响。
      • 示例:现代企业网络和家庭网络中广泛使用的以太网交换机连接方式就是星型拓扑结构。

    • 环型拓扑
      • 定义:所有设备连接成一个闭合的环,信息沿着环单向或双向传输。
      • 特点:结构简单,传输路径固定,实时性较好;但可靠性较低,任何一个节点出现故障都可能导致整个网络瘫痪;并且网络扩展困难。
      • 示例:早期的令牌环网采用的就是环型拓扑结构。

    • 树型拓扑
      • 定义:是一种层次化的拓扑结构,类似于树的形状,由根节点、分支节点和叶子节点组成。
      • 特点:易于扩展和管理,适合大规模网络;但根节点的可靠性对整个网络影响较大。
      • 示例:企业内部的网络架构可能采用树型拓扑结构,总部作为根节点,各个分支机构作为分支节点,终端设备作为叶子节点。

    • 网状型拓扑
      • 定义:每个节点都与其他多个节点直接相连,形成一个复杂的网状结构。
      • 特点:可靠性高,容错能力强,任何一个节点或链路出现故障都不会影响整个网络的正常运行;但网络建设成本高,管理和维护难度大。
      • 示例:大型数据中心和核心骨干网络通常采用网状型拓扑结构。

    (3)按使用目的分类

    • 公用网
      • 定义:由电信部门或其他提供通信服务的运营商建设和管理,向公众开放使用的网络,如互联网。
      • 特点:覆盖范围广,用户数量多,提供多种服务;但安全性和可靠性相对较低,需要用户自行采取安全措施。

    • 专用网
      • 定义:为特定的组织或机构(如企业、政府部门等)内部使用而建设的网络,不向公众开放。
      • 特点:可以根据用户的需求进行定制化设计,安全性和可靠性较高;但建设和维护成本较高,覆盖范围相对较小。
      • 示例:企业内部的办公网络、银行的内部网络等都属于专用网。

    二.OSI七层模型

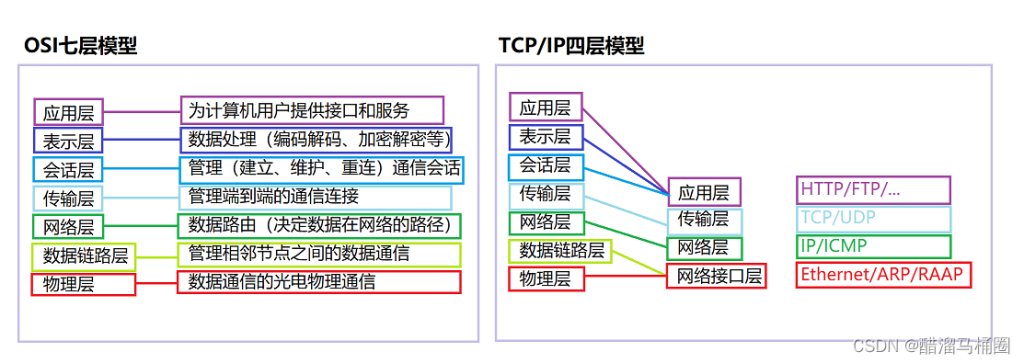
    • 七层模型,亦称OSI(Open System Interconnection)。参考模型是国际标准化组织(ISO)制定的一个用于计算机或通信系统间互联的标准体系,一般称为OSI参考模型或七层模型。 它是一个七层的、抽象的模型体,不仅包括一系列抽象的术语或概念,也包括具体的协议。

    应用层

    • 功能:负责网络应用的实际运行。是OSI的最高层,为网络用户之间的通信提供专用的程序。许多网络应用软件、网络操作系统都是在该层次上的直接应用

    表示层

    • 功能:负责数据格式的编码和解码,以及数据的加密与解密、压缩与解压缩等。它主要是将计算机能够识别的东西转换成人能够识别的东西

    会话层

    • 功能:负责建立和维护会话。主要在你的系统之间发起会话或接受会话请求(设备之间需要互相认识可以是IP也可以是MAC或者是主机名)。

    传输层

    • 负责端到端的数据传输和可靠性保证。定义了一些传输数据的协议和端口号,如TCP(传输控制协议,传输效率低,可靠性强)和UDP(用户数据报协议,与TCP特性相反)。传输层将下层接收的数据进行分段和传输,到达目的地址后再进行重组。

    网络层

    • 功能:负责将数据包从源节点传输到目标节点。主要将从下层接收到的数据进行IP地址的封装与解封装。网络层是网络通信的小型控制中心,它根据网络条件、服务的优先权和其它因素来决定数据应使用哪一条路由进行传送。

    数据链路层

    • 功能:负责网络节点之间的数据传输和错误检测。主要将从物理层接收的数据进行MAC地址(网卡的地址)的封装与解封装。

    物理层

    • 功能:定义物理设备标准,如网线的接口类型、光纤的接口类型、各种传输介质的传输速率等。物理层是OSI分层结构体系中最重要、最基础的一层,它建立在传输媒介基础上,起建立、维护和取消物理连接作用,实现设备之间的物理接口连接。解决使用何种信号来表示比特0和比特1的问题数据单位:比特(bit),即二进制数据。

    三.TCP/IP四层模型

    应用层

    应用层的协议包括HTTP、FTP、Telnet、DNS、SMTP等

    传输层

    TCP、UDP

    网络层

    网络接口层

    四.数据封装与解封装

    • 数据封装:数据--段--包--帧--比特流
    • 解封装:比特流--帧--包--段--数据

    核心概念:分层模型

    数据封装和解封装发生在分层的网络模型(如TCP/IP模型或OSI模型)中。每一层为它从上层接收到的数据添加特定的控制信息(头部,有时还有尾部),然后将整个结构传递给下一层。接收端则逐层剥离这些信息。

    1. 封装(Encapsulation:发送端 - 自上而下加“包装”)

    封装发生在数据发送端。数据从应用层开始,逐层向下传递,每一层都为其添加本层的控制信息(头部/报头),就像给数据包上包装一样。目的是让数据能在网络中正确传输、路由和交付。

    • 步骤 (以 TCP/IP 模型为例,对应 OSI 层):
      1. 应用层(Application Layer - OSI 5-7): 用户生成原始数据(如电子邮件内容、网页请求)。这个数据块称为 数据(Data) 或 消息(Message)。
      2. 传输层(Transport Layer - OSI 4): 接收应用层的数据。
        • 添加 传输层头部(TCP Header 或 UDP Header)。头部包含关键信息如 源端口号、目标端口号(用于标识发送和接收的应用程序)、序列号、确认号(TCP)、校验和等。
        • 封装后的数据单元称为 段(Segment - TCP) 或 数据报(Datagram - UDP)。

      3. 网络层(Internet Layer - OSI 3): 接收传输层的段/数据报。
        • 添加 网络层头部(IP Header)。头部包含关键信息如 源 IP 地址、目标 IP 地址(用于跨网络路由)、生存时间(TTL)、协议标识符(标识上层是TCP还是UDP)等。
        • 封装后的数据单元称为 包(Packet) 或 数据报(Datagram)(在IP层常称为IP数据报)。

      4. 网络接口层(Link Layer - OSI 1-2): 接收网络层的包。
        • 添加 数据链路层头部(Frame Header) 和 尾部(Frame Trailer)。
        • 头部包含 源 MAC 地址、目标 MAC 地址(用于在同一物理网络段内设备间的寻址)、帧类型 等。
        • 尾部通常包含 帧校验序列(FCS),用于检测传输错误。
        • 封装后的数据单元称为 帧(Frame)。

      5. 物理层(Physical Layer - OSI 1): 接收数据链路层的帧。
        • 将帧转换成适合物理介质(网线、光纤、无线电波)传输的 比特流(Bits)(0和1的序列)。
        • 这个过程涉及编码(如曼彻斯特编码、NRZ)、调制(如Wi-Fi的QAM)等,不添加头部信息,只是格式转换。
        • 比特流通过物理介质发送出去。


    封装过程总结(发送端): 数据 (应用层) -> [+TCP/UDP头] = 段/数据报 (传输层) -> [+IP头] = 包 (网络层) -> [+帧头 & 帧尾] = 帧 (数据链路层) -> 比特流 (物理层)

    2. 解封装(Decapsulation:接收端 - 自下而上拆“包装”)

    解封装发生在数据接收端。比特流从物理介质到达,接收端设备从物理层开始,逐层向上传递,每一层剥离本层的控制信息(头部/尾部),并将剩余的有效载荷传递给上层。目的是最终将原始数据交付给目标应用程序。

    • 步骤 (接收端):
      1. 物理层(Physical Layer): 从物理介质接收到 比特流(Bits)。
        • 将比特流转换成 帧(Frame) 的结构(识别帧的开始和结束)。传递给数据链路层。

      2. 数据链路层(Link Layer):
        • 检查 帧尾的 FCS,验证帧在传输过程中是否出错(若有错则丢弃)。
        • 剥离 帧头 和 帧尾。
        • 检查 帧头中的目标 MAC 地址 是否与本机 MAC 地址或广播/组播地址匹配。匹配则将其中的 包(Packet) 传递给网络层。

      3. 网络层(Internet Layer):
        • 剥离 IP 头。
        • 检查 IP 头中的目标 IP 地址 是否与本机 IP 地址匹配。匹配则根据 IP 头中的协议标识符(如 TCP=6, UDP=17)将内部的 段(Segment) 或 数据报(Datagram) 传递给相应的传输层协议(TCP 或 UDP)。
        • (如果是路由器,则根据目标IP地址进行路由转发,而不是解封装到上层)。

      4. 传输层(Transport Layer):
        • 剥离 TCP 头 或 UDP 头。
        • 检查 头中的目标端口号,识别是哪个应用程序在等待数据。
        • 将 数据(Data) 传递给该端口号对应的应用层进程。
        • (TCP还会处理序列号、确认、重传等可靠传输机制)。

      5. 应用层(Application Layer): 接收传输层传递上来的 原始数据(Data),供应用程序使用(如显示邮件内容、加载网页)。

    解封装过程总结(接收端): 比特流 (物理层) -> 帧 (数据链路层) -> [-帧头 & 帧尾] = 包 (网络层) -> [-IP头] = 段/数据报 (传输层) -> [-TCP/UDP头] = 数据 (应用层)

    关键点:

    • 封装是加头(尾),解封装是拆头(尾)。
    • 每一层只处理本层添加的头部信息。下层对上层添加的头部是“透明”的(当作数据的一部分)。
    • 封装确保数据包含足够的信息在网络中传输、路由、可靠交付到正确的应用程序。
    • 解封装确保数据被正确接收、校验、并最终交付给目标应用程序。
    • 你提到的“数据解封是数据--段--包--帧--比特流”实际上是解封装过程的逆序描述:
      • 接收端:比特流 -> 帧 -> 包 -> 段 -> 数据
      • 发送端:数据 -> 段 -> 包 -> 帧 -> 比特流

    封装和解封装是相辅相成的过程,是网络设备(主机、路由器、交换机)进行通信的基础。

    五.网络设备

    image-20250603223358635

    六.网络协议

    1.IP协议

    1.1 IP地址的定义

     IP地址(Internet Protocol Address)是用于标识网络中每一台计算机或设备的唯一标识符。IP地址遵循网络层协议,通过数字形式(IPv4)或更长的字符形式(IPv6)表示。IP地址的作用是确保数据包能够从源设备准确地送达目标设备。

    1.2 IPv4与IPv6

    • IPv4地址由32个二进制位组成,通常以四个十进制数字(每个数字为0-255)表示,每个数字之间用点分隔。比如:192.168.1.1。
    • IPv6地址则由128个二进制位组成,通常以八组16位的十六进制数表示,每组之间用冒号分隔。IPv6地址是由8个块组成,每个块由4个十六进制数字表示。例如,IPv6地址的一部分可能是0000、1234 或 abcd 等。每个块的值从 0000 到 ffff 都是有效的。比如:2001:0db8:85a3:0000:0000:8a2e:0370:7334。

    1.3 IP地址的结构组成

    IPv4地址可以分为两部分:

    • 网络部分:用于标识网络的唯一性
    • 主机部分:用于标识网络中具体的设备(主机)

    对于IPv6,结构更加复杂和灵活,IPv6地址通常分为三部分:

    • 前缀部分:与网络地址相关,标识网络
    • 子网部分:用于标识子网
    • 接口标识符:用于标识单个设备或主机

    IP地址点分十进制记法

    以 IPV4 为例,IPV4 的地址长度为32位,共4个字节,但实际中我们会用到点分十进制记法。

    例如:

    (1)机器存放的 IP 地址是 32 位二进制代码 —— 10000000000010110000001100011111

    (2)每隔 8 位插入一个空格,提高可读性 —— 10000000 00001011 00000011 00011111

    (3)将每 8 位的二进制数转换为十进制数 —— 128 11 3 31

    (4)采用点分十进制记法,更加便于使用 —— 128.11.3.31

    1.3 IP地址的分类

    • 五类地址

    1.0.0.0 ~ 126.255.255.255A类网络8位,主机24位
    128.0.0.0 ~ 191.255.255.255B类网络16位,主机16位
    192.0.0.0 ~ 223.255.255.255C类网络24位,主机8位
    224.0.0.0 ~ 239.255.255.255D类不分网络地址和主机地址,作为组播地址
    240.0.0.0 ~ 255.255.255.255E类不分网络地址和主机地址

    • 特殊地址

    127.x.x.x回环地址如127.0.0.1 等效于localhost或本机IP。
    255.255.255.255广播地址

    • 私有地址

    A 类地址10.0.0.0 - 10.255.255.255 (前一个字节为网络号,后三个为主机号 )
    B 类地址172.16.0.0-172.31.255.255( 前两个为网络号,后两个为主机号 )
    C 类地址192.168.0.0-192.168.255.255( 前 3 个为网络号,后 1 个为主机号 )

    2.ICMP协议

    作用:测试网络连通性

    ping命令

    windows系统:

    -t选项 一直发包,按ctrl + c终止

    -n选项 指定发包数量

    -l选项 指定发包大小

     -----n选项    指定发包数量
     C:\Users\Administrator>ping -n 2 baidu.com
     ​
     正在 Ping baidu.com [110.242.68.66] 具有 32 字节的数据:
     来自 110.242.68.66 的回复: 字节=32 时间=38ms TTL=48
     来自 110.242.68.66 的回复: 字节=32 时间=39ms TTL=48
     ​
     110.242.68.66 的 Ping 统计信息:
        数据包: 已发送 = 2,已接收 = 2,丢失 = 0 (0% 丢失),
     往返行程的估计时间(以毫秒为单位):
        最短 = 38ms,最长 = 39ms,平均 = 38ms
     ​
     C:\Users\Administrator>ping -n 100000000000000000000000000 baidu.com
     ​
     正在 Ping baidu.com [110.242.68.66] 具有 32 字节的数据:
     来自 110.242.68.66 的回复: 字节=32 时间=39ms TTL=48
     来自 110.242.68.66 的回复: 字节=32 时间=41ms TTL=48
     
     
      -----     -l选项     指定发包大小
      C:\Users\Administrator>ping -l 1000 baidu.com
     ​
     正在 Ping baidu.com [110.242.68.66] 具有 1000 字节的数据:
     来自 110.242.68.66 的回复: 字节=1000 时间=48ms TTL=48
     来自 110.242.68.66 的回复: 字节=1000 时间=69ms TTL=48
     ​
     110.242.68.66 的 Ping 统计信息:
        数据包: 已发送 = 2,已接收 = 2,丢失 = 0 (0% 丢失),
     往返行程的估计时间(以毫秒为单位):
        最短 = 48ms,最长 = 69ms,平均 = 58ms
     Control-C
     ^C
     C:\Users\Administrator>ping -l 1000000 baidu.com
     选项 -l 的值有错误,有效范围从 0 到 65500。

    3.ARP协议

    • 作用 - 将IP地址解析为MAC地址

    arp -a 显示所有的IP地址和mac地址的对应关系

     C:\Users\Administrator>arp  -a
     ​
     接口: 192.168.3.67 --- 0x5
      Internet 地址         物理地址             类型
      192.168.3.1           80-05-88-e9-4e-79     动态
      192.168.3.5           bc-f4-d4-73-38-05     动态
      192.168.3.6           78-af-08-7e-e3-b1     动态
      192.168.3.12         98-3b-8f-02-45-ef     动态
      192.168.3.13         20-1e-88-01-16-ed     动态
      192.168.3.14         9e-ec-f1-99-d7-51     动态
      192.168.3.18         34-6f-24-a6-ca-95     动态
      192.168.3.21         78-2b-46-cf-db-90     动态
      192.168.3.28         dc-21-48-7e-46-31     动态
      192.168.3.30         9c-67-d6-bc-5b-6a     动态
      192.168.3.31         e8-b0-c5-8b-04-c0     动态
      192.168.3.32         b0-dc-ef-db-23-42     动态
      192.168.3.36         8c-c8-4b-c1-19-05     动态
      192.168.3.38         12-74-14-f3-9f-3c     动态
      192.168.3.40         3a-ae-7d-b8-34-8e     动态
      192.168.3.42         ae-53-f7-99-45-e8     动态
      192.168.3.43         b0-68-e6-3a-09-89     动态
      192.168.3.49         5e-d1-74-7a-27-30     动态
      192.168.3.69         e4-aa-ea-9f-8f-3f     动态
      192.168.3.70         10-63-c8-fb-9c-bf     动态
      192.168.3.77         66-c7-c6-f5-04-39     动态
      192.168.3.79         e6-b4-7c-65-0e-b8     动态
      192.168.3.89         c8-b2-9b-69-60-f4     动态

    如何清除当前主机arp缓存 arp -d *

    如果只想删除特定IP地址的ARP条目,可以将*替换为具体的IP地址,例如:

     arp -d 192.168.1.100

    静态绑定ip地址和mac地址

     arp -s ip地址 mac地址

    arp攻击

    制作假的对应关系

    192.168.3.32 b0-dc-ef-db-23-42

    192.168.3.90 e4-aa-ea-9f-8f-b5

    192.168.3.90 a1-22-33-44-55-66

    arp欺骗

    伪造的网关数据

    7.子网掩码

    1.概念

    • 定义 子网掩码(Subnet Mask)是用于将IP地址分成网络部分和主机部分的工具。它与IP地址相结合,用于确定网络地址和可用的主机地址。   子网掩码也是由32位二进制数构成,其中“1”表示网络部分,"0"表示主机部分。子网掩码通常和IP地址一起使用,以确定哪些IP地址属于同一网络。
    • 作用 分割网络:子网掩码允许将一个大的网络划分为多个小网络(子网),以提高网络的管理效率。 决定网络范围:通过与IP地址按位进行“与”操作(AND运算),子网掩码可以帮助确定IP地址所在的网络范围。
    • 示例(IPv4) 子网掩码 255.255.255.0,即/24(表示前24位是网络部分)。 子网掩码 255.255.255.128,即/25(表示前25位是网络部分)。
    • 示例(IPv6) IPv6网络2001:0db8:85a3::/48:前48位是网络部分,后80位可用于划分子网。 IPv6网络2001:0db8:85a3::/64:前64位是网络部分,后64位用于主机部分,通常用于标识单个主机。

    子网掩码的格式

    网掩码是一个32位的二进制数,通常以点分十进制形式表示(例如:255.255.255.0)。它的特点是:

    • 网络部分为1:子网掩码中,网络部分的位全为1。
    • 主机部分为0:子网掩码中,主机部分的位全为0。
    • 连续性:1和0必须连续,不能交错出现。

    例如:

    • 子网掩码255.255.255.0表示前24位为网络部分,后8位为主机部分。
    • 子网掩码255.255.255.192表示前26位为网络部分,后6位为主机部分。

    子网掩码的分类

    根据子网掩码的长度,可以将子网掩码分为以下几种类型:

    • 默认子网掩码:对应于A、B、C三类IP地址的默认子网掩码。
      • A类:255.0.0.0(/8)
      • B类:255.255.0.0(/16)
      • C类:255.255.255.0(/24)

    • 自定义子网掩码:通过修改默认子网掩码,可以实现子网划分。例如,将C类网络的子网掩码从255.255.255.0修改为255.255.255.192。

    2.网络地址

    • 定义 网络地址是由IP地址和子网掩码计算得出的结果,它表示网络本身,而不是网络中的某个具体主机。网络地址是网络的标识符,通常不能分配给主机。
    • 计算 网络地址是通过将IP地址与子网掩码进行按位与运算得到的。 对于IPv6,网络地址也是通过前缀来定义的。前缀可以表示一个完整的网络或子网,通过根据前缀长度来确定网络地址范围。
    • 作用这个网络地址的作用是标识一个子网或网络区域,通常用于路由选择和数据包的转发。

    3.主机地址

    • 定义 主机地址是IP地址中的一部分,表示网络中某个特定设备(主机)的唯一标识符。它位于由子网掩码划分出的网络部分之外,通常是在网络地址之后的部分。主机地址是区分网络内不同设备的标识符。
    • 计算 主机地址是通过将IP地址和子网掩码进行按位与运算后得到的网络地址部分以外的剩余部分。简单来说,主机地址对应于IP地址中的主机部分,它位于子网掩码中标识为0的位置,即IP地址和子网掩码的反码进行与运算。 在IPv6中,主机地址由网络地址的前缀长度决定,网络前缀后面部分即为主机地址的范围。
    • 作用 主机地址的作用是标识同一网络中的不同设备。每个设备在其网络内有一个唯一的主机地址,它在网络中用于确定通信的具体目标。例如,在局域网(LAN)中,每台计算机、打印机等设备都有一个主机地址,用于在该网络内进行数据传输。 主机地址通常用于在本地网络内进行设备间的通信以及从路由器或其他设备中获取数据。

    4. IP地址、子网掩码、网络地址和主机地址示例分析

    示例 :典型家庭网络(IPv4)

    • 配置

     IP地址:192.168.1.10
     子网掩码:255.255.255.0

    • 将子网掩码转换为二进制

     255.255.255.0 → 11111111.11111111.11111111.00000000

    • 确定网络部分和主机部分 网络部分:前24位(即11111111.11111111.11111111,即192.168.1)。
       主机部分:后8位(即00000000,即主机地址)。
    • 网络地址计算:

     将IP地址与子网掩码进行按位“与”运算:
     IP地址:   192.168.1.10 → 11000000.10101000.00000001.00001010
     子网掩码: 255.255.255.0 → 11111111.11111111.11111111.00000000
     结果(网络部分):         11000000.10101000.00000001.00000000

    网络地址:192.168.1.0

    • 广播地址计算 广播地址是通过将主机部分(即IP地址中与子网掩码为0的部分)置为全1,得到广播地址:

    IP地址:    192.168.1.10 → 11000000.10101000.00000001.00001010
    子网掩码反码: 00000000.00000000.00000000.11111111
    结果(广播地址): 11000000.10101000.00000001.11111111

    广播地址: 192.168.1.255

    • 可用主机地址范围 主机地址范围是从 192.168.1.1到192.168.1.254。

    示例 :公司网络的子网划分(IPv4)

    • 配置

    IP地址:10.0.0.10
    子网掩码:255.255.255.128(即 /25)

    • 将子网掩码转换为二进制:

    255.255.255.128 → 11111111.11111111.11111111.10000000

    • 确定网络部分和主机部分

    网络部分:前25位(即11111111.11111111.11111111.10000000,即10.0.0和10地址段中的前25位)。
    主机部分:剩余7位。

    • 网络地址计算

    将IP地址与子网掩码进行按位“与”运算:

    IP地址: 10.0.0.10 → 00001010.00000000.00000000.00001010
    子网掩码: 255.255.255.128 → 11111111.11111111.11111111.10000000
    结果(网络部分): 00001010.00000000.00000000.00000000

    网络地址: 10.0.0.0

    • 广播地址计算 将IP地址中的主机部分设置为全1,得到广播地址:

    IP地址:    10.0.0.10   →    00001010.00000000.00000000.00001010
    子网掩码反码: 00000000.00000000.00000000.01111111
    结果(广播地址): 00001010.00000000.00000000.01111111

    广播地址: 10.0.0.127

    • 可用主机地址范围 主机地址范围是从10.0.0.1到10.0.0.126。

    示例 :多子网配置(IPv4)

    • 配置

    IP地址:192.168.2.25
    子网掩码:255.255.255.192(即 /26)

    • 将子网掩码转换为二进制

    255.255.255.192 → 11111111.11111111.11111111.11000000

    • 确定网络部分和主机部分

    网络部分:前26位(即11111111.11111111.11111111.11000000,即192.168.2和25地址段中的前26位)。
    主机部分:剩余6位。

    • 网络地址计算

    将IP地址与子网掩码进行按位“与”运算:

    IP地址: 192.168.2.25 → 11000000.10101000.00000010.00011001
    子网掩码: 255.255.255.192 → 11111111.11111111.11111111.11000000
    结果(网络部分): 11000000.10101000.00000010.00000000

    网络地址:192.168.2.0

    • 广播地址计算 将IP地址中的主机部分设置为全1,得到广播地址:

    IP地址:    192.168.2.25    → 11000000.10101000.00000010.00011001
    子网掩码反码: 00000000.00000000.00000000.00111111
    结果(网络部分): 11000000.10101000.00000010.00111111

    广播地址: 192.168.2.63

    • 可用主机地址范围 主机地址范围是从192.168.2.1到192.168.2.62。

    5.子网掩码的划分

    避免IP地址浪费:在没有子网划分的情况下,一个网络只能使用一个子网掩码,这可能导致大量IP地址的浪费。例如,一个C类网络(255.255.255.0)可以容纳254台主机(除去网络地址和广播地址)。如果一个部门只需要10台主机,那么剩下的244个IP地址就会被浪费掉。通过子网划分,可以将一个C类网络划分为多个更小的子网,每个子网根据实际需求分配主机数量,从而避免IP地址的浪费。

    子网划分是将一个大的网络划分为多个小的子网。其步骤如下:

    • 确定子网数量:根据需求确定需要划分的子网数量。
    • 计算子网掩码:根据子网数量,计算所需的子网掩码长度。
    • 分配子网地址:根据子网掩码,为每个子网分配一个网络地址。

    示例1:将C类网络192.168.1.0划分为4个子网

    1. 确定子网数量:需要4个子网。
    2. 计算子网掩码:
      • 原始子网掩码为255.255.255.0(/24),主机位有8位。
      • 需要4个子网,2²=4,因此需要借用2位主机位作为子网位。
      • 新的子网掩码为255.255.255.192(/26)。

    3. 分配子网地址:
      • 子网1:192.168.1.0/26,主机范围为192.168.1.1~192.168.1.62
      • 子网2:192.168.1.64/26,主机范围为192.168.1.65~192.168.1.126
      • 子网3:192.168.1.128/26,主机范围为192.168.1.129~192.168.1.190
      • 子网4:192.168.1.192/26,主机范围为192.168.1.193~192.168.1.254

    示例2:将B类网络172.16.0.0划分为10个子网

    1. 确定子网数量:需要10个子网。
    2. 计算子网掩码:
      • 原始子网掩码为255.255.0.0(/16),主机位有16位。
      • 需要10个子网,2⁴=16,因此需要借用4位主机位作为子网位。
      • 新的子网掩码为255.255.240.0(/20)。

    3. 分配子网地址:
      • 子网1:172.16.0.0/20,主机范围为172.16.0.1~172.16.15.254
      • 子网2:172.16.16.0/20,主机范围为172.16.16.1~172.16.31.254
      • 子网3:172.16.32.0/20,主机范围为172.16.32.1~172.16.47.254
      • 以此类推,直到172.16.160.0/20。

    示例3:公司拥有网络地址 192.168.10.0/24,需划分以下子网:

    部门 A:50 台主机
    部门 B:25 台主机
    部门 C:10 台主机
    部门 D:5 台主机
    求最优子网划分方案(要求地址利用率最高)。

    • 部门A:192.168.10.0/26 子网掩码:255.255.255.192 网络地址:192.168.10.0 广播地址:192.168.10.63 可用主机范围:192.168.10.1 - 192.168.10.62

    部门A需要50台,离50最近的是64,所以借主机位2位

    子网掩码 二进制为 11111111 11111111 11111111 11000000 —26

    十进制为 255.255.255.192

    • 部门B:192.168.10.64/27 子网掩码:255.255.255.224 网络地址:192.168.10.64 广播地址:192.168.10.95 可用主机范围:192.168.10.65 - 192.168.10.94

    部门B需要25台,离25最近的是32,所以借主机位3位

    子网掩码 二进制为 11111111 11111111 11111111 11100000 —27

    十进制为 255.255.255.224

    • 部门C:192.168.10.96/28 子网掩码:255.255.255.240 网络地址:192.168.10.96 广播地址:192.168.10.111 可用主机范围:192.168.10.97 - 192.168.10.110

    部门C需要10台,离10最近的是16,所以借主机位4位

    子网掩码 二进制为 11111111 11111111 11111111 11110000 —28

    十进制为 255.255.255.240

    • 部门D:192.168.10.112/29 子网掩码:255.255.255.248 网络地址:192.168.10.112 广播地址:192.168.10.119 可用主机范围:192.168.10.113 - 192.168.10.118

    部门D需要5台,离5最近的是8,所以借主机位5位

    子网掩码 二进制为 11111111 11111111 11111111 11111000 —29

    十进制为 255.255.255.248

    子网掩码划分的注意事项

    • 子网数量和主机数量的平衡:在划分子网时,需要根据实际需求合理选择子网掩码,既要满足子网数量的需求,又要尽量减少主机位的浪费。
    • 子网掩码的连续性:子网掩码中的1和0必须连续,不能交错出现。
    • 网络地址和广播地址:每个子网的第一个地址是网络地址,最后一个地址是广播地址,这两个地址不能分配给主机使用。

    8.MAC地址

    MAC地址:MAC地址(Media Access Control Address)是网络设备的唯一硬件标识符,由48位二进制数(6字节)组成,通常表示为12位十六进制格式(如00-1A-2B-3C-4D-5E),用于数据链路层实现局域网内设备的精准通信。

    • 每一个网卡都有一个6字节(48bit)的地址MAC地址
    • 全球唯一,固化在了网卡的中,由标准规定
    • 前3个字节:组织唯一标识符 由IEEE的注册管理机构分配给厂商
    • 后3个字节:网络接口标识符 由厂商自行分配

    MAC地址的核心特性与作用

    • 唯一性与固化性
      • MAC地址由IEEE统一分配前24位(OUI,厂商代码),后24位由厂商自行分配,确保全球唯一性
      • 出厂时烧录至网卡的EPROM中,通常不可更改(除非手动覆盖)

    • 功能定位
      • 设备识别:在局域网(LAN)内,通过MAC地址直接定位目标设备,如交换机根据MAC表转发数据帧。
      • 安全控制:可通过MAC地址过滤实现网络访问权限管理。‌‌
      • 协议支持:与ARP协议配合,将IP地址解析为MAC地址,完成跨网络通信。‌‌

    MAC地址的结构与分类

    • 格式:前3字节为厂商代码(如00-16-EA),后3字节为设备序列号。‌‌
    • 类型:
      • 单播地址(首位十六进制数为偶数):标识单一设备。
      • 多播地址(首位为奇数):用于组播通信。
      • 广播地址(全F):向局域网所有设备发送数据。‌‌

    9.华为ENSP

    eNSP(Enterprise Network Simulation Platform,企业网络仿真平台)是一款由华为提供的免费、可扩展和图形化操作的网络仿真工具平台,实现了对华为网络设备(路由器、交换机、防火墙等)进行软件仿真,支持各种生产环境中的网络模拟。

    1.eNSP功能特色介绍如下:

    (1)图形化操作:eNSP提供便捷的图形化操作界面,让复杂的组网操作变得筒单,可以直观地感受设备形态,并且支持一键获取帮助和在华为网站查询设备资料。

    (2)高仿真度:按照真实设备支持特性情况进行模拟,模拟的设备形态多,支持的功能全面,模拟的实际程度高。

    (3)可与真实设备对接:支持与真实网卡的绑定,实现模拟设备与真实设备的对接,组网更灵活。

    (4)分布式部署:eNSP不仅支持单机部署,同时还支持分布式部署在多台服务器上。分布式部署环境下能够支持更多设备组成复杂的大型网络。

    2. 安装顺序

    (1)WinPcap

    WinPcap(Windows Packet Capture) 是一个 Windows 平台下的 数据包捕获和网络分析开发工具包,允许程序直接访问网络接口,捕获和发送原始数据包(Raw Packet)。它是 libpcap(Linux 下的同类工具)的 Windows 移植版本,广泛用于网络监控、入侵检测、流量统计、协议开发等领域。

    (2)Wireshark

    Wireshark 是一款开源、跨平台的网络协议分析工具,用于捕获、分析网络流量,支持数百种协议的解析。它通过监听网络接口,实时抓取原始数据包,并以可视化方式展示协议细节,是网络工程师、安全人员和开发者诊断网络问题、学习协议原理的必备工具。

    (3)VirtualBox

    VirtualBox 是一款由 Oracle 公司开源的跨平台虚拟机软件,允许在单一物理主机上运行多个操作系统(如 Windows、Linux、macOS、Android 等)。它通过虚拟化技术将物理硬件资源虚拟化为多个独立的虚拟机(VM),每个虚拟机可运行独立的操作系统和应用程序,实现开发测试、多系统共存、环境隔离等场景。

    (4)ENSP

    3. 华为ensp文件系统VRP

    VRP是华为公司从低端到高端的全系列路由器、交换机等数据通信产品的通用网络操作系统,就如同PC上安装的Windows操作系统和手机上安装的安卓系统。VRP在华为网络设备上拥有一致的用户界面、管理界面和网络界面,可为用户提供灵活而丰富的网络应用解决方案。

    4. ensp视图分类

    (1)用户视图:

    进入命令行界面后,首先进入的就是用户视图。在提示符“<Huawei>”中,“< >”表示是用户视图,“Huawei”是设备出厂默认主机名,如图所示。

    在用户视图下,用户可以了解设备的基础信息、査询设备状态,但不能进行与业务功能相关的配置。如果需要对设备进行业务功能配置,则需要进入到系统视图。

    <Huawei>

    (2)系统视图:

    在用户视图下使用“system-view”命令切换到系统视图,此时的提示符中使用了方括号“[ ]”,系统视图下可以使用绝大部分的基础功能配置命令。另外,系统视图还提供了切换到其他视图的入口,如果要进入其他视图,必须先切换到系统视图。

    <Huawei>sys
    <Huawei>system-view
    Enter system view, return user view with Ctrl+Z.
    [Huawei]

    (3)接口视图:

    如果要对设备的具体接口进行相关配置,则还需要进入到接口视图。进入接口视图后,主机名后追加了接口类型和接口编号的信息。在接口视图下,可以完成对相应接口的配置操作,例如,配置接口的IP地址。接口视图下,主机名外的符号仍然是“[ ]”。事实上,除用户视图外,其他任何视图下的主机名外的符号都是“[ ]”。符号内除了包含主机名信息,还会有相关接口信息,例如,内容为“Huawei-GigabitEthernet0/0/0”,表示是设备第1个槽位、第1号板卡的第1个端口。

    [Huawei]int g0/0/0
    [Huawei-GigabitEthernet0/0/0]

    (4)视图之间切换

    在退出某个视图时,用户可以使用quit命令退出到上一层视图,也可以使用return命令或“Ctrl+Z”组合键直接退回到用户视图。

    5. ensp基础命令

    (1)修改主机名 sysname

    [Huawei]sysname jcx
    [jcx]

    (2)查看帮助 ?

    ----  直接使用?查看所有命令
    [jcx]?
    System view commands:
    aaa <Group> aaa command group
    aaa-authen-bypass Set remote authentication bypass
    aaa-author-bypass Set remote authorization bypass
    aaa-author-cmd-bypass Set remote command authorization bypass
    access-user User access
    acl Specify ACL configuration information
    alarm Alarm
    anti-attack Specify anti-attack configurations
    application-apperceive Set application-apperceive information

    --- 也可以命令后接 ?
    [jcx]display ip int ?
    GigabitEthernet GigabitEthernet interface
    NULL NULL interface
    brief Brief summary of IP status and configuration
    description Interface description
    | Matching output
    <cr> Please press ENTER to execute command

    (3)ensp修改时间 clock

    • 查看时间 display clock

    [jcx]display clock
    2025-06-07 16:38:01
    Saturday
    Time Zone(China-Standard-Time) : UTC-08:00

    • 配置时间需先配置时区

    <jcx>clock timezone BJ add 08:00:00
    • 再配置时间

    <jcx>clock datetime 16:00 2025-10-1
    <jcx>display clock
    2025-10-01 16:00:05
    Wednesday
    Time Zone(BJ) : UTC+08:00

    (4)ensp配置地址

    a.显示IP接口的简要信息

    [Huawei]display ip interface brief
    *down: administratively down
    ^down: standby
    (l): loopback
    (s): spoofing
    The number of interface that is UP in Physical is 1
    The number of interface that is DOWN in Physical is 3
    The number of interface that is UP in Protocol is 1
    The number of interface that is DOWN in Protocol is 3

    Interface IP Address/Mask Physical Protocol
    GigabitEthernet0/0/0 unassigned down down
    GigabitEthernet0/0/1 unassigned down down
    GigabitEthernet0/0/2 unassigned down down
    NULL0 unassigned up up(s)

    b.进入接口模式

    [Huawei]int g0/0/0
    [Huawei-GigabitEthernet0/0/0]

    c.配置IP地址

    [Huawei-GigabitEthernet0/0/0]ip address 192.168.1.1 24

    d.启用端口

    [Huawei-GigabitEthernet0/0/0]undo shutdown 

    e.查看信息

    [Huawei]display ip interface brief
    *down: administratively down
    ^down: standby
    (l): loopback
    (s): spoofing
    The number of interface that is UP in Physical is 1
    The number of interface that is DOWN in Physical is 3
    The number of interface that is UP in Protocol is 1
    The number of interface that is DOWN in Protocol is 3

    Interface IP Address/Mask Physical Protocol
    GigabitEthernet0/0/0 192.168.1.1/24 down down
    GigabitEthernet0/0/1 unassigned down down
    GigabitEthernet0/0/2 unassigned down down
    NULL0 unassigned up up(s)

    (5)设置console

    • 接入console口

    • 设置console密码

    [Huawei]user-interface console 0
    [Huawei-ui-console0]authentication-mode password

    (6)ensp连接真机

    7.1 利用的环回口

    添加环回口

    操作 - 添加过时硬件

    • 环回适配器配置地址

    • ensp连接

    (7)telnet登录

    • 添加交换机的IP地址
    • 启用telnet功能

    [Huawei]telnet server enable            ---启用telnet功能

    [Huawei]user-interface vty 0 4 ----- 进去虚拟用户终端界面

    [Huawei-ui-vty0-4]authentication-mode aaa ------配置认证模式为3a认证

    [Huawei-ui-vty0-4]protocol inbound telnet -------配置入站协议为telnet

    • 配置3A认证功能

    [Huawei]aaa                ------进入3a认证界面

    [Huawei-aaa]local-user zhangsan password cipher 123456 ----配置zhangsan用户设置密码为123456

    [Huawei-aaa]local-user zhangsan privilege level 15 -----设置zhangsan用户的权限为15最高级

    [Huawei-aaa]local-user zhangsan service-type telnet ------把该用户应用到telnet协议里

    • 远程登录

    (8)ssh登录

    • 添加交换机的IP地址
    • 启用telnet功能

    [Huawei]stelnet server enable            -----启用stelnet功能

    [Huawei]user-interface vty 0 4 ------进去虚拟用户终端界面

    [Huawei-ui-vty0-4]authentication-mode aaa -----配置认证模式为3a认证

    [Huawei-ui-vty0-4]protocol inbound ssh ------配置入站协议为ssh

    • 配置3A认证功能

    [Huawei]aaa               ----- 进入3a认证界面

    [Huawei-aaa]local-user zhangsan password cipher p-0p-0p-0 -----配置zhangsan用户设置密码为p-0p-0p-0

    [Huawei-aaa]local-user zhangsan privilege level 15 -----设置zhangsan用户的权限为15最高级

    [Huawei-aaa]local-user zhangsan service-type ssh -----把该用户应用到ssh协议里

    • 配置ssh用户采用密码认证

    [Huawei]ssh user woniu authentication-type password
    Authentication type setted, and will be in effect next time

    • 生成本地RSA密钥对

    [Huawei]rsa local-key-pair create
    The key name will be: Host
    % RSA keys defined for Host already exist.
    Confirm to replace them? (y/n)[n]:y
    The range of public key size is (512 ~ 2048).
    NOTES: If the key modulus is greater than 512,
    It will take a few minutes.
    Input the bits in the modulus[default = 512]:
    Generating keys...
    ..........++++++++++++
    ...............++++++++++++
    ........++++++++
    ....................................++++++++

    [Huawei]

    • 远程登录

    (9)根据拓扑完成vlan通信配置

    • 查看vlan

    [Huawei]display vlan

    • 创建vlan

    [Huawei]vlan 10      ------数字方式创建单个vlan
    [Huawei]vlan 20
    [Huawei]vlan bat ch 3 to 5 ------批量创建vlan

    • 将端口加入到指定vlan

    [Huawei-Ethernet0/0/1]port link-type access 				  ------指定端口的链接类型是access
    [Huawei-Ethernet0/0/1]port default vlan 10 ------将端口加入到vlan10

    • 将交换机互联的接口配置为trunk类型

    [Huawei-Ethernet0/0/3]port link-type trunk    -----指定端口类型是trunk
    [Huawei-Ethernet0/0/3]port trunk allow-pass vlan 10 20 -----设置允许通过的vlan数据

    注意:

    这里只配置了LSW1的E0/0/1接口与E0/0/3接口

    其他接口根据以上示例配置

    • 验证配置,查看当前配置文件

    [Huawei]display current-configuration 

    • 测试 ping

    (10)根据拓扑完成直连路由实验。

    • 路由配置

    <Huawei>sys  #进入系统视图
    [Huawei]int g0/0/0 #进入指定接口
    [Huawei-GigabitEthernet0/0/0]ip address 192.168.1.254 24 #设置IP
    [Huawei-GigabitEthernet0/0/0]q #返回上一级
    [Huawei]int g0/0/1 #进入指定接口
    [Huawei-GigabitEthernet0/0/1]ip address 140.205.255.254 16 #设置IP
    [Huawei-GigabitEthernet0/0/1]q #返回上一级
    [Huawei]display ip routing-table #查看路由器路由

    • 测试

    10.路由

    1.路由概念

    1)什么是路由?

    路由指路由器根据自己路由表中的路由条目判断如何转发数据包,并据此执行转发的操作。当路由器收到一个数据包时,会根据该数据包的目的IP地址查询路由表,将目的IP地址与路由表中的路由条目进行匹配,并且根据匹配的路由条目判断通过哪个接口进行数据包转发。如果没有路由条目匹配这个目的IP地址,那么路由器把数据包丢弃。

    • 路由器工作在网络层,属于三层设备;
    • 路由器的物理口连接不同网络的设备,根据路由表实现数据转发;
    • 路由表中记录了IP与物理接口对应关系。

    2)路由表(重点)

    • 自身的信息路由器获取到的直连路由的信息。
    • 管理员定义的管理员定义具体的路由路径,体现在静态路由。
    • 其他路由器获取到的动态路由协议获取的,从相邻的路由器获取的路由信息。

    display ip routing-table

    ① Destination/Mask:该列的作用是标识路由条目的目的IP地址及其子网掩码。

    ② Proto: Proto是Protocol (协议)的简写,标识的是路由条目的获得方式。其中, Direct表示直连路由;Static表示静态路由;OSPF表示动态路由协议。

    ③ Pre: Pre是Preference (路由优先级)的简写。路由设备通过多个不同的来源(包括静态配置和多种路由协议)获得去往同一个网络的路由。在这种情况下,路由设备需要通过优先级值来判断,通过哪个路由条目来转发数据包。Pre标识的是不同路由来源的可靠程度,它的值越小,路由来源的可靠度就越高。当路由器通过多种信息来

    源获得去往相同目的地的多个路由条目时,Pre只把路由优先级值最小的路由条目存入自己的路由表。

    协议优先级
    直连路由0(最高)
    OSPF10
    静态路由60
    默认路由60(比静态路由低)
    RIP100
    BGP255

    ④Cost:标识路由开销。当到达同一个目的网络的多个路由优先级相同时,路由开销最小的将成为最优路由。网络常常是四通八达的,即使通过同一种方式,路由设备也可能获得多条去往同一个网络的路由条目。Cost标识的数值叫作开销值, 表示通过同一种方式获取的路由条目,究竟孰优孰劣,其中,开销值较小的路由条目为较优的路由条目。当路由器通过同一种信息来源获得去往同一个网络的多个路由条目时, 会把开销值最小的路由条目存入自己的路由表。不同的路由协议也会采用不同的开销值计算标准。

    ⑤ Flags:其作用是显示路由标志。如果路由标志是D,则表示该路由已经下载到转发信息库。此后,当标志D的路由转发数据包时,不需要经过CPU处理,可以直接通过硬件转发—— 件转发不仅效率高,而且不占用路由设备CPU的处理资源。如果路由标志是R,则表示该路由是迭代路由。当标志R的路由转发数据包时,必须根据该路由的下一跳IP地址(NextHop)选择相应的接口来转发。此外,标志RD表示该路由之前是迭代路由,目前已经保存在转发信息库中,因此当标志RD的路由转发数据包时, 可以执行硬件转发。

    U——该路由可以使用

    G——该路由是到一个网关,如果没有该标志,说明目的地是直连的 gateway

    H——该路由是到一个主机 host

    D——该路由是由重定向报文创建的

    M——该路由已被重定向报文修改

    ⑥ NextHop:标识路由条目的下一跳IP地址。

    ⑦ Interface:标识转发数据包的接口。

    3)路由器的原理

    过程

    • 物理接口(g0/0/0)收到物理信号,将物理信号转为二进制数据;
    • 路由器物理口收到PC1发送的数据包后,查看MAC头信息,目标MAC是否为自己的MAC地址,如果不是,则丢包,否则,拆掉MAC头,暴露上层数据(IP头);
    • 查看IP头数据,确认目标IP是否存在于自己的路由表中,如果不存在,则丢包并响应目标不可达(ICMP,Type:3),如果存在,则将数据包交给对应物理接口(g0/0/2)处理;
    • 对应物理接口收到数据包后,查看MAC表,是否存在下一跳设备的MAC地址,如果不存在,则进行ARP请求获取;
    • 物理接口收到下一跳设备的MAC地址后,重新封装新的MAC头,将源MAC设置为自己的MAC,目标MAC设置为下一跳设备MAC地址;
    • 物理接口将二进制数据转为物理信号进行转发。

    4)路由分类

    • 直连路由
    • 静态路由
    • 动态路由

    2.直连路由

    特点:

    • 直接连接到路由器接口的网段
    • 优先级最高0
    • 直连的接口就是网段的网关

    路由表:

    直连路由配置以及示例:

    • 路由配置

    <Huawei>sys  #进入系统视图
    [Huawei]int g0/0/0 #进入指定接口
    [Huawei-GigabitEthernet0/0/0]ip address 192.168.1.254 24 #设置IP
    [Huawei-GigabitEthernet0/0/0]q #返回上一级
    [Huawei]int g0/0/1 #进入指定接口
    [Huawei-GigabitEthernet0/0/1]ip address 140.205.255.254 16 #设置IP
    [Huawei-GigabitEthernet0/0/1]q #返回上一级
    [Huawei]display ip routing-table #查看路由器路由

    • 测试

    3.静态路由

    特点:

    • 管理员手工配置
    • 路径明确,效率高
    • 管理困难
    • 不适合大型网络,只适合做动态路由的补充
    • 默认路由 -- 一个特殊的静态路由,只有一个出口

    配置步骤:

    • 1、配置路由器接口地址,PC端地址(配置网关--- 路由器连接的接口地址)

      2、配置静态路由

      写出每个路由器非直连网段

      AR1 --- 192.168.20.0/24 192.168.30.0/24

      AR2 --- 192.168.10.0/24

      AR3 ---- 默认路由

      开始静态路由配置:

      (1)告诉路由器要去哪 目标网段和子网掩码

      (2)怎么去

      - 从哪个口出去(自身的)
      - 去哪个路由器(下一跳地址,就是要去的路由器的它的接口地址)

    静态路由配置以及示例:

    AR1:

    AR1:
    sys
    int g0/0/0
    ip add 192.168.10.254 24
    int g0/0/1
    ip add 172.16.1.1 30
    q
    ip route-static 192.168.20.0 24 172.16.1.2

    AR2:

    AR2:
    sys
    int g0/0/0
    ip add 172.16.1.2 30
    int g0/0/1
    ip add 192.168.20.254 24
    int g0/0/2
    ip add 192.168.30.254 24
    q
    ip route-static 192.168.10.0 24 172.16.1.1

    AR3:

    AR3:
    sys
    int g0/0/0
    ip add 192.168.30.100 24
    q
    ip route-static 0.0.0.0 0 192.168.30.254

    AR4 默认路由:

    [Huawei]ip route-static 0.0.0.0 0 g0/0/0 192.168.30.254

    4.动态路由协议

    4.1 概念

    在路由器设备上运行指定的动态路由协议,让路由器之间交互特定的路由信息报文,互相学习路由条目,形成自己的路由表,并且在链路发生改变时,自动进行路由调整。

    4.2 分类

    • 距离矢量路由协议:运行距离矢量路由协议的路由器根据运行相同路由协议的路由器宣告的路由表,判断某个网络到自己的距离大小和方向,其中,大小指路由器跳数,方向指使用的接口或下一跳地址。
    • 链路状态路由协议:运行链路状态路由协议的路由器运行Dijkstra算法。路由设备首先和其他运行相同路由协议的设备建立邻接关系,并在此过程中相互同步链路状态,但并不是通告整个路由表。收到邻居路由器发送的链路状态之后,路由设备会把它放入自己的LSDB (LinkState Database,链路状态数据库),然后针对LSDB运行Dijkstra算法,计算出一个以自

    己为根、无环的最短路径树。路由设备按照这棵树计算去往各个网络的最优路径,并且把最优路径作为路由条目放入自己的路由表中。

    4.3 动态路由与静态路由区别

    静态路由配置方便,对系统要求低,适用于拓扑结构简单并且稳定的小型网络。缺点是不能自动适应网络拓扑的变化,需要人工干预。

    动态路由协议有自己的路由算法,能够自动适应网络拓扑的变化,适用于具有一定数量三层设备的网络。缺点是配置对用户要求比较高,对系统的要求高于静态路由,并将占用一定的网络资源和系统资源。

    5.RIP协议

    5.1 概念

    • RIP是Routing Information Protocol(路由信息协议)的简称,它是一种较为简单的内部网关协议(Interior Gateway Protocol)。RIP是一种基于距离矢量(Distance-Vector)算法的协议,它使用跳数(Hop Count)作为度量来衡量到达目的网络的距离。RIP通过UDP报文进行路由信息的交换,使用的端口号为520。
    • RIP协议支持最大15跳,16跳不可达;15跳就是我们的数据包最大能经过的路由器的数量。

    5.2 版本

    RIP包括RIP-1和RIP-2两个版本,RIP-2对RIP-1进行了扩充,使其更具有优势。

    RIPv1与RIPv2区别

    RIPv1RIPv2
    有类路由器协议(数据包不会携带子网掩码)无类路由协议(数据包会携带子网掩码)
    广播更新(255.255.255.255)组播更新(224.0.0.9)
    不支持可变长子网掩码(VLSM),使用标准子网掩码支持可变长子网掩码(VLSM)
    自动路由汇总,不可关闭自动汇总可关闭,可以手动汇总
    不支持不连续子网支持不连续子网

    5.3 命令

    • 创建RIP编号(取值范围:[1,65535])

    rip 编号

    • 设置RIP版本 默认是版本1

    version 版本号

    • 宣告直连网段(只支持标准A、B、C类网段)

    network IP网段

    • 手动汇总

    summary always

    动态路由配置 version 1

    AR1:

    AR1:
    lsys
    int g0/0/0
    ip add 192.168.10.254 24
    int g0/0/1
    ip add 172.16.1.1 30
    q
    rip 66
    network 192.168.10.0
    network 172.16.0.0

    AR2:

    AR2:
    sys
    int g0/0/0
    ip add 172.16.1.2 30
    int g0/0/1
    ip add 172.16.2.1 30
    q
    rip 66
    network 172.16.0.0

    AR3:

    AR3:
    sys
    int g0/0/0
    ip add 172.16.2.2 30
    int g0/0/1
    ip add 192.168.20.254 24
    q
    rip 66
    network 172.16.0.0
    network 192.168.20.0

    动态路由配置 version 2

    AR1:

    AR1:
    sys
    int g0/0/0
    ip add 192.168.1.2 30
    int g0/0/1
    ip add 172.16.10.1 24
    q
    rip 10
    version 2
    network 192.168.1.0
    network 172.16.0.0

    AR2:

    R2:
    sys
    int g0/0/0
    ip add 192.168.1.6 30
    int g0/0/1
    ip add 172.16.10.2 24
    q
    rip 10
    version 2
    network 192.168.1.0
    network 172.16.0.0

    AR3:

    AR3:
    sys
    int g0/0/0
    ip add 192.168.1.10 30
    int g0/0/1
    ip add 172.16.10.3 24
    q
    rip 10
    version 2
    network 192.168.1.0
    network 172.16.0.0

    AR4:

    AR4:
    sys
    int g0/0/0
    ip add 192.168.1.14 30
    int g0/0/1
    ip add 172.16.10.4 24
    q
    rip 10
    version 2
    network 192.168.1.0
    network 172.16.0.0

    AR5:

    AR5:
    sys
    int g0/0/0
    ip add 172.16.10.5 24
    int g0/0/1
    ip add 192.168.100.1 24
    q
    rip 10
    version 2
    network 172.16.0.0
    network 192.168.100.0

    AR6:

    AR6:
    sys
    int g0/0/0
    ip add 192.168.100.2 24
    int g0/0/1
    ip add 192.168.200.254 24
    q
    rip 10
    version 2
    network 192.168.100.0
    network 192.168.200.0

    6、OSPF协议

    1)协议概念

    开放式最短路径优先OSPF(Open Shortest Path First)是IETF组织开发的一个基于链路状态的内部网关协议(Interior Gateway Protocol)。

    2)工作原理

    a.建立邻居关系

    b.建立邻接关系 init -- 2way -- exstart -- exchange -- loading - full

    c.交换LSA数据

    3)区域分类

    区域0 area0 --- 骨干区域(必须要知道的)

    标准区域(最常用的)

    • 标准区域是最通用的区域,它传输区域内路由,区域间路由和外部路由。
    • 标准区域需要与骨干区域直连,也可以与其它AS区域连接。
    • 会产生LSA类型:1、2、3、4、5;

    末梢区域(STUB)

    • 不允许发布自治系统外部路由,只允许发布区域内路由和区域间的路由。
    • 会产生LSA类型:1、2、3(其它区域路由和通往其它AS的默认路由);

    完全末梢区域(Totally STUB)

    • 不允许发布自治系统外部路由和区域间的路由,只允许发布区域内路由。
    • 会产生LSA类型:1、2、3(通往其它区域和其它AS的默认路由);

    非纯末梢区域(NSSA)

    • 具备末梢区域特征(只允许发布区域内路由和区域间的路由);
    • 可以导入与当前区域内的ASBR直连的其它AS路由;
    • 会产生的LSA类型:1、2、3、7(与当前区域ASBR直连的其它AS路由以及通往其它AS的默认路由);

    完全非纯末梢区域(Totally NSSA)

    • 具备完全末梢区域特征(只允许发布区域内路由);
    • 具备非纯末梢区域特征(可以导入与当前区域内的ASBR直连的其它AS路由);
    • 会产生LSA类型:1、2、3(通往其它区域默认路由)、7(通往其它AS的默认路由与当前区域ASBR直连的其它AS路由);

    路由器角色

    • 区域内路由器(Internal Router):该类设备的所有接口都属于同一个OSPF区域。
    • 区域边界路由器ABR(Area Border Router):该类设备可以同时属于两个以上的区域,但其中一个必须是骨干区域。ABR用来连接骨干区域和非骨干区域,它与骨干区域之间既可以是物理连接,也可以是逻辑上的连接。
    • 自治系统边界路由器ASBR(AS Boundary Router):与其他AS交换路由信息的设备称为ASBR。ASBR并不一定位于AS的边界,它可能是区域内设备,也可能是ABR。只要一台OSPF设备引入了外部路由的信息,它就成为ASBR。

    4)信息分类

    Type1

    • 每个设备都会产生,描述了设备的链路状态和开销,在所属的区域内传播。

    Type2

    • 由DR(Designated Router)产生,描述本网段的链路状态,在所属的区域内传播。

    Type3

    • 由ABR产生,描述区域内某个网段的路由,并通告给发布或接收此LSA的非Totally STUB或NSSA区域。

    Type4

    • 由ABR产生,描述到ASBR的路由,通告给除ASBR所在区域的其他相关区域。

    Type5

    • 由ASBR产生,描述到AS外部的路由,通告到所有的区域(除了STUB区域和NSSA区域)。

    5)配置

    命令

    • 创建OSPF编号(取值范围:[1,65535])

    ospf 编号

    • 创建区域编号(取值范围:[0,4294967295],也可以使用IPv4格式)

    area 编号

    • 宣告网段

    network IP网段 通配符子网掩码(子网掩码反码)

    反码 -- 255.255.255.255减去子网掩码
    在 OSPF(开放最短路径优先)协议中,**反码(Inverse Mask)也称为通配符掩码(Wildcard Mask)**,是一个重要的概念,主要用于区域划分、路由过滤、邻居关系配置等场景。与子网掩码的 “网络位必须匹配” 规则相反,**反码用于指定 “哪些位可以忽略匹配”**,将子网掩码的每一位取反(`0` 变 `1`,`1` 变 `0`)。

    • OSPF区域中导入直连路由

    ospf 编号import-route direct

    • OSPF区域中导入静态路由

    ospf 编号import-route static

    • OSPF区域中导入默认路由

    ospf 编号default-route-advertise

    • OSPF区域中导入RIP路由

    ospf 编号import-route rip 编号

    • RIP区域中导入直连路由

    rip 编号import-route direct

    • RIP区域中导入静态路由

    rip 编号import-route static

    • RIP区域中导入默认路由

    rip 编号default-route originate

    • RIP区域中导入OSPF路由

    rip 编号import-route ospf 编号

    • 设置末梢区域

    ospf 编号area 编号stub

    • 设置完全末梢区域

    ospf 编号area 编号stub no-summary

    • 设置非纯末梢区域

    ospf 编号area 编号nssa

    • 设置完全非纯末梢区域

    ospf 编号area 编号nssa no-summary

    单区域ospf配置

    AR1:

    AR1:
    sys
    int g0/0/0
    ip add 192.168.10.254 24
    int g0/0/1
    ip add 172.16.1.1 30
    q
    ospf 100
    area 0
    network 192.168.10.0 0.0.0.255
    network 172.16.1.0 0.0.0.3

    AR2:

    AR2:
    sys
    int g0/0/0
    ip add 172.16.1.2 30
    int g0/0/1
    ip add 192.168.20.254 24
    q
    ospf 100
    area 0
    network 192.168.20.0 0.0.0.255
    network 172.16.1.0 0.0.0.3

    多区域ospf配置

    AR1:

    AR1:
    sys
    int g0/0/0
    ip add 192.168.10.254 24
    int g0/0/1
    ip add 172.16.1.1 30
    q
    ospf 100
    area 0
    network 192.168.10.0 0.0.0.255
    network 172.16.1.00.0.0.3
    q
    int g0/0/2
    ip add 172.16.2.1 30
    ospf 100
    area 1
    network 172.16.2.00.0.0.3

    AR2:

    AR2:
    sys
    int g0/0/0
    ip add 172.16.1.2 30
    int g0/0/1
    ip add 192.168.20.254 24
    q
    ospf 100
    area 0
    network 192.168.20.0 0.0.0.25
    network 172.16.1.0 0.0.0.3
    q
    int g0/0/2
    ip add 172.16.3.1 30
    q
    rip 100
    version 2
    network 172.16.0.0
    ospf 100
    import-route rip 100
    rip 100
    import-route ospf 100

    AR3:

    AR3:
    sys
    int g0/0/0
    ip add 192.168.30.254 24
    int g0/0/1
    ip add 172.16.2.2 30
    q
    ospf 100
    area 1
    network 172.16.2.0 0.0.0.3
    network 192.168.30.0 0.0.0.255

    AR4:

    AR4:
    sys
    int g0/0/0
    ip add 172.16.3.2 30
    int g0/0/1
    ip add 192.168.40.254 24
    q
    rip 100
    version 2
    network 172.16.0.0
    network 192.168.40.0