计算机网络
计算机网络
一.计算机网络的概念
1.1计算机网络定义
计算机网络是将地理位置分散、具有独立功能的计算机及外部设备,通过通信线路与设备(如路由器、交换机)连接起来,并在网络协议(如TCP/IP)的统一协调下,实现资源共享(如文件、打印机共享)与信息传递(如网页浏览、邮件收发)的系统。
1.2 计算机网络组成
- 硬件:包括计算机(如服务器、工作站、笔记本电脑等)、网络设备(如路由器、交换机、调制解调器等)以及传输介质(如双绞线、光纤、无线电波等)。
- 软件:包含网络操作系统(如 Windows Server、Linux 等)、网络协议(如 TCP/IP、HTTP、FTP 等)和网络应用程序(如浏览器、电子邮件客户端等)。
1.3 计算机网络分类
(1)按覆盖范围分类
- 局域网(LAN,Local Area Network)
- 定义:通常覆盖范围较小,一般在一个建筑物内(如家庭、学校、办公室等),用于连接计算机和其他设备,实现资源共享和数据通信。
- 特点:传输速率高(常见的有 10Mbps、100Mbps、1000Mbps 甚至更高)、延迟低、误码率低,网络拓扑结构相对简单,易于管理和维护。
- 示例:家庭中通过无线路由器连接的多台设备组成的网络;学校机房内计算机通过交换机连接形成的网络。
- 城域网(MAN,Metropolitan Area Network)
- 定义:覆盖一个城市的范围,通常由多个局域网互联而成,用于实现城市内不同区域之间的网络通信。
- 特点:传输速率适中,介于局域网和广域网之间;覆盖范围较大,需要使用一些特殊的通信技术和设备来保证网络的稳定性和可靠性。
- 示例:城市中的有线电视网络、城市政务网络等。
- 广域网(WAN,Wide Area Network)
- 定义:覆盖范围非常大,可以跨越城市、国家甚至全球,通过公共通信网络(如电话网、卫星通信等)将多个局域网和城域网连接起来。
- 特点:传输速率相对较低,延迟较高,误码率也相对较高;网络拓扑结构复杂,管理和维护难度较大。
- 示例:互联网就是最大的广域网,它连接了全球数以亿计的计算机和设备。
(2)按拓扑结构分类
- 总线型拓扑
- 定义:所有设备都连接在一条称为总线的公共传输介质上,信息沿着总线进行传输。
- 特点:结构简单,易于安装和扩展;但可靠性较低,一旦总线出现故障,整个网络将瘫痪;并且随着设备数量的增加,网络性能会下降。
- 示例:早期的以太网采用的就是总线型拓扑结构。
- 星型拓扑
- 定义:以一个中心节点(如交换机或集线器)为核心,其他设备都通过单独的线路连接到中心节点上。
- 特点:可靠性高,单个设备故障不会影响其他设备的正常通信;易于管理和维护;但中心节点一旦出现故障,整个网络将受到影响。
- 示例:现代企业网络和家庭网络中广泛使用的以太网交换机连接方式就是星型拓扑结构。
- 环型拓扑
- 定义:所有设备连接成一个闭合的环,信息沿着环单向或双向传输。
- 特点:结构简单,传输路径固定,实时性较好;但可靠性较低,任何一个节点出现故障都可能导致整个网络瘫痪;并且网络扩展困难。
- 示例:早期的令牌环网采用的就是环型拓扑结构。
- 树型拓扑
- 定义:是一种层次化的拓扑结构,类似于树的形状,由根节点、分支节点和叶子节点组成。
- 特点:易于扩展和管理,适合大规模网络;但根节点的可靠性对整个网络影响较大。
- 示例:企业内部的网络架构可能采用树型拓扑结构,总部作为根节点,各个分支机构作为分支节点,终端设备作为叶子节点。
- 网状型拓扑
- 定义:每个节点都与其他多个节点直接相连,形成一个复杂的网状结构。
- 特点:可靠性高,容错能力强,任何一个节点或链路出现故障都不会影响整个网络的正常运行;但网络建设成本高,管理和维护难度大。
- 示例:大型数据中心和核心骨干网络通常采用网状型拓扑结构。
(3)按使用目的分类
- 公用网
- 定义:由电信部门或其他提供通信服务的运营商建设和管理,向公众开放使用的网络,如互联网。
- 特点:覆盖范围广,用户数量多,提供多种服务;但安全性和可靠性相对较低,需要用户自行采取安全措施。
- 专用网
- 定义:为特定的组织或机构(如企业、政府部门等)内部使用而建设的网络,不向公众开放。
- 特点:可以根据用户的需求进行定制化设计,安全性和可靠性较高;但建设和维护成本较高,覆盖范围相对较小。
- 示例:企业内部的办公网络、银行的内部网络等都属于专用网。
二.OSI七层模型
- 七层模型,亦称OSI(Open System Interconnection)。参考模型是国际标准化组织(ISO)制定的一个用于计算机或通信系统间互联的标准体系,一般称为OSI参考模型或七层模型。 它是一个七层的、抽象的模型体,不仅包括一系列抽象的术语或概念,也包括具体的协议。
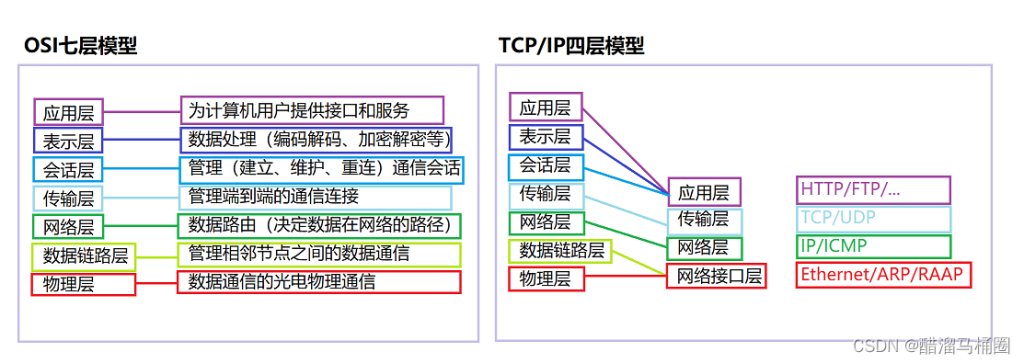
应用层
- 功能:负责网络应用的实际运行。是OSI的最高层,为网络用户之间的通信提供专用的程序。许多网络应用软件、网络操作系统都是在该层次上的直接应用
表示层
- 功能:负责数据格式的编码和解码,以及数据的加密与解密、压缩与解压缩等。它主要是将计算机能够识别的东西转换成人能够识别的东西
会话层
- 功能:负责建立和维护会话。主要在你的系统之间发起会话或接受会话请求(设备之间需要互相认识可以是IP也可以是MAC或者是主机名)。
传输层
- 负责端到端的数据传输和可靠性保证。定义了一些传输数据的协议和端口号,如TCP(传输控制协议,传输效率低,可靠性强)和UDP(用户数据报协议,与TCP特性相反)。传输层将下层接收的数据进行分段和传输,到达目的地址后再进行重组。
网络层
- 功能:负责将数据包从源节点传输到目标节点。主要将从下层接收到的数据进行IP地址的封装与解封装。网络层是网络通信的小型控制中心,它根据网络条件、服务的优先权和其它因素来决定数据应使用哪一条路由进行传送。
数据链路层
- 功能:负责网络节点之间的数据传输和错误检测。主要将从物理层接收的数据进行MAC地址(网卡的地址)的封装与解封装。
物理层
- 功能:定义物理设备标准,如网线的接口类型、光纤的接口类型、各种传输介质的传输速率等。物理层是OSI分层结构体系中最重要、最基础的一层,它建立在传输媒介基础上,起建立、维护和取消物理连接作用,实现设备之间的物理接口连接。解决使用何种信号来表示比特0和比特1的问题数据单位:比特(bit),即二进制数据。
三.TCP/IP四层模型
应用层
应用层的协议包括HTTP、FTP、Telnet、DNS、SMTP等
传输层
TCP、UDP
网络层
网络接口层
四.数据封装与解封装
- 数据封装:数据--段--包--帧--比特流
- 解封装:比特流--帧--包--段--数据
核心概念:分层模型
数据封装和解封装发生在分层的网络模型(如TCP/IP模型或OSI模型)中。每一层为它从上层接收到的数据添加特定的控制信息(头部,有时还有尾部),然后将整个结构传递给下一层。接收端则逐层剥离这些信息。
1. 封装(Encapsulation:发送端 - 自上而下加“包装”)
封装发生在数据发送端。数据从应用层开始,逐层向下传递,每一层都为其添加本层的控制信息(头部/报头),就像给数据包上包装一样。目的是让数据能在网络中正确传输、路由和交付。
- 步骤 (以 TCP/IP 模型为例,对应 OSI 层):
- 应用层(Application Layer - OSI 5-7): 用户生成原始数据(如电子邮件内容、网页请求)。这个数据块称为 数据(Data) 或 消息(Message)。
- 传输层(Transport Layer - OSI 4): 接收应用层的数据。
- 添加 传输层头部(TCP Header 或 UDP Header)。头部包含关键信息如 源端口号、目标端口号(用于标识发送和接收的应用程序)、序列号、确认号(TCP)、校验和等。
- 封装后的数据单元称为 段(Segment - TCP) 或 数据报(Datagram - UDP)。
- 网络层(Internet Layer - OSI 3): 接收传输层的段/数据报。
- 添加 网络层头部(IP Header)。头部包含关键信息如 源 IP 地址、目标 IP 地址(用于跨网络路由)、生存时间(TTL)、协议标识符(标识上层是TCP还是UDP)等。
- 封装后的数据单元称为 包(Packet) 或 数据报(Datagram)(在IP层常称为IP数据报)。
- 网络接口层(Link Layer - OSI 1-2): 接收网络层的包。
- 添加 数据链路层头部(Frame Header) 和 尾部(Frame Trailer)。
- 头部包含 源 MAC 地址、目标 MAC 地址(用于在同一物理网络段内设备间的寻址)、帧类型 等。
- 尾部通常包含 帧校验序列(FCS),用于检测传输错误。
- 封装后的数据单元称为 帧(Frame)。
- 物理层(Physical Layer - OSI 1): 接收数据链路层的帧。
- 将帧转换成适合物理介质(网线、光纤、无线电波)传输的 比特流(Bits)(0和1的序列)。
- 这个过程涉及编码(如曼彻斯特编码、NRZ)、调制(如Wi-Fi的QAM)等,不添加头部信息,只是格式转换。
- 比特流通过物理介质发送出去。
封装过程总结(发送端): 数据 (应用层) -> [+TCP/UDP头] = 段/数据报 (传输层) -> [+IP头] = 包 (网络层) -> [+帧头 & 帧尾] = 帧 (数据链路层) -> 比特流 (物理层)
2. 解封装(Decapsulation:接收端 - 自下而上拆“包装”)
解封装发生在数据接收端。比特流从物理介质到达,接收端设备从物理层开始,逐层向上传递,每一层剥离本层的控制信息(头部/尾部),并将剩余的有效载荷传递给上层。目的是最终将原始数据交付给目标应用程序。
- 步骤 (接收端):
- 物理层(Physical Layer): 从物理介质接收到 比特流(Bits)。
- 将比特流转换成 帧(Frame) 的结构(识别帧的开始和结束)。传递给数据链路层。
- 数据链路层(Link Layer):
- 检查 帧尾的 FCS,验证帧在传输过程中是否出错(若有错则丢弃)。
- 剥离 帧头 和 帧尾。
- 检查 帧头中的目标 MAC 地址 是否与本机 MAC 地址或广播/组播地址匹配。匹配则将其中的 包(Packet) 传递给网络层。
- 网络层(Internet Layer):
- 剥离 IP 头。
- 检查 IP 头中的目标 IP 地址 是否与本机 IP 地址匹配。匹配则根据 IP 头中的协议标识符(如 TCP=6, UDP=17)将内部的 段(Segment) 或 数据报(Datagram) 传递给相应的传输层协议(TCP 或 UDP)。
- (如果是路由器,则根据目标IP地址进行路由转发,而不是解封装到上层)。
- 传输层(Transport Layer):
- 剥离 TCP 头 或 UDP 头。
- 检查 头中的目标端口号,识别是哪个应用程序在等待数据。
- 将 数据(Data) 传递给该端口号对应的应用层进程。
- (TCP还会处理序列号、确认、重传等可靠传输机制)。
- 应用层(Application Layer): 接收传输层传递上来的 原始数据(Data),供应用程序使用(如显示邮件内容、加载网页)。
- 物理层(Physical Layer): 从物理介质接收到 比特流(Bits)。
解封装过程总结(接收端): 比特流 (物理层) -> 帧 (数据链路层) -> [-帧头 & 帧尾] = 包 (网络层) -> [-IP头] = 段/数据报 (传输层) -> [-TCP/UDP头] = 数据 (应用层)
关键点:
- 封装是加头(尾),解封装是拆头(尾)。
- 每一层只处理本层添加的头部信息。下层对上层添加的头部是“透明”的(当作数据的一部分)。
- 封装确保数据包含足够的信息在网络中传输、路由、可靠交付到正确的应用程序。
- 解封装确保数据被正确接收、校验、并最终交付给目标应用程序。
- 你提到的“数据解封是数据--段--包--帧--比特流”实际上是解封装过程的逆序描述:
- 接收端:
比特流 -> 帧 -> 包 -> 段 -> 数据 - 发送端:
数据 -> 段 -> 包 -> 帧 -> 比特流
- 接收端:
封装和解封装是相辅相成的过程,是网络设备(主机、路由器、交换机)进行通信的基础。
五.网络设备
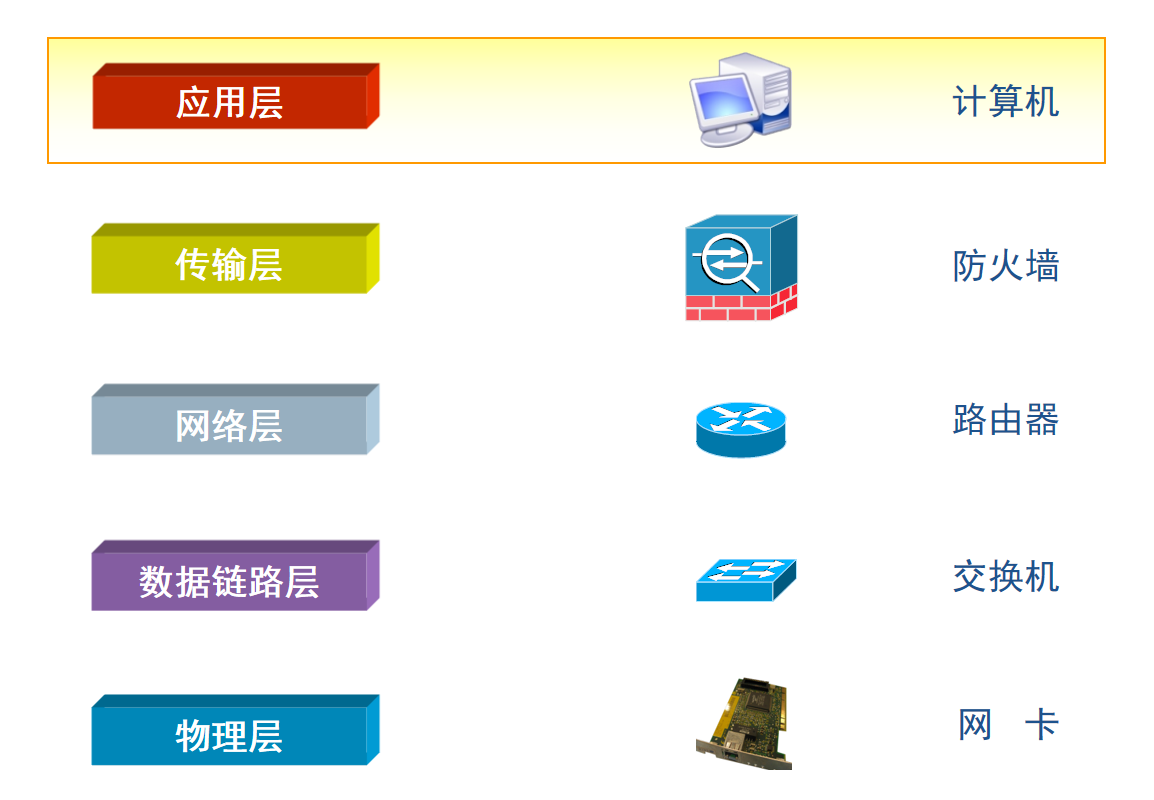
六.网络协议
1.IP协议
1.1 IP地址的定义
IP地址(Internet Protocol Address)是用于标识网络中每一台计算机或设备的唯一标识符。IP地址遵循网络层协议,通过数字形式(IPv4)或更长的字符形式(IPv6)表示。IP地址的作用是确保数据包能够从源设备准确地送达目标设备。
1.2 IPv4与IPv6
- IPv4地址由32个二进制位组成,通常以四个十进制数字(每个数字为0-255)表示,每个数字之间用点分隔。比如:192.168.1.1。
- IPv6地址则由128个二进制位组成,通常以八组16位的十六进制数表示,每组之间用冒号分隔。IPv6地址是由8个块组成,每个块由4个十六进制数字表示。例如,IPv6地址的一部分可能是0000、1234 或 abcd 等。每个块的值从 0000 到 ffff 都是有效的。比如:2001:0db8:85a3:0000:0000:8a2e:0370:7334。
1.3 IP地址的结构组成
IPv4地址可以分为两部分:
- 网络部分:用于标识网络的唯一性
- 主机部分:用于标识网络中具体的设备(主机)
对于IPv6,结构更加复杂和灵活,IPv6地址通常分为三部分:
- 前缀部分:与网络地址相关,标识网络
- 子网部分:用于标识子网
- 接口标识符:用于标识单个设备或主机
IP地址点分十进制记法
以 IPV4 为例,IPV4 的地址长度为32位,共4个字节,但实际中我们会用到点分十进制记法。
例如:
(1)机器存放的 IP 地址是 32 位二进制代码 —— 10000000000010110000001100011111
(2)每隔 8 位插入一个空格,提高可读性 —— 10000000 00001011 00000011 00011111
(3)将每 8 位的二进制数转换为十进制数 —— 128 11 3 31
(4)采用点分十进制记法,更加便于使用 —— 128.11.3.31
1.3 IP地址的分类
- 五类地址
| 1.0.0.0 ~ 126.255.255.255 | A类 | 网络8位,主机24位 |
|---|---|---|
| 128.0.0.0 ~ 191.255.255.255 | B类 | 网络16位,主机16位 |
| 192.0.0.0 ~ 223.255.255.255 | C类 | 网络24位,主机8位 |
| 224.0.0.0 ~ 239.255.255.255 | D类 | 不分网络地址和主机地址,作为组播地址 |
| 240.0.0.0 ~ 255.255.255.255 | E类 | 不分网络地址和主机地址 |
- 特殊地址
| 127.x.x.x | 回环地址 | 如127.0.0.1 等效于localhost或本机IP。 |
|---|---|---|
| 255.255.255.255 | 广播地址 |
- 私有地址
| A 类地址 | 10.0.0.0 - 10.255.255.255 (前一个字节为网络号,后三个为主机号 ) |
|---|---|
| B 类地址 | 172.16.0.0-172.31.255.255( 前两个为网络号,后两个为主机号 ) |
| C 类地址 | 192.168.0.0-192.168.255.255( 前 3 个为网络号,后 1 个为主机号 ) |
2.ICMP协议
作用:测试网络连通性
ping命令
windows系统:
-t选项 一直发包,按ctrl + c终止
-n选项 指定发包数量
-l选项 指定发包大小
-----n选项 指定发包数量
C:\Users\Administrator>ping -n 2 baidu.com
正在 Ping baidu.com [110.242.68.66] 具有 32 字节的数据:
来自 110.242.68.66 的回复: 字节=32 时间=38ms TTL=48
来自 110.242.68.66 的回复: 字节=32 时间=39ms TTL=48
110.242.68.66 的 Ping 统计信息:
数据包: 已发送 = 2,已接收 = 2,丢失 = 0 (0% 丢失),
往返行程的估计时间(以毫秒为单位):
最短 = 38ms,最长 = 39ms,平均 = 38ms
C:\Users\Administrator>ping -n 100000000000000000000000000 baidu.com
正在 Ping baidu.com [110.242.68.66] 具有 32 字节的数据:
来自 110.242.68.66 的回复: 字节=32 时间=39ms TTL=48
来自 110.242.68.66 的回复: 字节=32 时间=41ms TTL=48
----- -l选项 指定发包大小
C:\Users\Administrator>ping -l 1000 baidu.com
正在 Ping baidu.com [110.242.68.66] 具有 1000 字节的数据:
来自 110.242.68.66 的回复: 字节=1000 时间=48ms TTL=48
来自 110.242.68.66 的回复: 字节=1000 时间=69ms TTL=48
110.242.68.66 的 Ping 统计信息:
数据包: 已发送 = 2,已接收 = 2,丢失 = 0 (0% 丢失),
往返行程的估计时间(以毫秒为单位):
最短 = 48ms,最长 = 69ms,平均 = 58ms
Control-C
^C
C:\Users\Administrator>ping -l 1000000 baidu.com
选项 -l 的值有错误,有效范围从 0 到 65500。
3.ARP协议
- 作用 - 将IP地址解析为MAC地址
arp -a 显示所有的IP地址和mac地址的对应关系
C:\Users\Administrator>arp -a
接口: 192.168.3.67 --- 0x5
Internet 地址 物理地址 类型
192.168.3.1 80-05-88-e9-4e-79 动态
192.168.3.5 bc-f4-d4-73-38-05 动态
192.168.3.6 78-af-08-7e-e3-b1 动态
192.168.3.12 98-3b-8f-02-45-ef 动态
192.168.3.13 20-1e-88-01-16-ed 动态
192.168.3.14 9e-ec-f1-99-d7-51 动态
192.168.3.18 34-6f-24-a6-ca-95 动态
192.168.3.21 78-2b-46-cf-db-90 动态
192.168.3.28 dc-21-48-7e-46-31 动态
192.168.3.30 9c-67-d6-bc-5b-6a 动态
192.168.3.31 e8-b0-c5-8b-04-c0 动态
192.168.3.32 b0-dc-ef-db-23-42 动态
192.168.3.36 8c-c8-4b-c1-19-05 动态
192.168.3.38 12-74-14-f3-9f-3c 动态
192.168.3.40 3a-ae-7d-b8-34-8e 动态
192.168.3.42 ae-53-f7-99-45-e8 动态
192.168.3.43 b0-68-e6-3a-09-89 动态
192.168.3.49 5e-d1-74-7a-27-30 动态
192.168.3.69 e4-aa-ea-9f-8f-3f 动态
192.168.3.70 10-63-c8-fb-9c-bf 动态
192.168.3.77 66-c7-c6-f5-04-39 动态
192.168.3.79 e6-b4-7c-65-0e-b8 动态
192.168.3.89 c8-b2-9b-69-60-f4 动态
如何清除当前主机arp缓存 arp -d *
如果只想删除特定IP地址的ARP条目,可以将*替换为具体的IP地址,例如:
arp -d 192.168.1.100
静态绑定ip地址和mac地址
arp -s ip地址 mac地址
arp攻击
制作假的对应关系
192.168.3.32 b0-dc-ef-db-23-42
192.168.3.90 e4-aa-ea-9f-8f-b5
192.168.3.90 a1-22-33-44-55-66
arp欺骗
伪造的网关数据
7.子网掩码
1.概念
- 定义 子网掩码(Subnet Mask)是用于将IP地址分成网络部分和主机部分的工具。它与IP地址相结合,用于确定网络地址和可用的主机地址。 子网掩码也是由32位二进制数构成,其中“1”表示网络部分,"0"表示主机部分。子网掩码通常和IP地址一起使用,以确定哪些IP地址属于同一网络。
- 作用 分割网络:子网掩码允许将一个大的网络划分为多个小网络(子网),以提高网络的管理效率。 决定网络范围:通过与IP地址按位进行“与”操作(AND运算),子网掩码可以帮助确定IP地址所在的网络范围。
- 示例(IPv4) 子网掩码 255.255.255.0,即/24(表示前24位是网络部分)。 子网掩码 255.255.255.128,即/25(表示前25位是网络部分)。
- 示例(IPv6) IPv6网络2001:0db8:85a3::/48:前48位是网络部分,后80位可用于划分子网。 IPv6网络2001:0db8:85a3::/64:前64位是网络部分,后64位用于主机部分,通常用于标识单个主机。
子网掩码的格式
网掩码是一个32位的二进制数,通常以点分十进制形式表示(例如:255.255.255.0)。它的特点是:
- 网络部分为1:子网掩码中,网络部分的位全为1。
- 主机部分为0:子网掩码中,主机部分的位全为0。
- 连续性:1和0必须连续,不能交错出现。
例如:
- 子网掩码255.255.255.0表示前24位为网络部分,后8位为主机部分。
- 子网掩码255.255.255.192表示前26位为网络部分,后6位为主机部分。
子网掩码的分类
根据子网掩码的长度,可以将子网掩码分为以下几种类型:
- 默认子网掩码:对应于A、B、C三类IP地址的默认子网掩码。
- A类:255.0.0.0(/8)
- B类:255.255.0.0(/16)
- C类:255.255.255.0(/24)
- 自定义子网掩码:通过修改默认子网掩码,可以实现子网划分。例如,将C类网络的子网掩码从255.255.255.0修改为255.255.255.192。
2.网络地址
- 定义 网络地址是由IP地址和子网掩码计算得出的结果,它表示网络本身,而不是网络中的某个具体主机。网络地址是网络的标识符,通常不能分配给主机。
- 计算 网络地址是通过将IP地址与子网掩码进行按位与运算得到的。 对于IPv6,网络地址也是通过前缀来定义的。前缀可以表示一个完整的网络或子网,通过根据前缀长度来确定网络地址范围。
- 作用这个网络地址的作用是标识一个子网或网络区域,通常用于路由选择和数据包的转发。
3.主机地址
- 定义 主机地址是IP地址中的一部分,表示网络中某个特定设备(主机)的唯一标识符。它位于由子网掩码划分出的网络部分之外,通常是在网络地址之后的部分。主机地址是区分网络内不同设备的标识符。
- 计算 主机地址是通过将IP地址和子网掩码进行按位与运算后得到的网络地址部分以外的剩余部分。简单来说,主机地址对应于IP地址中的主机部分,它位于子网掩码中标识为0的位置,即IP地址和子网掩码的反码进行与运算。 在IPv6中,主机地址由网络地址的前缀长度决定,网络前缀后面部分即为主机地址的范围。
- 作用 主机地址的作用是标识同一网络中的不同设备。每个设备在其网络内有一个唯一的主机地址,它在网络中用于确定通信的具体目标。例如,在局域网(LAN)中,每台计算机、打印机等设备都有一个主机地址,用于在该网络内进行数据传输。 主机地址通常用于在本地网络内进行设备间的通信以及从路由器或其他设备中获取数据。
4. IP地址、子网掩码、网络地址和主机地址示例分析
示例 :典型家庭网络(IPv4)
- 配置
 IP地址:192.168.1.10
 子网掩码:255.255.255.0
- 将子网掩码转换为二进制
255.255.255.0 → 11111111.11111111.11111111.00000000
- 确定网络部分和主机部分 网络部分:前24位(即11111111.11111111.11111111,即192.168.1)。
主机部分:后8位(即00000000,即主机地址)。 - 网络地址计算:
 将IP地址与子网掩码进行按位“与”运算:
 IP地址:    192.168.1.10 → 11000000.10101000.00000001.00001010
 子网掩码:  255.255.255.0 → 11111111.11111111.11111111.00000000
 结果(网络部分):         11000000.10101000.00000001.00000000
网络地址:192.168.1.0
- 广播地址计算 广播地址是通过将主机部分(即IP地址中与子网掩码为0的部分)置为全1,得到广播地址:
IP地址:    192.168.1.10 → 11000000.10101000.00000001.00001010
子网掩码反码:               00000000.00000000.00000000.11111111
结果(广播地址):            11000000.10101000.00000001.11111111
广播地址: 192.168.1.255
- 可用主机地址范围 主机地址范围是从 192.168.1.1到192.168.1.254。
示例 :公司网络的子网划分(IPv4)
- 配置
IP地址:10.0.0.10
子网掩码:255.255.255.128(即 /25)
- 将子网掩码转换为二进制:
255.255.255.128 → 11111111.11111111.11111111.10000000
- 确定网络部分和主机部分
网络部分:前25位(即11111111.11111111.11111111.10000000,即10.0.0和10地址段中的前25位)。
主机部分:剩余7位。
- 网络地址计算
将IP地址与子网掩码进行按位“与”运算:

IP地址:    10.0.0.10   →    00001010.00000000.00000000.00001010
子网掩码:  255.255.255.128 → 11111111.11111111.11111111.10000000
结果(网络部分):              00001010.00000000.00000000.00000000
网络地址: 10.0.0.0
- 广播地址计算 将IP地址中的主机部分设置为全1,得到广播地址:
IP地址:    10.0.0.10   →    00001010.00000000.00000000.00001010
子网掩码反码:                00000000.00000000.00000000.01111111
结果(广播地址):            00001010.00000000.00000000.01111111
广播地址: 10.0.0.127
- 可用主机地址范围 主机地址范围是从10.0.0.1到10.0.0.126。
示例 :多子网配置(IPv4)
- 配置
IP地址:192.168.2.25
子网掩码:255.255.255.192(即 /26)
- 将子网掩码转换为二进制
255.255.255.192 → 11111111.11111111.11111111.11000000
- 确定网络部分和主机部分
网络部分:前26位(即11111111.11111111.11111111.11000000,即192.168.2和25地址段中的前26位)。
主机部分:剩余6位。
- 网络地址计算
将IP地址与子网掩码进行按位“与”运算:

IP地址:    192.168.2.25    → 11000000.10101000.00000010.00011001
子网掩码:  255.255.255.192  → 11111111.11111111.11111111.11000000
结果(网络部分):               11000000.10101000.00000010.00000000
网络地址:192.168.2.0
- 广播地址计算 将IP地址中的主机部分设置为全1,得到广播地址:
IP地址:    192.168.2.25    → 11000000.10101000.00000010.00011001
子网掩码反码:                  00000000.00000000.00000000.00111111
结果(网络部分):               11000000.10101000.00000010.00111111
广播地址: 192.168.2.63
- 可用主机地址范围 主机地址范围是从192.168.2.1到192.168.2.62。
5.子网掩码的划分
避免IP地址浪费:在没有子网划分的情况下,一个网络只能使用一个子网掩码,这可能导致大量IP地址的浪费。例如,一个C类网络(255.255.255.0)可以容纳254台主机(除去网络地址和广播地址)。如果一个部门只需要10台主机,那么剩下的244个IP地址就会被浪费掉。通过子网划分,可以将一个C类网络划分为多个更小的子网,每个子网根据实际需求分配主机数量,从而避免IP地址的浪费。
子网划分是将一个大的网络划分为多个小的子网。其步骤如下:
- 确定子网数量:根据需求确定需要划分的子网数量。
- 计算子网掩码:根据子网数量,计算所需的子网掩码长度。
- 分配子网地址:根据子网掩码,为每个子网分配一个网络地址。
示例1:将C类网络192.168.1.0划分为4个子网
- 确定子网数量:需要4个子网。
- 计算子网掩码:
- 原始子网掩码为255.255.255.0(/24),主机位有8位。
- 需要4个子网,2²=4,因此需要借用2位主机位作为子网位。
- 新的子网掩码为255.255.255.192(/26)。
- 分配子网地址:
- 子网1:192.168.1.0/26,主机范围为192.168.1.1~192.168.1.62
- 子网2:192.168.1.64/26,主机范围为192.168.1.65~192.168.1.126
- 子网3:192.168.1.128/26,主机范围为192.168.1.129~192.168.1.190
- 子网4:192.168.1.192/26,主机范围为192.168.1.193~192.168.1.254
示例2:将B类网络172.16.0.0划分为10个子网
- 确定子网数量:需要10个子网。
- 计算子网掩码:
- 原始子网掩码为255.255.0.0(/16),主机位有16位。
- 需要10个子网,2⁴=16,因此需要借用4位主机位作为子网位。
- 新的子网掩码为255.255.240.0(/20)。
- 分配子网地址:
- 子网1:172.16.0.0/20,主机范围为172.16.0.1~172.16.15.254
- 子网2:172.16.16.0/20,主机范围为172.16.16.1~172.16.31.254
- 子网3:172.16.32.0/20,主机范围为172.16.32.1~172.16.47.254
- 以此类推,直到172.16.160.0/20。
示例3:公司拥有网络地址 192.168.10.0/24,需划分以下子网:
部门 A:50 台主机
部门 B:25 台主机
部门 C:10 台主机
部门 D:5 台主机
求最优子网划分方案(要求地址利用率最高)。
- 部门A:192.168.10.0/26 子网掩码:255.255.255.192 网络地址:192.168.10.0 广播地址:192.168.10.63 可用主机范围:192.168.10.1 - 192.168.10.62
部门A需要50台,离50最近的是64,所以借主机位2位
子网掩码 二进制为 11111111 11111111 11111111 11000000 —26
十进制为 255.255.255.192
- 部门B:192.168.10.64/27 子网掩码:255.255.255.224 网络地址:192.168.10.64 广播地址:192.168.10.95 可用主机范围:192.168.10.65 - 192.168.10.94
部门B需要25台,离25最近的是32,所以借主机位3位
子网掩码 二进制为 11111111 11111111 11111111 11100000 —27
十进制为 255.255.255.224
- 部门C:192.168.10.96/28 子网掩码:255.255.255.240 网络地址:192.168.10.96 广播地址:192.168.10.111 可用主机范围:192.168.10.97 - 192.168.10.110
部门C需要10台,离10最近的是16,所以借主机位4位
子网掩码 二进制为 11111111 11111111 11111111 11110000 —28
十进制为 255.255.255.240
- 部门D:192.168.10.112/29 子网掩码:255.255.255.248 网络地址:192.168.10.112 广播地址:192.168.10.119 可用主机范围:192.168.10.113 - 192.168.10.118
部门D需要5台,离5最近的是8,所以借主机位5位
子网掩码 二进制为 11111111 11111111 11111111 11111000 —29
十进制为 255.255.255.248
子网掩码划分的注意事项
- 子网数量和主机数量的平衡:在划分子网时,需要根据实际需求合理选择子网掩码,既要满足子网数量的需求,又要尽量减少主机位的浪费。
- 子网掩码的连续性:子网掩码中的1和0必须连续,不能交错出现。
- 网络地址和广播地址:每个子网的第一个地址是网络地址,最后一个地址是广播地址,这两个地址不能分配给主机使用。
8.MAC地址
MAC地址:MAC地址(Media Access Control Address)是网络设备的唯一硬件标识符,由48位二进制数(6字节)组成,通常表示为12位十六进制格式(如00-1A-2B-3C-4D-5E),用于数据链路层实现局域网内设备的精准通信。
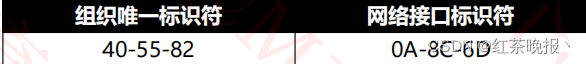
- 每一个网卡都有一个6字节(48bit)的地址MAC地址
- 全球唯一,固化在了网卡的中,由标准规定
- 前3个字节:组织唯一标识符 由IEEE的注册管理机构分配给厂商
- 后3个字节:网络接口标识符 由厂商自行分配
MAC地址的核心特性与作用
- 唯一性与固化性
- MAC地址由IEEE统一分配前24位(OUI,厂商代码),后24位由厂商自行分配,确保全球唯一性
- 出厂时烧录至网卡的EPROM中,通常不可更改(除非手动覆盖)
- 功能定位
- 设备识别:在局域网(LAN)内,通过MAC地址直接定位目标设备,如交换机根据MAC表转发数据帧。
- 安全控制:可通过MAC地址过滤实现网络访问权限管理。
- 协议支持:与ARP协议配合,将IP地址解析为MAC地址,完成跨网络通信。
MAC地址的结构与分类
- 格式:前3字节为厂商代码(如00-16-EA),后3字节为设备序列号。
- 类型:
- 单播地址(首位十六进制数为偶数):标识单一设备。
- 多播地址(首位为奇数):用于组播通信。
- 广播地址(全F):向局域网所有设备发送数据。
9.华为ENSP
eNSP(Enterprise Network Simulation Platform,企业网络仿真平台)是一款由华为提供的免费、可扩展和图形化操作的网络仿真工具平台,实现了对华为网络设备(路由器、交换机、防火墙等)进行软件仿真,支持各种生产环境中的网络模拟。
1.eNSP功能特色介绍如下:
(1)图形化操作:eNSP提供便捷的图形化操作界面,让复杂的组网操作变得筒单,可以直观地感受设备形态,并且支持一键获取帮助和在华为网站查询设备资料。
(2)高仿真度:按照真实设备支持特性情况进行模拟,模拟的设备形态多,支持的功能全面,模拟的实际程度高。
(3)可与真实设备对接:支持与真实网卡的绑定,实现模拟设备与真实设备的对接,组网更灵活。
(4)分布式部署:eNSP不仅支持单机部署,同时还支持分布式部署在多台服务器上。分布式部署环境下能够支持更多设备组成复杂的大型网络。
2. 安装顺序
(1)WinPcap
WinPcap(Windows Packet Capture) 是一个 Windows 平台下的 数据包捕获和网络分析开发工具包,允许程序直接访问网络接口,捕获和发送原始数据包(Raw Packet)。它是 libpcap(Linux 下的同类工具)的 Windows 移植版本,广泛用于网络监控、入侵检测、流量统计、协议开发等领域。
(2)Wireshark
Wireshark 是一款开源、跨平台的网络协议分析工具,用于捕获、分析网络流量,支持数百种协议的解析。它通过监听网络接口,实时抓取原始数据包,并以可视化方式展示协议细节,是网络工程师、安全人员和开发者诊断网络问题、学习协议原理的必备工具。
(3)VirtualBox
VirtualBox 是一款由 Oracle 公司开源的跨平台虚拟机软件,允许在单一物理主机上运行多个操作系统(如 Windows、Linux、macOS、Android 等)。它通过虚拟化技术将物理硬件资源虚拟化为多个独立的虚拟机(VM),每个虚拟机可运行独立的操作系统和应用程序,实现开发测试、多系统共存、环境隔离等场景。
(4)ENSP
3. 华为ensp文件系统VRP
VRP是华为公司从低端到高端的全系列路由器、交换机等数据通信产品的通用网络操作系统,就如同PC上安装的Windows操作系统和手机上安装的安卓系统。VRP在华为网络设备上拥有一致的用户界面、管理界面和网络界面,可为用户提供灵活而丰富的网络应用解决方案。
4. ensp视图分类
(1)用户视图:
进入命令行界面后,首先进入的就是用户视图。在提示符“<Huawei>”中,“< >”表示是用户视图,“Huawei”是设备出厂默认主机名,如图所示。
在用户视图下,用户可以了解设备的基础信息、査询设备状态,但不能进行与业务功能相关的配置。如果需要对设备进行业务功能配置,则需要进入到系统视图。
<Huawei>
(2)系统视图:
在用户视图下使用“system-view”命令切换到系统视图,此时的提示符中使用了方括号“[ ]”,系统视图下可以使用绝大部分的基础功能配置命令。另外,系统视图还提供了切换到其他视图的入口,如果要进入其他视图,必须先切换到系统视图。
<Huawei>sys
<Huawei>system-view
Enter system view, return user view with Ctrl+Z.
[Huawei]
(3)接口视图:
如果要对设备的具体接口进行相关配置,则还需要进入到接口视图。进入接口视图后,主机名后追加了接口类型和接口编号的信息。在接口视图下,可以完成对相应接口的配置操作,例如,配置接口的IP地址。接口视图下,主机名外的符号仍然是“[ ]”。事实上,除用户视图外,其他任何视图下的主机名外的符号都是“[ ]”。符号内除了包含主机名信息,还会有相关接口信息,例如,内容为“Huawei-GigabitEthernet0/0/0”,表示是设备第1个槽位、第1号板卡的第1个端口。
[Huawei]int g0/0/0
[Huawei-GigabitEthernet0/0/0]
(4)视图之间切换
在退出某个视图时,用户可以使用quit命令退出到上一层视图,也可以使用return命令或“Ctrl+Z”组合键直接退回到用户视图。
5. ensp基础命令
(1)修改主机名 sysname
[Huawei]sysname jcx
[jcx]
(2)查看帮助 ?
----  直接使用?查看所有命令
[jcx]?
System view commands:
aaa                          <Group> aaa command group
aaa-authen-bypass            Set remote authentication bypass
aaa-author-bypass            Set remote authorization bypass
aaa-author-cmd-bypass        Set remote command authorization bypass
access-user                  User access
acl                          Specify ACL configuration information
alarm                        Alarm
anti-attack                  Specify anti-attack configurations
application-apperceive       Set application-apperceive information

---  也可以命令后接 ?
[jcx]display ip int ?
GigabitEthernet  GigabitEthernet interface
NULL             NULL interface
brief            Brief summary of IP status and configuration
description      Interface description
|                Matching output
<cr>             Please press ENTER to execute command
(3)ensp修改时间 clock
- 查看时间 display clock
[jcx]display clock
2025-06-07 16:38:01
Saturday
Time Zone(China-Standard-Time) : UTC-08:00
- 配置时间需先配置时区
<jcx>clock timezone BJ add 08:00:00
- 再配置时间
<jcx>clock datetime 16:00 2025-10-1
<jcx>display clock
2025-10-01 16:00:05
Wednesday
Time Zone(BJ) : UTC+08:00
(4)ensp配置地址
a.显示IP接口的简要信息
[Huawei]display ip interface brief
*down: administratively down
^down: standby
(l): loopback
(s): spoofing
The number of interface that is UP in Physical is 1
The number of interface that is DOWN in Physical is 3
The number of interface that is UP in Protocol is 1
The number of interface that is DOWN in Protocol is 3

Interface                         IP Address/Mask      Physical   Protocol
GigabitEthernet0/0/0              unassigned           down       down
GigabitEthernet0/0/1              unassigned           down       down
GigabitEthernet0/0/2              unassigned           down       down
NULL0                             unassigned           up         up(s)
b.进入接口模式
[Huawei]int g0/0/0
[Huawei-GigabitEthernet0/0/0]
c.配置IP地址
[Huawei-GigabitEthernet0/0/0]ip address 192.168.1.1 24
d.启用端口
[Huawei-GigabitEthernet0/0/0]undo shutdown
e.查看信息
[Huawei]display ip interface brief
*down: administratively down
^down: standby
(l): loopback
(s): spoofing
The number of interface that is UP in Physical is 1
The number of interface that is DOWN in Physical is 3
The number of interface that is UP in Protocol is 1
The number of interface that is DOWN in Protocol is 3

Interface                         IP Address/Mask      Physical   Protocol
GigabitEthernet0/0/0              192.168.1.1/24       down       down
GigabitEthernet0/0/1              unassigned           down       down
GigabitEthernet0/0/2              unassigned           down       down
NULL0                             unassigned           up         up(s)
(5)设置console
- 接入console口
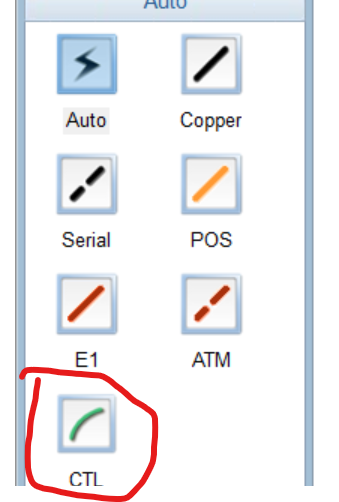
- 设置console密码
[Huawei]user-interface console 0
[Huawei-ui-console0]authentication-mode password
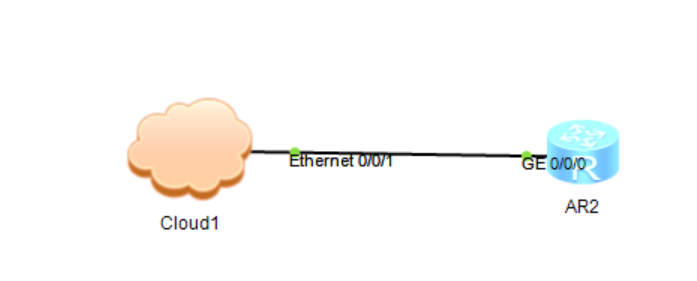
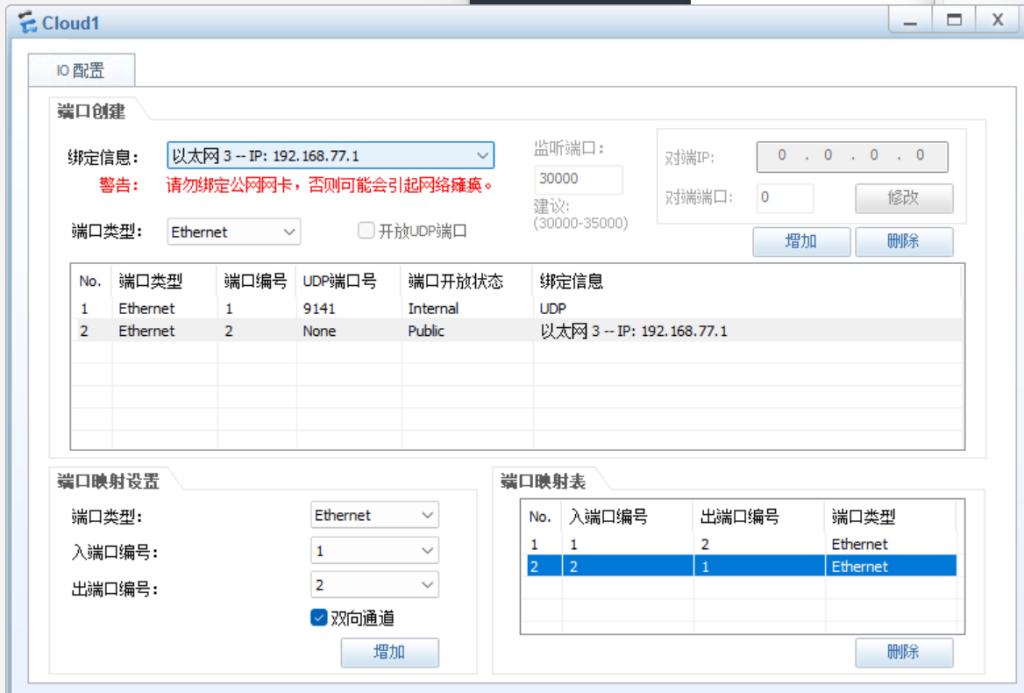
(6)ensp连接真机
7.1 利用的环回口
添加环回口
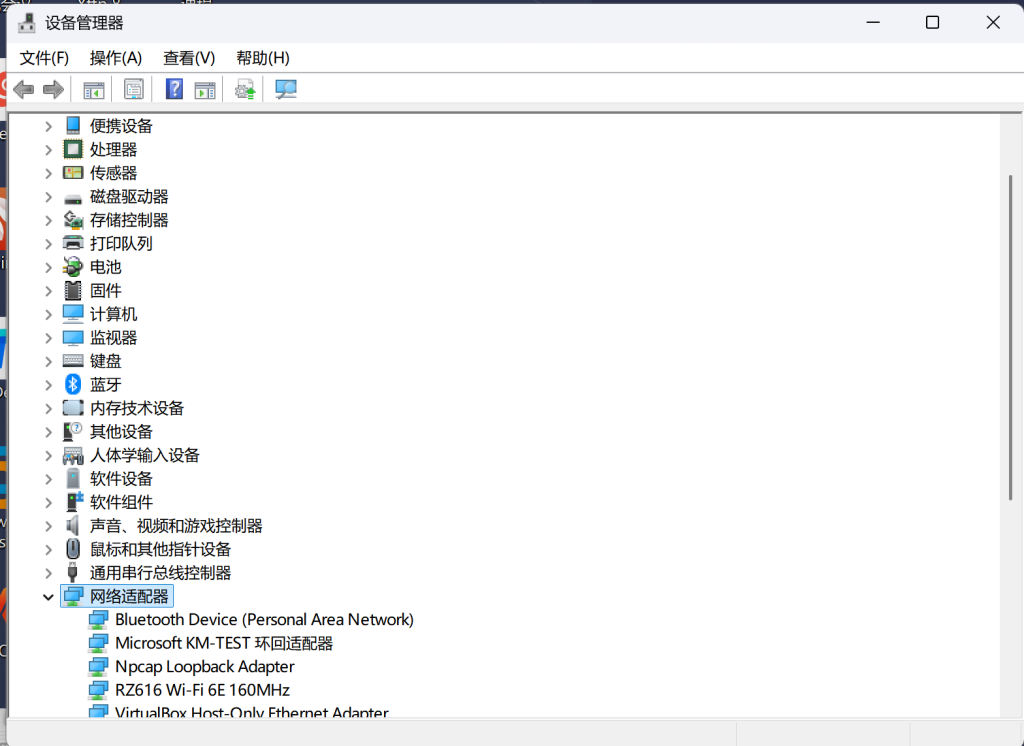
操作 - 添加过时硬件
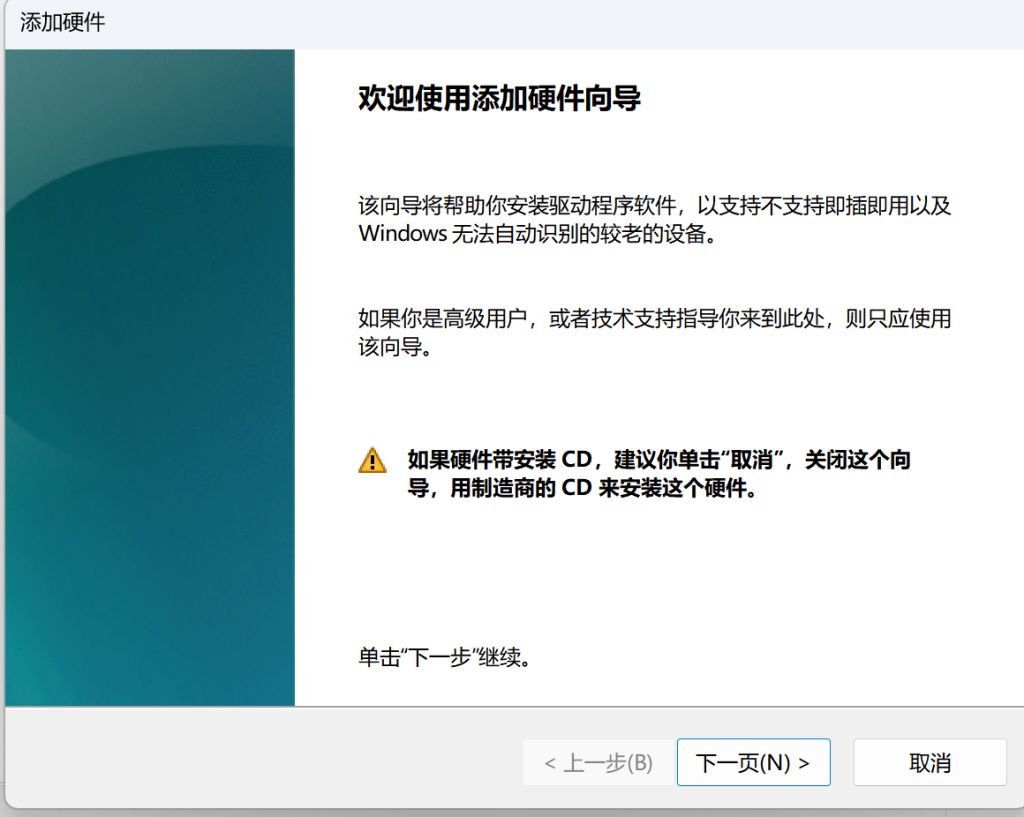
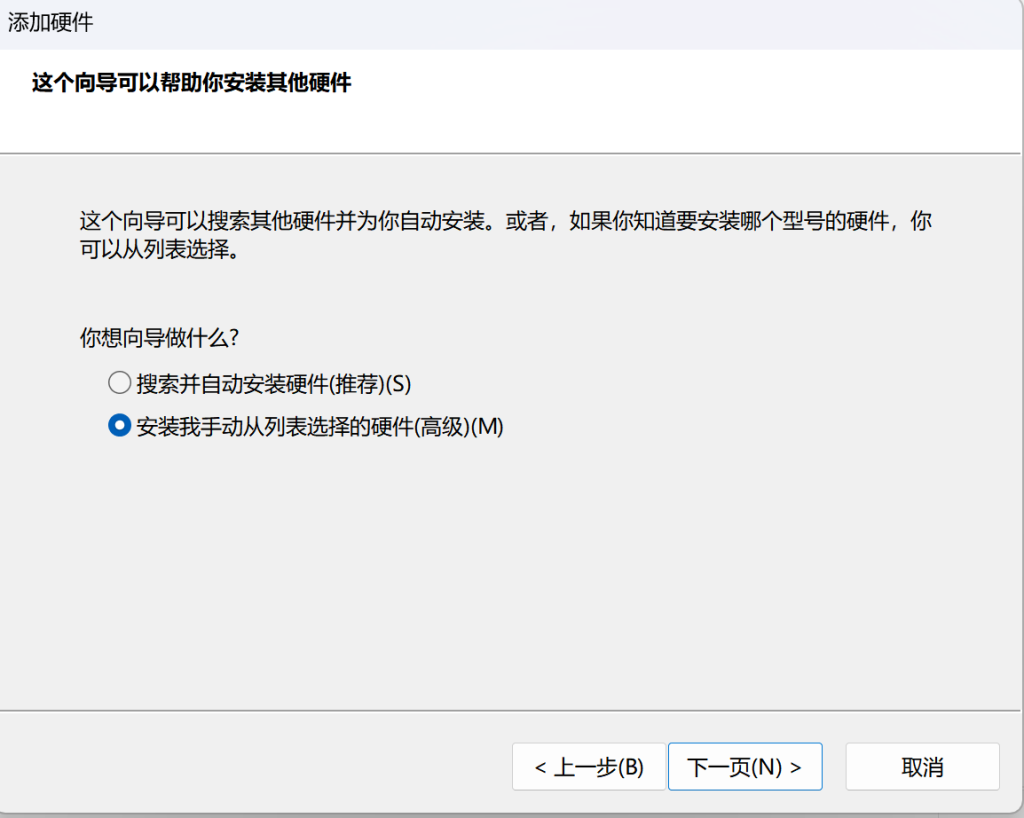
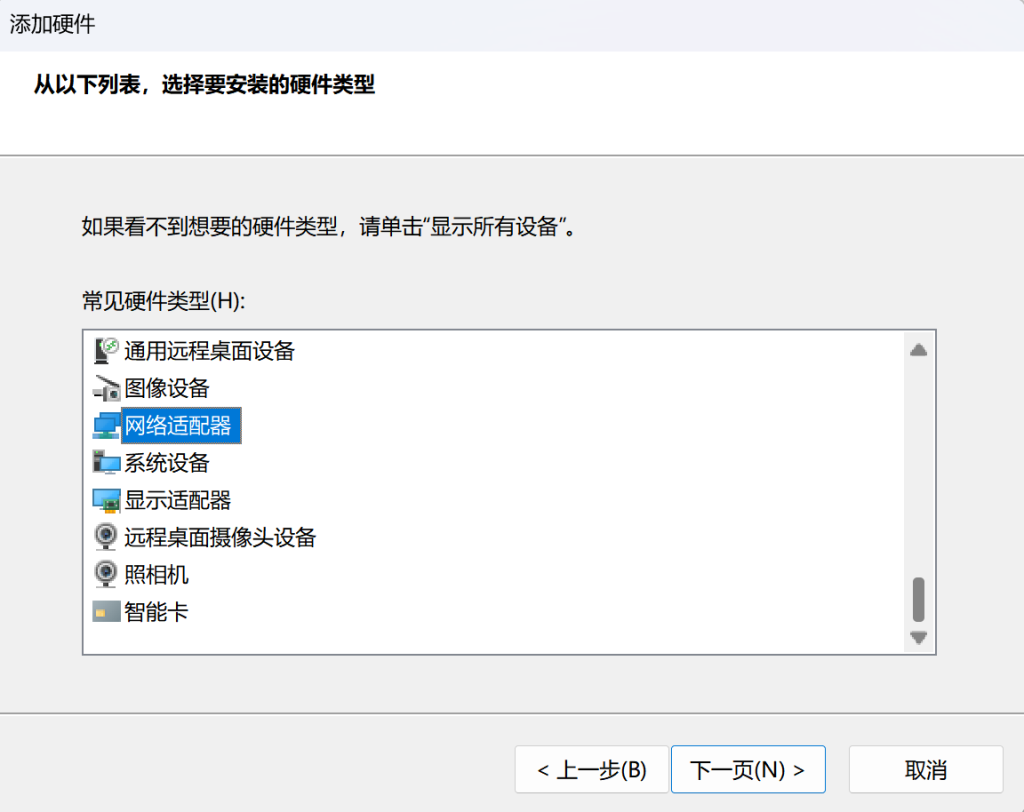
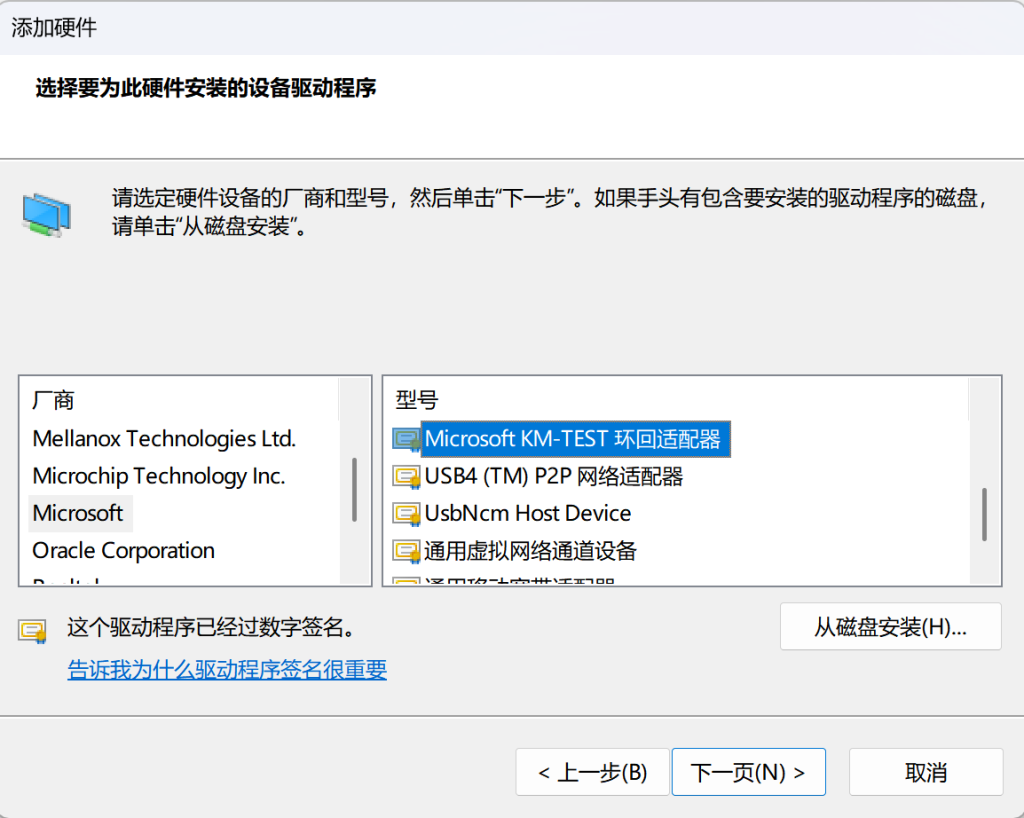
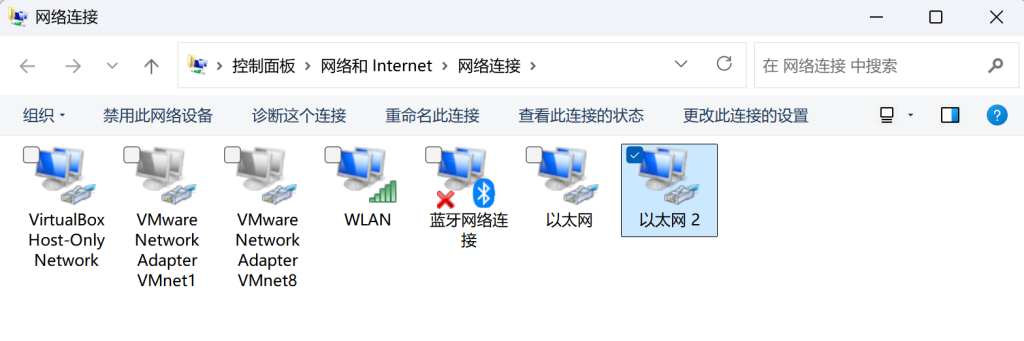
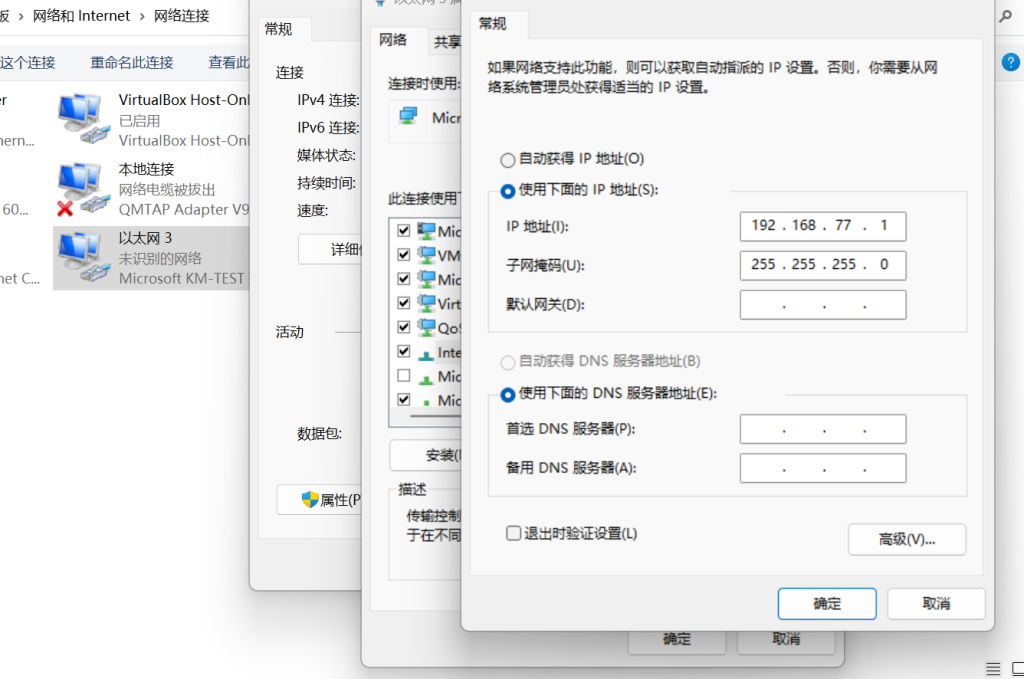
- 环回适配器配置地址
- ensp连接
(7)telnet登录
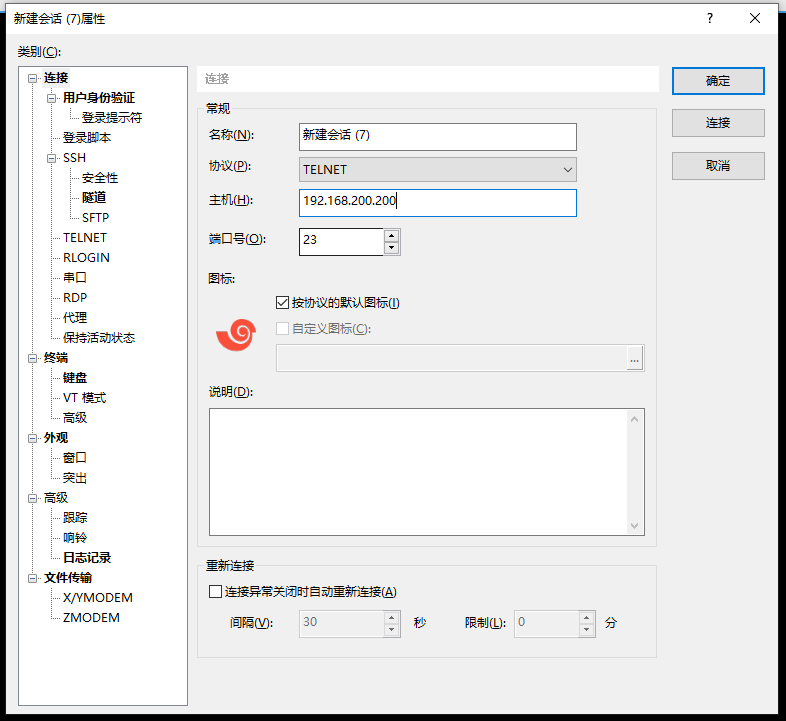
- 添加交换机的IP地址
- 启用telnet功能
[Huawei]telnet server enable            ---启用telnet功能

[Huawei]user-interface vty 0 4        -----  进去虚拟用户终端界面

[Huawei-ui-vty0-4]authentication-mode aaa    ------配置认证模式为3a认证

[Huawei-ui-vty0-4]protocol inbound telnet   -------配置入站协议为telnet
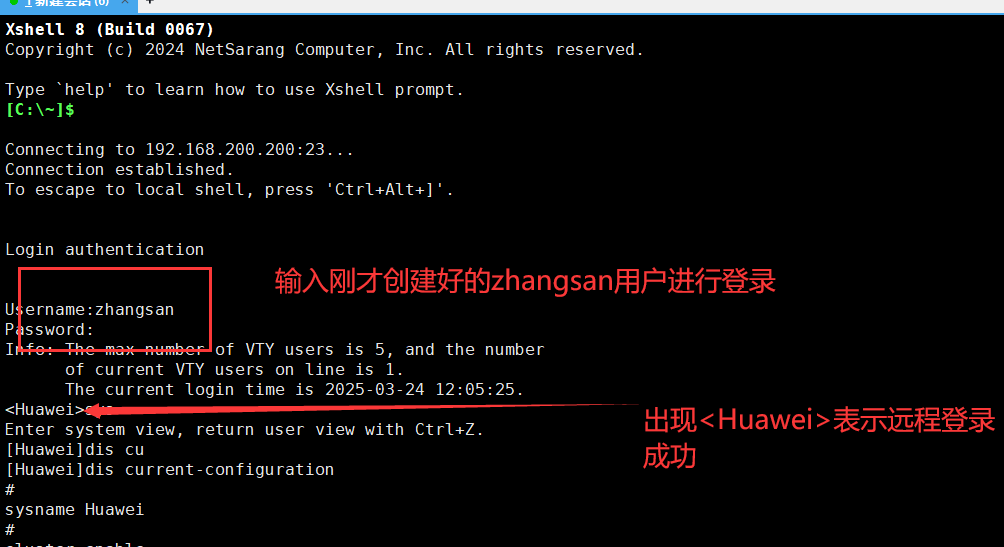
- 配置3A认证功能
[Huawei]aaa                ------进入3a认证界面

[Huawei-aaa]local-user zhangsan password cipher 123456   ----配置zhangsan用户设置密码为123456

[Huawei-aaa]local-user zhangsan privilege level 15    -----设置zhangsan用户的权限为15最高级

[Huawei-aaa]local-user zhangsan service-type telnet   ------把该用户应用到telnet协议里
- 远程登录
(8)ssh登录
- 添加交换机的IP地址
- 启用telnet功能
[Huawei]stelnet server enable            -----启用stelnet功能

[Huawei]user-interface vty 0 4          ------进去虚拟用户终端界面

[Huawei-ui-vty0-4]authentication-mode aaa   -----配置认证模式为3a认证

[Huawei-ui-vty0-4]protocol inbound ssh   ------配置入站协议为ssh
- 配置3A认证功能
[Huawei]aaa               ----- 进入3a认证界面

[Huawei-aaa]local-user zhangsan password cipher p-0p-0p-0    -----配置zhangsan用户设置密码为p-0p-0p-0

[Huawei-aaa]local-user zhangsan privilege level 15   -----设置zhangsan用户的权限为15最高级

[Huawei-aaa]local-user zhangsan service-type ssh     -----把该用户应用到ssh协议里
- 配置ssh用户采用密码认证
[Huawei]ssh user woniu authentication-type password
Authentication type setted, and will be in effect next time
- 生成本地RSA密钥对
[Huawei]rsa local-key-pair create
The key name will be: Host
% RSA keys defined for Host already exist.
Confirm to replace them? (y/n)[n]:y
The range of public key size is (512 ~ 2048).
NOTES: If the key modulus is greater than 512,
It will take a few minutes.
Input the bits in the modulus[default = 512]:
Generating keys...
..........++++++++++++
...............++++++++++++
........++++++++
....................................++++++++

[Huawei]
- 远程登录
(9)根据拓扑完成vlan通信配置
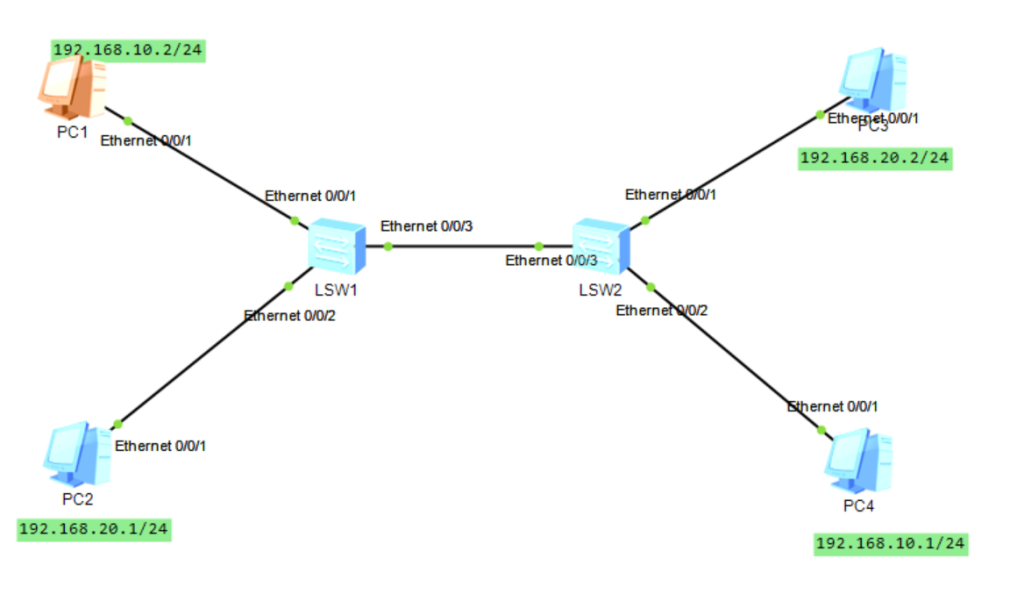
- 查看vlan
[Huawei]display vlan
- 创建vlan
[Huawei]vlan 10      ------数字方式创建单个vlan
[Huawei]vlan 20
[Huawei]vlan bat	ch 3 to 5     ------批量创建vlan
- 将端口加入到指定vlan
[Huawei-Ethernet0/0/1]port link-type access 				  ------指定端口的链接类型是access
[Huawei-Ethernet0/0/1]port default vlan 10     ------将端口加入到vlan10
- 将交换机互联的接口配置为trunk类型
[Huawei-Ethernet0/0/3]port link-type trunk    -----指定端口类型是trunk
[Huawei-Ethernet0/0/3]port trunk allow-pass vlan 10 20     -----设置允许通过的vlan数据
注意:
这里只配置了LSW1的E0/0/1接口与E0/0/3接口
其他接口根据以上示例配置
- 验证配置,查看当前配置文件
[Huawei]display current-configuration
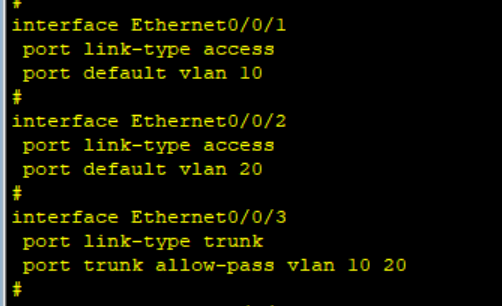
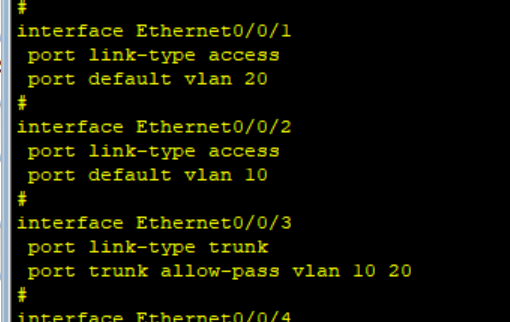
- 测试 ping
(10)根据拓扑完成直连路由实验。
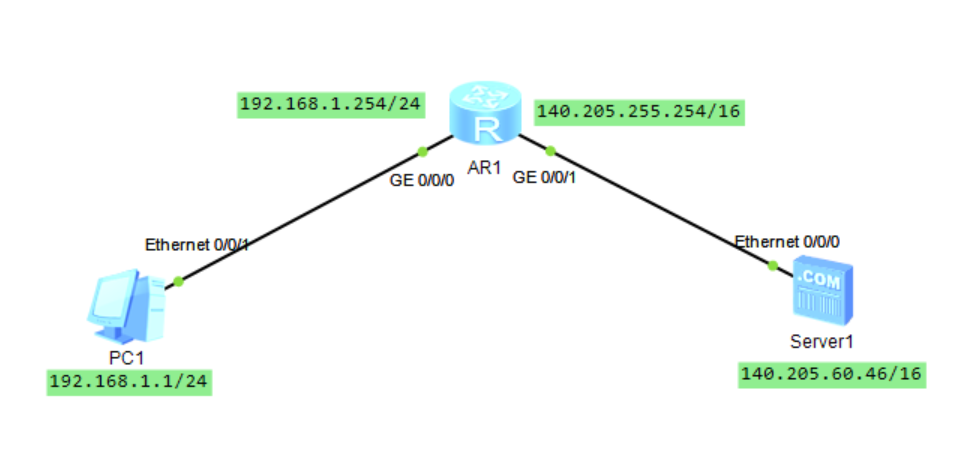
- 路由配置
<Huawei>sys  #进入系统视图
[Huawei]int g0/0/0 #进入指定接口
[Huawei-GigabitEthernet0/0/0]ip address 192.168.1.254 24 #设置IP
[Huawei-GigabitEthernet0/0/0]q  #返回上一级
[Huawei]int g0/0/1 #进入指定接口
[Huawei-GigabitEthernet0/0/1]ip address 140.205.255.254 16 #设置IP
[Huawei-GigabitEthernet0/0/1]q #返回上一级
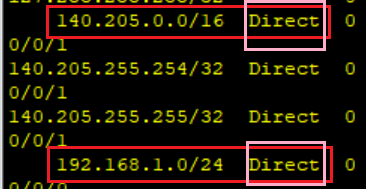
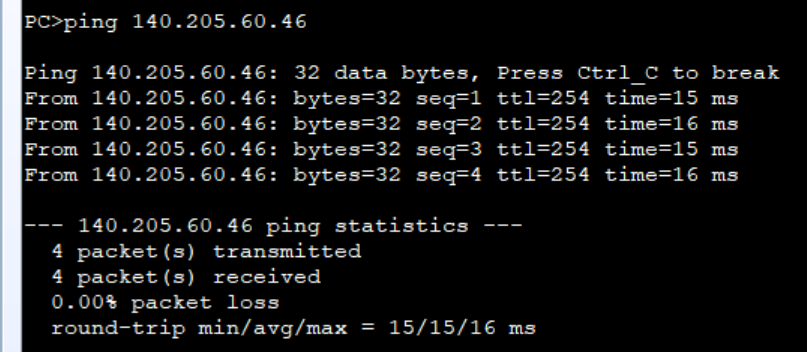
[Huawei]display ip routing-table   #查看路由器路由
- 测试
10.路由
1.路由概念
1)什么是路由?
路由指路由器根据自己路由表中的路由条目判断如何转发数据包,并据此执行转发的操作。当路由器收到一个数据包时,会根据该数据包的目的IP地址查询路由表,将目的IP地址与路由表中的路由条目进行匹配,并且根据匹配的路由条目判断通过哪个接口进行数据包转发。如果没有路由条目匹配这个目的IP地址,那么路由器把数据包丢弃。
- 路由器工作在网络层,属于三层设备;
- 路由器的物理口连接不同网络的设备,根据路由表实现数据转发;
- 路由表中记录了IP与物理接口对应关系。
2)路由表(重点)
- 自身的信息路由器获取到的直连路由的信息。
- 管理员定义的管理员定义具体的路由路径,体现在静态路由。
- 其他路由器获取到的动态路由协议获取的,从相邻的路由器获取的路由信息。
display ip routing-table
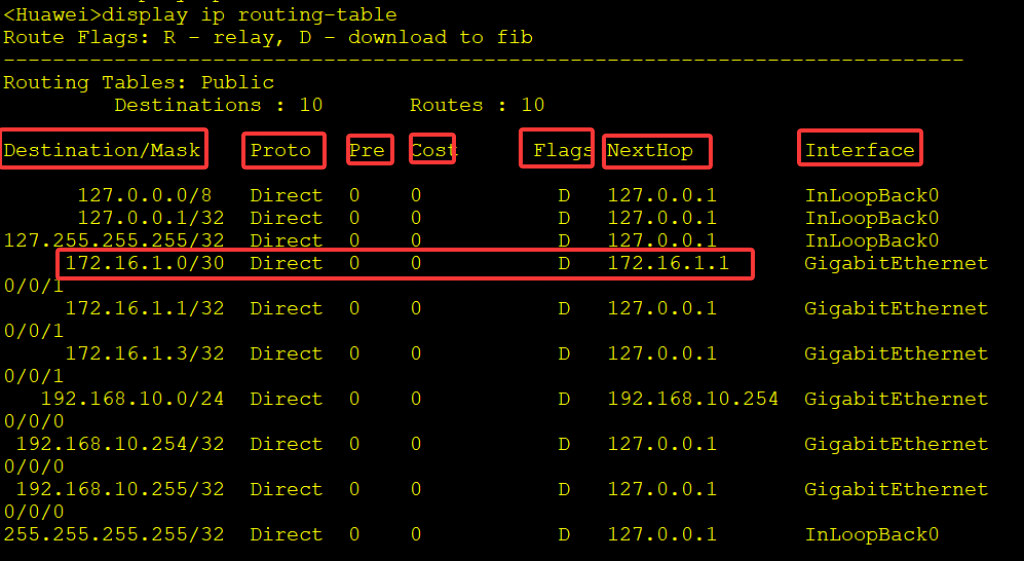
① Destination/Mask:该列的作用是标识路由条目的目的IP地址及其子网掩码。
② Proto: Proto是Protocol (协议)的简写,标识的是路由条目的获得方式。其中, Direct表示直连路由;Static表示静态路由;OSPF表示动态路由协议。
③ Pre: Pre是Preference (路由优先级)的简写。路由设备通过多个不同的来源(包括静态配置和多种路由协议)获得去往同一个网络的路由。在这种情况下,路由设备需要通过优先级值来判断,通过哪个路由条目来转发数据包。Pre标识的是不同路由来源的可靠程度,它的值越小,路由来源的可靠度就越高。当路由器通过多种信息来
源获得去往相同目的地的多个路由条目时,Pre只把路由优先级值最小的路由条目存入自己的路由表。
| 协议 | 优先级 |
|---|---|
| 直连路由 | 0(最高) |
| OSPF | 10 |
| 静态路由 | 60 |
| 默认路由 | 60(比静态路由低) |
| RIP | 100 |
| BGP | 255 |
④Cost:标识路由开销。当到达同一个目的网络的多个路由优先级相同时,路由开销最小的将成为最优路由。网络常常是四通八达的,即使通过同一种方式,路由设备也可能获得多条去往同一个网络的路由条目。Cost标识的数值叫作开销值, 表示通过同一种方式获取的路由条目,究竟孰优孰劣,其中,开销值较小的路由条目为较优的路由条目。当路由器通过同一种信息来源获得去往同一个网络的多个路由条目时, 会把开销值最小的路由条目存入自己的路由表。不同的路由协议也会采用不同的开销值计算标准。
⑤ Flags:其作用是显示路由标志。如果路由标志是D,则表示该路由已经下载到转发信息库。此后,当标志D的路由转发数据包时,不需要经过CPU处理,可以直接通过硬件转发—— 件转发不仅效率高,而且不占用路由设备CPU的处理资源。如果路由标志是R,则表示该路由是迭代路由。当标志R的路由转发数据包时,必须根据该路由的下一跳IP地址(NextHop)选择相应的接口来转发。此外,标志RD表示该路由之前是迭代路由,目前已经保存在转发信息库中,因此当标志RD的路由转发数据包时, 可以执行硬件转发。
U——该路由可以使用
G——该路由是到一个网关,如果没有该标志,说明目的地是直连的 gateway
H——该路由是到一个主机 host
D——该路由是由重定向报文创建的
M——该路由已被重定向报文修改
⑥ NextHop:标识路由条目的下一跳IP地址。
⑦ Interface:标识转发数据包的接口。
3)路由器的原理
过程
- 物理接口(g0/0/0)收到物理信号,将物理信号转为二进制数据;
- 路由器物理口收到PC1发送的数据包后,查看MAC头信息,目标MAC是否为自己的MAC地址,如果不是,则丢包,否则,拆掉MAC头,暴露上层数据(IP头);
- 查看IP头数据,确认目标IP是否存在于自己的路由表中,如果不存在,则丢包并响应目标不可达(ICMP,Type:3),如果存在,则将数据包交给对应物理接口(g0/0/2)处理;
- 对应物理接口收到数据包后,查看MAC表,是否存在下一跳设备的MAC地址,如果不存在,则进行ARP请求获取;
- 物理接口收到下一跳设备的MAC地址后,重新封装新的MAC头,将源MAC设置为自己的MAC,目标MAC设置为下一跳设备MAC地址;
- 物理接口将二进制数据转为物理信号进行转发。
4)路由分类
- 直连路由
- 静态路由
- 动态路由
2.直连路由
特点:
- 直接连接到路由器接口的网段
- 优先级最高0
- 直连的接口就是网段的网关
路由表:
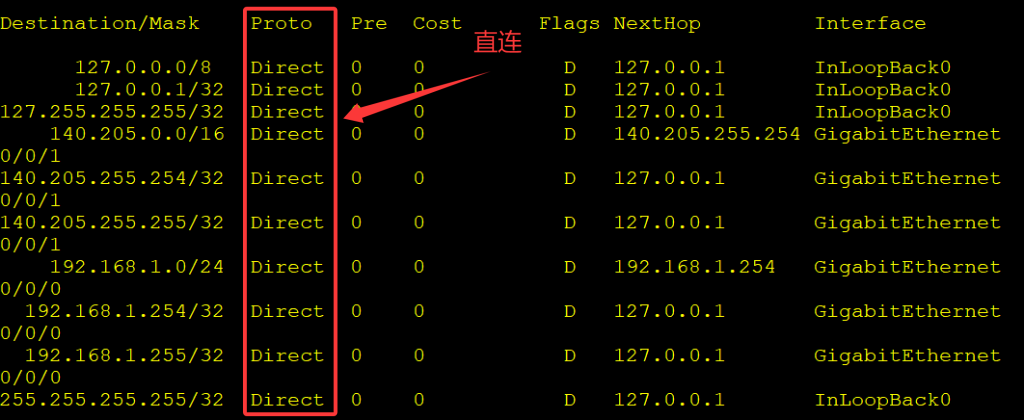
直连路由配置以及示例:
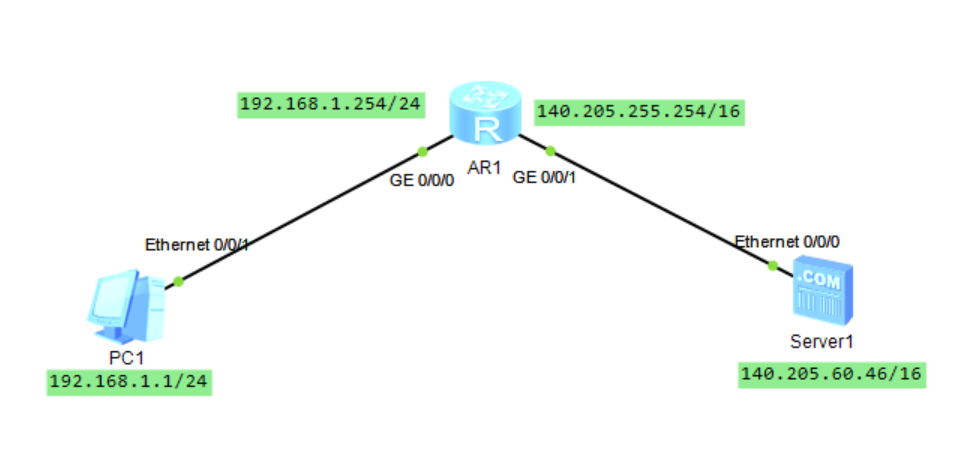
- 路由配置
<Huawei>sys  #进入系统视图
[Huawei]int g0/0/0 #进入指定接口
[Huawei-GigabitEthernet0/0/0]ip address 192.168.1.254 24 #设置IP
[Huawei-GigabitEthernet0/0/0]q  #返回上一级
[Huawei]int g0/0/1 #进入指定接口
[Huawei-GigabitEthernet0/0/1]ip address 140.205.255.254 16 #设置IP
[Huawei-GigabitEthernet0/0/1]q #返回上一级
[Huawei]display ip routing-table   #查看路由器路由
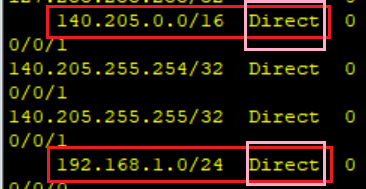
- 测试
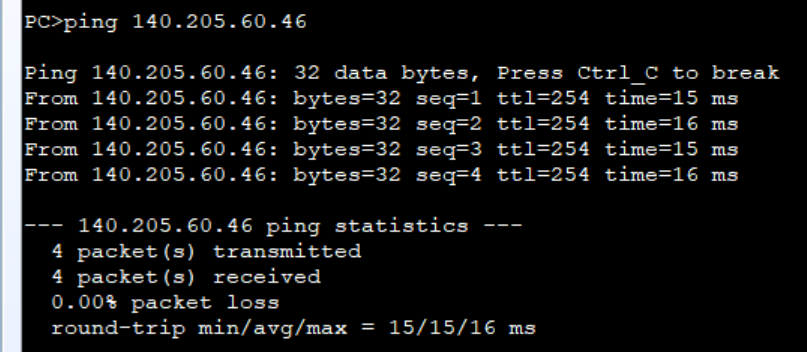
3.静态路由
特点:
- 管理员手工配置
- 路径明确,效率高
- 管理困难
- 不适合大型网络,只适合做动态路由的补充
- 默认路由 -- 一个特殊的静态路由,只有一个出口
配置步骤:
- 1、配置路由器接口地址,PC端地址(配置网关--- 路由器连接的接口地址)
2、配置静态路由
写出每个路由器非直连网段
AR1 --- 192.168.20.0/24 192.168.30.0/24
AR2 --- 192.168.10.0/24
AR3 ---- 默认路由
开始静态路由配置:
(1)告诉路由器要去哪 目标网段和子网掩码
(2)怎么去
- 从哪个口出去(自身的)
- 去哪个路由器(下一跳地址,就是要去的路由器的它的接口地址)
静态路由配置以及示例:
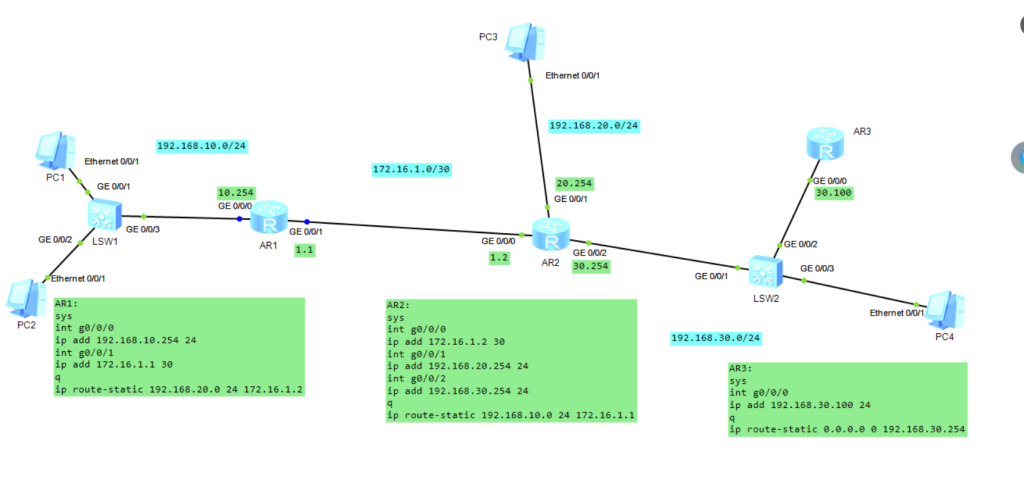
AR1:
AR1:
sys
int g0/0/0
ip add 192.168.10.254 24
int g0/0/1
ip add 172.16.1.1 30
q
ip route-static 192.168.20.0 24 172.16.1.2
AR2:
AR2:
sys
int g0/0/0
ip add 172.16.1.2 30
int g0/0/1
ip add 192.168.20.254 24
int g0/0/2
ip add 192.168.30.254 24
q
ip route-static 192.168.10.0 24 172.16.1.1
AR3:
AR3:
sys
int g0/0/0
ip add 192.168.30.100 24
q
ip route-static 0.0.0.0 0 192.168.30.254
AR4 默认路由:
[Huawei]ip route-static 0.0.0.0 0 g0/0/0 192.168.30.254
4.动态路由协议
4.1 概念
在路由器设备上运行指定的动态路由协议,让路由器之间交互特定的路由信息报文,互相学习路由条目,形成自己的路由表,并且在链路发生改变时,自动进行路由调整。
4.2 分类
- 距离矢量路由协议:运行距离矢量路由协议的路由器根据运行相同路由协议的路由器宣告的路由表,判断某个网络到自己的距离大小和方向,其中,大小指路由器跳数,方向指使用的接口或下一跳地址。
- 链路状态路由协议:运行链路状态路由协议的路由器运行Dijkstra算法。路由设备首先和其他运行相同路由协议的设备建立邻接关系,并在此过程中相互同步链路状态,但并不是通告整个路由表。收到邻居路由器发送的链路状态之后,路由设备会把它放入自己的LSDB (LinkState Database,链路状态数据库),然后针对LSDB运行Dijkstra算法,计算出一个以自
己为根、无环的最短路径树。路由设备按照这棵树计算去往各个网络的最优路径,并且把最优路径作为路由条目放入自己的路由表中。
4.3 动态路由与静态路由区别
静态路由配置方便,对系统要求低,适用于拓扑结构简单并且稳定的小型网络。缺点是不能自动适应网络拓扑的变化,需要人工干预。
动态路由协议有自己的路由算法,能够自动适应网络拓扑的变化,适用于具有一定数量三层设备的网络。缺点是配置对用户要求比较高,对系统的要求高于静态路由,并将占用一定的网络资源和系统资源。
5.RIP协议
5.1 概念
- RIP是Routing Information Protocol(路由信息协议)的简称,它是一种较为简单的内部网关协议(Interior Gateway Protocol)。RIP是一种基于距离矢量(Distance-Vector)算法的协议,它使用跳数(Hop Count)作为度量来衡量到达目的网络的距离。RIP通过UDP报文进行路由信息的交换,使用的端口号为520。
- RIP协议支持最大15跳,16跳不可达;15跳就是我们的数据包最大能经过的路由器的数量。
5.2 版本
RIP包括RIP-1和RIP-2两个版本,RIP-2对RIP-1进行了扩充,使其更具有优势。
RIPv1与RIPv2区别
| RIPv1 | RIPv2 |
|---|---|
| 有类路由器协议(数据包不会携带子网掩码) | 无类路由协议(数据包会携带子网掩码) |
| 广播更新(255.255.255.255) | 组播更新(224.0.0.9) |
| 不支持可变长子网掩码(VLSM),使用标准子网掩码 | 支持可变长子网掩码(VLSM) |
| 自动路由汇总,不可关闭 | 自动汇总可关闭,可以手动汇总 |
| 不支持不连续子网 | 支持不连续子网 |
5.3 命令
- 创建RIP编号(取值范围:[1,65535])
rip 编号
- 设置RIP版本 默认是版本1
version 版本号
- 宣告直连网段(只支持标准A、B、C类网段)
network IP网段
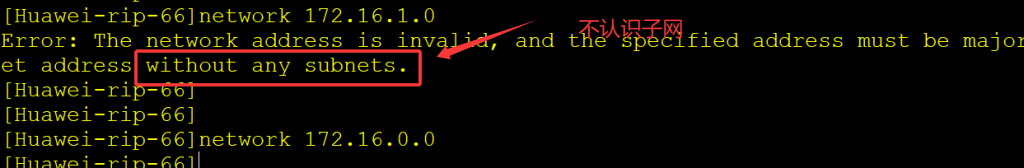
- 手动汇总
summary always
动态路由配置 version 1
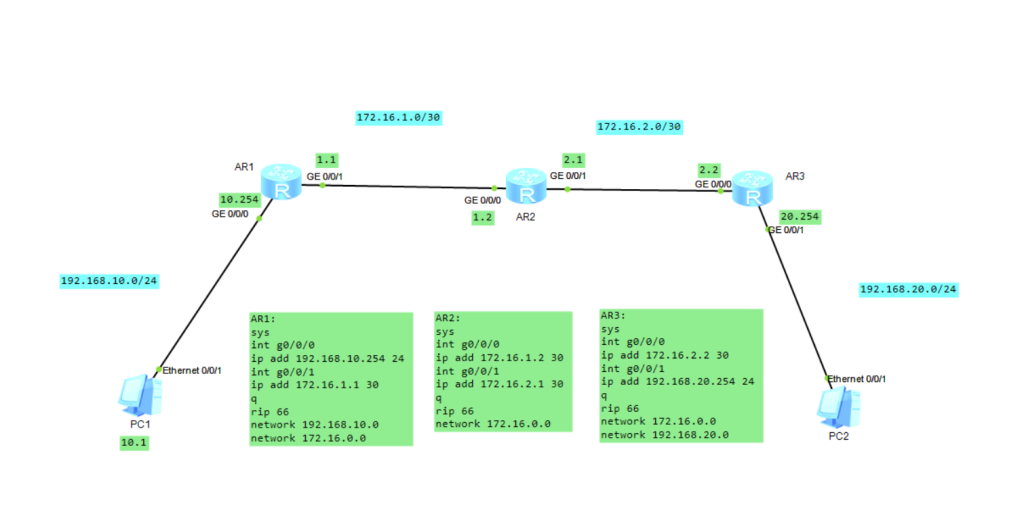
AR1:
AR1:
lsys
int g0/0/0
ip add 192.168.10.254 24
int g0/0/1
ip add 172.16.1.1 30
q
rip 66
network 192.168.10.0
network 172.16.0.0
AR2:
AR2:
sys
int g0/0/0
ip add 172.16.1.2 30
int g0/0/1
ip add 172.16.2.1 30
q
rip 66
network 172.16.0.0
AR3:
AR3:
sys
int g0/0/0
ip add 172.16.2.2 30
int g0/0/1
ip add 192.168.20.254 24
q
rip 66
network 172.16.0.0
network 192.168.20.0
动态路由配置 version 2
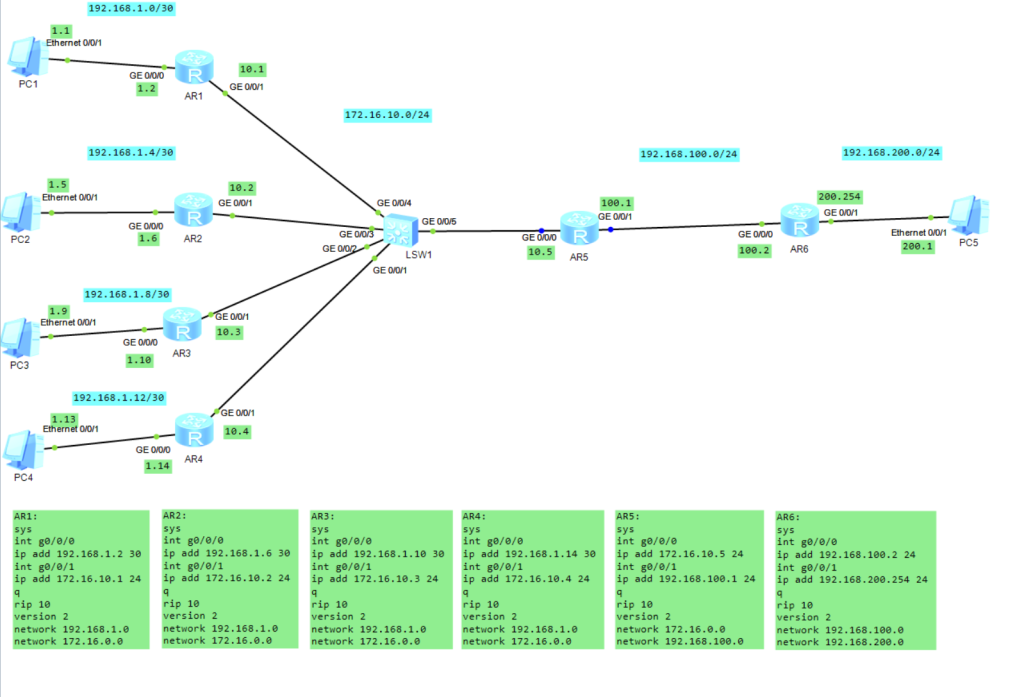
AR1:
AR1:
sys
int g0/0/0
ip add 192.168.1.2 30
int g0/0/1
ip add 172.16.10.1 24
q
rip 10
version 2
network 192.168.1.0
network 172.16.0.0
AR2:
R2:
sys
int g0/0/0
ip add 192.168.1.6 30
int g0/0/1
ip add 172.16.10.2 24
q
rip 10
version 2
network 192.168.1.0
network 172.16.0.0
AR3:
AR3:
sys
int g0/0/0
ip add 192.168.1.10 30
int g0/0/1
ip add 172.16.10.3 24
q
rip 10
version 2
network 192.168.1.0
network 172.16.0.0
AR4:
AR4:
sys
int g0/0/0
ip add 192.168.1.14 30
int g0/0/1
ip add 172.16.10.4 24
q
rip 10
version 2
network 192.168.1.0
network 172.16.0.0
AR5:
AR5:
sys
int g0/0/0
ip add 172.16.10.5 24
int g0/0/1
ip add 192.168.100.1 24
q
rip 10
version 2
network 172.16.0.0
network 192.168.100.0
AR6:
AR6:
sys
int g0/0/0
ip add 192.168.100.2 24
int g0/0/1
ip add 192.168.200.254 24
q
rip 10
version 2
network 192.168.100.0
network 192.168.200.0
6、OSPF协议
1)协议概念
开放式最短路径优先OSPF(Open Shortest Path First)是IETF组织开发的一个基于链路状态的内部网关协议(Interior Gateway Protocol)。
2)工作原理
a.建立邻居关系
b.建立邻接关系 init -- 2way -- exstart -- exchange -- loading - full
c.交换LSA数据
3)区域分类
区域0 area0 --- 骨干区域(必须要知道的)
标准区域(最常用的)
- 标准区域是最通用的区域,它传输区域内路由,区域间路由和外部路由。
- 标准区域需要与骨干区域直连,也可以与其它AS区域连接。
- 会产生LSA类型:1、2、3、4、5;
末梢区域(STUB)
- 不允许发布自治系统外部路由,只允许发布区域内路由和区域间的路由。
- 会产生LSA类型:1、2、3(其它区域路由和通往其它AS的默认路由);
完全末梢区域(Totally STUB)
- 不允许发布自治系统外部路由和区域间的路由,只允许发布区域内路由。
- 会产生LSA类型:1、2、3(通往其它区域和其它AS的默认路由);
非纯末梢区域(NSSA)
- 具备末梢区域特征(只允许发布区域内路由和区域间的路由);
- 可以导入与当前区域内的ASBR直连的其它AS路由;
- 会产生的LSA类型:1、2、3、7(与当前区域ASBR直连的其它AS路由以及通往其它AS的默认路由);
完全非纯末梢区域(Totally NSSA)
- 具备完全末梢区域特征(只允许发布区域内路由);
- 具备非纯末梢区域特征(可以导入与当前区域内的ASBR直连的其它AS路由);
- 会产生LSA类型:1、2、3(通往其它区域默认路由)、7(通往其它AS的默认路由与当前区域ASBR直连的其它AS路由);
路由器角色
- 区域内路由器(Internal Router):该类设备的所有接口都属于同一个OSPF区域。
- 区域边界路由器ABR(Area Border Router):该类设备可以同时属于两个以上的区域,但其中一个必须是骨干区域。ABR用来连接骨干区域和非骨干区域,它与骨干区域之间既可以是物理连接,也可以是逻辑上的连接。
- 自治系统边界路由器ASBR(AS Boundary Router):与其他AS交换路由信息的设备称为ASBR。ASBR并不一定位于AS的边界,它可能是区域内设备,也可能是ABR。只要一台OSPF设备引入了外部路由的信息,它就成为ASBR。
4)信息分类
Type1
- 每个设备都会产生,描述了设备的链路状态和开销,在所属的区域内传播。
Type2
- 由DR(Designated Router)产生,描述本网段的链路状态,在所属的区域内传播。
Type3
- 由ABR产生,描述区域内某个网段的路由,并通告给发布或接收此LSA的非Totally STUB或NSSA区域。
Type4
- 由ABR产生,描述到ASBR的路由,通告给除ASBR所在区域的其他相关区域。
Type5
- 由ASBR产生,描述到AS外部的路由,通告到所有的区域(除了STUB区域和NSSA区域)。
5)配置
命令
- 创建OSPF编号(取值范围:[1,65535])
ospf 编号
- 创建区域编号(取值范围:[0,4294967295],也可以使用IPv4格式)
area 编号
- 宣告网段
network IP网段 通配符子网掩码(子网掩码反码)

反码  --  255.255.255.255减去子网掩码
在 OSPF(开放最短路径优先)协议中,**反码(Inverse Mask)也称为通配符掩码(Wildcard Mask)**,是一个重要的概念,主要用于区域划分、路由过滤、邻居关系配置等场景。与子网掩码的 “网络位必须匹配” 规则相反,**反码用于指定 “哪些位可以忽略匹配”**,将子网掩码的每一位取反(`0` 变 `1`,`1` 变 `0`)。
- OSPF区域中导入直连路由
ospf 编号import-route direct
- OSPF区域中导入静态路由
ospf 编号import-route static
- OSPF区域中导入默认路由
ospf 编号default-route-advertise
- OSPF区域中导入RIP路由
ospf 编号import-route rip 编号
- RIP区域中导入直连路由
rip 编号import-route direct
- RIP区域中导入静态路由
rip 编号import-route static
- RIP区域中导入默认路由
rip 编号default-route originate
- RIP区域中导入OSPF路由
rip 编号import-route ospf 编号
- 设置末梢区域
ospf 编号area 编号stub
- 设置完全末梢区域
ospf 编号area 编号stub no-summary
- 设置非纯末梢区域
ospf 编号area 编号nssa
- 设置完全非纯末梢区域
ospf 编号area 编号nssa no-summary
单区域ospf配置
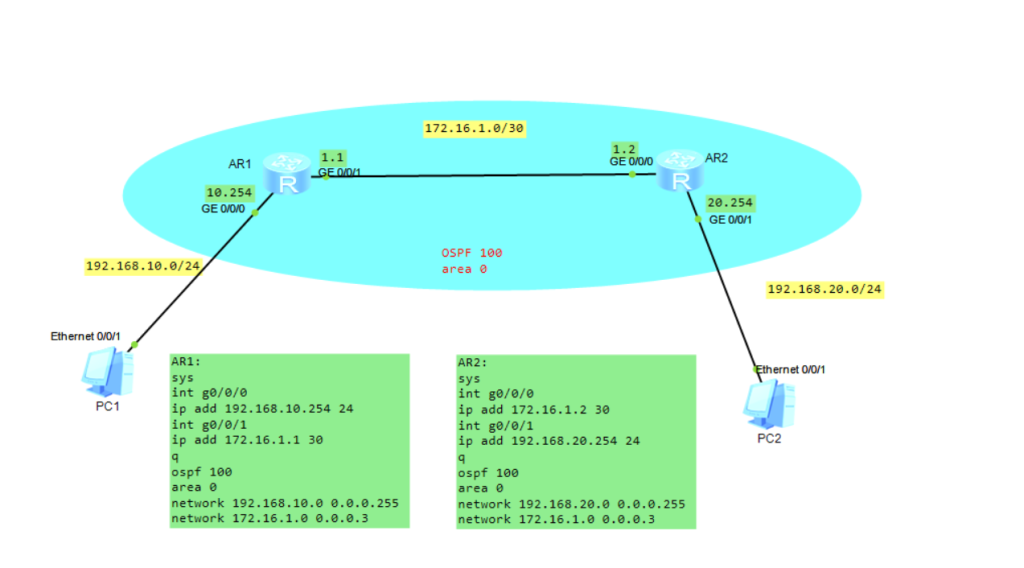
AR1:
AR1:
sys
int g0/0/0
ip add 192.168.10.254 24
int g0/0/1
ip add 172.16.1.1 30
q
ospf 100
area 0
network 192.168.10.0 0.0.0.255
network 172.16.1.0 0.0.0.3
AR2:
AR2:
sys
int g0/0/0
ip add 172.16.1.2 30
int g0/0/1
ip add 192.168.20.254 24
q
ospf 100
area 0
network 192.168.20.0 0.0.0.255
network 172.16.1.0 0.0.0.3
多区域ospf配置
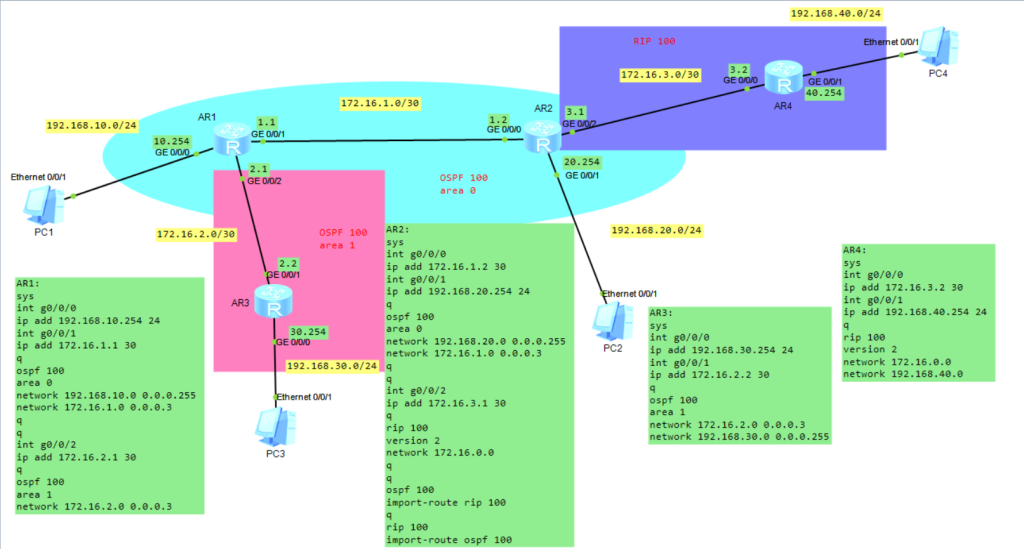
AR1:
AR1:
sys
int g0/0/0
ip add 192.168.10.254 24
int g0/0/1
ip add 172.16.1.1 30
q
ospf 100
area 0
network 192.168.10.0 0.0.0.255
network 172.16.1.00.0.0.3
q
int g0/0/2
ip add 172.16.2.1 30
ospf 100
area 1
network 172.16.2.00.0.0.3
AR2:
AR2:
sys
int g0/0/0
ip add 172.16.1.2 30
int g0/0/1
ip add 192.168.20.254 24
q
ospf 100
area 0
network 192.168.20.0 0.0.0.25
network 172.16.1.0 0.0.0.3
q
int g0/0/2
ip add 172.16.3.1 30
q
rip 100
version 2
network 172.16.0.0
ospf 100
import-route rip 100
rip 100
import-route ospf 100
AR3:
AR3:
sys
int g0/0/0
ip add 192.168.30.254 24
int g0/0/1
ip add 172.16.2.2 30
q
ospf 100
area 1
network 172.16.2.0 0.0.0.3
network 192.168.30.0 0.0.0.255
AR4:
AR4:
sys
int g0/0/0
ip add 172.16.3.2 30
int g0/0/1
ip add 192.168.40.254 24
q
rip 100
version 2
network 172.16.0.0
network 192.168.40.0